
XGBoost ปะทะ LightGBM: อัลกอริทึมไหนที่ใช่สำหรับคุณ? ไขข้อข้องใจแบบละเอียด
เจาะลึกความแตกต่างสำคัญระหว่างสองยักษ์ใหญ่แห่งวงการ Gradient Boosting เพื่อเลือกใช้ให้เหมาะสมที่สุดกับงานของคุณ
XGBoost (Extreme Gradient Boosting) และ LightGBM (Light Gradient Boosting Machine) คือสองเฟรมเวิร์กการบูสต์แบบเกรเดียนต์ (Gradient Boosting) ที่ได้รับความนิยมอย่างสูงในวงการวิทยาศาสตร์ข้อมูลและการเรียนรู้ของเครื่อง ทั้งคู่มีประสิทธิภาพยอดเยี่ยมในการสร้างโมเดลพยากรณ์ที่มีความแม่นยำสูง โดยเฉพาะอย่างยิ่งในงานแข่งขัน Kaggle และการประยุกต์ใช้งานกับชุดข้อมูลขนาดใหญ่ แม้ว่าทั้งสองจะมีพื้นฐานมาจากหลักการเดียวกันคือการสร้างต้นไม้ตัดสินใจ (Decision Trees) แบบต่อเนื่องเพื่อปรับปรุงข้อผิดพลาดของโมเดล แต่ก็มีความแตกต่างที่สำคัญหลายประการที่ส่งผลต่อประสิทธิภาพ ความเร็ว และความเหมาะสมในการนำไปใช้งาน
ประเด็นสำคัญที่คุณควรรู้
- ความเร็วและประสิทธิภาพหน่วยความจำ: LightGBM มักจะทำงานได้เร็วกว่าและใช้หน่วยความจำน้อยกว่า XGBoost อย่างเห็นได้ชัด โดยเฉพาะอย่างยิ่งเมื่อต้องจัดการกับชุดข้อมูลที่มีขนาดใหญ่มาก
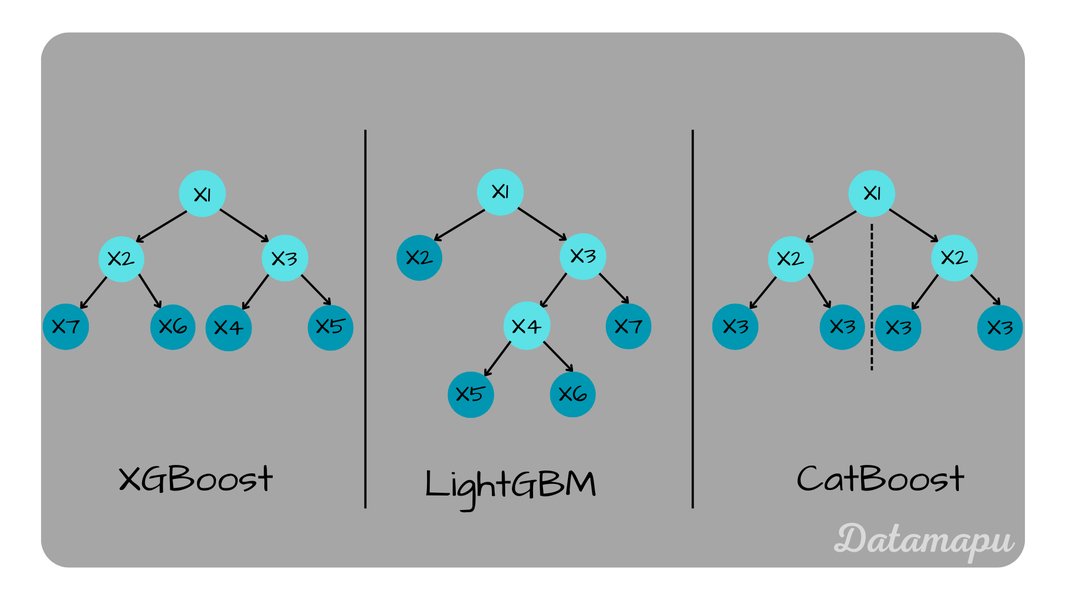
- กลยุทธ์การสร้างต้นไม้: XGBoost ใช้การเติบโตของต้นไม้แบบ level-wise (หรือ depth-wise) ทำให้ได้โครงสร้างต้นไม้ที่สมดุลและตีความได้ง่ายกว่า ในขณะที่ LightGBM ใช้การเติบโตแบบ leaf-wise ซึ่งสามารถค้นพบการแบ่งที่ดีที่สุดได้เร็วกว่า แต่อาจนำไปสู่ต้นไม้ที่ซับซ้อนและเสี่ยงต่อการเกิด Overfitting มากกว่าหากไม่ระมัดระวัง
- การจัดการคุณลักษณะเชิงหมวดหมู่ (Categorical Features): LightGBM มีความสามารถในการจัดการคุณลักษณะเชิงหมวดหมู่ได้โดยตรง ซึ่งช่วยลดขั้นตอนการเตรียมข้อมูลและลดการใช้หน่วยความจำ ในขณะที่ XGBoost โดยทั่วไปต้องการให้คุณลักษณะเหล่านี้ถูกแปลงด้วยวิธี One-hot Encoding ก่อน
เจาะลึกความแตกต่างในแต่ละมิติ
เพื่อให้เข้าใจความแตกต่างระหว่าง LightGBM และ XGBoost อย่างถ่องแท้ เรามาพิจารณารายละเอียดในแต่ละด้านกันครับ
1. กลยุทธ์การสร้างต้นไม้ (Tree Growth Strategy)
นี่คือหนึ่งในความแตกต่างพื้นฐานที่สุดระหว่างอัลกอริทึมทั้งสอง และส่งผลอย่างมากต่อประสิทธิภาพและลักษณะของโมเดลที่ได้
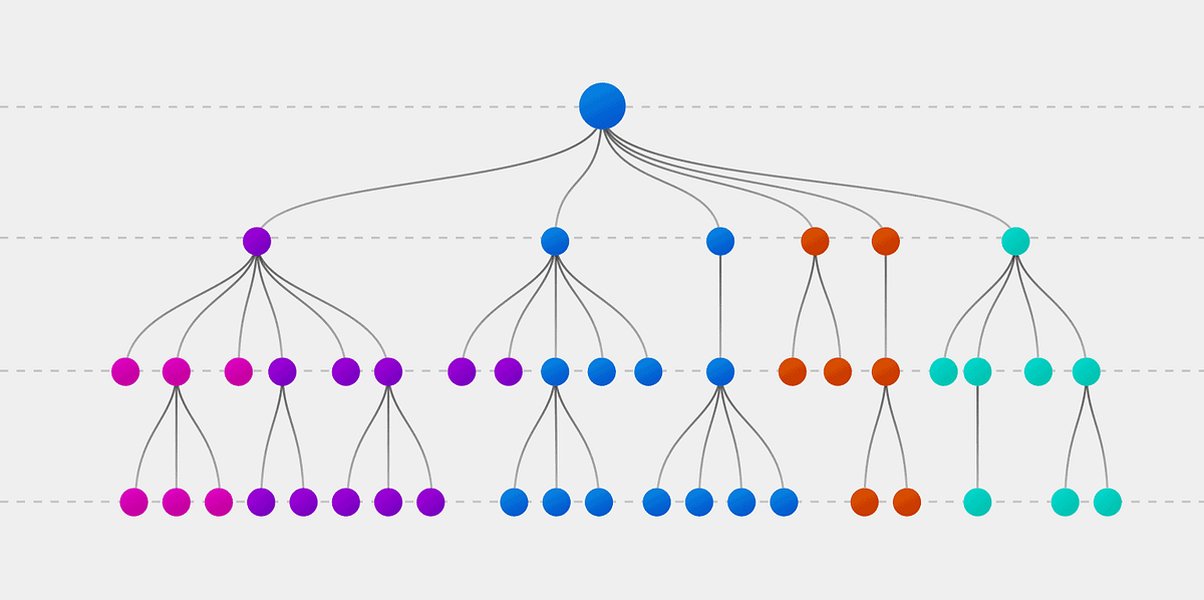
ภาพแสดงแนวคิดพื้นฐานของต้นไม้ตัดสินใจที่ทั้ง XGBoost และ LightGBM ใช้เป็นโครงสร้างหลัก
XGBoost: การเติบโตแบบ Level-wise (หรือ Depth-wise)
XGBoost สร้างต้นไม้โดยการขยายโหนดทั้งหมดในแต่ละระดับความลึก (level) พร้อมกัน ก่อนที่จะไปยังระดับถัดไป วิธีนี้ทำให้ต้นไม้ที่ได้มักจะมีความสมดุล (balanced tree) ซึ่งหมายความว่ากิ่งก้านต่างๆ ของต้นไม้จะมีความลึกใกล้เคียงกัน ข้อดีคือช่วยให้โมเดลมีความทนทาน (robust) และลดความเสี่ยงในการเกิด Overfitting ได้ในระดับหนึ่ง อีกทั้งยังทำให้โครงสร้างโมเดลค่อนข้างง่ายต่อการตีความ อย่างไรก็ตาม การสร้างต้นไม้แบบนี้อาจใช้เวลาในการฝึกนานกว่า โดยเฉพาะกับชุดข้อมูลขนาดใหญ่ เนื่องจากต้องพิจารณาการแตกโหนดในทุกระดับอย่างครบถ้วน
LightGBM: การเติบโตแบบ Leaf-wise (พร้อมข้อจำกัดความลึก)
LightGBM ใช้กลยุทธ์ที่แตกต่างออกไป โดยจะเลือกโหนดใบ (leaf node) ที่มีการลดค่าความสูญเสีย (loss reduction) มากที่สุดในบรรดาใบทั้งหมดเพื่อทำการแบ่ง (split) ต่อไป โดยไม่จำเป็นต้องขยายทุกโหนดในระดับเดียวกันพร้อมกัน วิธีนี้ทำให้ LightGBM สามารถค้นพบโครงสร้างที่ซับซ้อนและให้ความแม่นยำสูงได้อย่างรวดเร็ว เนื่องจากมุ่งเน้นไปที่ส่วนที่สำคัญที่สุดของต้นไม้ก่อน อย่างไรก็ตาม การเติบโตแบบ leaf-wise มีแนวโน้มที่จะสร้างต้นไม้ที่ลึกและไม่สมดุล ซึ่งอาจนำไปสู่ปัญหา Overfitting ได้ง่ายกว่า XGBoost โดยเฉพาะอย่างยิ่งกับชุดข้อมูลขนาดเล็ก ดังนั้น การปรับพารามิเตอร์อย่าง max_depth (ความลึกสูงสุดของต้นไม้) และ num_leaves (จำนวนใบสูงสุด) จึงมีความสำคัญมากในการควบคุมความซับซ้อนของโมเดล LightGBM
2. ความเร็วในการฝึกและประสิทธิภาพการใช้ทรัพยากร
ความเร็วในการฝึก (Training Speed)
LightGBM มักจะโดดเด่นในด้านความเร็วในการฝึก โดยเฉพาะกับชุดข้อมูลขนาดใหญ่ เหตุผลหลักมาจากเทคนิคที่เรียกว่า Histogram-based data binning ซึ่ง LightGBM นำมาใช้อย่างมีประสิทธิภาพ เทคนิคนี้จะทำการแบ่งค่าของคุณลักษณะต่อเนื่อง (continuous features) ออกเป็นช่วงๆ (bins) และสร้างฮิสโตแกรมขึ้น ซึ่งช่วยลดความซับซ้อนในการค้นหาจุดแบ่งที่ดีที่สุด ทำให้กระบวนการฝึกรวดเร็วขึ้นอย่างมากและใช้หน่วยความจำน้อยลง
XGBoost ก็รองรับ Histogram-based algorithm เช่นกัน (ผ่านพารามิเตอร์ tree_method='hist') และมีการปรับปรุงประสิทธิภาพอย่างต่อเนื่อง แต่โดยทั่วไปแล้ว LightGBM ยังคงมีความได้เปรียบด้านความเร็ว โดยเฉพาะในการตั้งค่าเริ่มต้นหรือเมื่อทำงานกับข้อมูลมิติสูง
ประสิทธิภาพการใช้หน่วยความจำ (Memory Efficiency)
LightGBM ถูกออกแบบมาให้ใช้หน่วยความจำน้อยกว่า XGBoost การใช้ Histogram-based algorithm และการจัดการคุณลักษณะเชิงหมวดหมู่โดยตรง (จะกล่าวถึงในหัวข้อถัดไป) ช่วยลดภาระการจัดเก็บข้อมูลระหว่างการฝึกได้อย่างมาก ทำให้ LightGBM เหมาะสมกับสถานการณ์ที่มีข้อจำกัดด้านหน่วยความจำ หรือเมื่อต้องประมวลผลชุดข้อมูลที่ไม่สามารถโหลดเข้าหน่วยความจำทั้งหมดได้ในคราวเดียว
3. การจัดการคุณลักษณะเชิงหมวดหมู่ (Categorical Feature Handling)
นี่เป็นอีกหนึ่งจุดที่ LightGBM มีความแตกต่างและได้เปรียบอย่างชัดเจน
LightGBM: รองรับโดยตรง (Native Support)
LightGBM สามารถจัดการกับคุณลักษณะที่เป็นหมวดหมู่ได้โดยตรง โดยไม่ต้องทำการแปลงเป็นตัวเลขด้วยเทคนิคอย่าง One-hot Encoding หรือ Label Encoding ก่อน อัลกอริทึมภายในของ LightGBM จะหาวิธีการแบ่งคุณลักษณะเชิงหมวดหมู่ที่ดีที่สุดได้อย่างมีประสิทธิภาพ ซึ่งช่วยลดเวลาในการเตรียมข้อมูล ลดขนาดของชุดข้อมูล (เนื่องจากไม่ต้องเพิ่มคอลัมน์ใหม่จำนวนมากจากการทำ One-hot Encoding) และมักจะให้ผลลัพธ์ที่ดีกว่าการแปลงด้วยตนเอง
XGBoost: ต้องการการเข้ารหัส (Requires Encoding)
โดยทั่วไป XGBoost ต้องการให้คุณลักษณะเชิงหมวดหมู่ถูกแปลงเป็นรูปแบบตัวเลขก่อน ซึ่งวิธีที่นิยมใช้คือ One-hot Encoding อย่างไรก็ตาม การทำ One-hot Encoding กับคุณลักษณะที่มีจำนวนหมวดหมู่สูง (high cardinality) สามารถทำให้มิติของข้อมูลเพิ่มขึ้นอย่างมหาศาล ส่งผลให้การฝึกโมเดลช้าลงและใช้หน่วยความจำมากขึ้น แม้ว่าจะมีเทคนิคอื่นในการจัดการ เช่น Target Encoding แต่ก็ต้องใช้ความระมัดระวังเพื่อหลีกเลี่ยงปัญหา Data Leakage
ภาพแสดงตำแหน่งของ XGBoost และ LightGBM ท่ามกลางอัลกอริทึม Gradient Boosting อื่นๆ
4. แนวโน้มการเกิด Overfitting และการ Regularization
LightGBM: ความเสี่ยงสูงกว่า แต่ควบคุมได้
ด้วยกลยุทธ์การเติบโตแบบ leaf-wise ที่มุ่งเน้นการลด loss อย่างรวดเร็ว LightGBM จึงมีความยืดหยุ่นสูงในการสร้างโมเดลที่ซับซ้อน ซึ่งอาจนำไปสู่ปัญหา Overfitting ได้ง่ายกว่า โดยเฉพาะกับชุดข้อมูลขนาดเล็ก หรือเมื่อไม่ได้ปรับจูนพารามิเตอร์อย่างเหมาะสม การควบคุม Overfitting ใน LightGBM ทำได้โดยการปรับพารามิเตอร์ที่สำคัญ เช่น num_leaves (ควรตั้งให้น้อยกว่า \(2^{\text{max\_depth}}\)), max_depth, min_data_in_leaf, และพารามิเตอร์ Regularization อื่นๆ เช่น lambda_l1 และ lambda_l2.
XGBoost: ทนทานกว่าโดยธรรมชาติ
การเติบโตแบบ level-wise ของ XGBoost ทำให้โครงสร้างต้นไม้มีความสมดุลมากกว่า ซึ่งโดยธรรมชาติแล้วช่วยลดความเสี่ยงในการเกิด Overfitting ได้ดีกว่า LightGBM นอกจากนี้ XGBoost ยังมีพารามิเตอร์ Regularization ที่แข็งแกร่ง เช่น gamma (minimum loss reduction required to make a further partition), alpha (L1 regularization), และ lambda (L2 regularization) ที่ช่วยควบคุมความซับซ้อนของโมเดลได้อย่างมีประสิทธิภาพ
5. ความแม่นยำ (Accuracy)
ในแง่ของความแม่นยำ ทั้ง XGBoost และ LightGBM ถือเป็นอัลกอริทึมระดับแนวหน้า และมักจะให้ผลลัพธ์ที่ใกล้เคียงกันมากในหลายๆ ชุดข้อมูล การศึกษาและผลการแข่งขันต่างๆ แสดงให้เห็นว่าไม่มีอัลกอริทึมใดที่เหนือกว่าอย่างชัดเจนในทุกสถานการณ์ ความแตกต่างของความแม่นยำมักจะขึ้นอยู่กับลักษณะเฉพาะของชุดข้อมูล การเตรียมข้อมูล (Feature Engineering) และที่สำคัญที่สุดคือการปรับจูนพารามิเตอร์ (Hyperparameter Tuning) ของแต่ละอัลกอริทึม
ในบางกรณี LightGBM อาจให้ความแม่นยำสูงกว่าเล็กน้อย โดยเฉพาะกับชุดข้อมูลขนาดใหญ่และซับซ้อน เนื่องจากความสามารถในการค้นพบโครงสร้างที่เหมาะสมได้อย่างรวดเร็ว อย่างไรก็ตาม XGBoost ก็ยังคงเป็นตัวเลือกที่แข็งแกร่งและให้ผลลัพธ์ที่น่าเชื่อถือ
6. การรองรับ GPU (GPU Support)
ทั้ง XGBoost และ LightGBM รองรับการฝึกโมเดลด้วย GPU ซึ่งช่วยเร่งความเร็วในการฝึกได้อย่างมาก โดยเฉพาะกับชุดข้อมูลขนาดใหญ่
- XGBoost: สามารถเปิดใช้งานการฝึกด้วย GPU ได้โดยการตั้งค่าพารามิเตอร์
tree_methodเป็น'gpu_hist'. - LightGBM: รองรับการฝึกด้วย GPU เช่นกัน แต่ในบางครั้งอาจต้องมีการติดตั้งเวอร์ชันที่คอมไพล์มาสำหรับ GPU โดยเฉพาะ หรือตรวจสอบการตั้งค่าให้ถูกต้อง
ประสิทธิภาพบน GPU ของทั้งสองอัลกอริทึมอาจแตกต่างกันไปขึ้นอยู่กับฮาร์ดแวร์ ขนาดข้อมูล และการตั้งค่าพารามิเตอร์
7. การตีความโมเดล (Model Interpretability)
โดยทั่วไปแล้ว โมเดลที่สร้างจาก XGBoost อาจจะตีความได้ง่ายกว่าเล็กน้อย เนื่องจากโครงสร้างต้นไม้แบบ level-wise ที่มีความสมดุล ทำให้การทำความเข้าใจว่าโมเดลตัดสินใจอย่างไร (เช่น ผ่าน Feature Importance หรือ SHAP values) อาจจะตรงไปตรงมามากกว่า
ในขณะที่ LightGBM ซึ่งสร้างต้นไม้แบบ leaf-wise อาจทำให้ได้ต้นไม้ที่ลึกและไม่สมดุล การทำความเข้าใจการทำงานภายในจึงอาจซับซ้อนกว่าเล็กน้อย อย่างไรก็ตาม ทั้งสองเฟรมเวิร์กรองรับเครื่องมือวิเคราะห์โมเดลที่ช่วยในการตีความได้เป็นอย่างดี
ตารางสรุปเปรียบเทียบ LightGBM และ XGBoost
เพื่อให้เห็นภาพรวมความแตกต่างที่ชัดเจนยิ่งขึ้น ลองดูตารางสรุปนี้ครับ:
| คุณสมบัติ | XGBoost | LightGBM |
|---|---|---|
| กลยุทธ์การสร้างต้นไม้ | Level-wise (ตามระดับ) | Leaf-wise (ตามใบ) |
| ความเร็วในการฝึก | ดี, อาจช้ากว่าสำหรับข้อมูลขนาดใหญ่ | เร็วมาก, โดยเฉพาะกับข้อมูลขนาดใหญ่ |
| ประสิทธิภาพหน่วยความจำ | ปานกลาง, ใช้มากกว่าเมื่อมี Categorical Features เยอะ | ดีเยี่ยม, ประหยัดหน่วยความจำ |
| การจัดการคุณลักษณะเชิงหมวดหมู่ | ต้องการ One-hot Encoding หรือการแปลงอื่น | รองรับโดยตรง (Native Support) |
| แนวโน้ม Overfitting | น้อยกว่า, โครงสร้างต้นไม้สมดุล | สูงกว่า, ต้องปรับจูนพารามิเตอร์อย่างระมัดระวัง |
| ความแม่นยำ | สูงมาก, แข็งแกร่ง | สูงมาก, อาจได้เปรียบเล็กน้อยในบางกรณี |
| การตีความโมเดล | ค่อนข้างง่ายกว่า (ต้นไม้สมดุล) | อาจซับซ้อนกว่า (ต้นไม้ไม่สมดุล, ลึก) |
| การรองรับ GPU | รองรับ (ตั้งค่า tree_method='gpu_hist') |
รองรับ (อาจต้องติดตั้งเวอร์ชันเฉพาะ) |
| ความนิยมและชุมชน | เก่าแก่กว่า, ชุมชนใหญ่, เอกสารเยอะ | ใหม่กว่า, ได้รับความนิยมอย่างรวดเร็ว |
ภาพรวมเชิงเปรียบเทียบผ่าน Radar Chart
แผนภูมิเรดาร์ด้านล่างนี้แสดงการเปรียบเทียบคุณสมบัติหลักๆ ระหว่าง LightGBM และ XGBoost โดยค่าที่สูงกว่าหมายถึงประสิทธิภาพที่ดีกว่าในแกนนั้นๆ (สำหรับ "ความทนทานต่อ Overfitting" ค่าที่สูงหมายถึงมีความทนทานมากกว่า หรือเสี่ยงต่อ Overfitting น้อยกว่า)
จากแผนภูมิ จะเห็นได้ว่า LightGBM มีความโดดเด่นในด้านความเร็ว ประสิทธิภาพหน่วยความจำ และการจัดการข้อมูลเชิงหมวดหมู่ ในขณะที่ XGBoost มีความได้เปรียบในด้านความทนทานต่อ Overfitting และความง่ายในการตีความโมเดล ส่วนความแม่นยำโดยทั่วไปนั้นใกล้เคียงกัน
โครงสร้างและความสัมพันธ์ผ่าน Mindmap
Mindmap ด้านล่างนี้จะช่วยให้คุณเห็นภาพรวมของความสัมพันธ์และลักษณะเด่นของ XGBoost และ LightGBM ภายใต้ร่มใหญ่ของเทคนิค Gradient Boosting Machines:
Level-wise (ตามระดับ)"] id1b["ความเร็ว:
ดี, อาจช้ากว่าสำหรับ
ข้อมูลขนาดใหญ่"] id1c["การจัดการข้อมูลเชิงหมวดหมู่:
ต้องการ One-hot encoding"] id1d["Overfitting:
น้อยกว่า, ควบคุมง่ายกว่า"] id1e["การตีความ:
ง่ายกว่า (ต้นไม้สมดุล)"] id1f["Regularization:
แข็งแกร่ง (gamma, alpha, lambda)"] id2["LightGBM (Light Gradient Boosting Machine)"] id2a["กลยุทธ์สร้างต้นไม้:
Leaf-wise (ตามใบ)"] id2b["ความเร็ว:
สูงมาก, เหมาะกับ
ข้อมูลขนาดใหญ่ (Histogram-based)"] id2c["การจัดการข้อมูลเชิงหมวดหมู่:
รองรับโดยตรง (Native)"] id2d["Overfitting:
เสี่ยงสูงกว่า,
ต้องปรับจูนพารามิเตอร์ (num_leaves, max_depth)"] id2e["การตีความ:
ยากกว่า (ต้นไม้ไม่สมดุล)"] id2f["ประสิทธิภาพหน่วยความจำ:
ดีเยี่ยม"]
Mindmap นี้สรุปประเด็นสำคัญที่ทำให้ XGBoost และ LightGBM มีลักษณะเฉพาะตัวและเหมาะสมกับงานที่แตกต่างกันออกไป
ชมวิดีโอเปรียบเทียบเพิ่มเติม
สำหรับผู้ที่ต้องการเห็นภาพและฟังคำอธิบายเพิ่มเติมเกี่ยวกับการเปรียบเทียบระหว่าง LightGBM และ XGBoost วิดีโอด้านล่างนี้จะให้ข้อมูลเชิงลึกและการสาธิตที่น่าสนใจ (เนื้อหาในวิดีโอเป็นภาษาอังกฤษ):
วิดีโอนี้จะพาคุณไปสำรวจความแตกต่างในการทำงาน ประสิทธิภาพ และกรณีการใช้งานของทั้งสองอัลกอริทึม ช่วยให้คุณเข้าใจได้ลึกซึ้งยิ่งขึ้นว่าควรเลือกใช้อัลกอริทึมใดในสถานการณ์ต่างๆ
คำถามที่พบบ่อย (FAQ)
LightGBM เหมาะกับงานประเภทใดมากที่สุด?
LightGBM เหมาะอย่างยิ่งสำหรับงานที่เกี่ยวข้องกับชุดข้อมูลขนาดใหญ่ (Big Data) ที่ต้องการความเร็วในการฝึกโมเดลสูง และมีประสิทธิภาพในการใช้หน่วยความจำที่ดี นอกจากนี้ยังโดดเด่นในงานที่มีคุณลักษณะเชิงหมวดหมู่ (Categorical Features) จำนวนมาก เนื่องจากสามารถจัดการได้โดยตรงโดยไม่ต้องทำการ One-hot Encoding ซึ่งช่วยประหยัดเวลาและทรัพยากรได้อย่างมาก ตัวอย่างเช่น การแข่งขัน Kaggle, การวิเคราะห์ข้อมูลลูกค้าขนาดใหญ่, หรือระบบแนะนำสินค้าแบบเรียลไทม์
XGBoost มีข้อได้เปรียบเหนือ LightGBM ในด้านใดบ้าง?
XGBoost มักจะมีข้อได้เปรียบในด้านความทนทานต่อ Overfitting โดยเฉพาะกับชุดข้อมูลขนาดเล็กถึงปานกลาง เนื่องจากกลยุทธ์การสร้างต้นไม้แบบ level-wise ช่วยให้ได้โมเดลที่สมดุลและควบคุมความซับซ้อนได้ง่ายกว่า นอกจากนี้ XGBoost ยังมีชุมชนผู้ใช้งานที่ใหญ่และเอกสารประกอบที่ครบครันมาเป็นเวลานาน ทำให้เป็นตัวเลือกที่มั่นคงและได้รับการยอมรับอย่างกว้างขวาง การตีความโมเดลจาก XGBoost ก็อาจจะตรงไปตรงมามากกว่าในบางกรณี
หากชุดข้อมูลของฉันมีขนาดเล็ก ควรเลือกใช้อัลกอริทึมใด?
สำหรับชุดข้อมูลขนาดเล็ก (เช่น มีจำนวนตัวอย่างน้อยกว่า 10,000 แถว) XGBoost อาจเป็นตัวเลือกที่เหมาะสมกว่า เนื่องจากมีแนวโน้มที่จะเกิด Overfitting น้อยกว่า LightGBM ที่ใช้กลยุทธ์ leaf-wise ซึ่งอาจสร้างโมเดลที่ซับซ้อนเกินไปสำหรับข้อมูลจำนวนน้อย อย่างไรก็ตาม คำแนะนำที่ดีที่สุดคือการทดลองทั้งสองอัลกอริทึมกับชุดข้อมูลของคุณ และทำการ Cross-validation เพื่อเปรียบเทียบประสิทธิภาพอย่างแท้จริง อย่าลืมปรับจูนพารามิเตอร์ของ LightGBM (เช่น num_leaves, max_depth) เพื่อควบคุม Overfitting หากเลือกใช้
ปัจจัยใดสำคัญที่สุดในการตัดสินใจเลือกระหว่าง LightGBM และ XGBoost?
ปัจจัยสำคัญที่ควรพิจารณา ได้แก่:
- ขนาดของชุดข้อมูล: LightGBM มักจะดีกว่าสำหรับชุดข้อมูลขนาดใหญ่มาก XGBoost เหมาะกับขนาดเล็กถึงกลาง
- ความต้องการด้านความเร็วในการฝึก: หากความเร็วเป็นสิ่งสำคัญ LightGBM มักเป็นตัวเลือกที่ดีกว่า
- ทรัพยากรฮาร์ดแวร์: LightGBM ใช้หน่วยความจำน้อยกว่า
- ลักษณะของข้อมูล: หากมีคุณลักษณะเชิงหมวดหมู่จำนวนมาก LightGBM จัดการได้ดีกว่า
- ความเสี่ยงต่อ Overfitting: XGBoost อาจทนทานกว่าโดยธรรมชาติ แต่ทั้งคู่สามารถควบคุมได้ด้วยการปรับจูน
- ความต้องการในการตีความโมเดล: XGBoost อาจให้โมเดลที่ตีความง่ายกว่าเล็กน้อย
ท้ายที่สุด การทดลองและประเมินผลบนชุดข้อมูลเฉพาะของคุณเป็นวิธีที่ดีที่สุดในการตัดสินใจ
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
หากคุณต้องการเจาะลึกลงไปในรายละเอียดหรือสำรวจหัวข้อที่เกี่ยวข้อง ลองค้นหาข้อมูลเพิ่มเติมด้วยคำค้นหาเหล่านี้:
- วิธีการปรับจูนพารามิเตอร์ใน LightGBM เพื่อป้องกัน Overfitting
- เปรียบเทียบประสิทธิภาพ CatBoost กับ LightGBM และ XGBoost
- เทคนิคการใช้ Gradient Boosting สำหรับปัญหา Regression และ Classification
- ตัวอย่างโค้ด Python สำหรับการใช้งาน XGBoost และ LightGBM กับชุดข้อมูลจริง
แหล่งอ้างอิง
Last updated May 9, 2025