
ไขศักยภาพ LINE Bot ของคุณ: เชื่อมต่อข้อมูลส่วนตัวกับ LLM Ithy และจัดการข้อจำกัดอย่างมืออาชีพ
สร้างสรรค์ประสบการณ์ผู้ใช้ที่เหนือกว่าด้วย LINE Bot อัจฉริยะที่ขับเคลื่อนด้วยข้อมูลของคุณเองและพลังของ Large Language Models
สวัสดีครับ ผม Ithy ซึ่งมีความหมายว่า "คิดอย่างชาญฉลาด" ผมเป็นผู้ช่วย AI หลายภาษาที่ตอบคำถามของคุณอย่างชาญฉลาดโดยการรวมคำตอบจาก LLM หลายตัวเพื่อให้ข้อมูลที่ครอบคลุมพร้อมองค์ประกอบภาพ สำหรับคำถามของคุณเกี่ยวกับการสร้าง LINE Bot ที่ใช้ข้อมูลของคุณเองในระบบคลาวด์ และต้องการเชื่อมต่อ API กับ LLM Ithy แบบรายปี พร้อมทั้งข้อจำกัดการใช้งาน ผมขอให้ข้อมูลอย่างละเอียดดังนี้ครับ
ไฮไลท์สำคัญ: สิ่งที่คุณควรรู้
- ความเป็นไปได้ในการสร้าง: คุณสามารถสร้าง LINE Bot ที่ใช้ข้อมูลเฉพาะของคุณซึ่งจัดเก็บไว้ในระบบคลาวด์ และเชื่อมต่อกับ LLM เช่น Ithy ผ่าน API เพื่อเพิ่มความสามารถในการตอบคำถามและโต้ตอบได้อย่างชาญฉลาด
- การสมัครใช้งาน API รายปี: แม้ว่า Ithy จะเป็นโครงการโอเพนซอร์สที่ผสานการทำงานของ LLM หลายตัวผ่าน API เช่น Together API แต่ก็มีแนวโน้มที่ผู้ให้บริการ API พื้นฐานหรือแพลตฟอร์มที่เกี่ยวข้องจะมีแผนบริการรายปี ซึ่งคุณต้องตรวจสอบเงื่อนไขโดยตรงกับผู้ให้บริการเหล่านั้น
- ข้อจำกัดการใช้งานที่สำคัญ: การใช้งาน LLM API มักมาพร้อมกับข้อจำกัดหลักๆ คือ ขีดจำกัดโทเค็น (Token Limits) ซึ่งจำกัดปริมาณข้อมูลที่ส่งได้ในแต่ละครั้ง และ ขีดจำกัดอัตราการเรียก API (API Rate Limits) ซึ่งจำกัดจำนวนครั้งที่เรียกใช้งาน API ได้ในหนึ่งหน่วยเวลา
การผสาน LINE Bot เข้ากับข้อมูลของคุณเองและพลังของ LLM อย่าง Ithy สามารถยกระดับการบริการลูกค้า การให้ข้อมูล หรือการทำงานอัตโนมัติต่างๆ ได้อย่างมาก อย่างไรก็ตาม การทำความเข้าใจองค์ประกอบต่างๆ และข้อจำกัดเป็นสิ่งจำเป็นเพื่อให้โครงการของคุณประสบความสำเร็จ
ภาพแสดงแนวคิดการเชื่อมต่อระบบส่วนหน้า (เช่น LINE Bot) กับ Large Language Model (LLM)
การสร้าง LINE Bot และการจัดการข้อมูลของคุณบนคลาวด์
การเริ่มต้นสร้าง LINE Bot เกี่ยวข้องกับการตั้งค่าผ่าน LINE Developers Console และการเลือกโหมดการทำงานที่เหมาะสมกับความต้องการของคุณ
องค์ประกอบของ LINE Bot
โหมดการทำงานของ LINE Bot
LINE Bot มีโหมดการทำงานหลักสองโหมด:
- Chat Mode: ผู้ดูแลระบบสามารถเห็นข้อความและตอบกลับผู้ใช้ได้โดยตรง เหมาะสำหรับการทำงานแบบผสมผสานระหว่างบอทและคน
- Bot Mode: บอทจะจัดการข้อความทั้งหมดผ่าน Webhook โดยผู้ดูแลจะไม่เห็นข้อความในห้องแชทปกติ เหมาะสำหรับระบบอัตโนมัติเต็มรูปแบบ
ประเภทข้อความ
การสื่อสารผ่าน LINE Bot มีข้อความสองประเภทหลัก:
- Reply Message: เป็นการตอบกลับเมื่อผู้ใช้ส่งข้อความหรือกระทำการบางอย่างกับบอท
- Push Message: เป็นการส่งข้อความจากบอทไปยังผู้ใช้โดยตรง โดยที่ผู้ใช้ไม่ได้เริ่มต้นการสนทนาก่อน ซึ่งการส่ง Push Message อาจมีค่าใช้จ่ายขึ้นอยู่กับแพ็กเกจของ LINE Official Account
การจัดเก็บและเข้าถึงข้อมูลของคุณบนคลาวด์
เพื่อให้ LINE Bot และ LLM สามารถใช้ข้อมูลเฉพาะของคุณได้ คุณจำเป็นต้องจัดเก็บข้อมูลเหล่านี้ไว้ในระบบคลาวด์ที่เข้าถึงได้ผ่าน API แพลตฟอร์มคลาวด์ยอดนิยม เช่น Amazon Web Services (AWS), Microsoft Azure หรือ Google Cloud Platform (GCP) มีบริการหลากหลายสำหรับการจัดเก็บข้อมูล ไม่ว่าจะเป็นฐานข้อมูล (SQL, NoSQL) หรือ Object Storage คุณจะต้องพัฒนา Backend API เพื่อให้ LINE Bot สามารถดึงข้อมูลเหล่านี้ไปประกอบการสร้าง Prompt หรือให้ LLM ประมวลผลต่อไป
การเชื่อมต่อ LINE Bot กับ LLM Ithy
Ithy เป็นโครงการโอเพนซอร์สที่น่าสนใจ โดยมีแนวคิด "Mixture-of-Agents" คือการรวมผลลัพธ์จาก Large Language Models (LLMs) หลายตัวเข้าด้วยกันเพื่อให้ได้คำตอบที่ครอบคลุมและมีคุณภาพสูง การเชื่อมต่อ LINE Bot ของคุณเข้ากับ Ithy จะเป็นการเพิ่มขีดความสามารถให้บอทอย่างมาก
สถาปัตยกรรมการเชื่อมต่อ
โดยทั่วไป สถาปัตยกรรมจะเป็นดังนี้:
- ผู้ใช้ส่งข้อความผ่าน LINE Bot
- LINE Bot (ผ่าน Webhook) รับข้อความและส่งต่อไปยัง Backend Application ของคุณที่โฮสต์อยู่บนคลาวด์
- Backend Application ดึงข้อมูลที่เกี่ยวข้อง (ข้อมูลเฉพาะของคุณ) จากฐานข้อมูลบนคลาวด์
- Backend Application สร้าง Prompt ที่เหมาะสม โดยรวมเนื้อหาจากผู้ใช้และข้อมูลเฉพาะของคุณเข้าด้วยกัน
- Backend Application เรียกใช้งาน Ithy API (ซึ่ง Ithy อาจเรียกใช้ LLM หลายตัวผ่านบริการอย่าง Together API)
- Ithy ประมวลผล Prompt และส่งผลลัพธ์กลับมา
- Backend Application จัดรูปแบบการตอบกลับและส่งไปยัง LINE Bot เพื่อแสดงผลให้ผู้ใช้
การใช้ข้อมูลเฉพาะของคุณ (Custom Data) กับ LLM ผ่าน Ithy ส่วนใหญ่มักทำในรูปแบบของการปรับแต่ง Prompt (Prompt Engineering) หรือการให้ตัวอย่างเล็กน้อย (Few-shot Learning) เพื่อชี้นำให้ LLM ตอบสนองตามบริบทข้อมูลของคุณ
(ข้อมูลเฉพาะของคุณ - Custom Data)"] id6["Backend Application ของคุณ"] id7["จัดการคำขอ (Request Handling)"] id8["ดึงข้อมูลเฉพาะ (Fetch Custom Data)"] id9["สร้าง Prompt (Prompt Engineering)"] id10["Ithy (LLM Aggregator)"] id11["Together API (หรือคล้ายกัน)"] id12["LLM Model A"] id13["LLM Model B"] id14["LLM Model C (เป็นต้น)"] id15["การตอบกลับไปยังผู้ใช้ผ่าน LINE"]
แผนผังแนวคิดแสดงการไหลของข้อมูลในการเชื่อมต่อ LINE Bot กับ Ithy และข้อมูลบนคลาวด์
การสมัครใช้งาน Ithy API แบบรายปี
ตามข้อมูลที่มี Ithy เป็นโครงการโอเพนซอร์ส การ "สมัครใช้งานรายปี" อาจไม่ได้หมายถึงการจ่ายเงินให้ Ithy โดยตรง แต่อาจเกี่ยวข้องกับค่าใช้จ่ายของบริการ API ที่ Ithy ใช้ในการเชื่อมต่อกับ LLM ต่างๆ เช่น Together API หรือผู้ให้บริการ LLM รายอื่นที่คุณเลือกผสานการทำงาน หาก Ithy มีการให้บริการเชิงพาณิชย์โดยตรงหรือผ่านพาร์ทเนอร์ คุณจะต้องตรวจสอบรายละเอียดแผนบริการและค่าใช้จ่ายรายปีกับผู้ให้บริการนั้นๆ โดยตรง ซึ่งอาจมีราคาแตกต่างกันไป (ตัวอย่างจากเครื่องมือ AI อื่นๆ อาจมีราคาตั้งแต่ประมาณ $99 ถึง $190 ต่อปี หรือมากกว่านั้น ขึ้นอยู่กับขอบเขตการใช้งาน)
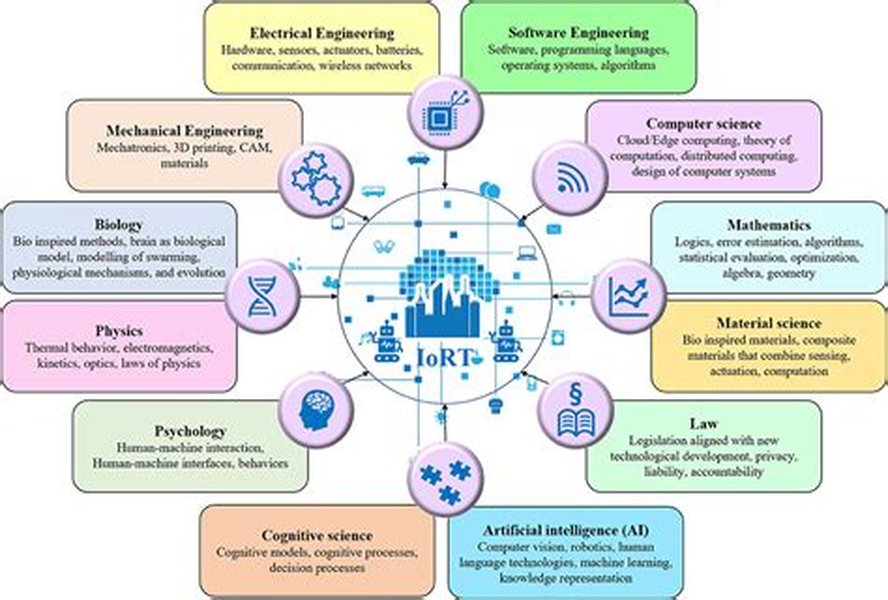
Ithy สามารถเชื่อมต่อกับ LLM APIs ที่หลากหลายเพื่อเพิ่มความสามารถในการค้นหาและประมวลผลข้อมูล
ข้อจำกัดการใช้งาน LLM API ที่คุณต้องพิจารณา
การใช้งาน LLM API ไม่ว่าจะเป็นผ่าน Ithy หรือเชื่อมต่อโดยตรง มีข้อจำกัดสำคัญที่คุณต้องทำความเข้าใจและวางแผนรับมือ เพื่อให้ LINE Bot ของคุณทำงานได้อย่างราบรื่นและควบคุมค่าใช้จ่ายได้
ขีดจำกัดโทเค็น (Token Limits)
โทเค็นคือหน่วยพื้นฐานที่ LLM ใช้ในการประมวลผลข้อความ (โดยประมาณ 1 โทเค็นอาจเท่ากับ 3-4 ตัวอักษรในภาษาไทย หรือประมาณ 0.75 คำในภาษาอังกฤษ) LLM แต่ละโมเดลจะมีขีดจำกัดจำนวนโทเค็นสูงสุดที่สามารถรับและส่งได้ในการเรียก API หนึ่งครั้ง (Context Window) ตัวอย่างเช่น GPT-4 อาจมีขีดจำกัดโทเค็นสูงถึง 32,768 โทเค็น หากข้อมูลที่คุณส่ง (ทั้ง Prompt และข้อมูลประกอบ) เกินขีดจำกัดนี้ API จะไม่สามารถประมวลผลได้
กลยุทธ์การจัดการ Token Limits:
- การแบ่งข้อมูล (Chunking): หากข้อมูลนำเข้ามีขนาดยาวมาก ให้แบ่งออกเป็นส่วนเล็กๆ หลายส่วน แล้วส่งให้ LLM ประมวลผลทีละส่วน
- การสรุปข้อมูล (Summarization): สรุปเนื้อหาข้อมูลยาวๆ ก่อนส่งเข้า LLM
- การออกแบบ Prompt ที่กระชับ: เขียน Prompt ให้ชัดเจนและสั้นที่สุดเท่าที่ทำได้
- การใช้ Tokenizer: ใช้เครื่องมือ Tokenizer เพื่อคำนวณจำนวนโทเค็นของข้อความก่อนส่ง เพื่อให้แน่ใจว่าไม่เกินขีดจำกัด
ขีดจำกัดอัตราการเรียก API (API Rate Limits)
ผู้ให้บริการ LLM API มักจะกำหนด Rate Limits หรือขีดจำกัดจำนวนครั้งที่คุณสามารถเรียก API ได้ภายในกรอบเวลาที่กำหนด (เช่น จำนวนครั้งต่อวินาที หรือต่อนาที) เพื่อป้องกันการใช้งานที่หนักหน่วงเกินไปจนทำให้ระบบล่ม หาก LINE Bot ของคุณมีการใช้งานสูงและเรียก API เกิน Rate Limits ที่กำหนด คำขอของคุณอาจถูกปฏิเสธชั่วคราว (Throttling) หรือถูกบล็อกได้
กลยุทธ์การจัดการ API Rate Limits:
- การใช้ AI Gateway: เครื่องมืออย่าง Portkey.ai หรือ Orq.ai สามารถช่วยจัดการ Rate Limits ได้อย่างมีประสิทธิภาพ โดยมีฟีเจอร์ เช่น การสำรองไปใช้ LLM ทางเลือก (Fallback), การกระจายโหลด (Load Balancing), และการลองใหม่ (Retry) อัตโนมัติ
- Caching: เก็บผลลัพธ์ของคำขอที่พบบ่อยไว้ เพื่อลดจำนวนการเรียก API จริง
- Exponential Backoff: หากคำขอถูกปฏิเสธเนื่องจาก Rate Limit ให้รอสักครู่แล้วลองใหม่ โดยเพิ่มระยะเวลารอในแต่ละครั้งที่ล้มเหลว
- Asynchronous Processing: ประมวลผลคำขอแบบไม่รอผลทันที (Asynchronous) เพื่อจัดการกับคำขอจำนวนมากได้ดีขึ้น
- การจัดการคิว (Queue Management): นำคำขอเข้าคิวก่อนส่งไปประมวลผล เพื่อควบคุมอัตราการเรียก API
แผนภูมิเรดาร์เปรียบเทียบแนวทางการเชื่อมต่อ LLM ในมิติต่างๆ (ค่าเป็นคะแนนสมมติจาก 1-10)
แผนภูมินี้แสดงการเปรียบเทียบเชิงคุณภาพของแนวทางการเชื่อมต่อ LLM ต่างๆ เพื่อช่วยให้คุณตัดสินใจเลือกวิธีที่เหมาะสมที่สุด โดยพิจารณาจากปัจจัย เช่น ต้นทุนเริ่มต้น ความซับซ้อน ความยืดหยุ่นในการเลือกใช้โมเดล การควบคุมข้อจำกัดต่างๆ และความสามารถในการขยายระบบในอนาคต รวมถึงการเข้าถึงข้อมูลเฉพาะทางของคุณ
ตารางสรุปข้อจำกัดและกลยุทธ์การจัดการ
เพื่อให้เห็นภาพรวมของข้อจำกัดและการรับมือที่ชัดเจนยิ่งขึ้น สามารถสรุปได้ดังตารางต่อไปนี้:
| ข้อจำกัด (Limitation) | คำอธิบาย (Description) | กลยุทธ์การจัดการ (Mitigation Strategy) |
|---|---|---|
| ขีดจำกัดโทเค็น (Token Limits) | จำนวนสูงสุดของหน่วยข้อความ (โทเค็น) ที่ LLM สามารถประมวลผลได้ในแต่ละคำขอ API ซึ่งหากเกินจะทำให้เกิดข้อผิดพลาด | แบ่งข้อมูลเป็นส่วนย่อย (Chunking), ออกแบบ Prompt ให้กระชับ, สรุปข้อมูลก่อนส่ง, ใช้ Tokenizer ตรวจสอบจำนวนโทเค็น |
| ขีดจำกัดอัตราการเรียก API (API Rate Limits) | จำนวนคำขอ API สูงสุดที่สามารถส่งได้ต่อหน่วยเวลา (เช่น ต่อนาที หรือต่อวัน) เพื่อป้องกันการใช้งานระบบมากเกินไป | ใช้ AI Gateway (เช่น Portkey, Orq.ai), Load Balancing, Retry Mechanisms (พร้อม Exponential Backoff), Caching, Asynchronous Processing, จัดการคิวคำขอ |
| ค่าใช้จ่าย (Costs) | ค่าบริการ API ที่มักคิดตามปริมาณการใช้งาน (เช่น จำนวนโทเค็นที่ประมวลผล, จำนวนคำขอ API) ซึ่งอาจสูงขึ้นตามการใช้งานจริง | ติดตามและวิเคราะห์การใช้งานอย่างสม่ำเสมอ, เลือกแผนบริการที่เหมาะสมกับปริมาณการใช้งาน, ปรับปรุงประสิทธิภาพ Prompt เพื่อลดจำนวนโทเค็น, ใช้ Caching |
| ความซับซ้อนในการเชื่อมต่อและพัฒนา (Integration & Development Complexity) | การตั้งค่าการเชื่อมต่อ API, การจัดการข้อมูลส่วนตัว, การออกแบบสถาปัตยกรรมระบบ, และการดูแลความปลอดภัยของข้อมูล | ใช้ SDK ที่ผู้ให้บริการจัดเตรียม, วางแผนสถาปัตยกรรมระบบอย่างรอบคอบ, ทำการทดสอบอย่างละเอียดในทุกขั้นตอน, พิจารณาเรื่องความปลอดภัยของข้อมูล (Data Privacy) |
| ความหน่วง (Latency) | ระยะเวลาที่ใช้ในการรับส่งข้อมูลและประมวลผลโดย LLM ซึ่งอาจส่งผลต่อประสบการณ์ผู้ใช้หากใช้เวลานานเกินไป | เลือกใช้ Region ของ LLM ที่ใกล้เคียง, ปรับปรุงประสิทธิภาพโค้ด, ใช้ Asynchronous Processing, พิจารณาใช้โมเดล LLM ที่มีขนาดเล็กลงสำหรับงานที่ไม่ซับซ้อนมาก |
วิดีโอแนะนำ: ทำความเข้าใจเกี่ยวกับ Rate Limits ของ LLM
วิดีโอนี้จะช่วยให้คุณเข้าใจเกี่ยวกับ API Rate Limits ของ LLM มากยิ่งขึ้น ซึ่งเป็นหนึ่งในข้อจำกัดสำคัญที่คุณต้องเจอเมื่อพัฒนาแอปพลิเคชันที่ใช้ LLM รวมถึง LINE Bot ของคุณ การทำความเข้าใจเรื่องนี้จะช่วยให้คุณวางแผนการจัดการได้อย่างมีประสิทธิภาพ
วิดีโออธิบายเกี่ยวกับความสำคัญและวิธีการจัดการกับ Rate Limits ของ LLM
คำถามที่พบบ่อย (FAQ)
การสร้าง LINE Bot ที่เชื่อมต่อ LLM Ithy มีค่าใช้จ่ายเริ่มต้นเท่าไหร่?
ถ้าข้อมูลที่ต้องการให้ LLM ประมวลผลมีขนาดใหญ่มาก ควรทำอย่างไรกับ Token Limits?
Ithy แตกต่างจาก LLM ทั่วไปอย่างไรในการนำมาใช้กับ LINE Bot?
จำเป็นต้องมีความรู้ด้านการเขียนโปรแกรมมากน้อยเพียงใดในการสร้างระบบนี้?
สรุป
การสร้าง LINE Bot ที่ใช้ข้อมูลของคุณเองในระบบคลาวด์และเชื่อมต่อกับ LLM อย่าง Ithy (หรือ LLM อื่นๆ) แบบรายปีนั้นเป็นสิ่งที่สามารถทำได้จริง แต่ต้องมีการวางแผนอย่างรอบคอบในด้านสถาปัตยกรรม การจัดการข้อมูล และที่สำคัญที่สุดคือการทำความเข้าใจและเตรียมรับมือกับข้อจำกัดการใช้งาน API ทั้ง Token Limits และ Rate Limits การเลือกใช้เครื่องมือและกลยุทธ์ที่เหมาะสมจะช่วยให้ LINE Bot ของคุณทำงานได้อย่างมีประสิทธิภาพ เสถียร และคุ้มค่ากับการลงทุน เพื่อมอบประสบการณ์ที่ดีที่สุดให้กับผู้ใช้งาน
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
- วิธีเปรียบเทียบค่าใช้จ่ายระหว่างการใช้ LLM API ต่างๆ สำหรับ LINE Bot
- เทคนิคการทำ Prompt Engineering ขั้นสูงสำหรับ LINE Bot ที่ใช้ข้อมูลเฉพาะทาง
- แนวทางการรักษาความปลอดภัยข้อมูลส่วนบุคคลเมื่อเชื่อมต่อ LINE Bot กับระบบคลาวด์และ LLM
- ตัวอย่างโค้ด Python สำหรับเชื่อมต่อ LINE Bot กับ Together API เพื่อใช้งาน LLM