
Jak Uczą Się Modele LLM i Czy Twoje Dane Są Bezpieczne? Odkrywamy Tajniki Sztucznej Inteligencji
Zrozumienie mechanizmów nauki Dużych Modeli Językowych, ich pamięci oraz implikacji dla bezpieczeństwa Twoich poufnych informacji.
Duże Modele Językowe (LLM) zrewolucjonizowały sposób, w jaki interakcja z technologią jest możliwa, oferując zdolności generowania tekstu, tłumaczenia, odpowiadania na pytania i wiele więcej. Jednakże, wraz z ich rosnącą popularnością, pojawiają się istotne pytania dotyczące sposobu ich uczenia się, tego, co "pamiętają" z naszych interakcji, oraz bezpieczeństwa danych, które im powierzamy. Zrozumienie tych aspektów jest kluczowe dla świadomego i bezpiecznego korzystania z tych potężnych narzędzi.
Najważniejsze Informacje w Pigułce
- LLM uczą się na wzorcach: Modele te są trenowane na gigantycznych zbiorach danych tekstowych, ucząc się rozpoznawać schematy językowe, a nie zapamiętywać konkretne informacje słowo w słowo.
- Ograniczona "pamięć" interakcji: LLM zazwyczaj utrzymują kontekst rozmowy tylko w ramach bieżącej sesji; nie przechowują trwale specyficznych danych użytkownika w swoich podstawowych parametrach.
- Ostrożność z danymi poufnymi: Zaleca się unikanie wprowadzania wrażliwych lub poufnych informacji do publicznie dostępnych modeli LLM ze względu na potencjalne ryzyko naruszenia prywatności i bezpieczeństwa.
Mechanizm Nauki Dużych Modeli Językowych
Sercem Dużych Modeli Językowych jest proces uczenia maszynowego, a konkretnie głębokiego uczenia. Modele te, często oparte na architekturze zwanej "Transformer", są trenowane na olbrzymich ilościach danych tekstowych pochodzących z różnorodnych źródeł, takich jak książki, artykuły, strony internetowe i inne publicznie dostępne teksty. Celem tego procesu nie jest dosłowne zapamiętanie treści, ale raczej nauczenie się złożonych wzorców, struktur gramatycznych, zależności semantycznych oraz kontekstu, w jakim występują słowa i frazy.
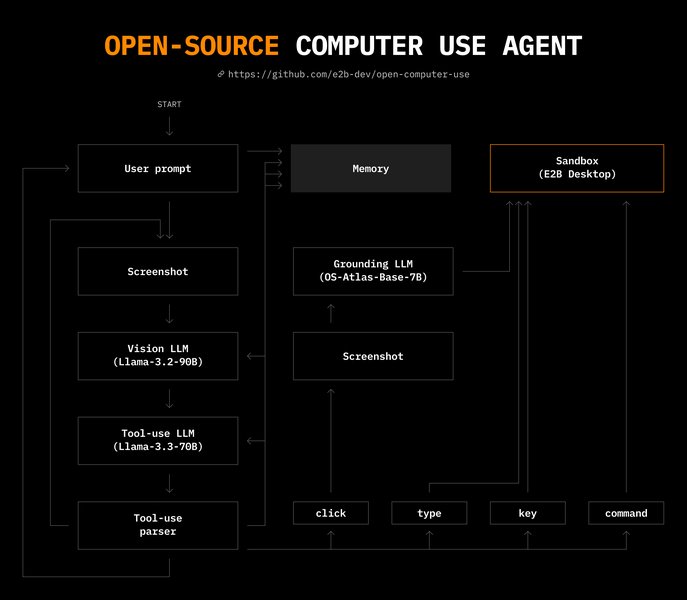
Przykładowy schemat ilustrujący złożoną architekturę modelu sztucznej inteligencji, podobną do tej wykorzystywanej w LLM.
Etapy i Metody Uczenia
Proces nauki LLM można podzielić na kilka kluczowych aspektów:
1. Trening na Ogromnych Korpusach Tekstowych
Modele są "karmione" miliardami, a nawet bilionami słów. Podczas tego etapu, zwanego często "pre-trainingiem" (wstępnym treningiem), model uczy się przewidywać następne słowo w sekwencji lub uzupełniać brakujące fragmenty tekstu. To pozwala mu zrozumieć statystyczne zależności w języku.
2. Architektura Transformer i Mechanizm Uwagi
Większość nowoczesnych LLM wykorzystuje architekturę Transformer. Kluczowym jej elementem jest "mechanizm uwagi" (attention mechanism), który pozwala modelowi ważyć znaczenie różnych słów w tekście wejściowym podczas generowania odpowiedzi. Dzięki temu model może skupić się na najbardziej relevantnych fragmentach kontekstu, nawet jeśli są one odległe w tekście.
3. Parametry Modelu
LLM posiadają miliony, a nawet miliardy parametrów. Są to wartości liczbowe, które model dostosowuje podczas procesu treningu. To właśnie te parametry kodują "wiedzę" modelu o języku. Im więcej parametrów, tym potencjalnie model może nauczyć się bardziej złożonych wzorców.
4. Uczenie Nadzorowane i Nienadzorowane
Wstępny trening często odbywa się metodą nienadzorowaną, gdzie model uczy się samodzielnie na podstawie surowych danych tekstowych. Następnie może przejść fazę "fine-tuning" (dostrajania), która często wykorzystuje uczenie nadzorowane. W tym etapie model jest trenowany na mniejszych, bardziej specjalistycznych zbiorach danych, aby lepiej wykonywać konkretne zadania (np. odpowiadanie na pytania, tłumaczenie, podsumowywanie).
Ważne jest zrozumienie, że wiedza LLM jest zasadniczo "zamrożona" w momencie zakończenia treningu. Oznacza to, że model nie uczy się w czasie rzeczywistym z każdej interakcji z użytkownikiem, chyba że jest to specyficznie zaimplementowana funkcja w danym systemie, a jego wiedza o świecie kończy się na dacie ostatnich danych treningowych.
Film wyjaśniający, jak działają Duże Modele Językowe, takie jak ChatGPT, co może pomóc w zrozumieniu podstaw ich funkcjonowania.
Czy LLM "Zapamiętują" Wprowadzane Dane?
To jedno z najczęstszych pytań dotyczących LLM. Odpowiedź jest złożona. Modele LLM nie działają jak tradycyjne bazy danych, które przechowują każdą wprowadzoną informację w sposób dosłowny i trwały. Ich "pamięć" jest bardziej abstrakcyjna i kontekstowa.
Pamięć Krótkoterminowa (Kontekst Sesji)
Podczas pojedynczej interakcji (sesji rozmowy), LLM utrzymuje tzw. "kontekst". Oznacza to, że zapamiętuje poprzednie fragmenty rozmowy, aby generować spójne i adekwatne odpowiedzi. Ten kontekst jest jednak ograniczony (np. do określonej liczby słów lub tokenów) i zazwyczaj jest tracony po zakończeniu sesji lub po pewnym czasie nieaktywności, o ile system nie został zaprojektowany inaczej (np. w celu personalizacji).
Brak Trwałego Zapamiętywania Indywidualnych Danych w Modelu
Dane wprowadzane przez użytkownika podczas typowej interakcji nie są bezpośrednio włączane do podstawowych parametrów modelu, które zostały ustalone podczas głównego procesu treningu. Model nie "uczy się" na nowo od każdego użytkownika w sposób modyfikujący jego fundamentalną wiedzę. Zamiast tego, generuje odpowiedzi w oparciu o wzorce i wiedzę nabytą podczas treningu, stosując je do bieżącego kontekstu rozmowy.
Należy jednak pamiętać, że dostawcy usług LLM mogą przechowywać historię interakcji dla różnych celów, takich jak ulepszanie modeli, monitorowanie nadużyć czy debugowanie. Polityki prywatności poszczególnych usługodawców określają, jak te dane są gromadzone, wykorzystywane i jak długo przechowywane.
Wizualizacja Aspektów Przetwarzania Danych przez LLM
Poniższy diagram radarowy przedstawia subiektywną ocenę różnych aspektów związanych z przetwarzaniem danych przez typowe Duże Modele Językowe. Skala ocen (od 1 do 10) jest orientacyjna i ma na celu zilustrowanie ogólnych tendencji, gdzie wyższa wartość oznacza większą intensywność danego aspektu.
Diagram ten ilustruje, że choć LLM doskonale uczą się wzorców i potrafią generalizować wiedzę, ich zdolność do trwałego zapamiętywania indywidualnych danych użytkownika w samym rdzeniu modelu jest niska. Jednocześnie, ryzyko dla danych poufnych jest znaczące, a kontrola użytkownika nad tym, co dzieje się z jego danymi po wprowadzeniu, jest często ograniczona w przypadku publicznych platform.
Czy Warto Wprowadzać Dane Poufne do Modeli LLM?
Odpowiedź na to pytanie jest zasadniczo negatywna, zwłaszcza w kontekście publicznie dostępnych modeli LLM. Istnieje kilka kluczowych powodów, dla których należy zachować szczególną ostrożność:
Kwestie ochrony danych osobowych (jak RODO) są niezwykle istotne w kontekście systemów AI, w tym LLM.
Potencjalne Ryzyka
- Przechowywanie i analiza danych przez dostawców: Jak wspomniano, dostawcy usług LLM mogą gromadzić dane z interakcji w celu ulepszania swoich usług, monitorowania lub zapewnienia zgodności. Oznacza to, że Twoje dane mogą być przechowywane na serwerach firm trzecich.
- Ryzyko wycieku danych: Chociaż dostawcy stosują środki bezpieczeństwa, żadny system nie jest w 100% odporny na ataki cybernetyczne lub błędy ludzkie, które mogą prowadzić do nieautoryzowanego dostępu lub wycieku danych.
- Możliwość wykorzystania danych do przyszłego treningu: W niektórych przypadkach dane (zazwyczaj zanonimizowane lub zagregowane) mogą być wykorzystywane do dalszego trenowania modeli, co budzi obawy o prywatność, jeśli oryginalne dane zawierały wrażliwe informacje.
- Ataki typu "Model Inversion" i "Membership Inference": Są to zaawansowane techniki, które teoretycznie mogłyby pozwolić na próbę odtworzenia fragmentów danych treningowych lub stwierdzenia, czy konkretne dane były częścią zbioru treningowego. Chociaż trudne do przeprowadzenia, stanowią potencjalne zagrożenie.
- Złożoność przepływu danych: Dane wprowadzane do globalnych systemów LLM mogą być przetwarzane w różnych jurysdykcjach, co komplikuje kwestie zgodności z lokalnymi przepisami o ochronie danych.
Zalecenia Dotyczące Danych Poufnych
Generalnie, nie zaleca się wprowadzania do publicznych modeli LLM informacji takich jak:
- Dane osobowe (numery PESEL, NIP, adresy, numery telefonów)
- Dane finansowe (numery kart kredytowych, dane kont bankowych)
- Informacje medyczne
- Tajemnice handlowe i informacje biznesowe o charakterze poufnym
- Hasła i inne dane uwierzytelniające
Alternatywy dla Przetwarzania Danych Poufnych
Jeśli istnieje potrzeba wykorzystania LLM do przetwarzania wrażliwych danych, warto rozważyć:
- Lokalne modele AI: Uruchamianie modeli LLM na własnej infrastrukturze (on-premise) daje znacznie większą kontrolę nad danymi.
- Prywatne instancje modeli w chmurze: Niektórzy dostawcy oferują możliwość korzystania z modeli w izolowanym środowisku, z silniejszymi gwarancjami bezpieczeństwa i prywatności.
- Rozwiązania dedykowane z odpowiednimi certyfikatami bezpieczeństwa: Wybieranie usług, które są zgodne z odpowiednimi standardami i regulacjami (np. GDPR, HIPAA).
- Konsultacja z ekspertami ds. bezpieczeństwa i prawnikami: Przed przetwarzaniem dużych ilości danych wrażliwych za pomocą LLM, zawsze warto zasięgnąć profesjonalnej porady.
Podsumowanie Kluczowych Zagadnień w Formie Mapy Myśli
Poniższa mapa myśli przedstawia główne koncepcje związane z działaniem i bezpieczeństwem Dużych Modeli Językowych, o których była mowa. Pomaga ona zwizualizować zależności między sposobem uczenia się LLM, ich "pamięcią" oraz kwestiami bezpieczeństwa danych.
Tabela Ryzyk i Rekomendacji
Poniższa tabela podsumowuje kluczowe ryzyka związane z wprowadzaniem danych do LLM oraz rekomendacje dotyczące postępowania, zwłaszcza w kontekście informacji poufnych.
| Aspekt | Potencjalne Ryzyko | Rekomendacja |
|---|---|---|
| Dane osobowe | Kradzież tożsamości, naruszenie prywatności, profilowanie | Nie wprowadzać do publicznych LLM; stosować anonimizację, jeśli konieczne i możliwe. |
| Dane finansowe | Oszustwa finansowe, nieautoryzowane transakcje | Absolutnie unikać wprowadzania do publicznych LLM. |
| Tajemnice handlowe | Utrata przewagi konkurencyjnej, szpiegostwo przemysłowe | Nie wprowadzać; korzystać z zabezpieczonych, prywatnych systemów LLM. |
| Ogólne dane konwersacyjne | Przechowywanie przez dostawcę, potencjalne wykorzystanie do treningu modeli | Być świadomym polityki prywatności usługi; unikać dzielenia się informacjami, których ujawnienie mogłoby być szkodliwe. |
| Dane medyczne | Naruszenie prywatności pacjenta, dyskryminacja | Nie wprowadzać do publicznych LLM; korzystać z systemów zgodnych z HIPAA lub równoważnymi regulacjami. |
| Interakcje z LLM | Możliwość odtworzenia części danych (ataki "inference"), niezamierzone "nauczenie" modelu niepożądanych wzorców (w ograniczonym zakresie, bardziej dotyczy fine-tuning) | Regularnie przeglądać ustawienia prywatności, być świadomym, że interakcje mogą być logowane. |
Często Zadawane Pytania (FAQ)
Jak dokładnie modele LLM uczą się języka?
Modele LLM uczą się poprzez analizę ogromnych ilości tekstu, identyfikując statystyczne wzorce i zależności między słowami oraz całymi frazami. Wykorzystują do tego zaawansowane architektury sieci neuronowych, takie jak Transformer, które pozwalają im rozumieć kontekst i generować spójny, naturalnie brzmiący tekst. Proces ten polega na przewidywaniu kolejnych elementów w sekwencji tekstowej lub uzupełnianiu brakujących fragmentów.
Czy LLM zapamiętują moje rozmowy na zawsze?
Standardowo, LLM nie zapamiętują treści konkretnych rozmów w swojej trwałej "pamięci" modelowej po zakończeniu sesji. Utrzymują kontekst w trakcie trwania interakcji, aby móc prowadzić spójną konwersację. Jednakże, dostawcy usług mogą przechowywać logi interakcji zgodnie ze swoimi politykami prywatności (np. w celu ulepszania usług). Nie oznacza to, że sam model fundamentalnie się zmienia po każdej rozmowie.
Jakie dane są uważane za poufne w kontekście LLM?
Dane poufne to wszelkie informacje, których ujawnienie mogłoby prowadzić do szkody, naruszenia prywatności lub strat finansowych. Obejmuje to dane osobowe (np. PESEL, adres, numer telefonu), dane finansowe (numery kart kredytowych, dane bankowe), informacje medyczne, tajemnice handlowe, strategie biznesowe, hasła oraz inne dane uwierzytelniające. Ogólnie, są to informacje, których nie udostępniłbyś publicznie.
Czy istnieją bezpieczniejsze sposoby korzystania z LLM z wrażliwymi danymi?
Tak, istnieją. Można rozważyć użycie modeli LLM działających lokalnie (on-premise), co daje pełną kontrolę nad danymi. Inne opcje to korzystanie z prywatnych, izolowanych instancji modeli oferowanych przez niektórych dostawców chmurowych, które zapewniają wyższy poziom bezpieczeństwa i prywatności. Ważne jest również wybieranie usługodawców, którzy przestrzegają rygorystycznych norm bezpieczeństwa i przepisów o ochronie danych.
Co to są ataki "model inversion" i "membership inference"?
Model inversion to rodzaj ataku, w którym atakujący próbuje zrekonstruować (częściowo lub w całości) dane użyte do treningu modelu, analizując jego wyjścia lub wewnętrzne parametry. Celem jest odtworzenie wrażliwych informacji, które model "widział" podczas nauki.
Membership inference to atak, którego celem jest ustalenie, czy konkretny rekord danych (np. dane konkretnej osoby) był częścią zbioru treningowego modelu. Nawet jeśli same dane nie są odtwarzane, potwierdzenie ich obecności w zbiorze treningowym może naruszać prywatność.
Rekomendowane Zapytania
- Jakie są różnice między uczeniem nadzorowanym a nienadzorowanym w kontekście LLM?
- Jakie przepisy o ochronie danych (np. RODO) mają zastosowanie do modeli LLM?
- W jaki sposób mogę zweryfikować politykę prywatności dostawcy usługi LLM?
- Czy istnieją narzędzia do anonimizacji danych przed wprowadzeniem ich do LLM?
Referencje
Last updated May 6, 2025