
Как Разогнать Manticore Search до Предельных Скоростей: Полное Руководство по Оптимизации
Откройте секреты молниеносной работы вашего поискового движка Manticore Search с помощью детальных настроек и проверенных методик.
Ключевые Моменты для Максимальной Производительности
- Оптимизация Индексации: Ускорение процесса создания и обновления индексов через шардирование, правильное управление памятью и параллельную обработку является фундаментом быстрой работы.
- Тонкая Настройка Поисковых Запросов: Эффективное использование фильтров, параметра
max_matches, булевой оптимизации и понимание работы оптимизатора запросов Manticore кардинально снижает время отклика. - Аппаратное Обеспечение и Серверные Параметры: Выбор подходящего оборудования (SSD, достаточный объем RAM, многоядерные CPU) и грамотная конфигурация серверных настроек Manticore Search обеспечивают стабильно высокую производительность.
Введение в Высокопроизводительный Manticore Search
Manticore Search – это высокопроизводительный полнотекстовый поисковый движок, являющийся форком Sphinx Search. Он разработан на C++ для обеспечения быстрого времени запуска и эффективного использования ресурсов, потребляя всего около 40 МБ RAM для пустого экземпляра. Однако, при работе с большими объемами данных, исчисляемыми миллионами и даже миллиардами записей, стандартные настройки могут оказаться недостаточными для достижения желаемой скорости. Эта статья предоставит вам всестороннее руководство по настройке Manticore Search для максимальной производительности, охватывая как оптимизацию индексации, так и поисковых запросов, а также серверные и аппаратные аспекты.
Manticore Search обеспечивает высокую производительность для поисковых задач.
Оптимизация Производительности Индексации
Скорость индексации напрямую влияет на актуальность данных и общую отзывчивость системы. Медленная индексация может стать узким местом, особенно при работе с динамически изменяющимися данными.
Шардирование и Параллельная Индексация
При работе с очень большими наборами данных (сотни миллионов документов) рекомендуется разделять индексы на части (шарды) и индексировать их параллельно. Это позволяет более эффективно использовать многоядерные процессоры и дисковые подсистемы. Хотя автоматическое встроенное шардирование находится в разработке, ручное разделение на несколько меньших индексов и их одновременная сборка уже сейчас могут значительно ускорить процесс.
Ключевые параметры для индексатора:
mem_limit: Увеличение лимита памяти для индексатора может ускорить процесс за счет выполнения большего количества операций в RAM.indexer_threads: Настройка количества потоков для индексации в соответствии с количеством ядер вашего CPU.
Работа с Real-Time (RT) Индексами
RT-индексы удобны для данных, требующих частого обновления. Однако для поддержания их производительности важно:
rt_mem_limit: Этот параметр определяет объем оперативной памяти, выделяемой для RT-индекса. Больший лимит уменьшает необходимость частых сбросов данных на диск, что ускоряет вставку, но требует достаточного объема RAM. Например, при наличии 6 ГБ RAM, можно выделить 4-6 ГБ для RT-индексов.- Команда
OPTIMISE INDEX имя_индекса: Регулярное выполнение этой команды для RT-индексов помогает уменьшить фрагментацию, консолидировать данные и сделать их сравнимыми по скорости поиска с обычными (plain) индексами.
Пример настройки RT-индекса в конфигурационном файле manticore.conf:
index rt_mydata {
    type = rt
    path = /var/lib/manticore/rt_mydata
    rt_field = title
    rt_field = content
    rt_attr_uint = category_id
    rt_mem_limit = 4G # Пример: 4 Гигабайта
}
Оптимизация Запросов на Загрузку Данных
Если вы индексируете данные из реляционных баз данных (например, MySQL), убедитесь, что SQL-запросы, используемые для извлечения данных (в секции sql_query для plain индексов), максимально оптимизированы. Используйте необходимые фильтры (WHERE), выбирайте только нужные поля и избегайте сложных соединений, если это возможно, на этапе выборки данных для индексации. Иногда реиндексация больших таблиц с использованием инструментов вроде mysqldump может быть значительно быстрее.
Оптимизация Производительности Поисковых Запросов
Скорость ответа на поисковые запросы критична для пользовательского опыта. Manticore Search предлагает несколько механизмов для их ускорения.
Эффективное Использование Параметров Запроса
Контроль Количества Результатов с `max_matches`
Параметр max_matches (или max_matches в опциях SQL-запроса) контролирует, какое максимальное количество "лучших" совпадений отслеживается Manticore Search во время поиска. Отслеживание, например, только 500 лучших совпадений значительно эффективнее с точки зрения использования RAM и CPU, чем хранение информации обо всех миллионах совпадений, их последующая сортировка и отбрасывание всех, кроме первых 20, необходимых для отображения на странице. Этот параметр существенно влияет на производительность.
SELECT * FROM my_index WHERE MATCH('искомый текст') LIMIT 20 OPTION max_matches=1000;
Булева Оптимизация (`boolean_simplify`)
Manticore Search включает оптимизатор булевых выражений. Параметр `boolean_simplify` (в опциях SQL-запроса или глобально) может упростить сложные или алгоритмически сгенерированные запросы, улучшая их производительность. Однако это потребляет дополнительное время CPU на этапе оптимизации самого запроса. Для простых или уже оптимизированных вручную запросов, значение по умолчанию (`boolean_simplify=0` или не указывать) может дать лучшие результаты.
Использование SQL vs JSON
Manticore Search поддерживает как собственный SQL-подобный язык запросов (ManticoreQL), так и JSON API. Рекомендуется использовать SQL для разработки и отладки запросов, так как он ближе к естественному языку. Для интеграции с приложениями JSON может быть более удобен из-за его программной природы. Лучшая практика – сначала разработать и протестировать запрос на SQL, а затем, при необходимости, реализовать его через JSON API для вашего приложения.
Фильтрация и Пагинация
- Фильтры по атрибутам: Применение фильтров по атрибутам (например,
WHERE category_id = 5 AND price < 1000) до или вместе с полнотекстовым поиском (MATCH()) значительно сужает пространство поиска и ускоряет выполнение запроса. - Пагинация: При реализации пагинации, особенно в полнотекстовом поиске, всегда включайте
WEIGHT()(или_scoreв некоторых контекстах) в критерии сортировки (ORDER BY), чтобы наиболее релевантные результаты отображались первыми. Manticore предлагает несколько методов пагинации; выбор зависит от сценария использования.
Параллелизация Запросов и Оптимизатор на Основе Стоимости
Manticore Search использует интеллектуальную параллелизацию запросов, чтобы максимально задействовать все доступные ядра CPU, снижая время отклика. Кроме того, он оснащен оптимизатором запросов на основе стоимости (cost-based query optimizer), который использует статистику об индексированных данных для оценки и выбора наиболее эффективного плана выполнения для данного запроса.
Влияние Оптимизаций на Производительность: Сравнительный Анализ
Для наглядной демонстрации эффекта от различных уровней оптимизации Manticore Search, рассмотрим следующую диаграмму. Она сравнивает условные показатели производительности для системы с настройками по умолчанию, после базовой оптимизации (например, настройка rt_mem_limit, max_matches) и после продвинутой оптимизации (включая шардирование, тонкую настройку всех параметров, оптимизацию запросов).
Как видно из диаграммы, продвинутая оптимизация позволяет значительно улучшить скорость индексации, снизить задержку запросов и потребление ресурсов, а также повысить масштабируемость. Однако это достигается ценой увеличения сложности настройки.
Аппаратные и Системные Рекомендации
Производительность Manticore Search также сильно зависит от аппаратного обеспечения и настроек операционной системы.
- SSD (Твердотельные накопители): Использование быстрых SSD-накопителей критически важно, особенно для операций ввода-вывода при индексации и выполнении сложных запросов с частым обращением к диску.
- Оперативная память (RAM): Достаточное количество RAM позволяет хранить большие части индексов и данные RT-индексов в памяти, минимизируя медленные дисковые операции.
- Многоядерный CPU: Manticore Search эффективно использует многопоточность для параллельной обработки запросов и индексации.
- Сетевая подсистема: Убедитесь в достаточной пропускной способности сети, если `searchd` обслуживает большое количество удаленных клиентов.
Ключевые Серверные Параметры в `searchd`
В секции `searchd` конфигурационного файла `manticore.conf` обратите внимание на следующие параметры:
| Параметр | Описание | Влияние на производительность |
|---|---|---|
listen |
Определяет сетевые интерфейсы и порты, которые Manticore Search будет слушать для SQL и HTTP JSON запросов. | Правильная настройка важна для доступности сервиса. |
log / query_log |
Пути к файлам логов. | Анализ логов запросов помогает выявлять медленные запросы и узкие места. |
pid_file |
Путь к PID-файлу процесса. | Стандартный параметр для управления демоном. |
max_children (устарел, см. `threads` или `workers`) |
Максимальное количество дочерних процессов для обработки запросов. | Влияет на способность обрабатывать параллельные запросы. Современные версии используют потоковую модель. |
net_workers |
Количество потоков для обработки сетевых запросов. Увеличьте для лучшего масштабирования на многоядерных CPU при высокой нагрузке. | Увеличивает пропускную способность обработки входящих запросов. |
preopen_tables |
Если установлено в 1 (или больше), Manticore Search будет предварительно загружать таблицы (индексы) в память при старте. | Ускоряет первые запросы после старта, но увеличивает время запуска и потребление RAM. |
rt_flush_period |
Как часто (в секундах) RT-индекс будет сбрасывать накопленные данные из RAM-чанка на диск в дисковый чанк. | Баланс между скоростью индексации (более редкий сброс) и скоростью слияния чанков / потреблением RAM. Слишком частый сброс может замедлить индексацию. |
binlog_path |
Путь для хранения бинарных логов, используемых для репликации и восстановления. | Важно для отказоустойчивости, но может незначительно влиять на производительность записи. |
Пример секции `searchd`:
searchd {
    listen = 127.0.0.1:9306:mysql41
    listen = 127.0.0.1:9308:http
    log = /var/log/manticore/searchd.log
    query_log = /var/log/manticore/query.log
    pid_file = /var/run/manticore/searchd.pid
    seamless_rotate = 1
    preopen_tables = 1
    unlink_old = 1
    binlog_path = /var/lib/manticore/
    rt_flush_period = 3600  # Сбрасывать RT-чанкі раз в час
    net_workers = 4         # Количество сетевых обработчиков, например, по числу ядер CPU
}
Структура Оптимизации Manticore Search
Для лучшего понимания взаимосвязей различных аспектов оптимизации Manticore Search, рассмотрим следующую ментальную карту. Она визуализирует основные направления работы по улучшению производительности.
Эта карта помогает структурировать подход к оптимизации, выделяя ключевые области, требующие внимания для достижения максимальной скорости работы Manticore Search.
Режимы Работы Индексов: Real-time vs Plain
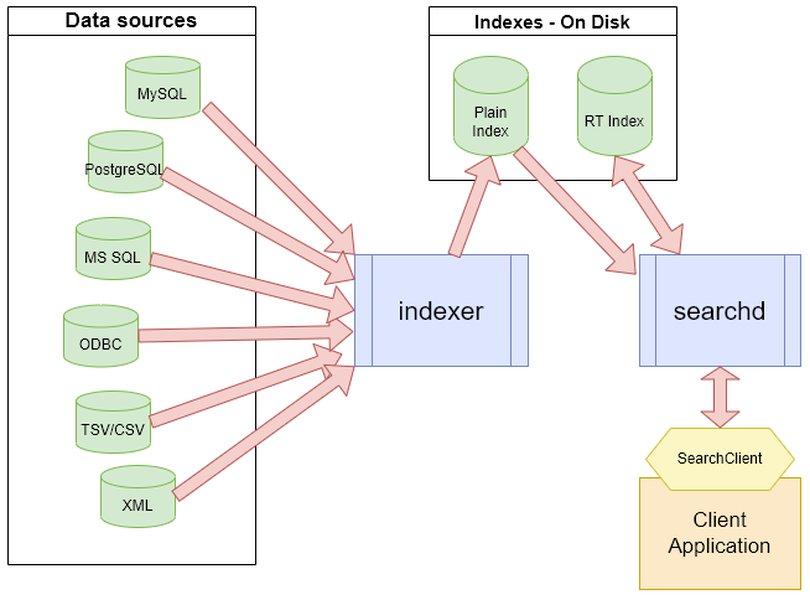
Понимание различий между Real-time (RT) и Plain (дисковыми) индексами в Manticore Search имеет решающее значение для выбора правильной стратегии оптимизации в зависимости от вашего варианта использования. RT-индексы позволяют добавлять, обновлять и удалять документы "на лету", что делает их идеальными для быстро меняющихся данных. Plain-индексы, с другой стороны, обычно создаются для более статичных данных и перестраиваются периодически. Каждый режим имеет свои компромиссы в отношении производительности индексации и поиска.
Следующее видео подробно рассматривает эти различия и помогает понять, какой режим лучше подходит для различных сценариев, что косвенно влияет на общую производительность и стратегию настройки:
Видео: "Real-time vs Plain Mode in Manticore Search: What's the Difference and When to Use Which?" от Manticore Search.
Выбор правильного типа индекса и его соответствующая настройка (например, rt_mem_limit и OPTIMISE для RT-индексов, или частота переиндексации для plain-индексов) являются ключевыми факторами для достижения высокой производительности.
Дополнительные Лучшие Практики
- Мониторинг и Тестирование: Регулярно анализируйте лог запросов (
query_log) для выявления медленных запросов. Используйте командуSHOW STATUSв ManticoreQL для получения информации о текущем состоянии сервера. Проводите нагрузочное тестирование (например, с помощью Manticore Load Emulator) для проверки производительности под ожидаемой нагрузкой и подбора оптимальных параметров. - Регулярные Обновления: Следите за выходом новых версий Manticore Search. Разработчики постоянно работают над улучшением производительности, исправлением ошибок и добавлением новых оптимизаций.
- Настройка
charset_tableиngram_len: Особенно важно для неанглийских языков и CJK (китайский, японский, корейский) символов. Правильная настройка этих параметров влияет как на релевантность поиска, так и на размер индекса и скорость поиска. - Избегайте избыточных индексов: Создавайте только необходимые атрибуты и поля. Каждый дополнительный атрибут увеличивает размер индекса и может незначительно замедлять операции.
Часто Задаваемые Вопросы (FAQ)
Как часто нужно выполнять команду `OPTIMISE` для RT-индексов?
Частота выполнения `OPTIMISE` зависит от интенсивности обновлений вашего RT-индекса и требований к производительности поиска. Если у вас очень много вставок/обновлений, может потребоваться запускать `OPTIMISE` чаще (например, раз в несколько часов или ежедневно). Для менее активных индексов достаточно еженедельного или даже ежемесячного запуска. Цель – поддерживать небольшое количество дисковых чанков (сегментов) индекса. Мониторьте количество чанков (можно увидеть через `SHOW INDEX имя_индекса STATUS`) и производительность поиска, чтобы подобрать оптимальную частоту.
Влияет ли выбор между SQL и JSON на производительность запросов?
С точки зрения самого движка Manticore Search, производительность выполнения идентичного запроса, отправленного через SQL (ManticoreQL) или JSON API, как правило, не должна существенно отличаться. Оба интерфейса в конечном итоге транслируются во внутренние операции движка. Разница может быть в накладных расходах на парсинг запроса и формирование ответа, но обычно она пренебрежимо мала по сравнению со временем самого поиска, особенно для сложных запросов. Выбор между SQL и JSON чаще диктуется удобством разработки и интеграции, а не соображениями микрооптимизации производительности.
Какие аппаратные ресурсы наиболее важны для Manticore Search?
Наиболее важными аппаратными ресурсами являются:
- Быстрые диски (SSD): Особенно NVMe SSD. Manticore Search интенсивно работает с диском во время индексации и при поиске по большим индексам, которые не помещаются полностью в RAM.
- Достаточный объем оперативной памяти (RAM): Чем больше RAM, тем больше данных индекса может быть закэшировано, и тем быстрее будут RT-операции (при правильно настроенном `rt_mem_limit`).
- Многоядерный процессор (CPU): Manticore Search хорошо масштабируется по ядрам CPU, используя параллелизм для обработки запросов и некоторых этапов индексации.
Баланс между этими компонентами зависит от специфики нагрузки.
Можно ли ускорить индексацию очень больших объемов данных (сотни миллионов записей)?
Да, можно. Основные стратегии:
- Шардирование: Разделите ваш огромный набор данных на несколько логических частей (шардов) и создайте для каждой части отдельный plain-индекс. Индексируйте эти части параллельно на нескольких машинах или последовательно, но с использованием всех ядер CPU на одной машине (если позволяет дисковая подсистема). При поиске используйте распределенные индексы (distributed index) для объединения результатов со всех шардов.
- Оптимизация источника данных: Убедитесь, что SQL-запросы (если данные из БД) максимально эффективны и быстро возвращают данные.
- Увеличение `mem_limit` для индексатора: Если доступно достаточно RAM, это может ускорить сортировку и обработку данных в памяти.
- Использование `indexer_threads` (если применимо): Для некоторых операций индексатор может использовать несколько потоков.
- Аппаратное обеспечение: Быстрые SSD и мощный CPU существенно влияют на скорость индексации.
Рекомендуемые Запросы для Дальнейшего Изучения
- Узнайте больше о техниках шардирования индексов в Manticore Search для работы с очень большими наборами данных.
- Изучите сравнительный анализ производительности Real-time и Plain индексов Manticore Search на практических примерах.
- Ознакомьтесь с использованием Manticore Load Emulator для эффективного тестирования нагрузки и оптимизации конфигурации вашего сервера.
- Откройте для себя продвинутые возможности ManticoreQL для построения сложных поисковых запросов и аналитических выборок.
Источники и Полезные Ссылки
Last updated May 8, 2025