
Раскрываем Потенциал Вашей Формулы ranker=expr в Manticore Search: Актуальность, Практика и Альтернативы!
Узнайте, как максимально эффективно использовать кастомное ранжирование в Manticore Search и какие существуют нюансы.
Вы интересуетесь оценкой вашей формулы для ranker=expr в Manticore Search, её актуальностью, работоспособностью, а также тем, используются ли подобные подходы другими и каковы существующие альтернативы. Поскольку конкретная формула не была предоставлена, мы предложим общий анализ этой мощной функции Manticore Search, основываясь на текущих практиках и доступной информации.
Ключевые Моменты о ranker=expr
- Гибкость и Контроль:
ranker=exprпредоставляет максимальную гибкость в настройке релевантности поиска, позволяя создавать собственные формулы с использованием более 20 факторов ранжирования и атрибутов документов. - Актуальность: Это современная и активно поддерживаемая функция в Manticore Search, упоминаемая в документации для различных версий, включая последние релизы.
- Распространенность: Опытные пользователи Manticore Search активно применяют кастомные выражения для решения специфических бизнес-задач, где стандартных ранжировщиков недостаточно.
Что такое ranker=expr и как он работает?
Manticore Search – это высокопроизводительный полнотекстовый поисковый движок, который предлагает различные механизмы для ранжирования результатов поиска. Параметр ranker определяет, как будет рассчитываться релевантность документов по отношению к запросу. Опция ranker=expr (от "expression" – выражение) позволяет задать собственную, пользовательскую формулу для вычисления веса (релевантности) каждого документа.
Эта функция является одной из самых мощных в Manticore Search, поскольку она дает разработчикам полный контроль над процессом ранжирования. Вы можете комбинировать различные внутренние текстовые факторы, атрибуты документов и математические операции для создания сложной логики, точно отвечающей требованиям вашего проекта.
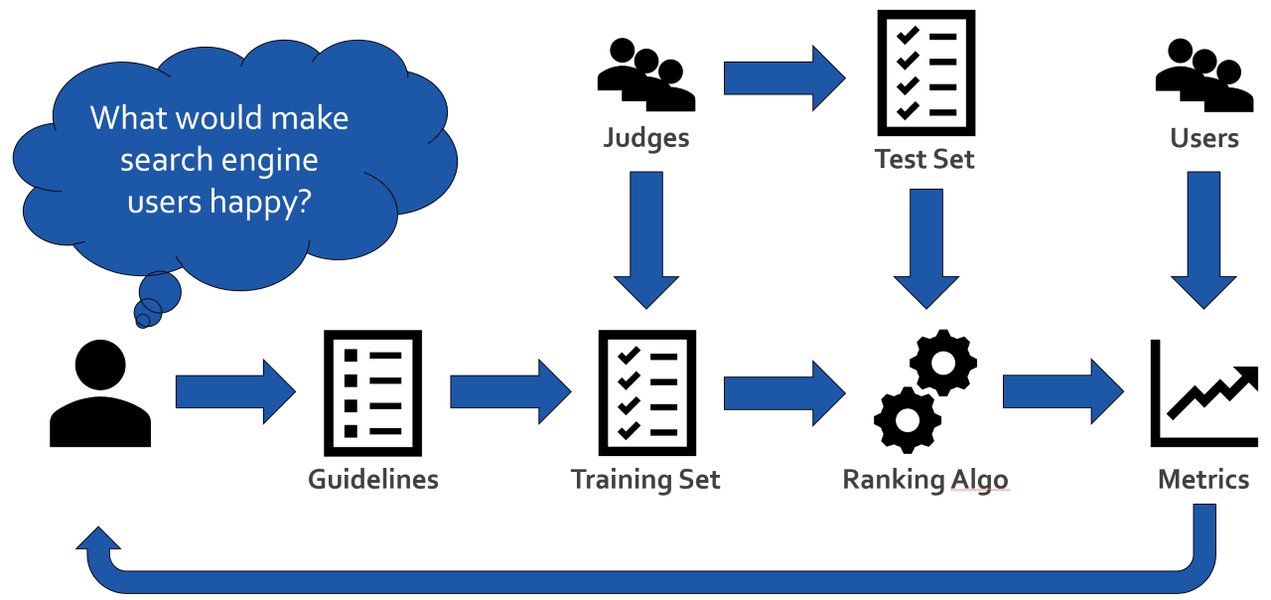
Концептуальное представление построения алгоритма ранжирования.
Актуальность и Работоспособность
Поддержка в Версиях Manticore Search
Функция ranker=expr является актуальной и полностью рабочей. Она поддерживается и документирована во многих версиях Manticore Search, включая 2.6.x, 2.7.x, 3.1.x, 3.2.0 и более новые. Это свидетельствует о её стабильности и важности для экосистемы Manticore Search. Вы можете быть уверены, что, используя ranker=expr, вы работаете с поддерживаемым и развиваемым инструментом.
Принципы Работы
Формула для ranker=expr указывается в виде строки, например: OPTION ranker=expr('sum(lcs*user_weight) + bm25'). В этой формуле могут использоваться:
- Факторы ранжирования: Это числовые значения, рассчитываемые для каждого совпавшего документа в контексте текущего запроса. Manticore Search предоставляет более 20 таких факторов, включая:
bm25: Стандартный вероятностный алгоритм ранжирования Okapi BM25.lcs: Длина наибольшей общей подпоследовательности между запросом и текстом в поле документа.max_lcs: Максимально возможная LCS для данного запроса.sum_hit_rank,min_hit_pos: Факторы, связанные с позицией и порядком слов.exact_hit: Фактор точного совпадения.word_count: Количество совпавших слов.- И многие другие.
- Атрибуты документа: Числовые значения атрибутов документа, хранящиеся в индексе.
- Пользовательские веса (user_weight): Веса, которые можно передавать вместе с запросом для отдельных полей или терминов.
- Математические функции и операторы: Сложение, вычитание, умножение, деление, функции типа
min,max,log,powи другие.
Эта формула вычисляется для каждого документа, найденного по запросу, и полученное значение используется для его ранжирования. Тщательное тестирование формулы на реальных данных крайне важно, так как некорректно составленное выражение может ухудшить качество поиска.
Используют ли Другие Подобные Варианты?
Да, использование ranker=expr – распространенная практика среди разработчиков, которым требуется тонкая настройка релевантности. Это особенно актуально в следующих областях:
- Электронная коммерция: Для учета популярности товаров, наличия на складе, пользовательских оценок и других бизнес-метрик при ранжировании.
- Поиск по документации или базам знаний: Для приоритизации более свежих документов, точных совпадений терминологии или документов из определенных разделов.
- Системы логирования и мониторинга: Для выделения наиболее критичных событий или совпадений в определенных полях логов.
- Retrieval-Augmented Generation (RAG) системы: Где точность извлечения релевантных фрагментов текста напрямую влияет на качество генерируемого ответа.
На форумах сообщества Manticore Search и в блогах можно найти множество примеров и обсуждений, где пользователи делятся своими формулами и опытом их применения. Типичный пример, который часто встречается – это комбинация стандартного BM25 с дополнительными весами для LCS и пользовательских весов полей, например, OPTION ranker=expr('sum(lcs*user_weight*10) + bm25*1.2 + custom_factor').
Сравнение ranker=expr с Другими Подходами
Для наглядности, давайте сравним ключевые характеристики кастомного ранжирования через ranker=expr со стандартными встроенными ранжировщиками Manticore Search.
Этот график иллюстрирует, что ranker=expr предлагает наивысшую гибкость и контроль над процессом ранжирования, однако это достигается за счет потенциального увеличения сложности настройки и возможного влияния на производительность по сравнению с оптимизированными встроенными ранжировщиками.
Производительность
Важно отметить, что вычисление сложных кастомных формул в ranker=expr может быть несколько медленнее, чем использование встроенных, скомпилированных ранжировщиков. Это связано с тем, что выражение парсится и вычисляется "на лету" для каждого документа. Однако для многих задач выигрыш в точности релевантности оправдывает это небольшое снижение производительности. Всегда рекомендуется проводить тестирование производительности на ваших данных и запросах.
Альтернативы ranker=expr
Хотя ranker=expr предоставляет огромную гибкость, существуют и другие подходы к настройке ранжирования в Manticore Search и за его пределами.
Встроенные Ранкеры Manticore Search
Manticore Search предлагает несколько встроенных ранжировщиков, которые могут подойти для многих стандартных задач и обычно работают быстрее, чем ranker=expr:
| Ранкер | Описание | Когда использовать |
|---|---|---|
proximity_bm25 |
Ранкер по умолчанию. Комбинирует BM25 с учетом близости слов в документе. | Общий случай, когда важна как релевантность по ключевым словам, так и их взаимное расположение. |
bm25 |
Классический алгоритм BM25. Оценивает релевантность на основе частоты терминов и их распределения. | Когда близость слов не так важна, или для более простого базового ранжирования. |
none |
Не производит ранжирования. Документы возвращаются в произвольном порядке (или как отсортированы по атрибуту). | Когда ранжирование не требуется, или сортировка производится исключительно по другим атрибутам. |
wordcount |
Ранжирует документы по количеству совпавших слов запроса. | Для очень простых запросов, где важно лишь количество совпадений. |
proximity |
Оценивает только близость слов, без учета статистических весов BM25. | Когда основной критерий – насколько близко друг к другу расположены слова запроса в документе. |
matchany |
Предпочитает документы, где есть полное совпадение фразы. | Когда точное совпадение фразы является ключевым. |
sph04 |
Улучшенная версия proximity_bm25, которая может давать дополнительный вес совпадениям в начале или конце поля. (Уточните актуальность в вашей версии Manticore). |
Если позиция совпадения в поле имеет значение. |
Даже используя встроенные ранкеры, вы можете влиять на ранжирование через опцию field_weights, которая позволяет задать относительную важность различных полей индекса.
Внешние Альтернативы и Подходы
Если возможности Manticore Search, включая ranker=expr, оказываются недостаточными для ваших задач (например, требуется сложное машинное обучение для ранжирования или специфические интеграции), можно рассмотреть другие поисковые движки:
- Elasticsearch: Очень популярный и масштабируемый поисковый движок с широкими возможностями кастомизации ранжирования, включая скриптинг и плагины для машинного обучения (Learning to Rank).
- Meilisearch: Фокусируется на простоте использования и высокой производительности "из коробки", предлагая хороший уровень релевантности с меньшими возможностями для глубокой кастомизации по сравнению с Manticore
ranker=expr. - Vespa.ai: Платформа для создания приложений, интенсивно использующих данные, с очень мощными возможностями по ранжированию и применению моделей машинного обучения в реальном времени.
Однако, для большинства задач, где требуется гибкая настройка релевантности без необходимости внедрения сложных ML-систем, ranker=expr в Manticore Search представляет собой отличный баланс между мощностью, гибкостью и относительной простотой реализации.
Визуализация Концепции ranker=expr
Следующая диаграмма представляет структуру и ключевые аспекты использования ranker=expr в Manticore Search, помогая лучше понять его место в системе ранжирования.
ranker=expr в Manticore Search"]
id1["Определение"]
id1_1["Кастомная формуларелевантности"] id1_2["Указывается через
OPTION ranker=expr(...)"] id2["Компоненты Формулы"] id2_1["Факторы ранжирования"] id2_1_1["bm25, lcs, word_count"] id2_1_2["min_hit_pos, exact_hit"] id2_1_3["Более 20 факторов"] id2_2["Атрибуты Документа"] id2_2_1["Числовые значения"] id2_3["Пользовательские Веса (user_weight)"] id2_4["Математические Операторы
и Функции"] id3["Преимущества"] id3_1["Максимальная Гибкость"] id3_2["Точный Контроль
над Ранжированием"] id3_3["Адаптация под
Специфичные Задачи"] id4["Применение"] id4_1["E-commerce"] id4_2["Поиск по Документам"] id4_3["Системы Логирования"] id4_4["RAG-системы"] id5["Соображения"] id5_1["Производительность
(может быть ниже встроенных)"] id5_2["Сложность Отладки"] id5_3["Необходимость Тестирования"] id6["Альтернативы в Manticore"] id6_1["proximity_bm25 (по умолчанию)"] id6_2["bm25, wordcount, none, etc."] id6_3["field_weights"] id7["Внешние Альтернативы"] id7_1["Elasticsearch"] id7_2["Meilisearch"] id7_3["Vespa.ai"]
Эта ментальная карта показывает, что ranker=expr является центральным элементом для продвинутой настройки релевантности в Manticore, опираясь на богатый набор факторов и операторов, но требует внимательного подхода к разработке и тестированию формул.
Видео: Начало Работы с Manticore Search
Если вы только начинаете знакомиться с Manticore Search или хотите освежить свои знания об основах, следующее видео может быть полезным. В нем рассматривается настройка, создание первой таблицы и выполнение первых запросов, что поможет лучше понять контекст, в котором используется ranker=expr.
Это видео демонстрирует базовые шаги по развертыванию Manticore Search с использованием Docker, созданию индекса (таблицы) и выполнению поисковых запросов. Понимание этих основ необходимо для эффективной работы с более сложными функциями, такими как кастомное ранжирование.
Часто Задаваемые Вопросы (FAQ)
Могу ли я эмулировать встроенные ранкеры с помощью ranker=expr?
Да, Manticore Search позволяет эмулировать поведение большинства встроенных ранжировщиков с помощью ranker=expr. Например, стандартный ранкер proximity_bm25 можно представить как OPTION ranker=expr('sum(lcs*user_weight) + bm25'). Однако стоит помнить, что скомпилированные встроенные ранкеры обычно работают быстрее, чем их эмуляции через expr. Эмуляция полезна для понимания работы ранжировщика или для тонкой настройки, начиная с базовой формулы.
Как проверить корректность моей формулы `ranker=expr`?
1. Проверьте синтаксис: Убедитесь, что все функции, операторы и имена факторов/атрибутов написаны правильно и соответствуют документации Manticore Search.
2. Используйте простые запросы: Начните с простых запросов и постепенно усложняйте их, наблюдая за изменениями в ранжировании.
3. Анализируйте результаты: Сравнивайте результаты, полученные с вашей формулой, с результатами от стандартных ранжировщиков (например, bm25) или с ожидаемой релевантностью.
4. Используйте функцию SHOW META: Этот запрос может показать значения факторов ранжирования для документов, что поможет в отладке.
5. Тестируйте на реальных данных: Эффективность формулы сильно зависит от характера ваших данных и запросов. Проводите A/B тестирование, если это возможно.
Влияет ли `ranker=expr` на скорость индексации?
Нет, ranker=expr применяется только во время выполнения поискового запроса. Формула ранжирования не влияет на процесс и скорость индексации данных. Индексация занимается подготовкой данных для поиска, а ранжирование – это этап обработки запроса к уже существующему индексу.
Какие самые распространенные ошибки при использовании `ranker=expr`?
1. Синтаксические ошибки: Опечатки в именах факторов, атрибутов или функций, неправильное использование скобок.
2. Логические ошибки в формуле: Неправильное комбинирование факторов, приводящее к неинтуитивным результатам ранжирования.
3. Использование несуществующих атрибутов или факторов: Попытка использовать переменные, которые не определены для данного индекса или запроса.
4. Отсутствие нормализации: Если разные компоненты формулы имеют сильно различающиеся диапазоны значений, некоторые из них могут непропорционально сильно влиять на итоговый вес.
5. Чрезмерное усложнение формулы: Слишком сложные формулы трудно отлаживать и поддерживать, и они не всегда приводят к лучшей релевантности.
Рекомендуемые Запросы для Дальнейшего Изучения
- Как оптимизировать производительность запросов с ranker=expr в Manticore Search?
- Примеры сложных формул ranker=expr для электронной коммерции в Manticore Search.
- Сравнение факторов ранжирования LCS и BM25 в Manticore Search.
- Использование атрибутов документа в формулах ranker=expr Manticore Search.
Источники и Полезные Ссылки
Last updated May 8, 2025