
解锁材料科学文献宝库:构建下一代智能抽取系统的核心功能蓝图
从材料研究人员视角出发,全方位解析文献抽取系统不可或缺的功能模块,加速您的科研创新之路。
核心亮点速览
- 智能数据捕获: 自动从海量文献中精准识别并提取材料成分、工艺、性能等关键数据,极大提升文献调研效率。
- 知识构建与洞察: 将非结构化信息转化为结构化知识图谱,揭示材料内在关联与潜在规律,辅助发现新材料或优化现有材料。
- 高效分析与协作: 提供强大的数据分析、可视化及团队共享功能,赋能数据驱动的材料研发,加速从文献到实验的转化。
对于奋战在材料科学前沿的研究人员而言,文献是获取知识、激发创新的源泉。然而,海量的文献信息也带来了巨大的挑战:如何快速、准确地从中提取有价值的数据和信息?一个功能全面的材料文献抽取系统,正是解决这一痛点的关键。以下将从材料研究者的实际需求出发,详细阐述这样一套系统应具备的核心功能。
一、文献获取与综合管理:您的专属智能文献库
文献是科研的基础。一个强大的文献抽取系统首先需要解决文献的来源和管理问题,让研究人员能够便捷地整合和处理各类文献资源。
多源文献高效导入
材料研究往往需要参考来自不同渠道的文献。系统应支持:
- 多种格式兼容: 直接导入PDF、HTML、XML等常见文献格式文件。
- 文献管理软件集成: 支持从EndNote, Zotero, Mendeley等主流文献管理工具导入文献库(如RIS, BibTeX格式),实现无缝对接。
- 主流数据库接入: 能够通过API或内置接口连接PubMed, ScienceDirect, Web of Science, Scopus, IEEE Xplore, 中国知网等国内外重要学术数据库,实现文献的批量检索与导入。
- 自动更新与订阅: 允许研究人员设置关注领域或关键词,系统自动抓取并推送最新的相关文献,确保研究人员始终掌握学科前沿动态。
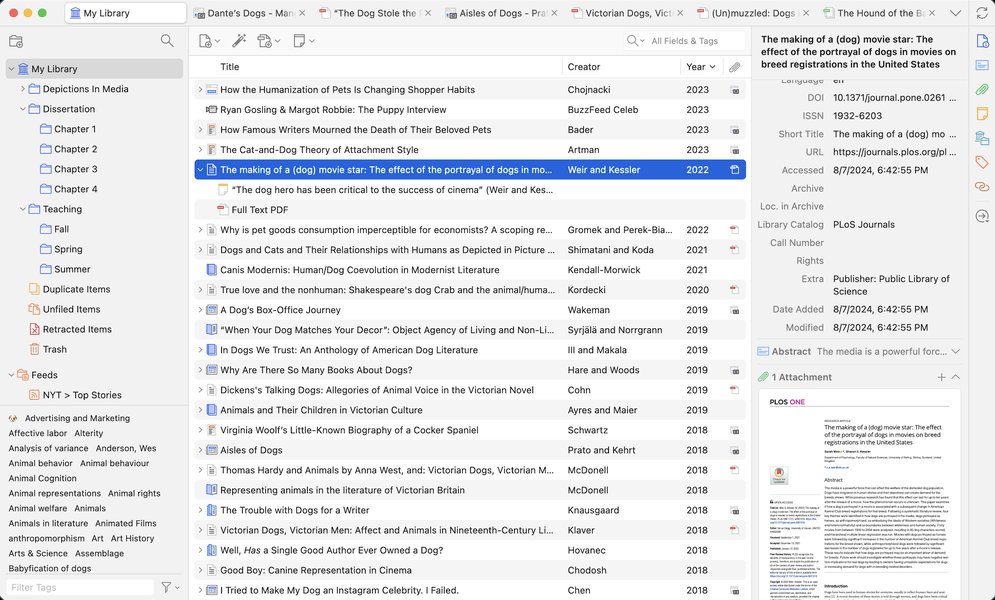
文献管理工具界面示例,帮助研究人员高效组织和引用文献资料。
智能文献深度解析
原始文献的格式多样,特别是扫描版或图文混排的文档,对信息提取构成挑战。因此,系统需要具备:
- 光学字符识别 (OCR): 内置高精度OCR引擎,能够准确识别扫描版PDF、图片格式文献中的文字内容,包括对复杂排版和多栏文档的处理,将其转化为可供后续分析的文本。
- 元数据自动提取: 自动从导入文献中解析并提取标题、作者、机构、期刊、发表年份、DOI、摘要、关键词等基础元数据,为文献的组织和检索奠定基础。
- 图表结构识别预处理: 初步识别文献中表格、曲线图、化学结构式、显微结构图等非文本元素的位置和类型,为后续的专门抽取模块做准备。
高效文献组织与管理
面对日益增长的文献数量,有效的组织和管理至关重要:
- 自定义分类与标签: 允许研究人员根据研究项目、材料类型、研究主题等自定义文件夹和标签,对文献进行灵活分类。
- 全文检索引擎: 提供强大的全文检索功能,支持关键词、作者、标题、摘要等多种检索方式,并支持布尔逻辑、短语匹配、模糊搜索等高级检索策略。
- 文献去重与版本控制: 自动识别重复导入的文献,并能对文献的不同版本进行管理和区分,避免信息冗余。
- 笔记与注释: 支持在文献阅读过程中添加个人笔记、高亮和注释,方便后续回顾和知识沉淀。
二、核心智能抽取引擎:从文本到数据的精准提炼
这是系统的核心价值所在,目标是从非结构化的文献文本中,精准、高效地提取结构化的材料科学数据。
精准材料实体识别 (Named Entity Recognition, NER)
系统需利用先进的自然语言处理(NLP)技术,特别是针对材料科学领域优化的模型(如MatSciBERT或ChemDataExtractor等工具的原理),准确识别文本中各类关键实体:
- 材料名称与组分: 如“高温合金GH4169”、“TiO2纳米管”、“Fe-25Cr-20Ni (wt%)”。
- 制备与加工工艺: 如“溶胶-凝胶法”、“放电等离子烧结”、“退火温度800°C”、“压力50MPa”。
- 材料性能与表征: 如“抗拉强度”、“电导率”、“硬度”、“杨氏模量”、“晶粒尺寸”、“相组成”。
- 实验条件与参数: 如“测试温度25°C”、“应变速率10-3 s-1”、“气氛:氩气”。
- 应用领域与器件: 如“锂离子电池正极材料”、“催化剂”、“传感器”。
复杂关系抽取 (Relation Extraction)
仅仅识别实体是不够的,更重要的是理解它们之间的关系。系统应能抽取:
- 材料-性能关系: 例如,某种合金成分对其屈服强度的影响。
- 工艺-结构关系: 例如,特定的烧结温度如何影响材料的晶粒尺寸。
- 结构-性能关系: 例如,晶粒尺寸与材料硬度之间的关联。
- 因果关系: 如“增加A元素导致B性能提升”。
这种能力帮助研究人员理解材料设计原理,发现“成分-工艺-结构-性能”之间的复杂联系。
表格与图表数据提取
材料文献中大量有价值的数据隐藏在表格和图表中。系统应具备:
- 智能表格抽取: 自动识别PDF或图片中的表格,准确提取表格的行列结构、表头和单元格数据,并将其转换为结构化格式(如CSV或数据库表)。
- 曲线图数据数字化: 识别曲线图中的坐标轴、刻度、图例和数据点,将曲线图像转化为可分析的(x, y)数据对。这对于获取大量实验数据点至关重要。
- 化学结构式与谱图识别: 提取化学分子结构式,并尝试解析如XRD、SEM、TEM等谱图中的关键信息或元数据。
三、数据结构化与知识图谱构建:连接信息的孤岛
提取出的零散信息需要被有效组织,才能发挥最大价值。系统应将非结构化数据转化为结构化知识,便于后续的分析和应用。
数据标准化与清洗
从不同文献中提取的数据往往存在格式不一、单位不同、表述多样等问题。系统应具备:
- 单位规范化: 自动识别并转换各种物理量的单位到国际标准单位制(SI)或用户指定的标准。例如,将ksi转换为MPa。
- 术语同义词管理: 维护一个材料科学领域的同义词库和本体库,将不同表述的同一概念(如“tensile strength”和“ultimate tensile strength”)映射到标准术语。
- 数据校验与去噪: 对提取的数据进行初步的合理性校验,剔除明显的错误或异常值。
材料知识图谱构建与应用
将结构化的数据点连接成网,形成材料科学知识图谱 (Materials Knowledge Graph):
- 图谱构建: 以材料为核心节点,将材料的成分、结构、制备工艺、性能参数、应用领域以及相关的文献、作者、机构等信息作为关联节点和边,构建一个多维度的知识网络。
- 可视化探索: 提供知识图谱的可视化界面,研究人员可以通过图形化的方式浏览和探索材料间的复杂关系,直观发现潜在的知识关联。
- 语义推理: 基于知识图谱,系统可以进行一定程度的语义推理,例如,根据已有的“A影响B,B影响C”的关系,推断A可能间接影响C。
知识图谱能够帮助研究人员从全局视角理解材料体系,发现新的研究思路和材料设计方案。
Materials Literature
Extraction System"] L1_LitMgmt["文献管理
Literature Management"] L2_Import["导入与采集
Import & Acquisition
(PDF, API, Databases)"] L2_Parse["解析与OCR
Parsing & OCR
(Scanned Docs, Metadata)"] L2_Org["组织与分类
Organization & Categorization
(Tags, Folders, Search)"] L1_Extract["智能抽取
Intelligent Extraction"] L2_Entity["实体识别 (NER)
Entity Recognition
(Materials, Properties, Processes)"] L2_Relation["关系抽取
Relationship Extraction
(Cause-Effect, Correlations)"] L2_TableImg["表格/图像数据
Table/Image Data
(Tables, Curves, Structures)"] L1_Knowledge["知识构建
Knowledge Construction"] L2_Struct["数据结构化
Data Structuring
(JSON, CSV, Database)"] L2_KG["知识图谱构建
Knowledge Graph
(Nodes, Edges, Semantics)"] L2_Std["数据标准化
Data Standardization
(Units, Terminology)"] L1_Analysis["分析与应用
Analysis & Application"] L2_AdvSearch["高级检索
Advanced Search
(Semantic, Faceted)"] L2_Viz["数据可视化
Data Visualization
(Charts, Heatmaps)"] L2_MinePredict["挖掘与预测
Mining & Prediction
(ML Models, Trends)"] L1_Support["系统支持
System Support"] L2_UIUX["用户交互与反馈
User Interaction & Feedback
(Intuitive Interface, Correction)"] L2_IntegExt["集成与扩展
Integration & Extensibility
(APIs, ELN, LIMS)"] L2_SecCollab["安全与协作
Security & Collaboration
(Access Control, Sharing)"]
上图展示了材料文献抽取系统的核心功能模块及其关联,旨在构建一个从文献获取到知识应用的完整生态。
四、高级检索与分析洞察:赋能数据驱动的科研
拥有了结构化的数据和知识图谱后,系统需要提供强大的工具,帮助研究人员从中提取有价值的洞见。
多维度智能检索
超越传统关键词搜索,提供更精细化的检索能力:
- 基于属性的过滤: 允许研究人员按照特定的材料属性范围(如“屈服强度 > 500 MPa且延伸率 > 15%”)、工艺参数(如“烧结温度在1000-1200°C之间”)等条件筛选文献或数据。
- 语义搜索: 理解查询的语义意图,而不仅仅是字面匹配,例如搜索“耐高温结构材料”时,能返回包含具体高温合金或陶瓷材料的文献。
- 知识图谱导航检索: 通过在可视化知识图谱上进行点击和导航,探索相关联的材料、性能和文献。
数据可视化与挖掘分析
将抽取的数据以直观的方式呈现,并提供初步的分析能力:
- 多样化图表展示: 将提取的数值数据自动生成各种图表,如散点图、柱状图、折线图、热图等,帮助研究人员快速识别数据分布、趋势和异常点。
- 统计分析功能: 内置基本的统计分析工具,如描述性统计(均值、方差等)、相关性分析、回归分析等,对提取的数据进行初步探索。
- 机器学习接口: 能够将结构化数据导出,或提供API接口,方便与MatMiner、scikit-learn等材料信息学和机器学习工具包集成,支持更高级的材料性能预测、新材料设计和工艺优化。
材料数据可视化示例,将复杂数据转化为直观图表,辅助研究人员洞察规律。
材料文献抽取系统核心能力评估
下图通过雷达图形式,评估了一个理想的材料文献抽取系统在不同核心能力维度上的表现,并与当前技术可能面临的挑战进行对比。这有助于理解系统发展的关键方向和研究人员对各项能力的期望。
雷达图清晰对比了理想系统在各项能力上的高标准与当前技术发展中可能存在的差距,例如在提取准确度、数据覆盖广度等方面仍有提升空间。
五、系统辅助与协作功能:提升科研体验与效率
除了核心的数据处理能力,一系列辅助功能和协作机制能显著提升系统的实用性和用户体验。
用户反馈与模型持续优化
NLP模型的抽取结果并非永远完美。系统应提供:
- 错误标记与修正: 允许用户对错误的抽取结果(如实体识别错误、关系判断失误)进行标记和在线修正。
- 主动学习机制: 系统的后台模型能够学习用户的反馈数据,不断迭代优化抽取规则和模型参数,从而持续提高抽取的准确性和智能化水平。
多语言支持与国际化
材料科学研究是全球性的,文献来源多样。系统应:
- 处理多语言文献: 至少支持对英文文献的全面处理,并逐步扩展到对中文、德文、日文等其他主要科技语言文献的信息抽取能力。
- 界面多语言切换: 提供多语言用户界面,方便不同国家和地区的研究人员使用。
- 辅助翻译功能: 集成机器翻译引擎,对非母语文献的关键段落或摘要进行辅助翻译,帮助快速理解文献大意。
团队协作与数据共享
现代科研越来越强调团队合作。系统应支持:
- 共享文献库与数据集: 允许研究团队成员共享文献库、已抽取的结构化数据集以及分析结果。
- 协同标注与审核: 支持多人对同一批文献进行协同标注和数据审核,提高工作效率和数据质量。
- 权限管理: 提供细粒度的用户权限管理功能,控制不同用户对数据和功能的访问、编辑权限,确保数据安全和项目管理的有序性。
六、系统集成与安全保障:融入科研生态系统
为确保系统能够无缝融入研究人员的现有工作流程并保障数据安全,以下功能同样重要。
API接口与第三方工具集成
系统不应是一个孤岛,而应能与其他科研工具和平台协同工作:
- 开放API: 提供丰富的API接口,允许将抽取的数据和系统功能集成到其他科研软件中,如电子实验记录本(ELN)、实验室信息管理系统(LIMS)、材料数据库(如MatCloud)、材料模拟与计算平台等。
- 数据导出格式多样性: 支持将抽取的数据和分析结果导出为多种常用格式(如CSV, Excel, JSON, XML),方便在其他软件中进行进一步处理和分析。
- 插件支持: 开发针对主流文字处理软件(如MS Word, LaTeX)或浏览器(如Chrome)的插件,方便在撰写论文或浏览网页时快速调用系统的文献管理和信息抽取功能。
数据安全与隐私保护
文献数据,尤其是未发表的研究成果,具有高度敏感性。系统必须:
- 数据加密: 对用户上传的文献和抽取的数据进行加密存储和传输,防止数据泄露。
- 访问控制与审计日志: 严格的身份验证和权限控制机制,确保只有授权用户才能访问敏感数据。详细记录用户操作日志,方便追溯和审计。
- 合规性: 遵守相关的数据保护法规和知识产权政策。
用户界面友好与易用性
即使功能再强大,如果系统操作复杂,也会让研究人员望而却步。因此:
- 直观易用的界面设计: 简洁明了的图形用户界面(GUI),清晰的导航和操作流程,降低学习成本。
- 详细的帮助文档与教程: 提供完善的用户手册、操作指南、视频教程和FAQ,帮助用户快速上手。
- 个性化定制: 允许用户根据自己的偏好定制界面布局、抽取模板、关键词过滤器等。
关键信息提取类型及其对材料研究的重要性
下表总结了材料文献抽取系统需要重点关注的关键信息类型,以及它们对于材料研究人员的实际价值和意义。
| 信息类别 | 具体示例 | 对研究的重要性 |
|---|---|---|
| 材料实体 (Material Entities) | 高温合金GH4169, TiO2纳米管, Al-Si-Mg合金, 聚合物PLLA | 材料识别、分类、检索的基础;快速定位研究对象。 |
| 材料组分/化学式 (Material Composition/Formula) | Fe-25Cr-20Ni (wt%), C: 0.05%, Si: 0.5%, La0.7Sr0.3MnO3 | 理解材料性能与成分的核心关系;指导新材料配方设计与优化。 |
| 制备工艺/合成方法 (Synthesis/Processing) | 熔炼温度: 1600°C, 锻造压力: 500 MPa, 烧结时间: 2h, 溶胶-凝胶法, 气相沉积 | 复现实验结果;优化工艺参数以获得期望性能;探索新制备途径。 |
| 性能参数/表征数据 (Performance Parameters/Characterization Data) | 抗拉强度: 800 MPa, 电导率: 1.5x10⁶ S/m, 屈服强度, 断裂韧性, 催化效率, 电池容量 | 材料性能评估与横向比较;指导材料在特定场景下的应用选型;验证理论模型。 |
| 测试条件/实验环境 (Test Conditions/Experimental Environment) | 测试温度: 25°C, 应变速率: 0.001 s-1, 气氛: 空气/真空, pH值, 湿度 | 确保数据的可比性和有效性;理解外部条件对材料性能的影响机制。 |
| 微观结构/形貌特征 (Microstructure/Morphology) | 晶粒尺寸: 10 μm, 相组成: γ + γ', 析出物形态, 孔隙率, 表面粗糙度 | 连接“工艺-结构-性能”关系的关键桥梁;深入理解材料性能的微观机理。 |
该表格突出了文献抽取系统针对材料科学特定需求所应具备的数据提取能力,这些信息对于推动材料创新至关重要。
常见问题解答 (FAQ)
这个系统如何处理不同格式的文献,特别是扫描版的PDF? (How does this system handle documents in different formats, especially scanned PDFs?) ▼
系统支持导入多种格式(如PDF, HTML, XML, BibTeX, RIS)。对于扫描版PDF或图片格式的文献,系统内置先进的OCR(光学字符识别)技术,能够将图像中的文字转换为可编辑和可分析的文本。同时,它还能识别并提取文献中的图表、化学结构式等非文本信息,确保信息抽取的全面性。例如,对于一篇包含材料性能曲线图的扫描版论文,系统不仅能提取文本内容,还能尝试数字化曲线图上的数据点。
提取出来的数据准确性如何保证?研究人员可以如何参与优化? (How is the accuracy of extracted data ensured? How can researchers participate in optimization?) ▼
系统采用基于深度学习的NLP模型(如针对材料科学优化的MatSciBERT等)进行信息抽取,并通过数据清洗和预设的验证规则初步保证准确性。更重要的是,系统提供用户反馈机制。研究人员可以方便地在界面上标记和修正错误的抽取结果(例如,一个被错误识别的材料名称或一个数值提取错误)。这些宝贵的反馈将用于模型的持续学习(主动学习)和参数优化,从而不断提升抽取精度和系统的智能化水平,使其越来越贴合特定研究领域的需求。
构建知识图谱对材料研究有什么实际帮助? (What are the practical benefits of constructing a knowledge graph for materials research?) ▼
材料知识图谱将从海量文献中提取的孤立数据点(如材料实体、性能参数、工艺条件)通过它们之间的内在关系连接起来,形成一个结构化、语义化的知识网络。这对材料研究人员的实际帮助体现在:
- 深度洞察: 快速理解不同概念间的复杂关系,例如,某种特定工艺参数(如退火温度)如何系统性地影响多种不同材料的多种性能指标(如硬度、导电性、热稳定性)。
- 创新启发: 通过可视化探索和图谱推理,发现文献中未被明确指出的潜在规律、隐藏关联或新的研究方向,例如,找到具有相似性能模式但结构迥异的材料体系。
- 智能检索: 实现超越关键词匹配的语义搜索,例如,查询“具有高断裂韧性的轻质合金”,系统能够理解语义并返回相关的铝合金、镁合金或钛合金等信息。
- 数据驱动决策: 为材料设计、性能预测和工艺优化提供高质量的结构化数据基础,支持机器学习模型的训练和验证。
该系统是否支持团队协作和数据共享? (Does the system support team collaboration and data sharing?) ▼
是的,一个现代化的材料文献抽取系统会充分考虑科研工作的团队协作需求。它通常会提供多用户环境,允许研究团队成员共享文献库、已经抽取并结构化的数据集、分析模型以及最终的研究成果。通过细致的权限管理功能,可以设定不同成员(如项目负责人、研究员、研究生)对数据和功能的访问级别(如只读、编辑、管理),既能保障研究数据的安全性和完整性,又能促进团队内部的知识流通和高效协作,共同推进研究项目。
推荐探索
如果您对材料文献抽取及其相关技术感兴趣,以下问题可能帮助您进一步深入了解:
- 材料科学领域知识图谱构建的具体技术和挑战有哪些?
- 如何利用自然语言处理技术从专利文献中提取材料创新信息?
- 材料数据挖掘在预测新材料性能方面的最新进展是什么?
- 面向特定材料体系(如电池材料、高温合金)的文献抽取系统有哪些特殊要求?
参考文献
本回应的综合信息参考了以下及类似领域公开的技术与讨论:
Last updated May 11, 2025