
揭秘Milvus:打造高效智能的向量知识库管理系统
从基础架构到实际应用,全面解析Milvus如何革新知识库管理
Milvus知识库管理核心亮点
- 高性能向量检索:Milvus专为高维向量相似性搜索设计,支持亿级数据规模的高效检索
- 灵活的多租户架构:通过数据库级、集合级和分区级的隔离策略,满足不同规模企业需求
- 强大的RAG系统支持:与大型语言模型(LLM)无缝集成,构建智能问答和知识检索系统
Milvus知识库管理系统简介
Milvus是一款开源的高性能向量数据库,专为管理和检索高维向量数据而设计。在人工智能应用日益普及的今天,Milvus凭借其卓越的向量检索能力,成为构建智能知识库管理系统的理想选择。
作为LF AI & Data Foundation旗下的开源项目,Milvus遵循Apache 2.0许可分发,为用户提供了构建可扩展、高效的知识库管理解决方案。无论是处理文本、图像还是其他非结构化数据,Milvus都能将它们转换为向量表示,并提供快速精准的相似性搜索。
Milvus的技术架构
Milvus提供了两种部署模式以适应不同的应用场景:
- Milvus Distributed:基于云原生架构设计,可部署在Kubernetes集群上,适用于处理十亿级甚至更大规模的数据场景,确保关键组件的冗余。
- Milvus Lite:作为轻量级Python库,可以轻松集成到应用程序中,适合在Jupyter Notebook中进行快速原型设计或在资源有限的边缘设备上运行。
Milvus针对多种硬件架构和平台进行了性能优化,包括AVX512、SIMD、GPU和NVMe SSD,确保在各种硬件环境中都能发挥最佳性能。
多层次数据管理架构
Milvus采用三层数据组织结构,为知识库管理提供了灵活而强大的框架:
| 层级 | 说明 | 功能特点 |
|---|---|---|
| 数据库 (Database) | 顶层数据容器,类似传统关系型数据库 | 为不同应用或租户提供逻辑隔离 |
| 集合 (Collection) | 类似表的结构,用于管理不同逻辑组中的数据 | 定义架构、创建索引、设置分片策略 |
| 分区 (Partition) | 集合内部的数据分组 | 提升搜索性能,支持更精细的数据管理 |
这种多层次的数据组织结构使Milvus能够有效管理大规模知识库,同时提供细粒度的访问控制和优化的查询性能。
多租户策略对比
上图展示了Milvus三种多租户隔离策略的性能对比。数据库级隔离提供最高的安全性和资源隔离,但支持的租户数量有限;而分区级隔离则可支持数百万租户,但资源隔离程度较低。用户可根据具体需求选择最适合的隔离策略。
基于Milvus构建知识库管理系统
知识库构建流程
利用Milvus构建高效知识库管理系统的主要步骤包括:
1. 数据库配置与初始化
首先需要创建Milvus数据库并设置适当的权限控制。可以使用Milvus官方API进行数据库创建与管理,为特定用户分配数据库管理权限,从而为这些用户赋予管理数据库中集合的权利。
2. 文档处理与向量转换
将各类文档(如PDF、HTML、Excel、TXT等)加载并转换为文本片段,然后使用Embedding模型将这些片段转换为向量表示。这一步骤是知识库高效检索的基础。
3. 向量存储与索引构建
将生成的向量存储到Milvus集合中,并构建适当的索引以加速查询。Milvus支持多种索引类型,可根据应用场景选择最适合的索引方法。
4. 查询接口与检索优化
开发用户友好的查询接口,连接大语言模型和Milvus向量检索功能,实现高效的问答和信息检索系统。可以通过参数调优和查询重构提升检索准确性。
Milvus知识库管理的思维导图
多租户RAG系统实践
检索增强生成(RAG)是大语言模型应用的重要范式,通过向量检索技术为模型提供相关上下文信息,从而生成更准确、更有针对性的回答。Milvus在多租户RAG系统中扮演着核心角色。
RAG系统架构与流程
一个典型的基于Milvus的RAG系统包含以下核心组件:
- 文档处理器:负责解析、分割和清洗各种格式的文档。
- 向量生成器:使用Embedding模型将文本片段转换为向量表示。
- Milvus向量库:存储和索引文档向量,提供高效的相似性搜索。
- 大语言模型:根据检索结果生成最终回答,如OpenAI、DeepSeek等模型。
- 编排层:协调各组件工作,处理多租户隔离和权限管理。
当用户提出问题时,系统首先将问题转换为向量,然后在Milvus中检索相似的文档片段,最后将这些相关上下文连同原始问题一起发送给大语言模型,生成最终回答。
Milvus RAG系统视频演示
本视频详细介绍了RAG的向量数据库原理,从数据结构化、向量化、入库到检索过程,为理解Milvus在知识库管理中的应用提供了直观的演示。
实用知识库场景与应用
Milvus知识库管理系统可以应用于多种实际场景:
企业级应用
智能客服系统
企业可以将产品手册、常见问题和解决方案等资料整合到Milvus知识库中,构建智能客服系统,自动回答客户咨询,提高客服效率和客户满意度。
内部知识管理
企业可以将内部文档、培训材料和专业知识存储到Milvus知识库中,帮助员工快速找到所需信息,提升工作效率和知识共享水平。
个人知识管理
个人学习助手
个人用户可以将学习笔记、文献资料和书籍内容导入Milvus知识库,构建个性化学习助手,辅助学习和研究工作。
信息聚合与检索
收集和整理互联网信息,构建个人信息中心,通过Milvus的高效检索能力,快速找到需要的内容,避免信息过载。
垂直领域应用
医疗健康知识库
医疗机构可以将医学文献、诊疗指南和病例资料整合到Milvus知识库中,辅助医生诊断和治疗决策,提高医疗服务质量。
法律知识库
法律从业者可以构建包含法律法规、判例和专业文献的知识库,快速检索相关法律依据,提高工作效率和服务质量。
Milvus知识库相关资源
相关图片资源
以下是Milvus知识库管理相关的图片资源:
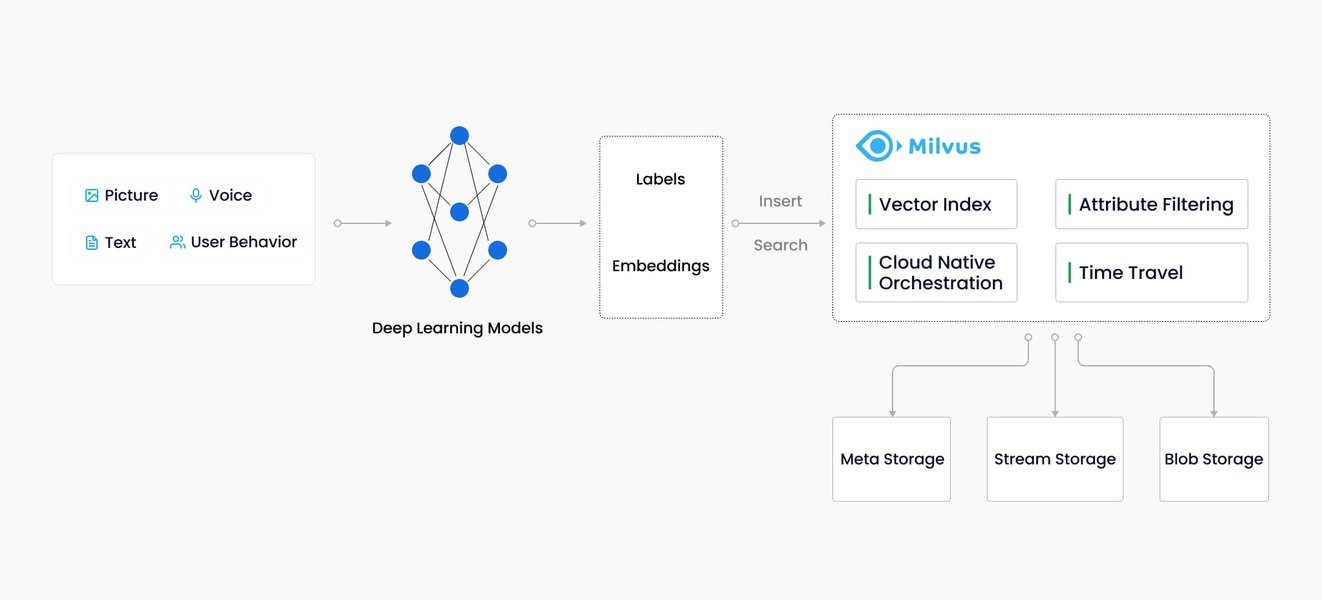
Milvus向量数据库工作流程示意图
DeepSeek与Milvus本地部署架构图
常见问题解答
参考资料
- Milvus | High-Performance Vector Database Built for Scale - Milvus官网
- What is Milvus - Milvus官方文档
- Milvus知识库管理功能介绍 - TIO Boot
-
在Windows中使用DeepSeek和Milvus搭建个人知识库 - 知乎
- 利用Milvus设计多租户RAG的最佳实践 - Milvus博客
- EKS上搭建的开源向量数据库Milvus - AWS中国博客
- 如何构建一个基于Milvus和LLM的智能知识库 - CSDN博客
推荐阅读
 aws.amazon.com
Last updated April 8, 2025