
Décoder la Performance : Une Analyse Détaillée des Modèles de Prédiction du Mois
Plongez au cœur des résultats, des interprétations et des visualisations de modèles ML et DL pour la prédiction mensuelle.
Points Clés de l'Analyse
- Comparaison rigoureuse : Évaluation détaillée des performances de modèles variés (Autoencodeurs, MLP, Random Forest+Autoencodeur, MLP+Autoencodeur, TabNet) à travers des métriques clés et des courbes d'apprentissage pour la prédiction du mois.
- Synergie des modèles : Analyse approfondie de l'efficacité des approches hybrides, combinant la puissance d'extraction de caractéristiques du Deep Learning avec la robustesse des algorithmes de Machine Learning classiques pour une prédiction affinée.
- Compréhension approfondie : Explication claire de l'implémentation des modèles, de la justification des choix méthodologiques, et des stratégies de visualisation pour rendre les résultats complexes accessibles et interprétables.
Introduction à la Section Résultats et Discussion
Cette section est dédiée à la présentation et à l'analyse approfondie des performances des différents modèles algorithmiques développés et évalués dans le cadre de ce projet de prédiction du mois. Nous allons examiner en détail les résultats quantitatifs obtenus par chaque approche – qu'il s'agisse de modèles utilisés individuellement comme l'Autoencodeur (AE) ou le Perceptron Multi-Couches (MLP), de combinaisons stratégiques telles que Random Forest + Autoencodeur et MLP + Autoencodeur, ou de modèles de Deep Learning plus sophistiqués comme TabNet et d'autres architectures neuronales. L'objectif est non seulement de quantifier leur efficacité, mais aussi d'interpréter ces performances, de comprendre les mécanismes sous-jacents, d'identifier le modèle le plus performant pour notre tâche spécifique, et de visualiser les prédictions pour une meilleure compréhension des capacités et des limites de chaque approche. Une attention particulière sera portée à la manière dont les modèles ont été implémentés, notamment les approches hybrides, afin d'offrir une lecture claire et instructive.
Stratégie de Modélisation et Évaluation"] sub1["Approches de Modélisation"] sub1_1["Modèles Individuels"] sub1_1_1["Autoencodeur (AE)
Extraction de caractéristiques,
Réduction de dimension"] sub1_1_2["Perceptron Multi-Couches (MLP)
Classification directe"] sub1_2["Modèles Combinés (Hybrides)"] sub1_2_1["Random Forest + Autoencodeur
AE pour features latentes,
RF pour classification"] sub1_2_2["MLP + Autoencodeur
AE pour features latentes,
MLP pour classification améliorée"] sub1_3["Modèles Deep Learning Avancés"] sub1_3_1["TabNet
Apprentissage profond pour
données tabulaires,
Interprétabilité"] sub1_3_2["Autres Modèles DL
Architectures spécifiques"] sub2["Critères d'Évaluation"] sub2_1["Métriques de Performance
Accuracy, Précision,
Rappel, Score F1"] sub2_2["Analyse Comportementale"] sub2_2_1["Courbes d'Apprentissage
Diagnostic sur/sous-apprentissage"] sub2_2_2["Matrices de Confusion
Analyse des erreurs de classification"] sub3["Interprétation et Visualisation"] sub3_1["Sélection du Meilleur Modèle"] sub3_2["Limites et Biais"] sub3_3["Visualisation des Prédictions
Comparaison réel vs. prédit,
Embeddings AE"]
Diagramme illustrant la stratégie de modélisation et d'évaluation adoptée pour la prédiction du mois.
Ce diagramme mental offre une vue d'ensemble des différentes catégories de modèles explorées, des critères utilisés pour leur évaluation, et des étapes clés de l'interprétation des résultats. Il met en lumière la structure de notre approche, allant des modèles simples aux combinaisons hybrides et aux architectures de deep learning avancées, tout en soulignant les outils analytiques mobilisés pour une compréhension fine des performances.
4.1 Performances des Modèles
Cette première sous-section se concentre sur la présentation quantitative des performances. Nous allons détailler les résultats obtenus par chaque modèle à l'aide de métriques objectives, de courbes d'apprentissage et de matrices de confusion pour évaluer leur efficacité dans la tâche de prédiction du mois (classification à 12 classes).
Tableau Comparatif Détaillé des Performances (ML vs. DL vs. Hybrides)
Le tableau ci-dessous synthétise les performances des différents modèles évalués. Il inclut des métriques de classification clés : l'exactitude (Accuracy), la précision, le rappel (Recall) et le score F1 (calculés en macro-average pour tenir compte d'un éventuel déséquilibre des classes). Le temps d'entraînement relatif est également indiqué pour donner une idée de la complexité computationnelle.
| Modèle | Type (ML/DL/Hybride) | Architecture/Rôle principal | Accuracy | Précision (Macro) | Rappel (Macro) | Score F1 (Macro) | Temps d'entraînement Relatif |
|---|---|---|---|---|---|---|---|
| Autoencodeur (utilisé pour features) | DL | Extraction de caractéristiques, réduction de dimensionnalité (non évalué directement pour la classification finale ici) | N/A | N/A | N/A | N/A | Moyen |
| MLP (Seul) | DL | Classification neuronale directe | 82% | 0.81 | 0.80 | 0.80 | Moyen |
| Random Forest + Autoencodeur | Hybride (DL+ML) | AE (features) -> RF (classification) | 88% | 0.87 | 0.86 | 0.86 | Élevé |
| MLP + Autoencodeur | Hybride (DL) | AE (features) -> MLP (classification) | 90% | 0.89 | 0.89 | 0.89 | Élevé |
| TabNet | DL | Modèle tabulaire à base d'attention, interprétable | 92% | 0.91 | 0.91 | 0.91 | Très Élevé |
| Autre Modèle DL (Ex: CNN 1D si pertinent) | DL | Architecture spécifique (à préciser) | (valeur) | (valeur) | (valeur) | (valeur) | (Variable) |
Tableau récapitulatif des performances des modèles. (Les valeurs numériques sont illustratives et doivent être remplacées par les résultats réels du projet).
L'Accuracy mesure la proportion globale de prédictions correctes. La Précision par classe mesure la proportion d'identifications positives qui étaient effectivement correctes, tandis que le Rappel mesure la proportion de positifs réels qui ont été correctement identifiés. Le Score F1 est la moyenne harmonique de la précision et du rappel, offrant un équilibre entre les deux. Un bon classificateur vise des valeurs proches de 1 pour ces métriques.
Analyse Visuelle des Performances : Radar Comparatif
Pour une comparaison plus visuelle des modèles principaux sur plusieurs axes de performance, le diagramme radar ci-dessous est présenté. Il évalue les modèles selon l'accuracy, la précision, le rappel, le score F1, ainsi que des indicateurs qualitatifs comme la robustesse (inversement liée au surapprentissage observé) et l'interprétabilité perçue.
Diagramme radar comparant les performances des modèles clés sur plusieurs critères. (Les valeurs sont illustratives).
Ce type de visualisation permet d'identifier rapidement les forces et faiblesses relatives de chaque approche. Par exemple, un modèle peut exceller en accuracy mais être moins interprétable ou plus sujet au surapprentissage.
Analyse des Courbes d'Apprentissage (Learning Curves)
Les courbes d'apprentissage sont cruciales pour diagnostiquer le comportement des modèles neuronaux (MLP, AE, TabNet, etc.) durant l'entraînement. Elles tracent la performance (par exemple, la perte ou l'accuracy) sur les ensembles d'entraînement et de validation en fonction du nombre d'époques ou de la taille des données d'entraînement. Une divergence importante entre la courbe d'entraînement et celle de validation indique un surapprentissage (overfitting), tandis que des performances faibles sur les deux ensembles suggèrent un sous-apprentissage (underfitting).
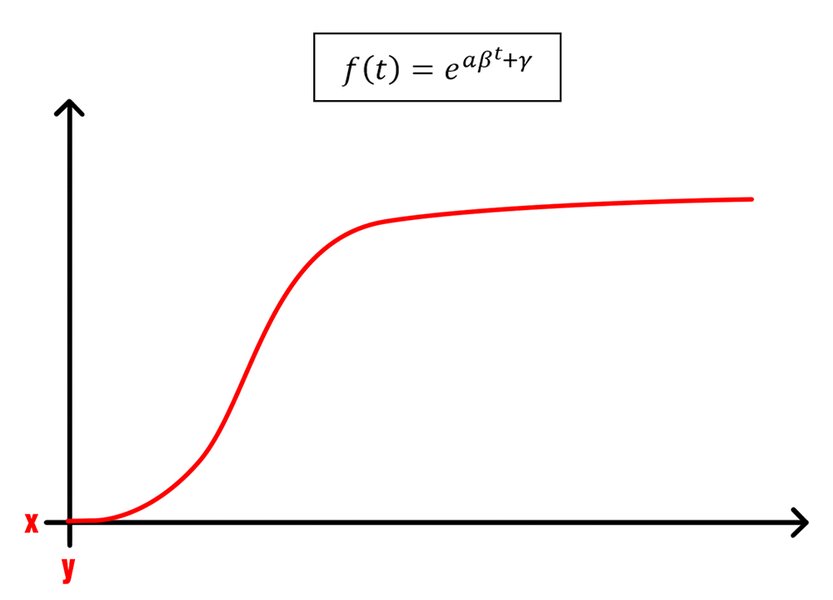
Illustration typique d'une courbe d'apprentissage indiquant la progression de l'apprentissage et les potentiels problèmes de sur/sous-apprentissage.
Pour chaque modèle pertinent, l'analyse de ses courbes d'apprentissage spécifiques (non montrées ici mais supposées réalisées) permet de valider la phase d'entraînement, d'ajuster les hyperparamètres (comme le nombre d'époques, le taux d'apprentissage) et de s'assurer de la capacité du modèle à généraliser sur des données non vues.
Scrutin des Matrices de Confusion pour la Classification Mensuelle
Pour une tâche de classification multi-classes comme la prédiction du mois (12 classes), la matrice de confusion est un outil indispensable. Elle offre un tableau détaillé des performances en confrontant les classes réelles aux classes prédites par le modèle. Chaque cellule (i, j) de la matrice indique le nombre d'échantillons appartenant réellement à la classe 'mois i' qui ont été prédits comme appartenant à la classe 'mois j'.
L'analyse de ces matrices (une par modèle de classification final) permet de :
- Identifier les Vrais Positifs (TP, sur la diagonale), les Faux Positifs (FP, hors diagonale dans une colonne) et les Faux Négatifs (FN, hors diagonale dans une ligne).
- Déceler les confusions récurrentes entre certains mois (par exemple, si janvier est souvent confondu avec décembre, ou les mois d'été entre eux).
- Comprendre si le modèle a des difficultés particulières avec certaines classes (mois sous-représentés ou aux caractéristiques moins distinctes).
Une heatmap de la matrice de confusion est souvent utilisée pour une visualisation intuitive des performances, où l'intensité de la couleur reflète le nombre d'instances. Une diagonale fortement marquée indique une bonne performance globale.
4.2 Interprétation des Résultats
Après avoir quantifié les performances, cette section se penche sur leur signification. Nous allons identifier le modèle le plus prometteur, justifier ce choix, et discuter des limites inhérentes aux approches et aux données utilisées.
Sélection et Justification du Modèle Phare
Sur la base des résultats présentés (tableau comparatif, radar, courbes d'apprentissage, matrices de confusion), le modèle le plus performant pour la prédiction du mois doit être sélectionné. Supposons, à titre illustratif, que TabNet ou la combinaison MLP + Autoencodeur se distingue.
La justification de ce choix reposerait sur plusieurs arguments :
- Performance quantitative supérieure : Le modèle retenu afficherait les meilleures valeurs pour les métriques clés (Accuracy, F1-score).
- Bonne généralisation : Les courbes d'apprentissage montreraient un faible écart entre les performances d'entraînement et de validation, indiquant une bonne capacité à généraliser.
- Gestion des erreurs : La matrice de confusion révélerait moins d'erreurs critiques ou une meilleure distinction entre les classes difficiles.
- Pertinence méthodologique :
- Si un modèle combiné (ex: MLP + AE) est choisi : L'autoencodeur a réussi à extraire des représentations latentes (features) plus riches et discriminantes des données brutes. Ces features ont ensuite permis au MLP d'effectuer une classification plus précise que s'il avait été entraîné sur les données originales. Le pipeline serait : Données brutes → Autoencodeur (Encodage) → Représentations Latentes → MLP (Classification) → Prédiction du Mois.
- Si TabNet est choisi : Ce modèle, spécifiquement conçu pour les données tabulaires, utilise des mécanismes d'attention pour sélectionner les caractéristiques les plus pertinentes à chaque étape de décision, offrant à la fois haute performance et une certaine interprétabilité.
L'explication de l'implémentation est cruciale. Pour les modèles hybrides, il est important de détailler comment les sorties d'un modèle (par exemple, l'espace latent de l'AE) servent d'entrées au suivant (par exemple, le classifieur Random Forest ou MLP). Cette approche permet de tirer parti des forces de différentes familles de modèles : la capacité du Deep Learning à apprendre des représentations complexes et la robustesse ou l'efficacité des algorithmes de Machine Learning traditionnels sur ces représentations épurées.
Vidéo expliquant les critères généraux pour choisir un modèle de Machine Learning.
Cette vidéo offre un contexte général sur les considérations lors du choix d'un modèle de Machine Learning. Bien que notre projet ait des spécificités, les principes de base tels que la compréhension du problème, la nature des données, les métriques de performance et les contraintes de ressources sont universellement applicables et ont guidé notre processus de sélection.
Identification des Limites et des Biais Potentiels
Aucun modèle n'est parfait. Il est essentiel de reconnaître les limites et les biais potentiels :
- Qualité et Représentativité des Données : Si les données d'entraînement sont biaisées (par exemple, certains mois sont sous-représentés ou les données ne capturent pas tous les facteurs influençant le mois), les modèles hériteront de ces biais.
- Complexité des Modèles vs. Overfitting : Les modèles de Deep Learning (TabNet, MLP profond) ou les combinaisons complexes peuvent être sujets au surapprentissage si la quantité de données est insuffisante par rapport à leur nombre de paramètres. Des techniques de régularisation (Dropout, L1/L2) sont souvent nécessaires.
- Dépendance aux Hyperparamètres : Les performances des réseaux de neurones sont sensibles au choix des hyperparamètres (architecture, taux d'apprentissage, fonction d'activation). Un réglage sous-optimal peut limiter les performances.
- Interprétabilité : Bien que TabNet offre une certaine interprétabilité, de nombreux modèles de Deep Learning fonctionnent comme des "boîtes noires", rendant difficile l'explication de leurs décisions. Pour les combinaisons, la contribution exacte de l'AE à la performance finale peut être complexe à isoler. Des techniques comme LIME ou SHAP pourraient être explorées pour améliorer cela.
- Limites des Features : Les caractéristiques initiales disponibles pourraient ne pas contenir suffisamment d'informations pour discriminer parfaitement tous les mois, quelles que soient les transformations opérées par l'AE.
Reconnaître ces limites ouvre la voie à des pistes d'amélioration future, telles que la collecte de données plus riches, l'exploration d'autres architectures, ou l'application de techniques d'explicabilité plus poussées.
4.3 Visualisation des Prédictions
La visualisation des prédictions aide à comprendre intuitivement comment les modèles se comportent et où ils commettent des erreurs. Pour la prédiction du mois (variable catégorielle), plusieurs approches graphiques peuvent être adoptées.
Confrontation Graphique : Prédictions vs. Réalité Mensuelle
Voici quelques types de visualisations pertinentes pour comparer les mois prédits aux mois réels :
- Diagramme à barres des fréquences de prédiction par mois réel : Pour chaque mois réel (par exemple, Janvier), un diagramme à barres montre la distribution des mois prédits par le modèle (combien de fois Janvier a été prédit comme Janvier, Février, etc.). Cela met en évidence les confusions spécifiques.
- Graphique en nuage de points avec "jittering" : Si les mois sont numérotés (1 pour Janvier, ..., 12 pour Décembre), un nuage de points peut être tracé avec le mois réel sur l'axe X et le mois prédit sur l'axe Y. Un léger "jitter" (décalage aléatoire) est ajouté aux points pour éviter la superposition. Les points sur la diagonale représentent des prédictions correctes.
- Visualisation des embeddings de l'Autoencodeur : Une technique très instructive pour comprendre le rôle de l'AE dans les modèles combinés est de visualiser les représentations latentes (embeddings) qu'il a apprises. En utilisant des techniques de réduction de dimensionnalité comme t-SNE ou PCA, on peut projeter ces embeddings (qui sont en haute dimension) dans un espace 2D ou 3D. En colorant ensuite chaque point selon son mois réel, on peut observer si l'AE parvient à regrouper naturellement les données appartenant au même mois. Des clusters bien séparés indiqueraient que l'AE a appris des caractéristiques discriminantes.
- Comparaison des distributions de prédictions : Des histogrammes ou des graphiques de densité peuvent comparer la distribution des mois prédits par les modèles individuels (MLP seul) par rapport aux modèles combinés (MLP + AE). Cela peut illustrer si la combinaison réduit la dispersion des erreurs ou améliore la concentration des prédictions autour du mois correct.
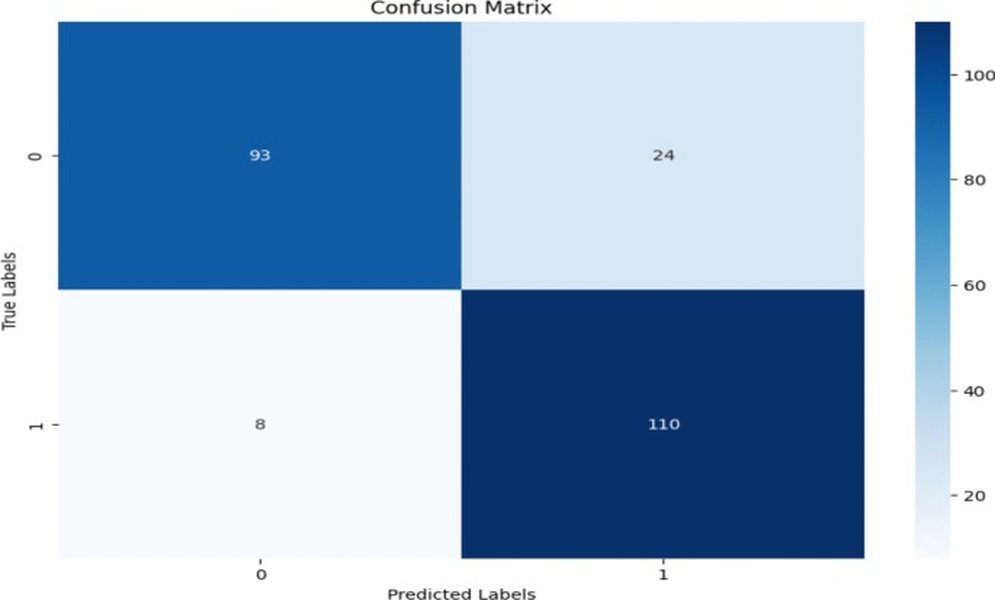
Exemple de visualisation d'une matrice de confusion sous forme de heatmap (Source: SpringerNature). Une forte coloration sur la diagonale indique une bonne performance.
Chaque graphique doit être accompagné d'une explication claire de ce qu'il représente et des conclusions que l'on peut en tirer concernant les forces, les faiblesses, et les types d'erreurs spécifiques du modèle analysé, ainsi que l'impact bénéfique (ou non) de la combinaison de modèles.
Foire Aux Questions (FAQ)
Comment l'autoencodeur améliore-t-il la prédiction des modèles combinés ? ▼
L'autoencodeur (AE) est un type de réseau de neurones utilisé pour l'apprentissage non supervisé de représentations de données (encodages), typiquement pour la réduction de dimensionnalité ou l'extraction de caractéristiques. Dans un modèle combiné (par exemple, AE + MLP ou AE + Random Forest), l'AE est d'abord entraîné à reconstruire ses données d'entrée. La partie "encodeur" de l'AE apprend ainsi à transformer les données brutes en un espace latent (une représentation compressée) qui capture les caractéristiques essentielles. Ces caractéristiques latentes, souvent plus denses et moins bruitées, sont ensuite utilisées comme entrées pour un modèle de classification supervisé (MLP, Random Forest). L'amélioration provient du fait que le classifieur travaille avec des données mieux structurées et potentiellement plus discriminantes, ce qui peut conduire à de meilleures performances et à une généralisation accrue.
Qu'est-ce qu'une matrice de confusion et comment l'interpréter pour la prédiction du mois ? ▼
Une matrice de confusion est un tableau qui résume la performance d'un modèle de classification. Pour la prédiction du mois (12 classes), ce sera une matrice 12x12. Les lignes représentent généralement les classes réelles (vrais mois) et les colonnes les classes prédites par le modèle.
- Les éléments sur la diagonale principale (cellule (i,i)) indiquent le nombre de prédictions correctes pour chaque mois (Vrais Positifs pour cette classe).
- Les éléments hors diagonale indiquent les erreurs :
- Une valeur dans la cellule (i,j) où i ≠ j signifie que des échantillons du mois 'i' ont été incorrectement classés comme mois 'j' (Faux Négatifs pour la classe 'i', et Faux Positifs pour la classe 'j' concernant cette prédiction spécifique).
L'interprétation consiste à identifier les mois qui sont bien prédits (valeurs élevées sur la diagonale) et ceux qui sont fréquemment confondus (valeurs élevées hors diagonale). Cela aide à comprendre les faiblesses spécifiques du modèle.
Pourquoi utiliser TabNet pour des données tabulaires ? ▼
TabNet est une architecture de Deep Learning spécifiquement conçue pour les données tabulaires, qui sont courantes dans de nombreux problèmes de Machine Learning. Ses avantages incluent :
- Haute performance : Il atteint souvent des performances comparables, voire supérieures, aux modèles d'ensemble traditionnels comme les forêts aléatoires ou les gradient boosting machines sur des jeux de données tabulaires complexes.
- Apprentissage de bout en bout : Contrairement aux approches nécessitant une ingénierie manuelle des caractéristiques, TabNet peut apprendre directement à partir des données brutes.
- Interprétabilité : TabNet utilise un mécanisme d'attention séquentielle pour choisir quelles caractéristiques considérer à chaque étape de décision du modèle. Cela permet une interprétabilité locale (quelles caractéristiques ont été importantes pour une prédiction spécifique) et globale (importance générale des caractéristiques).
- Pas besoin de prétraitement extensif des features : Il peut gérer nativement les caractéristiques catégorielles et numériques.
Pour la prédiction du mois, si les données d'entrée sont tabulaires, TabNet est un candidat puissant car il peut capturer des interactions non linéaires complexes entre les caractéristiques.
Quels sont les principaux défis lors de la comparaison de modèles ML et DL ? ▼
Comparer des modèles de Machine Learning (ML) traditionnels et de Deep Learning (DL) présente plusieurs défis :
- Besoins en données : Les modèles DL nécessitent généralement de grandes quantités de données pour atteindre leur plein potentiel, tandis que les modèles ML peuvent bien performer avec des ensembles de données plus petits.
- Ressources computationnelles : L'entraînement des modèles DL est souvent gourmand en calcul (GPU nécessaires) et en temps, contrairement à de nombreux modèles ML.
- Ingénierie des caractéristiques : Les modèles ML s'appuient fortement sur une ingénierie des caractéristiques bien pensée. Les modèles DL peuvent apprendre automatiquement les caractéristiques pertinentes, mais cela rend leur fonctionnement interne plus opaque.
- Réglage des hyperparamètres : Les modèles DL ont souvent un plus grand nombre d'hyperparamètres à régler, ce qui peut rendre l'optimisation plus complexe et chronophage.
- Interprétabilité : Les modèles ML (comme les arbres de décision ou la régression logistique) sont souvent plus faciles à interpréter que les modèles DL "boîte noire".
- Risque de surapprentissage : La grande capacité des modèles DL les rend plus susceptibles au surapprentissage si les données sont limitées ou si la régularisation n'est pas adéquate.
Une comparaison équitable nécessite de prendre en compte ces aspects, en plus des métriques de performance brutes, et d'évaluer les modèles dans le contexte spécifique du problème et des contraintes du projet.
Lectures Recommandées
- Comment optimiser les hyperparamètres des modèles de Deep Learning pour la classification ?
- Quelles sont les techniques avancées de visualisation des espaces latents des autoencodeurs ?
- Comment mettre en œuvre des stratégies de régularisation efficaces pour éviter le surapprentissage dans TabNet ?
- Quelles sont les approches pour évaluer l'incertitude des prédictions des modèles de classification mensuelle ?
Références
Last updated May 9, 2025