
Multilevel-Modelle trotz Zeitversatz? So analysieren Sie Depression & Affekt
Entdecken Sie, wie Sie den Zusammenhang zwischen Depressivität und Affekt modellieren, auch wenn die Messzeitpunkte nicht perfekt übereinstimmen.
Sie möchten den Zusammenhang zwischen Depressivität (gemessen zu T0 und T60) und positivem/negativem Affekt (gemessen zu T5 und T55) mithilfe eines Multilevel-Modells (MLM) untersuchen und fragen sich, ob der leichte zeitliche Versatz der Messungen ein Problem darstellt und wie Sie Ihr Modell am besten formulieren. Das ist eine ausgezeichnete Frage, da solche Designs in der Längsschnittforschung häufig vorkommen.
Wichtige Erkenntnisse
- Multilevel-Modelle sind geeignet: Diese Modelle sind ideal für Ihre Datenstruktur, da Messungen (Level 1: Zeitpunkte T0/T5 und T60/T55) innerhalb von Personen (Level 2: Individuen) verschachtelt sind. Sie können individuelle Unterschiede in den Ausgangswerten und Veränderungen über die Zeit berücksichtigen.
- Zeitlicher Versatz ist relevant: Der 5-Minuten-Versatz ist nicht trivial und muss bei der Interpretation, insbesondere bei kausalen Schlussfolgerungen, berücksichtigt werden. Affekt zu T5 kann Depressivität zu T0 nicht kausal vorhersagen. Das Modell kann jedoch Assoziationen zu den jeweiligen Messgelegenheiten abbilden.
- Modellformulierung ist flexibel: Sie können den Affekt als zeitlich variierenden Prädiktor für die Depressivität modellieren, wobei Sie die Messgelegenheit (z.B. T0/T5 vs. T60/T55) berücksichtigen. Zufällige Effekte für Personen sind entscheidend, um die individuelle Heterogenität zu erfassen.
Warum ein Multilevel-Modell die richtige Wahl ist
Umgang mit verschachtelten Datenstrukturen
Ihre Daten weisen eine typische hierarchische oder verschachtelte Struktur auf: Messungen (Level 1) sind innerhalb von Individuen (Level 2) gruppiert. Multilevel-Modelle (auch bekannt als hierarchische lineare Modelle oder Mixed-Effects-Modelle) sind speziell für die Analyse solcher Daten konzipiert. Sie ermöglichen es Ihnen:
- Die Varianz auf verschiedenen Ebenen zu zerlegen (z. B. wie stark variiert die Depressivität zwischen Personen vs. innerhalb einer Person über die Zeit?).
- Individuelle Unterschiede in den Ausgangsniveaus (Intercepts) und den Veränderungsraten (Slopes) über die Zeit zu modellieren.
- Korrelationen zwischen wiederholten Messungen innerhalb derselben Person korrekt zu berücksichtigen, was bei herkömmlichen Regressionsmodellen oft verletzt wird.
- Auch mit unbalancierten Daten oder ungleichen Zeitintervallen umzugehen, obwohl Ihre Intervalle hier regelmäßig erscheinen.
Gerade bei der Untersuchung von psychologischen Konstrukten wie Depression und Affekt, die sowohl stabile Persönlichkeitsanteile (Between-Person-Unterschiede) als auch situative Schwankungen (Within-Person-Veränderungen) aufweisen, sind MLMs besonders aussagekräftig.
Der zeitliche Versatz: Herausforderung und Lösungsansätze
Interpretation der Ergebnisse
Der kritischste Punkt ist der Zeitversatz zwischen den Messungen von Depressivität (T0, T60) und Affekt (T5, T55). Dies hat Implikationen für die Interpretation, insbesondere bezüglich Kausalität:
- T0 (Depression) vs. T5 (Affekt): Streng genommen kann der Affekt, der zu T5 gemessen wurde, die Depressivität zu T0 (5 Minuten *früher*) nicht kausal beeinflussen oder vorhersagen. Wenn Sie Affekt zu T5 als Prädiktor für Depressivität zu T0 verwenden, modellieren Sie eher eine Assoziation zur "ersten Messgelegenheit" – also wie Depressivität und kurz danach gemessener Affekt zusammenhängen.
- T60 (Depression) vs. T55 (Affekt): Hier wurde der Affekt (T55) vor der Depressivität (T60) gemessen. Dies passt besser zu einer Vorhersage-Logik, bei der der Affektzustand kurz vor der Depressionsmessung als Prädiktor dient. Die Interpretation als kurzfristiger Prädiktor ist hier plausibler.
Wie Sie den Versatz im Modell berücksichtigen können
Trotz des Versatzes können Sie sinnvolle Analysen durchführen:
- Modellierung von Assoziationen pro Messgelegenheit: Betrachten Sie T0/T5 als eine Einheit ("Messgelegenheit 1") und T60/T55 als eine zweite Einheit ("Messgelegenheit 2"). Sie modellieren dann, wie Affekt und Depressivität zu diesen jeweiligen Zeitpunkten (trotz des kleinen Lags) zusammenhängen und wie sich dieser Zusammenhang möglicherweise über die Gelegenheiten hinweg ändert.
- Lagged Effects modellieren: Sie könnten sich darauf konzentrieren, wie der Affekt zu einem früheren Zeitpunkt die Depressivität zu einem späteren Zeitpunkt vorhersagt. Das Modell würde dann z.B. untersuchen, ob Affekt zu T5 die Depressivität zu T60 vorhersagt (ein längerer Lag) oder ob Affekt zu T55 die Depressivität zu T60 vorhersagt (kurzer Lag).
- Kontrolle für Baseline-Depressivität: Wenn Sie die Veränderung der Depressivität vorhersagen möchten, können Sie den Depressionswert zu T0 als Kontrollvariable (Kovariate) auf Level 2 oder als Prädiktor für die Depressivität zu T60 einbeziehen.
Die beste Strategie hängt von Ihrer spezifischen Forschungsfrage ab. Für die Vorhersage der Depressivität durch Affekt ist die Modellierung der Assoziation pro Messgelegenheit (Option 1) oder die Verwendung von T55-Affekt zur Vorhersage von T60-Depression (Teil von Option 2) oft ein guter Ausgangspunkt.
Formulierung Ihres Multilevel-Modells
Ein typisches zweistufiges MLM für Ihre Daten könnte wie folgt aufgebaut sein:
Datenstruktur im Long-Format
Zuerst müssen Ihre Daten in einem "langen" Format vorliegen, bei dem jede Zeile eine Messung zu einem bestimmten Zeitpunkt für eine Person darstellt. Eine zusätzliche Variable kodiert die Messgelegenheit.
| Personen_ID | Messgelegenheit | Zeitpunkt_Depression | Zeitpunkt_Affekt | Depressivität | Positiver_Affekt | Negativer_Affekt |
|---|---|---|---|---|---|---|
| 1 | 1 | T0 | T5 | Wert_D_T0_P1 | Wert_PA_T5_P1 | Wert_NA_T5_P1 |
| 1 | 2 | T60 | T55 | Wert_D_T60_P1 | Wert_PA_T55_P1 | Wert_NA_T55_P1 |
| 2 | 1 | T0 | T5 | Wert_D_T0_P2 | Wert_PA_T5_P2 | Wert_NA_T5_P2 |
| 2 | 2 | T60 | T55 | Wert_D_T60_P2 | Wert_PA_T55_P2 | Wert_NA_T55_P2 |
| ... | ... | ... | ... | ... | ... | ... |
Tabelle 1: Beispielhafte Struktur des Datensatzes im Long-Format.
Modellgleichungen
Ein mögliches Modell, das die Depressivität durch positiven und negativen Affekt sowie die Messgelegenheit vorhersagt und individuelle Unterschiede berücksichtigt, könnte so aussehen:
Level 1 (Innerhalb der Person):
\[ \text{Depressivität}_{ij} = \beta_{0j} + \beta_{1j}(\text{Positiver Affekt}_{ij}) + \beta_{2j}(\text{Negativer Affekt}_{ij}) + \beta_{3j}(\text{Messgelegenheit}_{ij}) + e_{ij} \]- \( \text{Depressivität}_{ij} \): Depressionswert der Person \(j\) zur Messgelegenheit \(i\) (i=1 für T0/T5, i=2 für T60/T55).
- \( \text{Positiver Affekt}_{ij} \): Positiver Affekt der Person \(j\) zur Messgelegenheit \(i\) (gemessen zu T5 bzw. T55).
- \( \text{Negativer Affekt}_{ij} \): Negativer Affekt der Person \(j\) zur Messgelegenheit \(i\) (gemessen zu T5 bzw. T55).
- \( \text{Messgelegenheit}_{ij} \): Variable, die die Messgelegenheit kodiert (z.B. 0 für die erste, 1 für die zweite).
- \( \beta_{0j} \): Individueller Intercept (durchschnittliche Depressivität der Person \(j\) bei Gelegenheit 0, wenn Affektwerte 0 sind oder zentriert wurden).
- \( \beta_{1j}, \beta_{2j} \): Individuelle Effekte (Slopes) von positivem/negativem Affekt für Person \(j\).
- \( \beta_{3j} \): Individueller Effekt der Zeit/Messgelegenheit für Person \(j\) (Veränderung der Depressivität).
- \( e_{ij} \): Messfehler oder Residual auf Level 1.
Hinweis: Die Affektvariablen sollten möglicherweise zentriert werden (z.B. Grand-Mean-Zentrierung oder Person-Mean-Zentrierung), um die Interpretation des Intercepts zu erleichtern und Multikollinearität zu reduzieren.
Level 2 (Zwischen den Personen):
Die individuellen Effekte von Level 1 werden auf Level 2 modelliert:
\[ \beta_{0j} = \gamma_{00} + u_{0j} \quad (\text{Zufälliger Intercept}) \] \[ \beta_{1j} = \gamma_{10} \quad (\text{Fester Effekt für Positiven Affekt}) \] \[ \beta_{2j} = \gamma_{20} \quad (\text{Fester Effekt für Negativen Affekt}) \] \[ \beta_{3j} = \gamma_{30} + u_{3j} \quad (\text{Zufälliger Effekt für Messgelegenheit/Zeit}) \]- \( \gamma_{00} \): Durchschnittlicher Depressionswert über alle Personen zur ersten Messgelegenheit (bei zentrierten Prädiktoren).
- \( \gamma_{10}, \gamma_{20} \): Durchschnittliche feste Effekte (Fixed Effects) von positivem und negativem Affekt auf die Depressivität über alle Personen hinweg.
- \( \gamma_{30} \): Durchschnittliche Veränderung der Depressivität von der ersten zur zweiten Messgelegenheit über alle Personen.
- \( u_{0j} \): Zufälliger Effekt (Random Effect) für den Intercept der Person \(j\). Erfasst, wie die durchschnittliche Depressivität von Person zu Person variiert.
- \( u_{3j} \): Zufälliger Effekt für die Steigung der Messgelegenheit der Person \(j\). Erfasst, wie die Veränderung der Depressivität von Person zu Person variiert.
In diesem Beispiel wird angenommen, dass der Effekt des Affekts über die Personen hinweg konstant ist (\(\beta_{1j} = \gamma_{10}\), \(\beta_{2j} = \gamma_{20}\) - nur feste Effekte). Sie könnten jedoch auch zufällige Effekte für die Affektvariablen hinzufügen (\(\beta_{1j} = \gamma_{10} + u_{1j}\), \(\beta_{2j} = \gamma_{20} + u_{2j}\)), wenn Sie annehmen, dass der Zusammenhang zwischen Affekt und Depressivität von Person zu Person unterschiedlich stark ist. Mit nur zwei Messzeitpunkten kann die Schätzung vieler zufälliger Effekte jedoch schwierig sein.
Interaktionseffekte
Sie könnten auch Interaktionsterme hinzufügen, um zu prüfen, ob sich der Zusammenhang zwischen Affekt und Depressivität über die Messgelegenheiten ändert (z.B. Positiver_Affekt * Messgelegenheit).
Implementierung (Beispiel mit R)
Mit dem Paket lme4 in R könnte ein Modell mit zufälligem Intercept und zufälligem Slope für die Messgelegenheit wie folgt spezifiziert werden:
# Laden der Bibliothek
library(lme4)

# Beispiel-Modellformulierung
# Annahme: Daten sind im Long-Format im Dataframe 'meine_daten'
# Variablen: Depressivitaet, Positiver_Affekt, Negativer_Affekt, Messgelegenheit (0/1), Personen_ID

# Modell mit zufälligem Intercept und zufälligem Slope für Messgelegenheit
modell <- lmer(Depressivitaet ~ Positiver_Affekt + Negativer_Affekt + Messgelegenheit +
                   (1 + Messgelegenheit | Personen_ID),
                 data = meine_daten)

# Zusammenfassung der Ergebnisse
summary(modell)
Dieses Modell schätzt die durchschnittlichen Effekte (Fixed Effects) von Affekt und Zeit sowie die Varianz der zufälligen Effekte (Random Effects) für die Intercepts und die Zeit-Slopes zwischen den Personen.
Visualisierung der Modellkomponenten
Konzeptuelles Modell als Mindmap
Die folgende Mindmap visualisiert die Struktur eines möglichen Multilevel-Modells für Ihre Fragestellung:
Unterschiede im Depressions-Basislevel"] L2_SlopeVar["Varianz der Zeit-Slopes (u3j)
Unterschiede in der Depressions-Veränderung"] L2_Kov["(Optional) Level-2 Prädiktoren
z.B. Geschlecht, Alter"] Level1["Level 1: Messungen (Within-Person)"] L1_Outcome["Outcome: Depressivität (T0, T60)"] L1_Pred["Prädiktoren"] Affekt_Pos["Positiver Affekt (T5, T55)"] Affekt_Neg["Negativer Affekt (T5, T55)"] Zeit["Messgelegenheit (0 vs. 1)"] Interaktion["(Optional) Interaktionen
z.B. Affekt * Zeit"] L1_Error["Residualfehler (eij)"] Effekte["Modell-Effekte"] Fixed["Feste Effekte (Fixed Effects)"] Gamma00["γ00: Mittlerer Intercept"] Gamma10["γ10: Mittlerer Effekt Pos. Affekt"] Gamma20["γ20: Mittlerer Effekt Neg. Affekt"] Gamma30["γ30: Mittlerer Effekt Zeit"] Random["Zufällige Effekte (Random Effects)"] u0j["u0j: Individuelle Abweichung Intercept"] u3j["u3j: Individuelle Abweichung Zeit-Slope"] Kovarianz["(Optional) Kovarianz zw. u0j und u3j"]
Mindmap 1: Struktur des Multilevel-Modells zur Analyse des Zusammenhangs zwischen Depression und Affekt über zwei Messgelegenheiten.
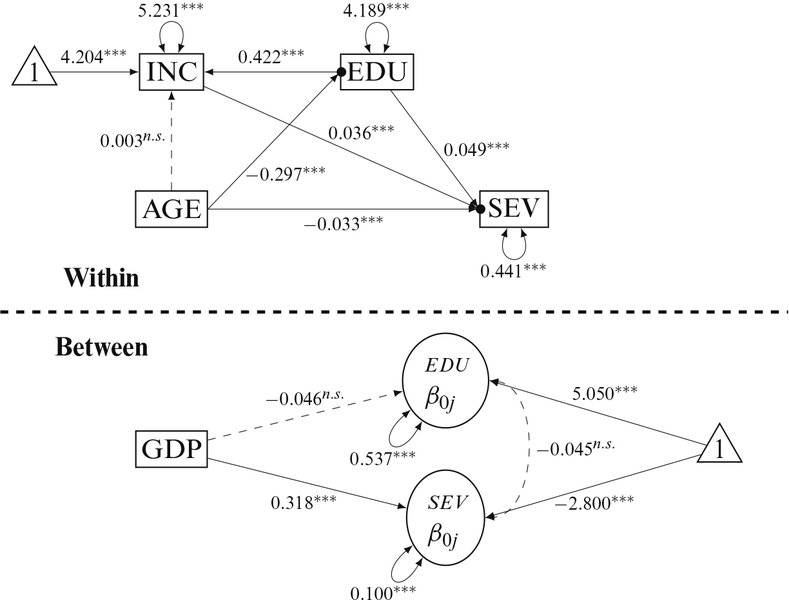
Abbildung 1: Beispielhafte Darstellung eines komplexeren Multilevel-Pfadmodells, das Beziehungen auf verschiedenen Ebenen zeigt (ähnlich dem Konzept Ihres Modells).
Hypothetische Stärke der Zusammenhänge
Radar-Chart zur Veranschaulichung
Das folgende Radar-Chart visualisiert hypothetische relative Stärken verschiedener Effekte, die in Ihrem Modell auftreten könnten. Es basiert nicht auf Ihren spezifischen Daten, sondern dient der Illustration möglicher Muster, wie sie oft in der Depressions- und Affektforschung gefunden werden. Beispielsweise wird oft erwartet, dass negativer Affekt stärker mit Depressivität assoziiert ist als (niedriger) positiver Affekt, und dass es sowohl stabile Unterschiede zwischen Personen als auch Schwankungen innerhalb von Personen gibt.
Radar-Chart 1: Hypothetische relative Stärke verschiedener Effekte in einem MLM für Depression und Affekt. 'Within' bezieht sich auf Zusammenhänge innerhalb von Personen über die Zeit, 'Between' auf Zusammenhänge zwischen Personen.
Einführung in Multilevel-Modelle
Das folgende Video bietet eine gute Einführung in die Grundlagen von Multilevel-Modellen, insbesondere das Random-Intercept-Modell, das einen Kernbestandteil Ihres Modells darstellt.
Video 1: Einführung in Multilevel-Modelle mit Fokus auf Random-Intercept-Modelle von Ian Brunton-Smith.
Häufig gestellte Fragen (FAQ)
Kann ich trotz des Zeitversatzes kausale Schlüsse ziehen?
Es ist schwierig, strenge kausale Schlüsse zu ziehen, insbesondere für die erste Messgelegenheit (Affekt T5 kann Depressivität T0 nicht verursachen). Für die zweite Messgelegenheit (Affekt T55 -> Depressivität T60) ist eine Interpretation im Sinne einer kurzfristigen Vorhersage plausibler, aber Kausalität bleibt schwer nachweisbar ohne experimentelles Design oder fortgeschrittenere Methoden (z.B. Cross-Lagged Panel Models mit mehr Zeitpunkten). Ihr MLM zeigt primär Assoziationen unter Berücksichtigung der Zeitstruktur.
Was genau bedeuten "Random Intercepts" und "Random Slopes"?
Random Intercepts (\(u_{0j}\)) erlauben, dass jede Person ein eigenes durchschnittliches Ausgangsniveau der abhängigen Variable (hier Depressivität) hat, das vom Gesamtmittelwert abweicht. Sie modellieren stabile Unterschiede zwischen Personen.
Random Slopes (z.B. \(u_{3j}\) für die Zeit) erlauben, dass der Effekt eines Prädiktors (hier die Veränderung über die Messgelegenheiten) für jede Person unterschiedlich stark ist. Sie modellieren individuelle Unterschiede in der Reaktion oder Veränderung.
Muss ich meine Affekt-Variablen zentrieren?
Eine Zentrierung wird oft empfohlen. Grand-Mean Centering (Subtraktion des Gesamtmittelwerts von jedem Wert) erleichtert die Interpretation des Intercepts als den erwarteten Wert für eine Person mit durchschnittlichem Affekt. Person-Mean Centering (Subtraktion des individuellen Mittelwerts über die Zeitpunkte) trennt Within-Person-Effekte (wie wirkt sich eine Abweichung vom *eigenen* Durchschnittsaffekt aus?) von Between-Person-Effekten (haben Personen mit *durchschnittlich* höherem Affekt andere Depressionswerte?). Die Wahl hängt von Ihrer Forschungsfrage ab.
Welche Software eignet sich für Multilevel-Modelle?
Es gibt mehrere Statistikpakete, die MLMs gut implementieren können:
- R: Pakete wie `lme4` (Funktion `lmer`) oder `nlme` (Funktion `lme`) sind sehr verbreitet und flexibel.
- SPSS: Die Prozedur "Gemischte Modelle" (MIXED) ist dafür vorgesehen.
- Stata: Befehle wie `mixed` oder spezialisierte Pakete für Paneldaten.
- Mplus: Sehr mächtig, insbesondere für komplexere Modelle wie Multilevel SEM.
- SAS: PROC MIXED.
Die Wahl hängt oft von Ihrer Vertrautheit mit der Software und den spezifischen Anforderungen Ihres Modells ab.
Referenzen
- Multilevel Modeling Tutorial (German) - DataCamp
- Grundbegriffe der Mehrebenenanalyse - Regorz Statistik
-
Multilevel Modeling of Relations Among Stress, Sleep Problems, and Depression... - NCBI PMC
-
Emotional and cognitive reactivity to daily events and depressive symptoms... - ScienceDirect
- Repeated Measures Analysis with SPSS (includes MLM) - UCLA OARC Stats
-
Analyzing multiple outcomes in clinical research using multivariate multilevel models - NCBI PMC
Empfohlene weitere Analysen
Last updated April 25, 2025