
揭秘OpenSearch:赋能智能应用的强大向量数据库
深入探索OpenSearch在向量数据库领域的革新与实践,解锁高效语义搜索与AI驱动应用。
核心亮点
- OpenSearch 通过其k-NN插件和向量引擎,将自身从传统搜索引擎扩展为功能全面的向量数据库,支持高维向量的高效存储、索引和相似性搜索。
- OpenSearch广泛适用于语义搜索、推荐系统、检索增强生成(RAG)、多模态搜索等AI驱动场景,通过结合词法和语义搜索提供强大能力。
- 服务器端调优关注索引性能(如禁用刷新、批量摄取、量化技术、分片策略)和搜索性能(如减少分段、预热索引);客户端调优侧重查询语句优化(如混合查询、批量查询)和应用层策略(如缓存、错误处理)。
在当今数据爆炸和人工智能迅速发展的时代,非结构化数据的处理和理解变得尤为关键。传统的数据库在处理精确匹配方面表现出色,但在处理“相似性”或“语义理解”时却力不从心。这时,向量数据库应运而生,它专门用于存储和检索高维向量数据,这些向量是文本、图像、音频等非结构化数据经过机器学习模型(如大型语言模型 LLMs)转换后得到的数值表示。这些向量捕捉了原始数据的语义信息和上下文关系,使得相似的数据在向量空间中彼此靠近,从而实现高效的相似性搜索。
作为OpenSearch的专家,我将为您深入解析OpenSearch如何完美融入这一趋势,成为一个强大且灵活的向量数据库解决方案。我们将详细探讨向量数据库的核心概念、OpenSearch实现其功能的机制、它所适用的各种场景,以及在实际使用中如何进行高效的服务器端与客户端调优,特别是针对查询语句的优化,以确保您的AI应用能充分发挥其潜力。
向量数据库:概念与核心洞察
向量数据库是一种专门为存储、管理和查询高维向量数据而设计的数据库系统。这些向量通常被称为嵌入(Embeddings),它们是机器学习模型将非结构化数据(如文本、图像、音频、视频等)转换为固定长度数值序列的结果。每个向量都代表了原始数据在特定语义空间中的位置,语义相似的数据在向量空间中会彼此靠近。
向量化的力量:从数据到语义
想象一下,传统的数据库在查找“红色轿车”时,会精确匹配所有包含“红色”和“轿车”这两个关键词的记录。而向量数据库则能更进一步,理解查询的语义。如果您搜索“舒适的交通工具”,它可能会返回“豪华轿车”、“宽敞的SUV”等,即使这些词语并未直接出现在查询中。这种能力正是通过将数据转换为高维向量,并计算这些向量之间的相似度来实现的。常见的相似度度量包括:
- 欧氏距离 (L2 Distance):衡量两个向量在多维空间中的直线距离。距离越小,相似度越高。
- 余弦相似度 (Cosine Similarity):衡量两个向量在方向上的相似性,无论其大小。它常用于文本语义相似度,因为它对向量长度不敏感。值范围通常在-1到1之间,1表示完全相同,-1表示完全相反。
- 内积 (Inner Product):与余弦相似度类似,但会考虑向量的长度。常用于推荐系统。
为何传统数据库难以胜任?
传统的关系型数据库或NoSQL数据库在处理结构化数据、执行精确匹配和聚合分析方面表现卓越。然而,它们在处理高维向量的相似性搜索时面临挑战:
- 性能瓶颈:对数百万甚至数十亿高维向量进行“蛮力”式的精确最近邻(k-NN)搜索计算量巨大,导致性能低下。
- 缺乏原生支持:传统数据库没有内置的索引结构或算法来高效地处理向量相似性搜索,需要复杂的外部集成或自定义实现。
向量数据库的出现正是为了弥补这一差距,它通过采用专门的近似最近邻(ANN)算法(如HNSW、IVF等)来加速在高维空间中的相似性搜索,极大地提升了搜索效率和准确性。
OpenSearch如何实现向量数据库功能?
OpenSearch是一个分布式、社区驱动、Apache 2.0许可的开源搜索和分析套件。它通过集成其核心的k-NN插件和向量引擎(Vector Engine),成功地将自身从一个传统的搜索引擎扩展为一个功能强大的向量数据库。
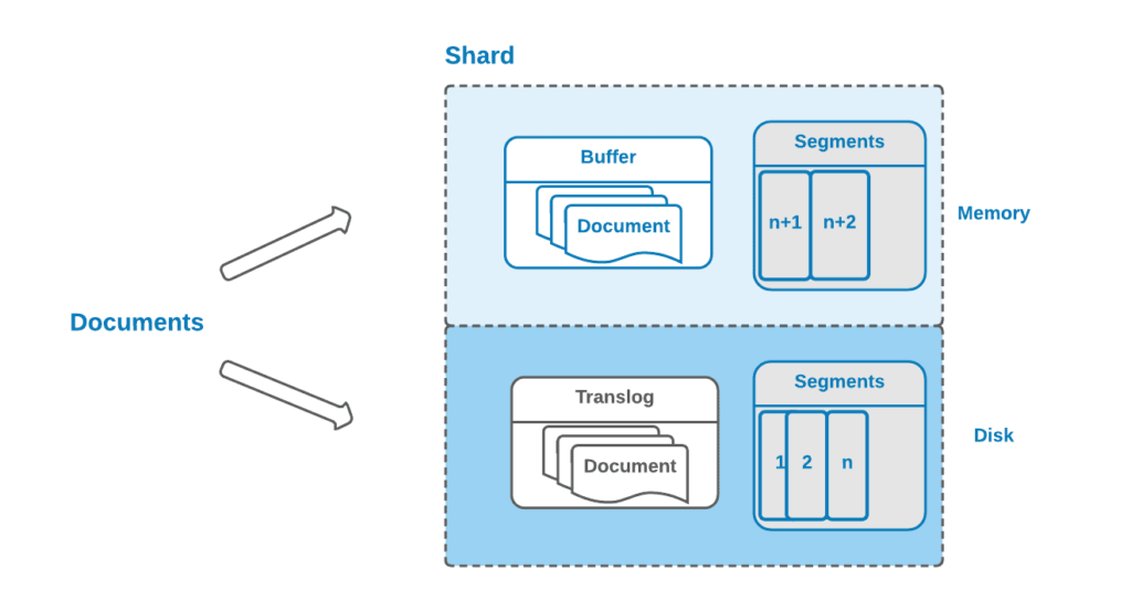
OpenSearch 架构概览
核心组件:k-NN插件与knn_vector数据类型
OpenSearch实现向量数据库功能的核心在于其k-NN插件。这个插件引入了一种自定义的数据类型:knn_vector。通过这个字段类型,用户可以直接将高维向量嵌入到OpenSearch索引中,并执行各种类型的k-NN搜索。knn_vector字段的灵活性使得OpenSearch能够支持广泛的k-NN工作负载。
支持的近似最近邻(ANN)算法
为了克服精确k-NN搜索在高维数据和大规模数据集上的性能瓶颈,OpenSearch实现了多种近似最近邻(ANN)算法,这些算法通过牺牲少量精度来换取搜索速度的显著提升:
- 分层可导航小世界 (Hierarchical Navigable Small Worlds, HNSW):这是一种基于图的算法,通过构建多层图结构来加速搜索。HNSW在大规模用例中表现出色,尤其在搜索速度和召回率之间取得了很好的平衡。
- 倒排文件系统 (Inverted File System, IVF):另一种ANN算法,它将向量空间划分为多个区域,然后仅在相关区域内进行搜索,适用于大规模数据。
- Lucene引擎 (精确k-NN):对于小规模部署或需要精确匹配并结合复杂过滤条件的场景,OpenSearch还可以利用其底层的Lucene引擎进行精确k-NN搜索。Lucene引擎提供了智能过滤等优势,可以根据情况自动应用最优的过滤策略(预过滤、后过滤或精确k-NN)。
向量存储、索引与融合搜索
OpenSearch允许您将向量嵌入与元数据(Metadata)一起存储和索引。这意味着您可以将描述性文本字段、时间戳、类别等与向量关联起来。这种设计减少了复杂性,提高了可维护性,并避免了数据重复。它还支持实时添加、更新或删除向量嵌入,而无需重新索引或影响查询性能,这对于动态变化的AI模型和搜索应用至关重要。
更重要的是,OpenSearch能够将向量搜索(语义搜索)、词法搜索(关键词搜索)和混合搜索(Hybrid Search)结合在一个软件包中。这为构建结合了语义理解和精确匹配的复杂搜索应用提供了强大能力,例如,一个查询可以同时利用用户输入的关键词和其隐含的语义意图来检索结果。
OpenSearch向量数据库的典型使用场景
OpenSearch作为向量数据库的强大能力使其适用于多种AI驱动的应用。其融合搜索、高可扩展性和实时性使其在众多场景中表现出色。
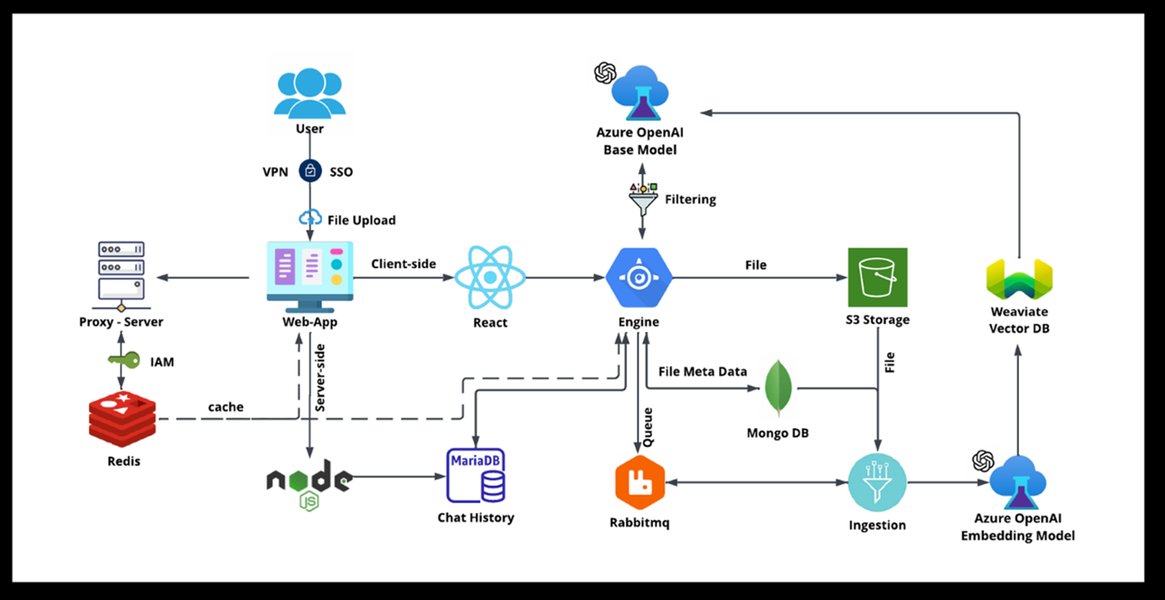
结合向量数据库的生成式AI聊天机器人
语义搜索 (Semantic Search)
超越传统关键词匹配,通过理解查询的含义来返回更相关的结果。
- 电子商务:用户搜索“防泼水外套”,OpenSearch可以返回冲锋衣、雨衣等具有防泼水功能的商品,即使商品描述中没有“防泼水”这个词。
- 文档搜索:企业内部员工搜索“关于2025年Q2收益报告的关键要点”,系统能返回最相关的报告摘要,即便查询与文档标题不完全匹配。
检索增强生成 (Retrieval Augmented Generation, RAG) 与大型语言模型 (LLMs)
RAG是当前提升LLM性能和减少幻觉的关键技术。OpenSearch可以作为外部知识库,为LLMs提供实时、准确的上下文信息。
- 智能客服机器人:当用户提问关于公司最新产品特性时,LLM可以从OpenSearch向量数据库中检索最新的产品手册、FAQ文档等,从而生成更准确、更具时效性的回答。
- 代码生成助手:LLM在生成代码时,可以从OpenSearch中检索相关的API文档、代码片段,确保生成的代码符合最佳实践。
推荐引擎 (Recommendation Engines)
根据用户行为和商品特征生成个性化推荐。
- 内容推荐:基于用户观看历史、浏览偏好(转换为向量),推荐相似的电影、新闻文章或音乐。
- 商品推荐:根据用户的购买历史或浏览过的商品(转换为向量),推荐其他可能感兴趣的商品。OpenSearch能通过协同过滤技术,实现用户-用户或物品-物品的相似性匹配。
多模态搜索 (Multimodal Search)
实现跨不同数据类型(如图片和文本)的相似性搜索。
- “以图搜图”:上传一张图片,系统能找到数据库中视觉上相似的图片。
- 跨媒体检索:搜索“户外活动的狗的图片”,系统能同时识别图片内容和描述文本,返回最相关的结果。
异常检测与欺诈检测 (Anomaly and Fraud Detection)
通过向量距离快速识别与正常模式偏离较大的异常事件。
- 金融欺诈:将用户的交易模式表示为向量,当出现与历史正常交易模式距离较大的交易向量时,及时预警。
- 网络安全:识别异常的网络流量模式或用户登录行为,以检测潜在的攻击或入侵。
个性化与用户级内容定位 (Personalization & User-level Content Targeting)
根据用户的兴趣向量,向其推荐个性化的内容、广告或产品。这在广告投放、内容订阅等领域尤为重要。
日志分析与企业搜索 (Log Analytics & Enterprise Search)
识别相似的日志模式或异常日志事件,提高故障排除效率。在企业内部,员工可以在海量文档、知识库中进行高效、语义化的搜索。
如何使用OpenSearch的向量数据库
使用OpenSearch作为向量数据库涉及几个关键步骤,从数据准备到最终的查询和集成。
1. 数据准备与嵌入生成
- 选择数据集:确定您要进行向量搜索的数据集(例如电影、产品描述、文档等)。
- 选择嵌入模型 (Embedding Model):这是最关键的一步。您需要使用一个合适的机器学习模型(如Hugging Face的
embed-english-v3、OpenAI的text-embedding-ada-002或其他预训练的文本/图像嵌入模型)将您的非结构化数据转换成高维向量(嵌入)。重要提示:用于生成向量数据库的嵌入模型必须与后续搜索时使用的查询模型保持一致。 - 准备数据:将原始数据和生成的向量组织起来,通常是以JSON格式,其中包含向量字段和任何相关的元数据字段。
2. 配置OpenSearch索引
- 创建索引:在OpenSearch中创建一个索引来存储您的向量和相关元数据。
- 定义映射 (Mapping):虽然OpenSearch可以自动推断映射,但通常最好提前定义映射,特别是对于
knn_vector字段。您需要指定其维度、所使用的算法(HNSW或IVF)和算法参数(如m和ef_construction)。这有助于优化性能并避免不一致。PUT /my-vector-index { "settings": { "index.knn": true, "knn.algo_param.ef_construction": 256, "knn.algo_param.m": 16 }, "mappings": { "properties": { "my_vector_field": { "type": "knn_vector", "dimension": 768, // 例如,如果您的嵌入是768维 "method": { "name": "hnsw", "space_type": "l2", // 距离度量:l2 (欧氏距离),cosine (余弦相似度) 等 "engine": "nmslib" // 或 faiss, lucene } }, "text_field": { "type": "text" } // ... 其他元数据字段 } } }
3. 数据摄取 (Data Ingestion)
将准备好的数据(包括向量和元数据)批量或实时地摄取到OpenSearch索引中。对于大规模数据,建议使用OpenSearch的批量API(_bulk API)进行批量摄取,以提高效率。
4. 执行向量搜索
- 查询向量生成:当用户提交查询时,使用与数据摄取时相同的嵌入模型将查询文本(或图像等)转换为查询向量。
- k-NN 查询:使用OpenSearch的k-NN查询来查找与查询向量最相似的Top K个文档。
GET /my-vector-index/_search { "query": { "knn": { "my_vector_field": { "vector": [0.1, 0.2, ..., 0.9], // 您的查询向量 "k": 10 // 返回10个最相似的结果 } } }, "_source": ["text_field", "other_metadata_field"] // 返回的字段 } - 混合搜索 (Hybrid Search):结合关键词搜索和向量相似性搜索,以获得更全面的结果。OpenSearch支持混合搜索,可以同时利用词法和语义信息。
OpenSearch向量数据库调优详解:Server端与Client端策略
优化OpenSearch作为向量数据库的性能,需要从服务器端(集群配置)和客户端(查询优化)两个方向进行细致的调整。不正确的调优可能导致查询延迟增加或资源浪费。
服务器端调优措施
服务器端调优聚焦于索引和搜索性能,以减少资源消耗和延迟。
索引性能调优 (Indexing Performance Tuning)
当计划一次性索引大量向量时,以下步骤可以提高索引性能:
- 禁用刷新 (Disable Refresh):在批量索引期间,临时禁用索引的自动刷新,即设置
"refresh_interval": "-1"。这会减少I/O开销,显著加快索引速度。完成后务必手动刷新或重新启用刷新。 - 批量摄取 (Bulk Ingestion):始终使用OpenSearch的批量API来一次性摄取大量文档,而不是逐个文档进行。
- 优化算法参数:
- HNSW:
ef_construction(构建图时邻居列表大小)和m(每个节点的最大连接数)。ef_construction越大,索引构建时间越长,内存使用越多,但召回率越高。m越大,图密度越高,搜索精度可能提高,但索引大小和搜索时间也会增加。 - IVF:
nlist(倒排列表的数量)和nprobe(查询时探测的倒排列表数量)。nlist越大,索引时间越长,但搜索效率可能提高。nprobe越大,召回率越高,但搜索时间也越长。
- HNSW:
- 分片策略 (Shard Strategy):合理规划索引的分片数量。过多的分片会增加管理开销,过少则可能导致单个分片过大,影响性能。每个
knn_vector字段/Lucene段都会创建向量索引。
内存管理与成本优化 (Memory Management and Cost Optimization)
- 量化技术 (Quantization Techniques):OpenSearch Service支持Faiss 16位标量量化(Faiss 16-bit scalar quantization),可以将32位浮点向量转换为16位向量,从而显著减少内存占用和存储成本,同时保持可接受的精度。
- 选择合适的引擎:
- 对于相对较小的数据集(最多几百万个向量),Lucene引擎通常表现出更好的延迟和召回率,并且索引大小最小。
- 对于大规模(数十亿)的向量数据集,NMSLIB和FAISS通常是更好的选择。
集群配置与扩展 (Cluster Configuration and Scaling)
- 节点类型与数量:根据数据量和查询负载选择合适的实例类型(CPU、内存优化)和数据节点数量。
- 专用主节点:对于生产环境,建议使用独立的专用主节点来管理集群状态,避免数据节点过载。
- OpenSearch Serverless:如果使用AWS,OpenSearch Serverless的向量数据库功能提供了可扩展且高性能的相似性搜索能力,无需管理底层基础设施。
OpenSearch 向量数据库调优策略心智图
此心智图清晰地展示了OpenSearch向量数据库在服务器端和客户端的各项调优措施。它有助于从宏观层面理解如何系统地优化性能,包括索引构建、内存管理、集群扩展以及具体的查询优化和监控策略。
客户端/查询端调优措施
客户端调优侧重于查询语句和应用层优化,确保高效交互。
提高查询性能 (Improving Query Performance)
- 减少段数 (Reduce Segment Count):索引合并可以减少段的数量,从而减少搜索时需要检查的文件数量,提高查询性能。可以通过
_forcemergeAPI强制合并段。 - 预热索引 (Warm Up the Index):在首次查询之前,可以对索引进行预热,确保数据和索引结构加载到内存中,减少冷启动延迟。
- 避免读取存储字段 (Avoid Reading Stored Fields):只检索查询所需的字段,特别是大型字段,通过
_source过滤或stored_fields参数来排除不必要的字段,减少网络传输和内存开销。 - 选择正确的 k-NN 算法:
- 近似 k-NN (ANN): 对于大规模数据集,ANN(如HNSW和IVF)是首选,它们通过重新组织索引和降低向量维度来提高搜索效率。
- 精确 k-NN (Exact k-NN): 如果需要在进行k-NN搜索之前应用过滤器(这会大大减少要搜索的向量数量),则应使用精确k-NN方法,例如
score script或painless extensions进行精确的蛮力搜索。
- 过滤器的使用 (Use of Filters):在向量搜索之前应用过滤器(例如,按类别、日期或元数据过滤),可以显著减少向量搜索的范围,提高查询速度和精度。OpenSearch的Lucene引擎在处理小规模数据集时,能够智能地选择预过滤、后过滤或精确k-NN策略。
- 批量查询 (Batching Queries):如果可能,使用
_msearchAPI将多个相似性搜索请求批量发送到OpenSearch,减少网络往返时间。 - 查询参数优化:
k值: 设定合理的k值(要检索的最近数据点数量),过大的k值会增加计算负担。- 距离度量 (Distance Metric): 根据您的数据和应用场景选择合适的距离度量(如L2欧氏距离、余弦相似度、内积)。
- HNSW
ef_search: 对于HNSW算法,ef_search参数(搜索期间的动态邻居列表大小)会影响搜索精度和速度。更大的ef_search值通常会提高召回率但增加搜索时间。
查询语句调优:混合搜索与更高级的查询
OpenSearch能够结合关键词搜索和向量搜索,实现强大的混合搜索(Hybrid Search)。
- 组合查询:使用
bool查询将knn查询与传统的match、term或filter查询结合起来。这允许您在执行向量相似性搜索的同时,对结果进行精确的元数据过滤。GET /my-vector-index/_search { "query": { "bool": { "must": { "knn": { "my_vector_field": { "vector": [0.1, 0.2, ..., 0.9], "k": 10 } } }, "filter": { "term": { "category.keyword": "Electronics" } // 按分类过滤 } } }, "_source": ["text_field", "category"] } - 权重调整 (Weight Adjustment):在进行混合搜索时,可以为关键词匹配和向量相似性匹配的结果分配不同的权重,以平衡两者的重要性,从而更精确地满足用户意图。
监控与持续优化
- 监控指标:密切关注OpenSearch的各项性能指标,包括CPU使用率、内存使用、磁盘I/O、搜索延迟、索引吞吐量等。OpenSearch Dashboards提供了丰富的可视化工具。
- A/B测试:对不同的调优策略进行A/B测试,以确定最适合您特定工作负载的配置。
- 文档参考:定期查阅OpenSearch的官方性能调优文档,获取最新的最佳实践。
OpenSearch向量数据库综合能力评估雷达图
这个雷达图直观地展示了OpenSearch作为向量数据库在不同维度的表现。例如,在“性能效率”方面,它能够通过ANN算法实现快速搜索;在“可扩展性”上,OpenSearch集群能够轻松应对数据量的增长;“易用性”体现在其简洁的API和对knn_vector字段的支持;“功能丰富性”则包含了混合搜索、多模态支持等;而“社区支持”则得益于其开源生态。数据点的值是基于我对OpenSearch能力的综合评估,它们高于轴的起点,表明其在这些方面都有不错的表现。
FAQ: 常见问题解答
什么是向量嵌入?
OpenSearch如何实现高效的向量搜索?
OpenSearch适合哪些类型的AI应用?
在OpenSearch中进行向量搜索时,如何选择合适的距离度量?
space_type参数指定。OpenSearch的向量数据库支持实时数据更新吗?
如何在OpenSearch中实现混合搜索?
match或term查询)在一个bool查询中实现。这允许您同时利用向量相似性和关键词匹配,以获得更全面和精确的搜索结果。OpenSearch Serverless与自托管OpenSearch在向量数据库方面有什么区别?
结论
OpenSearch作为一个多功能、可扩展且开源的搜索与分析引擎,通过其强大的向量数据库能力,已成为构建现代AI应用不可或缺的工具。它不仅能高效存储和检索高维向量,还能无缝集成传统关键词搜索,实现语义理解与精确匹配的强大融合。无论是语义搜索的精准度,推荐系统的个性化,还是RAG架构中LLMs的知识增强,OpenSearch都提供了坚实的技术基础。通过合理的服务器端与客户端调优,特别是针对查询语句的精细化优化,您可以最大限度地发挥OpenSearch的性能,为您的团队和最终用户带来卓越的智能体验。期待您的团队能够充分利用OpenSearch的强大功能,加速AI应用的发展与落地。
推荐阅读
- OpenSearch向量数据库的深度学习模型集成
- OpenSearch向量数据库与LLMs的RAG应用案例
- OpenSearch集群性能监控与诊断最佳实践
- OpenSearch Serverless向量数据库入门指南
参考资料
 aws.amazon.com
 docs.aws.amazon.com
aws.amazon.com
aws.amazon.com