
Fusion Intelligente de Données Temporelles : Étendre vos Prédictions avec Pandas
Un guide complet pour combiner des DataFrames historiques et futurs, en assurant la continuité des prédictions et la complétude des features.
Lorsque vous travaillez avec des séries temporelles et des modèles prédictifs, il est fréquent de devoir combiner des données historiques avec de nouvelles prédictions. Cette opération, bien que courante, nécessite une attention particulière pour garantir l'intégrité des données, la continuité des séries et le remplissage correct des valeurs manquantes. Nous allons explorer en détail comment fusionner un DataFrame df contenant 10 mois de données passées avec un DataFrame future_w_features contenant des prédictions pour une semaine future, en utilisant la puissance de la bibliothèque Pandas en Python.
Points Clés de la Fusion Temporelle
- Alignement des Colonnes Prédictives : La première étape cruciale est de renommer la colonne de prédiction dans vos données futures (par exemple, de
'pred'en'Prédiction XGB') pour qu'elle corresponde exactement au nom de la colonne dans votre DataFrame historique. Cela assure une extension transparente de la série de prédictions. - Concaténation Verticale Stratégique : L'utilisation de
pd.concat()avecaxis=0permet d'empiler les DataFrames, ajoutant les données futures à la suite des données passées. Il est essentiel que les deux DataFrames partagent un index temporel (DatetimeIndex) pour un alignement correct. - Remplissage Ciblé des Features Futures : Après la concaténation, les lignes correspondant à la période future peuvent avoir des valeurs manquantes (
NaN) pour certaines colonnes. La méthodeDataFrame.update()est particulièrement efficace pour combler ces manques en utilisant les valeurs correspondantes defuture_w_features, sans altérer les données historiques.
Préparation et Compréhension des Données
Avant de plonger dans le code, il est essentiel de bien comprendre la structure de vos deux DataFrames :
df(Données Passées) : Ce DataFrame contient vos données historiques sur une période de 10 mois. Il inclut une colonne cible que vous souhaitez étendre, nommée'Prédiction XGB', ainsi que d'autres features. Son index doit être unDatetimeIndex.future_w_features(Données Futures) : Ce DataFrame contient les prédictions pour une semaine future (par exemple, du'2023-10-31 23:59:31'au'2023-11-07 23:59:00'à une fréquence d'une minute). La prédiction se trouve dans une colonne (par exemple,'pred') et d'autres features futures y sont également présentes. Son index est également unDatetimeIndexcouvrant cette période future.
L'objectif est de créer un unique DataFrame où la colonne 'Prédiction XGB' est continue, passant des valeurs historiques de df aux valeurs de future_w_features['pred']. De plus, pour les autres colonnes, les valeurs manquantes dans la section future du DataFrame combiné devront être remplies avec les données de future_w_features.
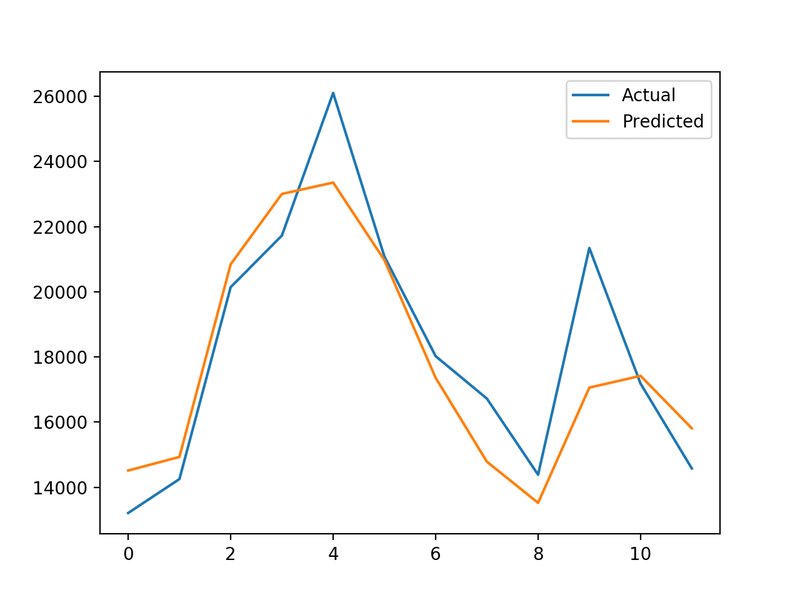
Illustration typique de la visualisation de prédictions par rapport aux valeurs réelles, conceptuellement similaire à l'extension de séries temporelles.
Processus Détaillé de Combinaison des DataFrames
Nous allons suivre une approche méthodique en plusieurs étapes pour réaliser cette fusion.
Étape 1 : Assurer la Cohérence des Index et Renommer la Colonne de Prédiction
Il est primordial que les deux DataFrames utilisent un index de type DatetimeIndex. Pandas gère cela nativement si les dates sont correctement formatées. Ensuite, renommez la colonne contenant les prédictions futures pour qu'elle corresponde à celle du DataFrame historique.
# Assurez-vous que les index sont bien de type DatetimeIndex (généralement déjà le cas si créés avec pd.date_range)
# df.index = pd.to_datetime(df.index)
# future_w_features.index = pd.to_datetime(future_w_features.index)

# Renommer la colonne 'pred' dans future_w_features pour correspondre à 'Prédiction XGB'
future_w_features_renamed = future_w_features.rename(columns={'pred': 'Prédiction XGB'})
Ce renommage est essentiel pour que pd.concat() puisse aligner et étendre correctement la colonne 'Prédiction XGB'.
Étape 2 : Concaténer les DataFrames
Utilisez pd.concat() pour empiler les DataFrames. L'argument axis=0 indique une concaténation le long des lignes (verticale). Par défaut, join='outer' est utilisé, ce qui conserve toutes les colonnes des deux DataFrames, remplissant les valeurs manquantes avec NaN là où une colonne n'existe pas dans l'un des DataFrames pour une période donnée.
df_combined = pd.concat([df, future_w_features_renamed], axis=0)
À ce stade, df_combined contient toutes les lignes de df suivies de toutes les lignes de future_w_features_renamed. La colonne 'Prédiction XGB' est maintenant étendue. Cependant, les autres colonnes issues de df auront des NaN pour la période future, et les nouvelles colonnes issues uniquement de future_w_features_renamed auront des NaN pour la période passée.
Étape 3 : Remplir les Valeurs Manquantes pour les Features Futures
Conformément à votre demande, "Pour les autres colonnes, si des valeurs manquent dans la partie future, les remplir avec celles de future_w_features". La méthode DataFrame.update() est idéale pour cela. Elle modifie df_combined sur place (ou sur une copie) en utilisant les valeurs de future_w_features_renamed pour remplir les NaN ou écraser les valeurs existantes, là où les index et les colonnes correspondent.
# Créez une copie si vous ne voulez pas modifier df_combined directement lors d'expérimentations
# df_combined_updated = df_combined.copy()
# df_combined_updated.update(future_w_features_renamed)

# Sinon, modification sur place (souvent acceptable dans un script linéaire)
df_combined.update(future_w_features_renamed)
Puisque future_w_features_renamed ne contient que des données pour la période future (grâce à son index), update() n'affectera que les lignes de df_combined correspondant à cette période future. Les valeurs de 'Prédiction XGB' pour la période future (déjà issues de future_w_features_renamed via concat) seront simplement réaffirmées. Les autres colonnes communes (par exemple, 'Valeur_A' dans notre exemple de code complet ci-dessous) qui étaient NaN dans df_combined pour la période future seront remplies avec les valeurs de future_w_features_renamed.
Si une colonne existe dans df mais pas dans future_w_features, elle restera NaN dans la période future après l'opération update, ce qui est correct car il n'y a pas de données dans future_w_features pour la remplir.
Étape 4 : Trier l'Index
Enfin, assurez-vous que le DataFrame combiné est trié chronologiquement par son index.
df_combined = df_combined.sort_index()
Votre df_combined est maintenant prêt, avec la colonne 'Prédiction XGB' étendue et les autres features de la période future remplies conformément aux données de future_w_features.
Exemple de Code Complet et Explications
Voici un exemple Python complet qui simule vos DataFrames et applique les étapes décrites :
import pandas as pd
import numpy as np

# --- Simulation de vos données ---
# DataFrame df (données passées)
# Supposons que df couvre les 10 mois précédant '2023-10-31 23:59:31'
# Pour simplifier, créons quelques jours de données passées
past_dates_end = pd.to_datetime('2023-10-31 23:58:31') # Juste avant le début des données futures
past_dates_start = past_dates_end - pd.Timedelta(days=10 * 30) # Approximativement 10 mois
# Utilisons une fréquence plus gérable pour l'exemple
past_dates = pd.date_range(start=past_dates_start, end=past_dates_end, freq='H') # Fréquence horaire pour l'exemple

df_data = {
    'Feature_A': np.random.rand(len(past_dates)) * 10,
    'Feature_B': np.random.randint(50, 80, len(past_dates)),
    'Prédiction XGB': np.random.rand(len(past_dates)) * 100  # Données de prédiction passées/réelles
}
df = pd.DataFrame(df_data, index=past_dates)
df.index.name = 'Timestamp'

# DataFrame future_w_features (données futures)
future_dates_index = pd.date_range('2023-10-31 23:59:31', '2023-11-07 23:59:00', freq='1min')
# Pour l'exemple, limitons le nombre de lignes futures pour que ce soit plus rapide
# Dans votre cas réel, vous utiliserez l'index complet.
# future_dates_index = future_dates_index[:5000] # Décommentez pour un sous-ensemble plus petit si nécessaire

future_data = {
    'Feature_A': np.random.rand(len(future_dates_index)) * 12, # Feature_A existe aussi dans df
    'Feature_C': np.random.uniform(1, 5, len(future_dates_index)), # Nouvelle feature pour le futur
    'pred': np.random.rand(len(future_dates_index)) * 110  # Prédictions futures
}
future_w_features = pd.DataFrame(future_data, index=future_dates_index)
future_w_features.index.name = 'Timestamp'

print("--- Informations Initiales ---")
print(f"df initial (dernières lignes):\\n{df.tail(3)}\\n")
print(f"future_w_features initial (premières lignes):\\n{future_w_features.head(3)}\\n")

# --- Étape 1: Renommer la colonne de prédiction future ---
future_w_features_renamed = future_w_features.rename(columns={'pred': 'Prédiction XGB'})
print(f"future_w_features après renommage (premières lignes):\\n{future_w_features_renamed.head(3)}\\n")

# --- Étape 2: Concaténer les DataFrames ---
df_combined = pd.concat([df, future_w_features_renamed], axis=0)
print(f"df_combined après concat (autour de la jonction):")
# Affichage autour du point de jonction
jonction_point = future_dates_index.min()
print(df_combined.loc[jonction_point - pd.Timedelta(minutes=2) : jonction_point + pd.Timedelta(minutes=2)])
print("\\n")

# --- Étape 3: Remplir les valeurs manquantes dans les colonnes pour la période future ---
df_combined.update(future_w_features_renamed)
print(f"df_combined après update (autour de la jonction):")
print(df_combined.loc[jonction_point - pd.Timedelta(minutes=2) : jonction_point + pd.Timedelta(minutes=2)])
print("\\n")

# --- Étape 4: Trier par index pour assurer l'ordre chronologique ---
df_combined = df_combined.sort_index()

print("--- DataFrame Final Combiné (df_combined) ---")
print(f"Premières lignes de df_combined:\\n{df_combined.head(3)}\\n")
print(f"Lignes de df_combined autour de la jonction :")
print(df_combined.loc[jonction_point - pd.Timedelta(minutes=2) : jonction_point + pd.Timedelta(minutes=2)])
print("\\n")
print(f"Dernières lignes de df_combined:\\n{df_combined.tail(3)}\\n")

print("--- Vérification des Colonnes ---")
print(f"Informations sur df_combined:\\n")
df_combined.info()
print("\\nNombre de NaN par colonne dans df_combined:")
print(df_combined.isnull().sum())
Dans cet exemple :
Feature_Aest présente dansdfetfuture_w_features. Dansdf_combined, elle sera continue, avec les valeurs dedfpour le passé et celles defuture_w_features(viaupdate) pour le futur.Feature_Best présente uniquement dansdf. Elle aura des valeurs pour le passé et desNaNpour le futur dansdf_combined.Feature_Cest présente uniquement dansfuture_w_features. Elle aura desNaNpour le passé et ses valeurs pour le futur dansdf_combined.Prédiction XGBsera continue, utilisant les valeurs dedfpour le passé et celles defuture_w_features_renamed['Prédiction XGB']pour le futur.
Visualisation Conceptuelle des Caractéristiques des Données
Pour mieux comprendre l'impact de ces opérations, un diagramme radar peut illustrer conceptuellement comment les caractéristiques des DataFrames évoluent. Ce graphique est une représentation qualitative.
Ce graphique illustre que le df_combined final vise à maximiser la continuité des prédictions, la complétude des features futures et l'intégrité des données historiques, tout en augmentant naturellement la taille et potentiellement la complexité structurelle.
Résumé des Étapes Clés et Fonctions Pandas
Le tableau suivant synthétise les opérations fondamentales de ce processus :
| Étape | Description | Fonction Pandas Principale | Objectif |
|---|---|---|---|
| 1. Préparation des Index | S'assurer que les deux DataFrames utilisent un index DatetimeIndex. (Souvent implicite si les dates sont bien gérées à la création). |
pd.to_datetime(), pd.date_range() |
Cohérence temporelle pour l'alignement. |
| 2. Alignement des Colonnes | Renommer la colonne 'pred' de future_w_features en 'Prédiction XGB'. |
DataFrame.rename() |
Permettre l'extension directe de la colonne de prédiction lors de la concaténation. |
| 3. Concaténation Verticale | Combiner df et la version renommée de future_w_features le long de l'axe des lignes (axis=0). |
pd.concat() |
Créer un DataFrame unique contenant à la fois les données passées et futures. |
| 4. Remplissage des Features Futures | Mettre à jour le DataFrame combiné avec les valeurs des features de future_w_features (renommé) pour la période future, comblant les NaN. |
DataFrame.update() |
Compléter les informations manquantes pour les features dans la période future en utilisant les données disponibles. |
| 5. Tri Chronologique | Trier le DataFrame combiné final par son index temporel. | DataFrame.sort_index() |
Assurer l'ordre correct et la lisibilité des données temporelles. |
Schéma du Processus de Fusion
La carte mentale ci-dessous visualise le flux de travail pour étendre votre DataFrame de séries temporelles :
Cette carte mentale illustre les étapes clés, de la préparation des données sources à l'obtention du DataFrame final combiné, mettant en évidence les fonctions Pandas utilisées et les transformations effectuées.
Vidéo expliquant l'utilisation de pandas.concat() pour combiner des DataFrames, un concept clé dans notre processus.
La vidéo ci-dessus (en anglais) offre une explication visuelle de la fonction pandas.concat(), qui est au cœur de la fusion de vos données temporelles. Bien qu'elle puisse couvrir des aspects plus larges de la concaténation, les principes de combinaison de DataFrames, de gestion des axes et des types de jointure sont fondamentaux pour comprendre l'opération que nous avons effectuée.
Foire Aux Questions (FAQ)
Que se passe-t-il si future_w_features contient des colonnes qui n'existent pas dans df ?
Lorsque vous utilisez pd.concat() avec le paramètre par défaut join='outer', ces nouvelles colonnes seront ajoutées au DataFrame combiné. Elles contiendront des valeurs NaN (Not a Number) pour toute la période couverte par le DataFrame df (c'est-à-dire la période passée), car df ne possédait pas ces colonnes. Pour la période future, elles auront les valeurs fournies par future_w_features.
Et si df a des colonnes (autres que 'Prédiction XGB') non présentes dans future_w_features ?
Ces colonnes conserveront leurs valeurs historiques issues de df pour la période passée. Après la concaténation, pour la période future (celle couverte par future_w_features), ces colonnes contiendront des valeurs NaN. L'opération df_combined.update(future_w_features_renamed) ne modifiera pas ces NaN, car future_w_features_renamed ne contient pas de données pour ces colonnes spécifiques. Elles resteront donc NaN pour la période future, ce qui est logique puisqu'il n'y a pas de "features futures" fournies pour elles.
La méthode update() modifie-t-elle les données historiques de df_combined ?
Non, pas dans ce contexte. La méthode DataFrame.update() met à jour le DataFrame appelant (ici, df_combined) en utilisant les valeurs non-NaN du DataFrame passé en argument (ici, future_w_features_renamed), en s'alignant sur l'index et les noms de colonnes. Étant donné que future_w_features_renamed ne contient des données que pour la période future (son index ne couvre que les dates futures), seules les lignes de df_combined correspondant à cette période future seront potentiellement affectées par update(). Les données historiques (celles dont l'index correspond à la période de df) ne seront pas modifiées par cette opération spécifique.
L'ordre des opérations (renommer, concat, update, sort) est-il important ?
Oui, l'ordre est crucial :
- Renommer : Vous devez d'abord renommer la colonne de prédiction dans
future_w_featurespour qu'elle corresponde à celle dedf. Si vous concaténez avant de renommer, vous obtiendrez deux colonnes de prédiction distinctes. - Concaténer : C'est l'étape qui assemble physiquement les deux ensembles de données.
- Update : Cette opération doit venir après la concaténation pour remplir les
NaNcréés dans la partie future pour les colonnes de features. - Sort_index : Bien que
concatpuisse préserver l'ordre si les index sont déjà triés et non chevauchants, il est toujours bon de trier explicitement à la fin pour garantir un ordre chronologique strict, surtout si les fréquences ou les alignements d'index ne sont pas parfaits.
Changer cet ordre pourrait entraîner des résultats incorrects ou des erreurs.
Pour Approfondir
Si vous souhaitez explorer davantage des sujets connexes, voici quelques pistes de recherche :
- Comment gérer les fuseaux horaires lors de la combinaison de séries temporelles avec pandas ?
- Quelles sont les meilleures pratiques pour valider la qualité des données après une fusion de DataFrames en pandas ?
- Comment interpoler des valeurs manquantes dans des séries temporelles en utilisant pandas ?
- Comment visualiser efficacement des séries temporelles combinées pour identifier des ruptures ou des anomalies ?
Références
Pour plus d'informations sur les fonctions Pandas utilisées, consultez la documentation officielle :
Last updated May 10, 2025