
ไขความลับโมเดลข้อมูลนับ: Poisson, Zero-Inflation, และ Negative Binomial แตกต่างกันอย่างไร?
เจาะลึกความเหมือน ความต่าง และแนวทางการเลือกใช้โมเดลทางสถิติยอดนิยมสำหรับข้อมูลประเภทจำนวนนับ เพื่อการวิเคราะห์ที่แม่นยำยิ่งขึ้น
ในการวิเคราะห์ข้อมูลเชิงปริมาณ โดยเฉพาะข้อมูลที่เป็น "จำนวนนับ" (Count Data) เช่น จำนวนครั้งที่เกิดเหตุการณ์, จำนวนลูกค้า, หรือจำนวนข้อบกพร่องของผลิตภัณฑ์ นักสถิติและนักวิทยาศาสตร์ข้อมูลมักเลือกใช้โมเดลเฉพาะทางเพื่อให้เข้าใจ پรากฏการณ์ที่ซ่อนอยู่เบื้องหลังตัวเลขเหล่านี้ โมเดลที่ได้รับความนิยมสูงสามประเภท ได้แก่ Poisson Regression, Negative Binomial Regression, และ Zero-Inflated Models ซึ่งแต่ละโมเดลก็มีลักษณะเฉพาะและเงื่อนไขการใช้งานที่แตกต่างกันไป การทำความเข้าใจโมเดลเหล่านี้จะช่วยให้คุณเลือกเครื่องมือที่เหมาะสมที่สุดสำหรับชุดข้อมูลของคุณ
ประเด็นสำคัญที่คุณจะได้รับ
- Poisson Regression: เป็นรากฐานสำหรับการวิเคราะห์ข้อมูลนับ โดยมีข้อสมมติสำคัญว่าค่าเฉลี่ยและความแปรปรวนของข้อมูลเท่ากัน เหมาะสำหรับข้อมูลที่ไม่ซับซ้อนมากนัก
- Negative Binomial Regression: พัฒนาขึ้นเพื่อจัดการกับข้อจำกัดของ Poisson โดยเฉพาะปัญหา "Overdispersion" หรือภาวะที่ความแปรปรวนของข้อมูลสูงกว่าค่าเฉลี่ย ทำให้มีความยืดหยุ่นมากกว่า
- Zero-Inflated Models: ออกแบบมาเพื่อข้อมูลนับที่มี "จำนวนศูนย์" มากผิดปกติ (Excess Zeros) ซึ่งอาจเกิดจากสองกระบวนการที่แตกต่างกัน ทำให้สามารถอธิบายพฤติกรรมของข้อมูลที่มีศูนย์จำนวนมากได้อย่างแม่นยำ
ทำความรู้จักกับแต่ละโมเดล
1. Poisson Regression: แบบจำลองพื้นฐานสำหรับข้อมูลนับ
Poisson Regression เป็นจุดเริ่มต้นที่สำคัญในการวิเคราะห์ข้อมูลนับ โดยตั้งอยู่บนพื้นฐานของการแจกแจงแบบปัวซง (Poisson Distribution) ซึ่งมีลักษณะสำคัญคือ ค่าเฉลี่ย (mean) และค่าความแปรปรวน (variance) ของข้อมูลมีค่าเท่ากัน หรือที่เรียกว่า "Equidispersion" ความสัมพันธ์ระหว่างค่าคาดหวัง (expected count, \(\lambda\)) และตัวแปรอธิบาย (predictors, \(X\)) มักจะแสดงผ่านฟังก์ชันเชื่อมโยงแบบล็อก (log link function):
\[ \log(\lambda_i) = \beta_0 + \beta_1 X_{1i} + \dots + \beta_p X_{pi} \]หรือเขียนอีกแบบได้ว่า:
\[ \lambda_i = e^{(\beta_0 + \beta_1 X_{1i} + \dots + \beta_p X_{pi})} \]โดยที่ \(\lambda_i\) คือค่าเฉลี่ยของจำนวนนับสำหรับหน่วยสังเกตที่ \(i\), และ \(\beta\) คือค่าสัมประสิทธิ์ของตัวแปรอธิบาย
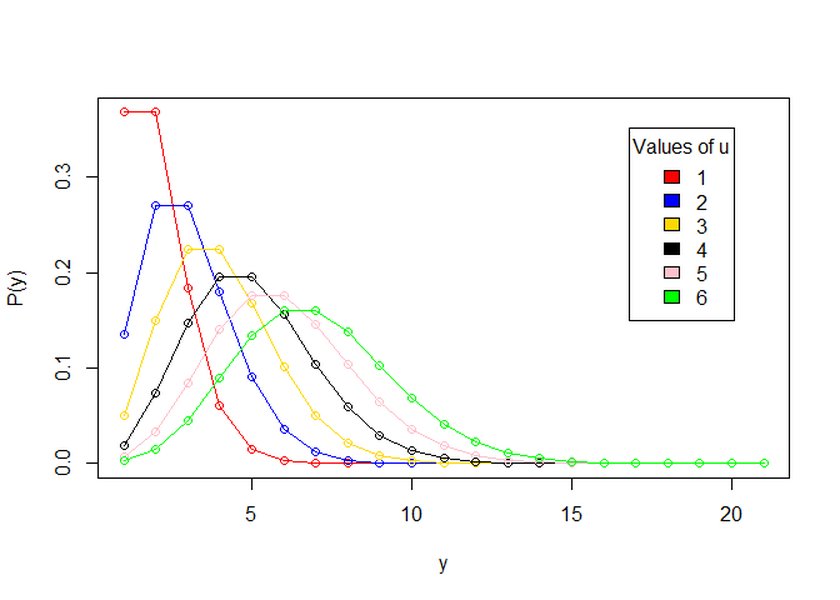
ภาพแสดงตัวอย่างการแจกแจงแบบปัวซงสำหรับค่า \(\lambda\) ต่างๆ
เงื่อนไขการใช้งาน:
- ข้อมูลเป็นจำนวนนับ (ค่าจำนวนเต็มไม่ติดลบ: 0, 1, 2, ...)
- ค่าเฉลี่ยของข้อมูลใกล้เคียงกับค่าความแปรปรวน (Equidispersion)
- เหตุการณ์ที่นับเกิดขึ้นอย่างอิสระต่อกัน
ข้อจำกัด:
- ไม่เหมาะสมหากข้อมูลมีภาวะ "Overdispersion" (ความแปรปรวนสูงกว่าค่าเฉลี่ยมาก) หรือ "Underdispersion" (ความแปรปรวนต่ำกว่าค่าเฉลี่ยมาก) การใช้ Poisson Regression ในกรณีเหล่านี้อาจทำให้ค่า Standard Errors ของสัมประสิทธิ์คลาดเคลื่อน และการอนุมานทางสถิติไม่ถูกต้อง
- ไม่สามารถจัดการกับข้อมูลที่มีจำนวนค่าศูนย์มากเกินไป (Excess Zeros) ได้ดีนัก
2. Negative Binomial Regression: ทางออกสำหรับปัญหา Overdispersion
Negative Binomial (NB) Regression เป็นการขยายแนวคิดจาก Poisson Regression เพื่อจัดการกับปัญหา Overdispersion ที่พบบ่อยในข้อมูลนับจริง โมเดล NB มีความยืดหยุ่นมากกว่าเนื่องจากไม่ได้มีข้อจำกัดว่าค่าเฉลี่ยและความแปรปรวนต้องเท่ากัน แต่จะอนุญาตให้ความแปรปรวนมีค่ามากกว่าค่าเฉลี่ยได้ โดยการเพิ่มพารามิเตอร์ที่เรียกว่า "Dispersion Parameter" (\(\alpha\)) เข้ามาในโมเดล ความสัมพันธ์ระหว่างความแปรปรวนและค่าเฉลี่ย (\(\mu\)) ในโมเดล NB สามารถเขียนได้เป็น:
\[ \text{Var}(Y) = \mu + \alpha \mu^2 \]หรือบางครั้งเขียนเป็น \( \text{Var}(Y) = \mu + \mu^2/k \) โดยที่ \(k = 1/\alpha\) คือ dispersion parameter
ถ้าค่า \(\alpha\) (หรือ \(1/k\)) เข้าใกล้ศูนย์ โมเดล Negative Binomial จะมีลักษณะใกล้เคียงกับโมเดล Poisson ซึ่งหมายความว่า Poisson Regression เป็นกรณีพิเศษของ Negative Binomial Regression เมื่อไม่มี Overdispersion (\(\alpha = 0\))
เงื่อนไขการใช้งาน:
- ข้อมูลเป็นจำนวนนับ
- ข้อมูลมีลักษณะ Overdispersion (ค่าความแปรปรวนสูงกว่าค่าเฉลี่ยอย่างมีนัยสำคัญ)
ข้อดี:
- สามารถจัดการกับข้อมูลที่มี Overdispersion ได้ดีกว่า Poisson Regression ทำให้การประมาณค่าสัมประสิทธิ์และ Standard Errors แม่นยำขึ้น
- ยังคงใช้โครงสร้างการเชื่อมโยงแบบ log link คล้ายกับ Poisson
3. Zero-Inflated Models: เมื่อข้อมูลมี "ศูนย์" มากเป็นพิเศษ
Zero-Inflated Models (ZIMs) ถูกออกแบบมาเพื่อวิเคราะห์ข้อมูลนับที่มีจำนวนค่าศูนย์ (Zeros) มากเกินกว่าที่การแจกแจงแบบ Poisson หรือ Negative Binomial มาตรฐานจะอธิบายได้ (Excess Zeros) ปัญหานี้เกิดขึ้นเมื่อค่าศูนย์ในข้อมูลมาจากสองกระบวนการที่แตกต่างกัน:
- Structural Zeros (ศูนย์เชิงโครงสร้าง): เป็นศูนย์ที่เกิดขึ้นอย่างแน่นอน หรือไม่สามารถเกิดค่าอื่นได้ เช่น ในการนับจำนวนปลาในแหล่งน้ำบางแห่งที่ไม่มีปลาอาศัยอยู่เลย จำนวนปลาที่นับได้จะเป็นศูนย์เสมอ
- Sampling Zeros (ศูนย์จากการสุ่ม): เป็นศูนย์ที่เกิดขึ้นโดยบังเอิญตามกระบวนการนับปกติ เช่น ในแหล่งน้ำที่มีปลา แต่ในการสุ่มตัวอย่างอาจไม่พบปลาเลยในบางครั้ง
Zero-Inflated Model ประกอบด้วยสองส่วนที่ทำงานร่วมกัน:
- ส่วน Zero-Inflation (Binary Model): มักใช้ Logistic Regression หรือ Probit Regression เพื่อทำนายความน่าจะเป็นที่หน่วยสังเกตนั้นจะเป็น Structural Zero (เช่น ความน่าจะเป็นที่หน่วยนั้น "ไม่มีทาง" เกิดเหตุการณ์นับ)
- ส่วน Count Model: ใช้ Poisson Regression หรือ Negative Binomial Regression เพื่อทำนายจำนวนนับสำหรับหน่วยสังเกตที่ไม่ใช่ Structural Zero (คือหน่วยที่ "มีโอกาส" เกิดเหตุการณ์นับ แต่ผลอาจเป็นศูนย์หรือมากกว่าศูนย์ก็ได้)
ดังนั้นจึงมีโมเดลย่อยสองประเภทหลักคือ:
- Zero-Inflated Poisson (ZIP) Regression: ใช้ส่วน Count Model เป็น Poisson Regression เหมาะสำหรับข้อมูลที่มี Excess Zeros แต่ส่วนที่ไม่ใช่ Structural Zero นั้นมีลักษณะ Equidispersion
- Zero-Inflated Negative Binomial (ZINB) Regression: ใช้ส่วน Count Model เป็น Negative Binomial Regression เหมาะสำหรับข้อมูลที่มีทั้ง Excess Zeros และ Overdispersion ในส่วนที่ไม่ใช่ Structural Zero
เงื่อนไขการใช้งาน:
- ข้อมูลเป็นจำนวนนับ
- มีสัดส่วนของค่าศูนย์ในข้อมูลสูงมากผิดปกติ ซึ่งไม่สามารถอธิบายได้ด้วย Poisson หรือ Negative Binomial มาตรฐาน
- มีเหตุผลทางทฤษฎีที่เชื่อได้ว่าค่าศูนย์เกิดจากสองกระบวนการที่แตกต่างกัน
ตารางเปรียบเทียบข้อแตกต่างที่สำคัญ
เพื่อให้เห็นภาพรวมของความแตกต่างระหว่างโมเดลทั้งสามประเภทได้ชัดเจนยิ่งขึ้น สามารถสรุปเป็นตารางเปรียบเทียบได้ดังนี้:
| คุณลักษณะ | Poisson Regression | Negative Binomial Regression | Zero-Inflated Models (ZIP/ZINB) |
|---|---|---|---|
| สมมติฐานหลักเกี่ยวกับความแปรปรวน | ค่าเฉลี่ย = ความแปรปรวน (Equidispersion) | ความแปรปรวน > ค่าเฉลี่ย (Overdispersion) โดยมี Dispersion Parameter (\(\alpha\)) | ขึ้นอยู่กับ Count Model ที่ใช้:
|
| การจัดการ Overdispersion | ไม่ได้โดยตรง (อาจให้ผลคลาดเคลื่อน) | ดีเยี่ยม (เป็นจุดแข็งหลักของโมเดล) |
|
| การจัดการ Excess Zeros | ไม่ดี (มักประเมินจำนวนศูนย์ต่ำไป) | ดีกว่า Poisson เล็กน้อย แต่ไม่เฉพาะทางเท่า ZIMs | ดีเยี่ยม (เป็นจุดแข็งหลักของโมเดล เนื่องจากมีส่วน Zero-Inflation โดยเฉพาะ) |
| ความซับซ้อนของโมเดล | ต่ำ | ปานกลาง | สูง (เนื่องจากเป็นโมเดลผสมสองส่วน) |
| สถานการณ์การใช้งานหลัก | ข้อมูลนับพื้นฐานที่ไม่มีปัญหา Overdispersion หรือ Excess Zeros รุนแรง | ข้อมูลนับที่มีปัญหา Overdispersion ชัดเจน | ข้อมูลนับที่มีปัญหา Excess Zeros ชัดเจน (และอาจมี Overdispersion ร่วมด้วยสำหรับ ZINB) |
การเปรียบเทียบโมเดลด้วยภาพ: Radar Chart
เพื่อให้เห็นภาพรวมจุดเด่นและข้อพิจารณาของแต่ละโมเดลในหลายมิติ สามารถแสดงด้วย Radar Chart ดังนี้ กราฟนี้แสดงการประเมินเชิงคุณภาพโดยให้คะแนนจาก 1 (ต่ำสุด) ถึง 10 (สูงสุด) ในแต่ละด้าน:
จาก Radar Chart จะเห็นได้ว่า Poisson Regression มีความง่ายในการใช้งานสูง แต่มีความสามารถในการจัดการ Overdispersion และ Excess Zeros ต่ำ ในขณะที่ Negative Binomial จัดการ Overdispersion ได้ดี Zero-Inflated Poisson (ZIP) จัดการ Excess Zeros ได้ดีเยี่ยม และ Zero-Inflated Negative Binomial (ZINB) มีความสามารถสูงทั้งในการจัดการ Overdispersion และ Excess Zeros แต่ก็มาพร้อมกับความซับซ้อนที่มากขึ้นและความต้องการข้อมูลที่สูงขึ้น
การเปรียบเทียบโมเดลด้วยข้อมูลชุดเดียวกัน
เมื่อต้องการตัดสินใจว่าจะใช้โมเดลใด (Poisson, Negative Binomial, หรือ Zero-Inflated) กับชุดข้อมูลที่มีอยู่ กระบวนการทั่วไปจะเกี่ยวข้องกับการวิเคราะห์ข้อมูลเบื้องต้น การสร้างโมเดลหลายๆ แบบ และการประเมินความเหมาะสมของแต่ละโมเดล
ตัวอย่างสถานการณ์: การวิเคราะห์จำนวนครั้งที่นักเรียนขาดเรียน
สมมติว่าเรามีข้อมูลเกี่ยวกับจำนวนครั้งที่นักเรียนแต่ละคนขาดเรียนในหนึ่งภาคการศึกษา พร้อมด้วยตัวแปรอื่นๆ เช่น ผลการเรียนเฉลี่ย, ระดับชั้น, หรือโครงการพิเศษที่เข้าร่วม ข้อมูลจำนวนครั้งที่ขาดเรียนนี้อาจมีลักษณะดังนี้:
- นักเรียนจำนวนมากไม่เคยขาดเรียนเลย (ค่าเป็น 0) ซึ่งอาจบ่งชี้ถึง Excess Zeros
- ในกลุ่มนักเรียนที่เคยขาดเรียน จำนวนครั้งที่ขาดอาจมีความแตกต่างกันมาก (อาจมี Overdispersion)
ขั้นตอนการเปรียบเทียบโมเดル:
-
การวิเคราะห์ข้อมูลเบื้องต้น (Exploratory Data Analysis):
- คำนวณค่าเฉลี่ยและความแปรปรวนของจำนวนครั้งที่ขาดเรียน หากความแปรปรวนสูงกว่าค่าเฉลี่ยมาก อาจบ่งชี้ถึง Overdispersion
- ตรวจสอบการกระจายตัวของข้อมูล และสัดส่วนของค่าศูนย์ หากมีค่าศูนย์จำนวนมาก อาจพิจารณา Zero-Inflated Models
- สร้างกราฟ เช่น ฮิสโตแกรม เพื่อดูรูปร่างการแจกแจงของข้อมูล
-
การสร้างโมเดล (Model Fitting):
ทำการสร้างโมเดลต่างๆ โดยใช้ตัวแปรอธิบายชุดเดียวกัน:
- Poisson Regression
- Negative Binomial Regression
- Zero-Inflated Poisson (ZIP) Regression
- Zero-Inflated Negative Binomial (ZINB) Regression (ถ้าสงสัยว่ามีทั้ง Excess Zeros และ Overdispersion)
-
การประเมินและเปรียบเทียบโมเดล (Model Evaluation and Comparison):
- Likelihood Ratio Test (LRT): ใช้เปรียบเทียบระหว่างโมเดลที่ซ้อนกัน (nested models) เช่น
- Poisson vs. Negative Binomial: เพื่อทดสอบว่า Dispersion Parameter (\(\alpha\)) ใน NB มีนัยสำคัญหรือไม่ (ถ้ามีนัยสำคัญ แสดงว่า NB เหมาะสมกว่า)
- Poisson vs. ZIP: เพื่อทดสอบว่าส่วน Zero-Inflation มีนัยสำคัญหรือไม่
- Negative Binomial vs. ZINB: เพื่อทดสอบว่าส่วน Zero-Inflation มีนัยสำคัญหรือไม่ เมื่อมี Overdispersion แล้ว
- Akaike Information Criterion (AIC) และ Bayesian Information Criterion (BIC): เป็นเกณฑ์ที่ใช้เปรียบเทียบโมเดลที่ไม่จำเป็นต้องซ้อนกัน โดยโมเดลที่มีค่า AIC หรือ BIC ต่ำกว่าถือว่ามีความเหมาะสมมากกว่า (เมื่อพิจารณาถึงความสามารถในการอธิบายข้อมูลและความซับซ้อนของโมเดล)
- การตรวจสอบ Residuals: พล็อตค่า Residuals (เช่น Pearson residuals, Deviance residuals) เทียบกับค่า Fitted values หรือตัวแปรอธิบาย เพื่อดูว่ามีรูปแบบที่ผิดปกติหรือไม่ และโมเดลสามารถจับลักษณะของข้อมูลได้ดีเพียงใด
- Vuong Test: เป็นการทดสอบที่ใช้เปรียบเทียบโมเดลที่ไม่ซ้อนกัน โดยเฉพาะอย่างยิ่งระหว่าง Zero-Inflated Model กับ Non-Zero-Inflated Model (เช่น ZIP vs. Poisson) เพื่อดูว่าโมเดลใดเหมาะสมกับข้อมูลมากกว่า
- Dispersion Statistic: คำนวณค่าสถิติ Dispersion (เช่น Pearson Chi-squared / degrees of freedom) สำหรับ Poisson Model ถ้าค่านี้มากกว่า 1 มากๆ แสดงว่ามี Overdispersion
- Likelihood Ratio Test (LRT): ใช้เปรียบเทียบระหว่างโมเดลที่ซ้อนกัน (nested models) เช่น
-
การตีความผลลัพธ์:
เลือกโมเดลที่เหมาะสมที่สุดตามเกณฑ์การประเมินต่างๆ และทำการตีความค่าสัมประสิทธิ์ของตัวแปรอธิบายในโมเดルที่เลือก เพื่อทำความเข้าใจว่าปัจจัยต่างๆ ส่งผลต่อจำนวนนับอย่างไร
ตัวอย่างโค้ด R สำหรับการสร้างโมเดล (อย่างง่าย)
ด้านล่างนี้เป็นตัวอย่างโค้ดภาษา R แบบง่ายๆ เพื่อแสดงให้เห็นถึงการสร้างโมเดลทั้งสามประเภท โดยสมมติว่ามีข้อมูลใน data frame ชื่อ student_data โดยมีตัวแปรตามคือ absences (จำนวนครั้งที่ขาดเรียน) และตัวแปรอิสระคือ math_score และ program_type (ปัจจัย):
# ติดตั้งและโหลดแพ็กเกจที่จำเป็น (ถ้ายังไม่ได้ติดตั้ง)
# install.packages("MASS") # สำหรับ Negative Binomial
# install.packages("pscl") # สำหรับ Zero-Inflated Models

library(MASS)
library(pscl)

# สมมติว่ามี data frame ชื่อ student_data
# student_data <- data.frame(
#   absences = c(0, 0, 1, 5, 0, 2, 0, 0, 10, 3, ...),
#   math_score = c(80, 90, 75, 60, 95, 70, 88, 92, 50, 65, ...),
#   program_type = factor(c("A", "B", "A", "C", "B", "A", "A", "B", "C", "A", ...))
# )

# 1. Poisson Regression
poisson_model <- glm(absences ~ math_score + program_type,
                     family = poisson,
                     data = student_data)
summary(poisson_model)

# 2. Negative Binomial Regression
negbin_model <- glm.nb(absences ~ math_score + program_type,
                       data = student_data)
summary(negbin_model)

# 3. Zero-Inflated Poisson (ZIP) Regression
zip_model <- zeroinfl(absences ~ math_score + program_type | math_score + program_type,
                      dist = "poisson",
                      data = student_data)
# หมายเหตุ: ส่วนหลัง | คือตัวแปรสำหรับทำนาย Zero-Inflation part (สามารถใช้ตัวแปรชุดเดียวกันหรือต่างกันได้)
# หากต้องการให้ Zero-Inflation part มีแค่ intercept ให้ใช้ | 1
# zip_model_simple_zero <- zeroinfl(absences ~ math_score + program_type | 1,
#                                   dist = "poisson",
#                                   data = student_data)
summary(zip_model)

# 4. Zero-Inflated Negative Binomial (ZINB) Regression (ถ้าต้องการ)
zinb_model <- zeroinfl(absences ~ math_score + program_type | math_score + program_type,
                       dist = "negbin",
                       data = student_data)
summary(zinb_model)

# การเปรียบเทียบโมเดลด้วย AIC
AIC(poisson_model, negbin_model, zip_model, zinb_model)

# การเปรียบเทียบด้วย Likelihood Ratio Test (ตัวอย่าง Poisson vs NB)
# ต้องมั่นใจว่าโมเดลถูก fit ด้วย ML (Maximum Likelihood) ซึ่ง glm และ glm.nb ทำเช่นนั้น
# library(lmtest)
# lrtest(poisson_model, negbin_model)

# Vuong Test (ตัวอย่าง ZIP vs Poisson)
# vuong(zip_model, poisson_model) # อาจต้องตรวจสอบแพ็กเกจที่รองรับฟังก์ชันนี้ล่าสุด
โค้ดข้างต้นเป็นเพียงตัวอย่างเบื้องต้น การวิเคราะห์จริงจะต้องมีการตรวจสอบข้อสมมติฐานของโมเดล การเลือกตัวแปรที่เหมาะสมสำหรับแต่ละส่วนของ Zero-Inflated Model และการตีความผลลัพธ์อย่างระมัดระวัง
แผนผังความคิด: สรุปความสัมพันธ์ของโมเดลข้อมูลนับ
แผนผังความคิด (Mindmap) ด้านล่างนี้ช่วยสรุปความสัมพันธ์และลักษณะเด่นของโมเดล Poisson, Negative Binomial, และ Zero-Inflated Models รวมถึงโมเดลย่อยที่สำคัญ:
แผนผังนี้แสดงให้เห็นว่า Poisson เป็นโมเดลพื้นฐาน Negative Binomial ขยาย Poisson เพื่อจัดการ Overdispersion และ Zero-Inflated Models (ทั้ง ZIP และ ZINB) ถูกพัฒนาขึ้นเพื่อจัดการกับปัญหา Excess Zeros โดย ZINB เป็นโมเดลที่ครอบคลุมที่สุดในแง่ของการจัดการทั้ง Overdispersion และ Excess Zeros พร้อมกัน
วิดีโอประกอบความเข้าใจเพิ่มเติม
วิดีโอนี้จะอธิบายเกี่ยวกับ Poisson Regression และ Negative Binomial Regression รวมถึงแนวคิดเรื่อง Overdispersion และวิธีการเลือกระหว่างสองโมเดลนี้ ซึ่งเป็นพื้นฐานสำคัญในการทำความเข้าใจโมเดลข้อมูลนับ:
Regression with Count Data: Poisson and Negative Binomial - อธิบายความแตกต่างและการเลือกใช้ระหว่าง Poisson และ Negative Binomial Regression รวมถึงปัญหา Overdispersion
การชมวิดีโอนี้จะช่วยให้คุณเห็นภาพการประยุกต์ใช้และข้อควรพิจารณาในการเลือกโมเดลได้ชัดเจนยิ่งขึ้น โดยเฉพาะอย่างยิ่งเมื่อต้องเผชิญกับข้อมูลที่ค่าเฉลี่ยและความแปรปรวนไม่เท่ากัน
คำถามที่พบบ่อย (FAQ)
โมเดล Poisson Regression เหมาะสมที่สุดเมื่อใด?
Poisson Regression เหมาะสมที่สุดเมื่อข้อมูลเป็นจำนวนนับ และมีลักษณะสำคัญคือค่าเฉลี่ย (mean) ของข้อมูลใกล้เคียงกับค่าความแปรปรวน (variance) หรือที่เรียกว่า Equidispersion นอกจากนี้ ข้อมูลไม่ควรมีจำนวนค่าศูนย์มากผิดปกติ (No excess zeros) หากข้อมูลของคุณตรงตามเงื่อนไขเหล่านี้ Poisson Regression จะเป็นโมเดลที่เรียบง่ายและให้ผลการวิเคราะห์ที่น่าเชื่อถือ
จะทราบได้อย่างไรว่าข้อมูลมีปัญหา Overdispersion?
มีหลายวิธีในการตรวจสอบ Overdispersion:
- เปรียบเทียบค่าเฉลี่ยและความแปรปรวน: คำนวณค่าเฉลี่ยและความแปรปรวนของตัวแปรตาม หากความแปรปรวนสูงกว่าค่าเฉลี่ยอย่างเห็นได้ชัด อาจเป็นสัญญาณของ Overdispersion
- Dispersion Statistic: หลังจาก fit Poisson model สามารถคำนวณค่าสถิติ Dispersion (เช่น Pearson Chi-squared statistic หารด้วย degrees of freedom) หากค่านี้มากกว่า 1 มากๆ (เช่น > 1.5 หรือ 2) แสดงว่าอาจมี Overdispersion
- Likelihood Ratio Test: เปรียบเทียบ Poisson model กับ Negative Binomial model หากผลการทดสอบมีนัยสำคัญทางสถิติ (p-value ต่ำ) แสดงว่า Negative Binomial model (ที่รองรับ Overdispersion) เหมาะสมกว่า
- การตรวจสอบ Residuals: พล็อต Residuals ของ Poisson model หากมีการกระจายตัวมากเกินไป อาจบ่งชี้ถึง Overdispersion
ข้อได้เปรียบหลักของโมเดล Zero-Inflated คืออะไร?
ข้อได้เปรียบหลักของ Zero-Inflated Models (ZIP และ ZINB) คือความสามารถในการจัดการกับข้อมูลที่มี "จำนวนศูนย์มากเกินไป" (Excess Zeros) ได้อย่างมีประสิทธิภาพ โมเดลเหล่านี้ทำได้โดยการสันนิษฐานว่าค่าศูนย์เกิดจากสองกระบวนการที่แตกต่างกัน: ส่วนหนึ่งเป็นศูนย์ที่เกิดขึ้นอย่างแน่นอน (Structural Zeros) และอีกส่วนเป็นศูนย์ที่เกิดจากการสุ่มในกระบวนการนับ (Sampling Zeros) ทำให้โมเดลสามารถอธิบายพฤติกรรมของข้อมูลที่มีศูนย์จำนวนมากได้แม่นยำกว่า Poisson หรือ Negative Binomial มาตรฐาน ซึ่งมักจะประเมินจำนวนศูนย์ต่ำเกินไปในสถานการณ์เช่นนี้
โมเดล Negative Binomial สามารถจัดการกับปัญหา Zero-inflation ได้หรือไม่?
โมเดล Negative Binomial (NB) โดยตัวมันเองถูกออกแบบมาเพื่อจัดการกับปัญหา Overdispersion (ความแปรปรวนสูงกว่าค่าเฉลี่ย) เป็นหลัก แม้ว่า NB จะมีความยืดหยุ่นและสามารถรองรับข้อมูลที่มีค่าศูนย์ได้ดีกว่า Poisson ในบางกรณี (โดยเฉพาะเมื่อ Overdispersion เป็นสาเหตุให้มีศูนย์มากขึ้น) แต่มันไม่ได้ถูกออกแบบมาเพื่อจัดการกับปัญหา Zero-inflation ที่เกิดจากกระบวนการสองส่วน (Structural vs. Sampling zeros) โดยตรง หากข้อมูลมีปัญหา Zero-inflation อย่างชัดเจน การใช้ Zero-Inflated Negative Binomial (ZINB) model ซึ่งรวมเอาคุณสมบัติของ NB (จัดการ Overdispersion) และ Zero-inflation model เข้าด้วยกัน จะเป็นทางเลือกที่เหมาะสมกว่า
Zero-Inflated Poisson (ZIP) และ Zero-Inflated Negative Binomial (ZINB) แตกต่างกันอย่างไร?
ความแตกต่างหลักระหว่าง ZIP และ ZINB อยู่ที่ส่วน "Count Model" ที่ใช้สำหรับทำนายจำนวนนับในกรณีที่ไม่ใช่ Structural Zero:
- Zero-Inflated Poisson (ZIP): ใช้ Poisson Regression เป็น Count Model ดังนั้นจึงสมมติว่าส่วน Count ของข้อมูล (หลังจากแยก Structural Zeros ออกไปแล้ว) มีลักษณะ Equidispersion (ค่าเฉลี่ย = ความแปรปรวน) ZIP เหมาะสำหรับข้อมูลที่มี Excess Zeros แต่ไม่มี Overdispersion ในส่วนที่ไม่ใช่ศูนย์
- Zero-Inflated Negative Binomial (ZINB): ใช้ Negative Binomial Regression เป็น Count Model ดังนั้นจึงสามารถจัดการกับ Overdispersion ในส่วน Count ของข้อมูลได้ ZINB เหมาะสำหรับข้อมูลที่มีทั้งปัญหา Excess Zeros และปัญหา Overdispersion ในส่วนที่ไม่ใช่ศูนย์พร้อมกัน
โดยสรุป ZINB มีความยืดหยุ่นมากกว่า ZIP เนื่องจากสามารถจัดการได้ทั้ง Excess Zeros และ Overdispersion แต่ก็มีความซับซ้อนมากกว่าและอาจต้องการข้อมูลจำนวนมากขึ้นในการประมาณค่าพารามิเตอร์
คำค้นหาที่เกี่ยวข้องเพื่อการศึกษาเพิ่มเติม
- วิธีการทดสอบ Overdispersion ในข้อมูลนับมีอะไรบ้าง?
- การเลือกใช้ระหว่างโมเดล ZIP และ ZINB ควรพิจารณาจากอะไร?
- มีโมเดลทางเลือกอื่นใดอีกบ้างสำหรับการวิเคราะห์ข้อมูลนับที่มีลักษณะซับซ้อน?
- Hurdle models แตกต่างจาก Zero-Inflated models อย่างไรในการจัดการข้อมูลศูนย์?
เอกสารอ้างอิง
Last updated May 14, 2025