
ไขความลับโมเดลทางสถิติ: Poisson, ZIP, และ Binomial Regression แตกต่างกันอย่างไร?
เจาะลึกความแตกต่าง หลักการทำงาน และสถานการณ์ที่เหมาะสมในการเลือกใช้แต่ละโมเดลสำหรับการวิเคราะห์ข้อมูลของคุณ
การเลือกแบบจำลองทางสถิติที่ถูกต้องเป็นหัวใจสำคัญของการวิเคราะห์ข้อมูลเพื่อให้ได้ข้อสรุปที่แม่นยำและน่าเชื่อถือ โดยเฉพาะอย่างยิ่งเมื่อต้องจัดการกับข้อมูลประเภทการนับ (count data) หรือข้อมูลสัดส่วน (proportional data) โมเดลที่มักถูกกล่าวถึงและใช้งานบ่อยครั้งคือ Poisson Regression, Zero-Inflated Poisson (ZIP) Regression และ Binomial Regression (ซึ่งในที่นี้จะขออนุมานว่า "BiNomail" ที่ผู้ใช้สอบถามมา หมายถึง Binomial Regression) แม้ว่าโมเดลเหล่านี้จะใช้ในการวิเคราะห์ข้อมูลเชิงปริมาณ แต่ก็มีข้อสมมติฐาน ลักษณะข้อมูลที่เหมาะสม และจุดเด่นที่แตกต่างกันอย่างชัดเจน
ไฮไลท์สำคัญ: ความแตกต่างหลักที่คุณต้องรู้
- Poisson Regression: เป็นรากฐานสำหรับการวิเคราะห์ข้อมูลนับ โดยตั้งสมมติฐานว่าค่าเฉลี่ยและความแปรปรวนของข้อมูลมีค่าเท่ากัน เหมาะสำหรับข้อมูลนับทั่วไปที่ไม่มีปัญหาเรื่องจำนวนศูนย์ที่มากผิดปกติหรือความแปรปรวนเกินควร
- Zero-Inflated Poisson (ZIP) Regression: ออกแบบมาเพื่อจัดการกับข้อมูลนับที่มี "จำนวนศูนย์มากเกินไป" (excess zeros) โดยเฉพาะ โมเดลนี้มองว่าค่าศูนย์เกิดได้จากสองกระบวนการ ทำให้การวิเคราะห์แม่นยำขึ้นเมื่อข้อมูลมีศูนย์จำนวนมาก
- Binomial Regression: มุ่งเน้นไปที่การวิเคราะห์จำนวน "ความสำเร็จ" จากจำนวน "การทดลอง" ทั้งหมดที่กำหนดไว้ หรือวิเคราะห์ข้อมูลที่เป็นสัดส่วนและข้อมูลทวิภาค (binary outcome) ซึ่งแตกต่างจาก Poisson และ ZIP ที่ใช้กับข้อมูลนับแบบปลายเปิด
ทำความรู้จัก Poisson Regression: โมเดลพื้นฐานสำหรับข้อมูลนับ
Poisson Regression เป็นแบบจำลองทางสถิติที่ใช้ในการวิเคราะห์ตัวแปรตามที่เป็นข้อมูลการนับ (count data) ซึ่งหมายถึงข้อมูลที่แสดงจำนวนครั้งของการเกิดเหตุการณ์ใดเหตุการณ์หนึ่งในช่วงเวลาหรือพื้นที่ที่กำหนด เช่น จำนวนลูกค้าที่เข้าร้านต่อวัน จำนวนอุบัติเหตุบนถนนสายหนึ่งต่อเดือน หรือจำนวนข้อบกพร่องในสินค้าที่ผลิตต่อล็อต
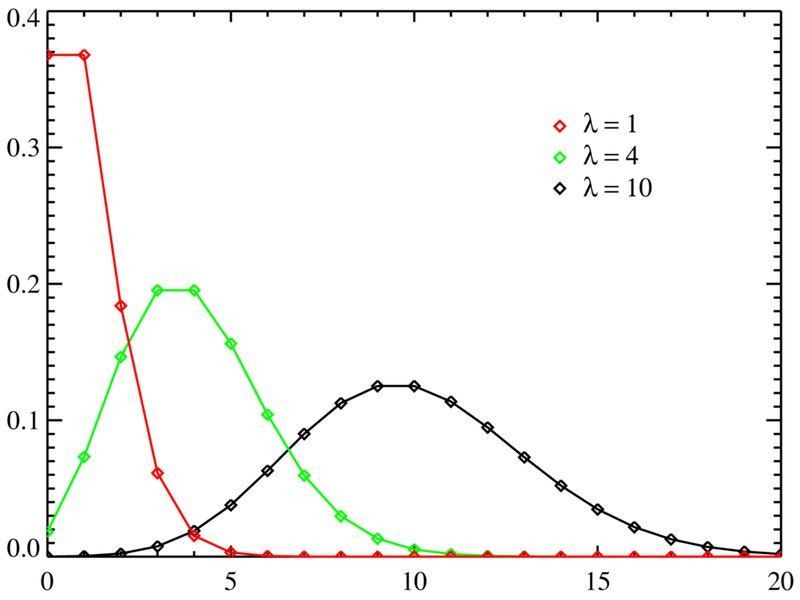
ภาพตัวอย่างการกระจายตัวแบบ Poisson ซึ่งแสดงความน่าจะเป็นของจำนวนเหตุการณ์ที่เกิดขึ้น
หลักการสำคัญของ Poisson Regression
การกระจายตัวแบบ Poisson (Poisson Distribution)
หัวใจของ Poisson Regression คือสมมติฐานที่ว่าตัวแปรตามมีการกระจายตัวแบบ Poisson การกระจายตัวนี้มีลักษณะเฉพาะคือ ค่าเฉลี่ย (mean, λ) ของจำนวนเหตุการณ์จะเท่ากับค่าความแปรปรวน (variance, λ) ของมัน หรือที่เรียกว่า "equidispersion" (E(Y) = Var(Y) = λ) เหตุการณ์ที่นับจะต้องเกิดขึ้นอย่างอิสระต่อกัน และอัตราการเกิดเหตุการณ์คงที่ในช่วงเวลาหรือพื้นที่ที่พิจารณา
Log Link Function
Poisson Regression ใช้ฟังก์ชันเชื่อมโยงแบบล็อก (log link function) เพื่อเชื่อมโยงค่าเฉลี่ยของตัวแปรตาม (λ) กับตัวแปรอิสระ (predictors) ในรูปแบบเชิงเส้น: \[ \ln(\lambda_i) = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + \dots + \beta_p X_{pi} \] ซึ่งหมายความว่า λ_i = \exp(\beta_0 + \beta_1 X_{1i} + \dots + \beta_p X_{pi}) ค่า λ ที่ทำนายได้จะต้องเป็นบวกเสมอ ซึ่งสอดคล้องกับธรรมชาติของข้อมูลนับที่ไม่สามารถมีค่าติดลบได้
ข้อสมมติฐานและข้อจำกัด
- Equidispersion: ข้อจำกัดหลักคือสมมติฐานที่ว่าค่าเฉลี่ยเท่ากับความแปรปรวน ในข้อมูลจริงมักพบปัญหา Overdispersion (ความแปรปรวนมากกว่าค่าเฉลี่ย) ซึ่งทำให้ Poisson Regression ประเมินความคลาดเคลื่อนมาตรฐานต่ำเกินไป และอาจนำไปสู่การสรุปผลที่ผิดพลาด
- Independence of Events: เหตุการณ์ที่นับต้องเป็นอิสระต่อกัน
- No Excess Zeros: โมเดลนี้อาจไม่เหมาะสมหากข้อมูลมีจำนวนค่าศูนย์ (zeros) มากเกินกว่าที่คาดการณ์โดยการกระจายตัวแบบ Poisson
หากพบปัญหา Overdispersion อาจต้องพิจารณาใช้ Negative Binomial Regression ซึ่งยืดหยุ่นกว่าในเรื่องความสัมพันธ์ระหว่างค่าเฉลี่ยและความแปรปรวน
สถานการณ์การใช้งานทั่วไป
- การทำนายจำนวนการโทรเข้าศูนย์บริการลูกค้าต่อชั่วโมง
- การวิเคราะห์จำนวนบทความที่นักวิจัยตีพิมพ์ต่อปี
- การศึกษาจำนวนชนิดพันธุ์ของนกที่พบในพื้นที่ป่าต่างๆ
Zero-Inflated Poisson (ZIP) Regression: เมื่อข้อมูลมี "ศูนย์" มากเกินไป
Zero-Inflated Poisson (ZIP) Regression เป็นส่วนขยายของ Poisson Regression ที่ถูกพัฒนาขึ้นเพื่อจัดการกับข้อมูลนับที่มีจำนวนค่าศูนย์ (zero counts) มากเกินกว่าที่การกระจายตัวแบบ Poisson ทั่วไปจะสามารถอธิบายได้ ปรากฏการณ์นี้เรียกว่า "excess zeros" หรือ "zero inflation"
การรับมือกับปัญหา Excess Zeros
ในหลายสถานการณ์ ค่าศูนย์ในข้อมูลอาจเกิดขึ้นจากสองกระบวนการที่แตกต่างกัน:
- Structural Zeros (Certain Zeros): เป็นค่าศูนย์ที่เกิดขึ้นจากกระบวนการหนึ่งที่ทำให้ผลลัพธ์เป็นศูนย์อย่างแน่นอน เช่น จำนวนบุหรี่ที่สูบต่อวันของผู้ที่ไม่เคยสูบบุหรี่เลย หรือจำนวนครั้งที่ปลาชนิดหนึ่งถูกจับได้ในบริเวณที่ปลาชนิดนั้นไม่อาศัยอยู่ กลุ่มนี้จะให้ค่าเป็นศูนย์เสมอ
- Sampling Zeros (Chance Zeros): เป็นค่าศูนย์ที่เกิดขึ้นโดยบังเอิญจากกระบวนการนับแบบ Poisson แม้ว่าจะมีโอกาสเกิดเหตุการณ์ที่ไม่ใช่ศูนย์ได้ เช่น จำนวนข้อบกพร่องที่พบในผลิตภัณฑ์หนึ่งชิ้นอาจเป็นศูนย์โดยบังเอิญ แม้ว่ากระบวนการผลิตจะมีโอกาสสร้างข้อบกพร่องได้
Poisson Regression แบบมาตรฐานไม่สามารถแยกแยะระหว่างศูนย์ทั้งสองประเภทนี้ได้ ทำให้การประมาณค่าอาจคลาดเคลื่อนเมื่อมี structural zeros จำนวนมาก
โครงสร้างแบบจำลองสองส่วน (Two-Part Model)
ZIP Regression เป็นแบบจำลองแบบผสม (mixture model) ที่ประกอบด้วยสองส่วน:
- ส่วนการพยากรณ์ค่าศูนย์ (Zero-Inflation Part): ส่วนนี้ใช้แบบจำลองโลจิสติก (Logistic Regression) หรือโพรบิต (Probit Regression) เพื่อทำนายความน่าจะเป็น (π) ที่หน่วยสังเกตการณ์นั้นจะอยู่ในกลุ่ม "structural zero" (กลุ่มที่ให้ค่าศูนย์อย่างแน่นอน)
- ส่วนการพยากรณ์การนับ (Count Part): ส่วนนี้ใช้แบบจำลอง Poisson Regression มาตรฐานเพื่อทำนายจำนวนการนับ (λ) สำหรับหน่วยสังเกตการณ์ที่ไม่ได้อยู่ในกลุ่ม "structural zero" (คือกลุ่มที่มีโอกาสให้ค่าเป็นศูนย์หรือค่าบวกตามกระบวนการ Poisson)
ดังนั้น ความน่าจะเป็นที่จะสังเกตเห็นค่าศูนย์ (Y=0) ใน ZIP model คือ:
\[ P(Y_i=0) = \pi_i + (1-\pi_i)e^{-\lambda_i} \] และความน่าจะเป็นที่จะสังเกตเห็นค่าที่ไม่ใช่ศูนย์ (Y=k > 0) คือ: \[ P(Y_i=k) = (1-\pi_i) \frac{e^{-\lambda_i}\lambda_i^k}{k!} \] โดยที่ π_i คือความน่าจะเป็นที่จะเป็น structural zero และ λ_i คือค่าเฉลี่ยของ Poisson count สำหรับกลุ่ม non-structural zero.เมื่อใดควรพิจารณาใช้ ZIP Regression?
- เมื่อข้อมูลนับมีสัดส่วนของค่าศูนย์สูงกว่าที่คาดการณ์จากการกระจายตัวแบบ Poisson อย่างเห็นได้ชัด
- เมื่อมีเหตุผลทางทฤษฎีที่เชื่อได้ว่ามีสองกระบวนการที่ก่อให้เกิดค่าศูนย์ในข้อมูล
- ตัวอย่างเช่น การศึกษาจำนวนครั้งที่ผู้ป่วยไปพบแพทย์ (บางคนอาจไม่เคยป่วยหรือไม่ไปพบแพทย์เลยด้วยเหตุผลอื่น ในขณะที่บางคนอาจไม่ไปเพราะไม่ป่วยในช่วงเวลานั้น) หรือจำนวนการเรียกร้องค่าสินไหมทดแทนจากผู้เอาประกัน (บางคนอาจไม่เคยเรียกร้องเลยเพราะไม่เกิดเหตุการณ์)
หากข้อมูลมีทั้ง excess zeros และ overdispersion (ความแปรปรวนในส่วน count มากกว่าค่าเฉลี่ย) อาจต้องพิจารณาใช้ Zero-Inflated Negative Binomial (ZINB) Regression แทน
Binomial Regression: การวิเคราะห์จำนวนความสำเร็จและสัดส่วน
Binomial Regression แตกต่างจาก Poisson และ ZIP Regression อย่างชัดเจน โดยมุ่งเน้นไปที่การวิเคราะห์ตัวแปรตามที่เป็นผลลัพธ์จากการทดลองแบบทวินาม (binomial trial) หรือข้อมูลที่เป็นสัดส่วน
หัวใจสำคัญ: จำนวนการทดลอง (Trials) และจำนวนความสำเร็จ (Successes)
Binomial Regression ใช้เมื่อตัวแปรตามแสดง "จำนวนความสำเร็จ" (k) จาก "จำนวนการทดลองทั้งหมดที่กำหนดไว้" (n) โดยแต่ละการทดลองมีผลลัพธ์ที่เป็นไปได้เพียงสองอย่าง (เช่น สำเร็จ/ไม่สำเร็จ, ใช่/ไม่ใช่, เกิด/ไม่เกิด) และความน่าจะเป็นของความสำเร็จ (p) คงที่ในแต่ละการทดลอง
ลักษณะสำคัญของข้อมูลที่เหมาะกับ Binomial Regression:
- ตัวแปรตามคือจำนวนความสำเร็จ k โดยที่ \(0 \le k \le n\).
- จำนวนการทดลอง n สำหรับแต่ละหน่วยสังเกตการณ์เป็นที่ทราบและมีค่าจำกัด
- การทดลองแต่ละครั้งเป็นอิสระต่อกัน
เมื่อ n=1 (การทดลองเดียวต่อหน่วยสังเกตการณ์) Binomial Regression จะกลายเป็น Logistic Regression ซึ่งใช้สำหรับวิเคราะห์ตัวแปรตามที่เป็นข้อมูลทวิภาค (binary outcome: 0 หรือ 1)
รูปแบบและความแตกต่างจากโมเดลข้อมูลนับ
Binomial Regression มักใช้ link function เช่น logit, probit, หรือ log-log เพื่อเชื่อมโยงความน่าจะเป็นของความสำเร็จ (p) กับตัวแปรอิสระ ตัวอย่างเช่น Logistic Regression (ซึ่งเป็นกรณีพิเศษของ Binomial Regression) ใช้ logit link function:
\[ \text{logit}(p_i) = \ln\left(\frac{p_i}{1-p_i}\right) = \beta_0 + \beta_1 X_{1i} + \dots + \beta_p X_{pi} \]ข้อแตกต่างสำคัญจาก Poisson และ ZIP:
- ขอบเขตของตัวแปรตาม: Poisson และ ZIP ใช้กับข้อมูลนับที่ไม่มีขอบเขตบน (0, 1, 2, ...) ในขณะที่ Binomial Regression ตัวแปรตาม (จำนวนความสำเร็จ) มีขอบเขตบนคือจำนวนการทดลอง (n)
- ธรรมชาติของข้อมูล: Poisson และ ZIP จัดการกับอัตราการเกิดเหตุการณ์ ในขณะที่ Binomial Regression จัดการกับความน่าจะเป็นหรือสัดส่วนของความสำเร็จ
สถานการณ์การใช้งานทั่วไป
- การวิเคราะห์สัดส่วนของนักเรียนที่สอบผ่านในแต่ละโรงเรียน (k=จำนวนนักเรียนสอบผ่าน, n=จำนวนนักเรียนทั้งหมดในโรงเรียน)
- การศึกษาปัจจัยที่มีผลต่อการรอดชีวิตของเมล็ดพันธุ์ (k=จำนวนเมล็ดที่งอก, n=จำนวนเมล็ดที่เพาะทั้งหมด)
- การทำนายความน่าจะเป็นที่ลูกค้าจะคลิกโฆษณา (binary outcome, n=1)
เปรียบเทียบคุณสมบัติโมเดลด้วยภาพ: ใครเด่นด้านไหน?
เพื่อให้เห็นภาพรวมความสามารถและข้อจำกัดของแต่ละโมเดลชัดเจนยิ่งขึ้น ลองพิจารณาการเปรียบเทียบผ่าน Radar Chart ด้านล่างนี้ ซึ่งประเมินโมเดลทั้งสามในมิติต่างๆ เช่น ความสามารถในการจัดการกับข้อมูลที่มีความแปรปรวนเกิน (Overdispersion), การรับมือกับจำนวนศูนย์ที่มากผิดปกติ (Excess Zeros), ความซับซ้อนของโมเดล, ความยืดหยุ่นของประเภทข้อมูล และความเข้มงวดของข้อสมมติฐานด้านความแปรปรวน คะแนนที่สูงกว่า (แกนยิ่งยื่นออกไปไกล) หมายถึงความสามารถหรือลักษณะที่เด่นชัดกว่าในมิตินั้นๆ
หมายเหตุ: การประเมินนี้เป็นเชิงคุณภาพเพื่อให้เห็นภาพรวม ไม่ได้อิงจากมาตรวัดทางสถิติที่ตายตัว
คู่มือฉบับย่อ: เลือกโมเดลไหนดี?
การตัดสินใจเลือกโมเดลที่เหมาะสมขึ้นอยู่กับลักษณะของข้อมูลและคำถามการวิจัยของคุณ แผนภาพความคิด (Mindmap) ด้านล่างนี้จะช่วยนำทางคุณในการพิจารณาเบื้องต้น:
Mindmap นี้เป็นแนวทางเบื้องต้น ควรพิจารณาการตรวจสอบข้อสมมติฐานของโมเดลเพิ่มเติมเสมอ
สรุปเปรียบเทียบโมเดล: Poisson vs. ZIP vs. Binomial
ตารางต่อไปนี้สรุปความแตกต่างที่สำคัญระหว่าง Poisson Regression, Zero-Inflated Poisson (ZIP) Regression และ Binomial Regression ในประเด็นต่างๆ เพื่อช่วยให้คุณเข้าใจและเลือกใช้ได้อย่างเหมาะสม
| คุณลักษณะ | Poisson Regression | Zero-Inflated Poisson (ZIP) Regression | Binomial Regression |
|---|---|---|---|
| ประเภทตัวแปรตามหลัก | ข้อมูลนับ (จำนวนเต็มไม่ติดลบ, ไม่มีขีดจำกัดบนตามทฤษฎี) | ข้อมูลนับ (ที่มีจำนวนศูนย์มากเกินไป) | จำนวนความสำเร็จจาก n การทดลอง, ข้อมูลสัดส่วน, ข้อมูลทวิภาค (0/1) |
| ข้อสมมติฐานหลักเกี่ยวกับความแปรปรวน | ค่าเฉลี่ย = ความแปรปรวน (Equidispersion) | ส่วน Count: ค่าเฉลี่ย = ความแปรปรวน (แต่จัดการ zero-inflation แยกต่างหาก) | ความแปรปรวนของ p ขึ้นกับ n และ p (Var = np(1-p) สำหรับจำนวนนับ, p(1-p)/n สำหรับสัดส่วน) |
| การจัดการกับ "จำนวนศูนย์" (Zeros) | คาดการณ์จำนวนศูนย์ตามการกระจาย Poisson ปกติ ไม่เหมาะกับ excess zeros | ออกแบบมาเพื่อจัดการกับ excess zeros โดยเฉพาะ (แยก structural zeros และ sampling zeros) | จำนวนศูนย์ (ไม่สำเร็จ) เป็นส่วนหนึ่งของการกระจาย Binomial ไม่ได้ออกแบบมาสำหรับ excess zeros ในข้อมูลนับ |
| การจัดการกับ "Overdispersion" | ไม่สามารถจัดการได้โดยตรง (หากเกิด overdispersion ควรพิจารณา Negative Binomial) | จัดการ overdispersion ที่เกิดจาก excess zeros ได้ แต่ถ้าส่วน count ยัง overdispersed อาจต้องใช้ ZINB | Overdispersion ใน Binomial data (quasi-binomial) สามารถจัดการได้ด้วยการปรับ variance function หรือใช้ generalized estimating equations (GEE) |
| โครงสร้างโมเดล | ส่วนเดียว (Single component) | สองส่วน (Two-part mixture model: logistic/probit สำหรับ zero-inflation + Poisson สำหรับ count) | ส่วนเดียว (Single component) |
| Link Function ที่ใช้บ่อย | Log | Zero-inflation part: Logit/Probit; Count part: Log | Logit (สำหรับ Logistic), Probit, Log (สำหรับ Relative Risk) |
| ตัวอย่างสถานการณ์ใช้งาน | จำนวนอุบัติเหตุต่อวัน, จำนวนข้อร้องเรียนต่อสัปดาห์ (เมื่อไม่มีปัญหา excess zeros/overdispersion) | จำนวนครั้งที่บุคคลดื่มแอลกอฮอล์ (หลายคนไม่ดื่มเลย), จำนวนปลาที่จับได้ในแต่ละจุด (บางจุดไม่มีปลาชนิดนั้น) | สัดส่วนนักศึกษาที่สำเร็จการศึกษา, ความน่าจะเป็นที่ผู้ป่วยจะตอบสนองต่อการรักษา, จำนวนครั้งที่เหรียญออกหัวจากการโยน 10 ครั้ง |
เจาะลึก Zero Inflation: วิดีโออธิบายเพิ่มเติม
เพื่อทำความเข้าใจแนวคิดของ Zero Inflation และการทำงานของ Zero-Inflated Poisson (ZIP) Regression ให้ลึกซึ้งยิ่งขึ้น วิดีโอด้านล่างนี้จะอธิบายถึงปัญหา Zero Inflation ว่าคืออะไร และ ZIP Model เข้ามาช่วยแก้ไขปัญหานี้ได้อย่างไร รวมถึงภาพรวมของโครงสร้างโมเดล ZIP ซึ่งจะช่วยเสริมความเข้าใจจากเนื้อหาที่ได้อ่านมา
วิดีโออธิบายแนวคิด Zero Inflation และ Zero-Inflated Poisson (ZIP) Regression
วิดีโอนี้ ("Zero-inflated Poisson (ZIP) regression" โดยผู้ใช้ YouTube ที่เกี่ยวข้องกับการสอนสถิติ) จะช่วยให้คุณเห็นภาพว่าเมื่อใดที่ข้อมูลของเราอาจมีปัญหา Zero Inflation และทำไม Poisson Regression แบบดั้งเดิมอาจไม่เพียงพอ นอกจากนี้ยังมีการกล่าวถึงองค์ประกอบของ ZIP model ซึ่งสอดคล้องกับที่เราได้อธิบายไปเกี่ยวกับกระบวนการสองส่วนในการสร้างข้อมูล
คำถามที่พบบ่อย (FAQ)
Poisson Regression ไม่เหมาะสมเมื่อใด? +
Poisson Regression อาจไม่เหมาะสมในกรณีต่อไปนี้:
- Overdispersion: เมื่อความแปรปรวนของข้อมูลนับมีค่าสูงกว่าค่าเฉลี่ยอย่างมีนัยสำคัญ ซึ่งละเมิดข้อสมมติฐานหลักของ Poisson (mean=variance) ในกรณีนี้ Negative Binomial Regression อาจเป็นทางเลือกที่ดีกว่า
- Excess Zeros: เมื่อข้อมูลมีจำนวนค่าศูนย์ (0) มากเกินกว่าที่การกระจายตัวแบบ Poisson จะคาดการณ์ได้ ในสถานการณ์นี้ Zero-Inflated Poisson (ZIP) หรือ Zero-Inflated Negative Binomial (ZINB) Regression อาจเหมาะสมกว่า
- Underdispersion: แม้จะพบน้อยกว่า แต่ถ้าความแปรปรวนน้อยกว่าค่าเฉลี่ย Poisson Regression ก็อาจไม่เหมาะสมเช่นกัน อาจต้องพิจารณา Generalized Poisson Regression
- ข้อมูลไม่ใช่ข้อมูลนับ: หากตัวแปรตามเป็นข้อมูลต่อเนื่อง สัดส่วน หรือประเภทอื่นๆ Poisson Regression จะไม่เหมาะสม
จะทราบได้อย่างไรว่าข้อมูลมี "Excess Zeros" สำหรับ ZIP Regression? +
มีหลายวิธีในการตรวจสอบว่าข้อมูลมี "excess zeros":
- การเปรียบเทียบภาพ (Visual Inspection): สร้างฮิสโทแกรมของข้อมูลนับและเปรียบเทียบกับรูปทรงของการกระจาย Poisson ที่มีค่าเฉลี่ยเท่ากับข้อมูลตัวอย่าง หากแท่งของค่าศูนย์สูงกว่าที่คาดการณ์ไว้อย่างชัดเจน อาจบ่งชี้ถึง excess zeros
- การเปรียบเทียบจำนวนศูนย์ที่สังเกตได้กับที่คาดการณ์: Fit Poisson model กับข้อมูล แล้วคำนวณจำนวนศูนย์ที่คาดการณ์จากโมเดลนั้น หากจำนวนศูนย์ที่สังเกตได้ในข้อมูลจริงสูงกว่าจำนวนที่คาดการณ์จาก Poisson model อย่างมาก ก็เป็นสัญญาณของ excess zeros
- การทดสอบทางสถิติ: มีการทดสอบเฉพาะทาง เช่น Vuong test ซึ่งสามารถใช้เปรียบเทียบความเหมาะสมระหว่าง Poisson model กับ ZIP model หรือระหว่าง Negative Binomial model กับ ZINB model ได้
- ความเข้าใจในบริบทของข้อมูล (Contextual Knowledge): พิจารณาว่ามีเหตุผลทางทฤษฎีที่สนับสนุนการมีอยู่ของ "structural zeros" หรือไม่ เช่น ในการศึกษาจำนวนการซื้อสินค้าบางชนิด กลุ่มผู้ที่ไม่สนใจสินค้านั้นเลย (structural zeros) ย่อมมีพฤติกรรมเป็นศูนย์เสมอ
Binomial Regression สามารถใช้กับข้อมูลนับทั่วไปได้หรือไม่? +
โดยทั่วไปแล้ว Binomial Regression ไม่ได้ออกแบบมาสำหรับข้อมูลนับแบบปลายเปิด (open-ended count data) ที่ Poisson หรือ ZIP Regression จัดการ
- Binomial Regression ต้องการ "จำนวนการทดลอง" (n) ที่ชัดเจนและมีขอบเขตสำหรับแต่ละหน่วยสังเกตการณ์ และตัวแปรตามคือ "จำนวนความสำเร็จ" (k) จาก n การทดลองนั้น
- หากข้อมูลนับของคุณไม่มีจำนวน "การทดลอง" สูงสุดที่กำหนดไว้ (เช่น จำนวนลูกค้าต่อวัน ซึ่งตามทฤษฎีแล้วไม่มีขีดจำกัด) Binomial Regression จะไม่เหมาะสม
- อย่างไรก็ตาม หากคุณสามารถแปลงข้อมูลนับให้อยู่ในรูปสัดส่วนได้ (เช่น สัดส่วนของวันที่ร้านมีลูกค้ามากกว่า X คน จากจำนวนวันทั้งหมดที่สังเกต) หรือหากข้อมูลนับนั้นเป็นผลลัพธ์ทวิภาค (เช่น เกิดเหตุการณ์/ไม่เกิดเหตุการณ์ ในช่วงเวลาหนึ่ง) ก็อาจพิจารณาใช้ Logistic Regression ซึ่งเป็นกรณีพิเศษของ Binomial Regression ได้
ดังนั้น คำตอบคือ "ไม่โดยตรง" สำหรับข้อมูลนับทั่วไป แต่ "อาจจะใช่" หากข้อมูลสามารถจัดให้อยู่ในกรอบของจำนวนความสำเร็จจากการทดลองที่กำหนดได้
แนะนำหัวข้อที่น่าสนใจสำหรับการศึกษาเพิ่มเติม
- เราควรพิจารณาใช้ Negative Binomial Regression แทน Poisson Regression ในสถานการณ์ใดบ้าง?
- Zero-Inflated Poisson (ZIP) และ Zero-Inflated Negative Binomial (ZINB) Regression แตกต่างกันอย่างไร และควรเลือกใช้อย่างไร?
- Hurdle Model และ Zero-Inflated Model มีความแตกต่างกันอย่างไรในการจัดการกับข้อมูลนับที่มีจำนวนศูนย์มาก?
- มีวิธีการใดบ้างในการตรวจสอบข้อสมมติฐานของ Poisson Regression และ ZIP Regression เพื่อให้มั่นใจในผลการวิเคราะห์?
แหล่งอ้างอิง
Last updated May 9, 2025