
Passer de la prédiction à la prévision : Comment prédire les 24 prochaines heures pour votre variable cible
Exploitez vos caractéristiques temporelles et vos lags pour anticiper l'avenir avec des modèles de séries temporelles.
Vous avez franchi une étape importante en visualisant les prédictions de votre modèle par rapport aux valeurs réelles existantes. Maintenant, l'ajout de caractéristiques temporelles et de lags (1 à 60) vous positionne idéalement pour la prochaine étape : prévoir les valeurs de votre variable cible pour les 24 prochaines heures, même si vous ne disposez pas encore de ces données réelles. C'est ce qu'on appelle la prévision de séries temporelles.
Ce guide vous expliquera comment utiliser votre configuration actuelle pour générer ces prévisions futures, en abordant les concepts clés, les modèles appropriés et les étapes pratiques.
Points Clés à Retenir
- Exploitation des Lags et Caractéristiques Temporelles : Vos lags (valeurs passées) et caractéristiques temporelles (heure, jour, etc.) sont essentiels pour que les modèles apprennent les dépendances et les cycles, permettant ainsi de prédire les prochaines 24 heures.
- Choix du Modèle : Plusieurs modèles peuvent être utilisés, des classiques ARIMA/ETS aux plus complexes comme les LSTMs (réseaux de neurones récurrents) ou les modèles d'apprentissage automatique (XGBoost, Random Forest), en fonction de la nature de vos données (uni/multivariées, saisonnalité).
- Prévision Multi-Étapes : L'objectif est de générer 24 prédictions séquentielles. Les modèles doivent être configurés pour réaliser cette prévision "multi-shot" ou "autorégressive", en utilisant les dernières données disponibles comme point de départ.
Comprendre la Transition : De la Prédiction In-Sample à la Prévision Out-of-Sample
Initialement, votre code comparait les valeurs prédites aux valeurs cibles déjà existantes dans votre jeu de données. C'est utile pour évaluer la performance du modèle sur le passé (prédiction in-sample).
Maintenant, vous voulez utiliser ce modèle (ou un modèle similaire entraîné sur les mêmes données enrichies) pour générer des valeurs pour des points temporels futurs (les prochaines 24 heures) pour lesquels vous n'avez pas encore d'observations. C'est la prévision out-of-sample.
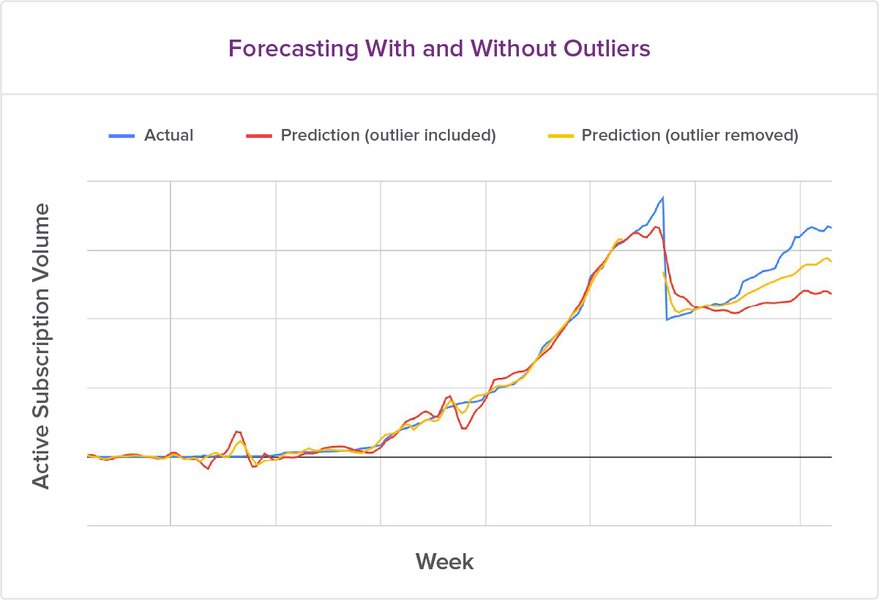
Visualisation d'une prévision temporelle
Un graphique typique montrant les données historiques (bleu) et les valeurs futures prévues (orange), illustrant le passage de l'analyse passée à l'anticipation future.
Pourquoi les Lags et les Caractéristiques Temporelles sont Cruciaux
L'ajout des lags de 1 à 60 signifie que votre modèle peut examiner les 60 dernières valeurs de la variable cible pour prédire la suivante. C'est fondamental pour capturer l'autocorrélation (comment une valeur dépend de ses valeurs passées).
Les caractéristiques temporelles (comme l'heure du jour, le jour de la semaine, le mois) permettent au modèle d'identifier et d'exploiter des motifs récurrents ou saisonniers (par exemple, des pics d'activité chaque jour à la même heure).
En combinant ces deux types d'informations, votre modèle est mieux équipé pour comprendre la dynamique sous-jacente de vos données et extrapoler ces tendances pour les 24 prochaines heures.
Préparation des Données pour la Prévision
Avant de choisir et d'entraîner un modèle pour la prévision, quelques étapes de préparation sont souvent nécessaires :
Stationnarité
De nombreux modèles de séries temporelles (notamment ARIMA) supposent que les données sont stationnaires (la moyenne, la variance et l'autocorrélation ne changent pas avec le temps). Si vos données présentent une tendance ou une saisonnalité marquée, vous devrez peut-être les différencier (calculer la différence entre des observations consécutives ou saisonnières) pour les rendre stationnaires.
Exemple : Différence première \( \Delta y_t = y_t - y_{t-1} \) ou différence saisonnière \( \Delta_{24} y_t = y_t - y_{t-24} \) pour des données horaires avec cycle quotidien.Normalisation/Mise à l'échelle
Pour les modèles basés sur l'apprentissage automatique (comme les LSTMs ou même la régression linéaire avec de nombreuses caractéristiques), il est recommandé de normaliser ou de mettre à l'échelle vos données (par exemple, entre 0 et 1 ou avec une moyenne de 0 et un écart-type de 1). Cela aide l'algorithme à converger plus rapidement et évite que les caractéristiques avec des échelles plus grandes ne dominent le processus d'apprentissage.
Division Entraînement/Validation/Test
Pour évaluer la capacité de prévision de votre modèle, divisez vos données chronologiquement :
- Ensemble d'entraînement : La majorité des données historiques (ex: les premiers 80%).
- Ensemble de validation : Une partie plus récente pour ajuster les hyperparamètres du modèle (ex: les 10% suivants).
- Ensemble de test : La partie la plus récente pour évaluer la performance finale sur des données "inconnues" (ex: les derniers 10%).
Pour simuler la prévision des 24 prochaines heures, vous entraîneriez le modèle sur l'ensemble d'entraînement (et validation), puis feriez une prévision pour la période couverte par l'ensemble de test et compareriez avec les valeurs réelles.
Choisir le Bon Modèle de Prévision
Le choix du modèle dépend de la complexité de vos données, de la présence de saisonnalités multiples, et si vous utilisez uniquement la variable cible (univarié) ou aussi des caractéristiques externes (multivarié - ce qui est votre cas avec les caractéristiques temporelles).
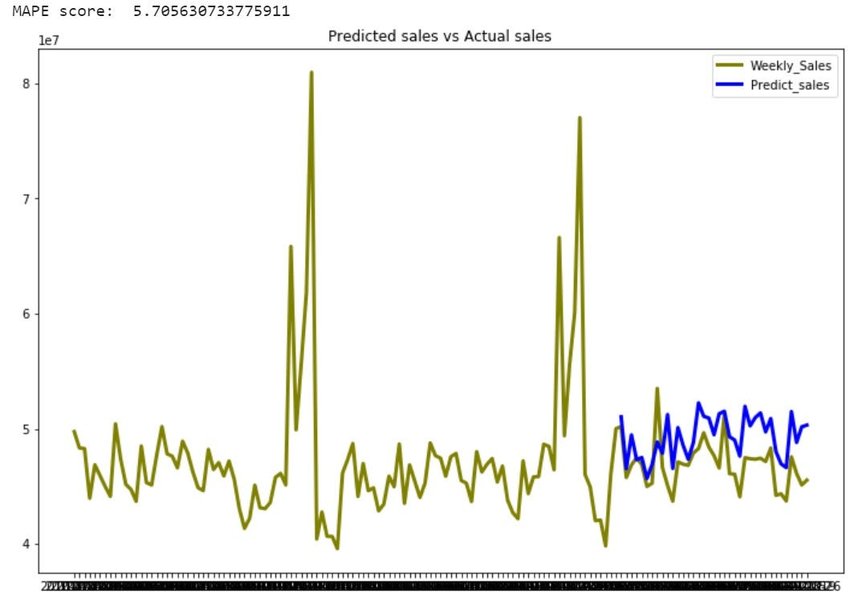
Diversité des approches de prévision
Cette image illustre schématiquement que différentes techniques (statistiques, machine learning) peuvent être appliquées à la prévision de séries temporelles.
Modèles Statistiques Classiques
- ARIMA (Autoregressive Integrated Moving Average) : Bon pour les données univariées stationnaires ou stationnarisées. Modélise la dépendance linéaire par rapport aux lags passés et aux erreurs de prédiction passées.
- SARIMA (Seasonal ARIMA) : Extension d'ARIMA qui intègre explicitement la saisonnalité (par exemple, un cycle de 24 heures). Très pertinent pour votre cas si vous avez des patterns quotidiens.
- ETS (Error, Trend, Seasonality / Exponential Smoothing) : Autre famille de modèles univariés puissants, décomposant la série en erreur, tendance et saisonnalité. Adapté à différentes formes de tendances et de saisonnalités (additives ou multiplicatives).
- VAR (Vector Autoregression) : Pour les séries temporelles multivariées, où plusieurs variables s'influencent mutuellement. Moins pertinent si vos caractéristiques temporelles sont déterministes (heure, jour).
Modèles Basés sur l'Apprentissage Automatique (Machine Learning)
- Régression Linéaire / Modèles Arbres (Random Forest, XGBoost) : Vous pouvez traiter la prévision comme un problème de régression supervisée. La variable cible à l'instant \(t\) est prédite en utilisant les lags ( \(y_{t-1}, ..., y_{t-60}\) ) et les caractéristiques temporelles à l'instant \(t\) comme prédicteurs. Simple à mettre en œuvre mais peut moins bien capturer les dépendances temporelles complexes que les modèles spécifiques.
- LSTM (Long Short-Term Memory) / RNN (Recurrent Neural Networks) : Particulièrement adaptés aux séquences et aux dépendances à long terme. Ils peuvent prendre en entrée une séquence de lags et de caractéristiques temporelles pour prédire une séquence de 24 valeurs futures. C'est une approche très puissante pour les données multivariées et les patterns complexes.
- Modèles Hybrides : Combinaison de modèles statistiques et de machine learning pour tirer parti des forces de chacun.
Comparaison des Modèles
Le tableau suivant résume les caractéristiques clés de certains modèles courants :
| Modèle | Type | Gestion des Lags | Gestion Caractéristiques Temporelles | Saisonnalité | Complexité | Idéal Pour |
|---|---|---|---|---|---|---|
| ARIMA | Statistique (Univarié) | Oui (AR part) | Non (directement) | Non (SARIMA oui) | Moyenne | Séries stationnaires avec dépendances linéaires. |
| SARIMA | Statistique (Univarié) | Oui | Non (directement) | Oui (explicite) | Moyenne-Élevée | Séries avec saisonnalité claire (ex: quotidienne, hebdomadaire). |
| ETS | Statistique (Univarié) | Implicite | Non (directement) | Oui (additive/multiplicative) | Moyenne | Séries avec tendance et/ou saisonnalité claires. |
| Regression (Linéaire, Arbres) | ML (Supervisé) | Oui (comme features) | Oui (comme features) | Via features temporelles | Faible-Moyenne | Approche rapide, bonne baseline, interprétable (linéaire). |
| LSTM/RNN | ML (Deep Learning) | Oui (naturellement via séquences) | Oui (comme input multivarié) | Apprise implicitement | Élevée | Dépendances complexes, non-linéaires, long terme, données multivariées. |
Visualisation Comparative des Modèles
Le graphique radar ci-dessous offre une perspective visuelle sur les forces relatives de différentes approches de modélisation pour la prévision de séries temporelles, en évaluant des aspects comme la gestion de la saisonnalité, la capacité à utiliser des entrées multivariées (comme vos caractéristiques temporelles et lags), la complexité, et les besoins en données.
Ce graphique suggère que les LSTMs excellent dans la gestion des entrées multivariées et des dépendances à long terme, mais sont moins interprétables et plus coûteux en calcul. SARIMA et ETS sont forts sur la saisonnalité et l'interprétabilité pour les données univariées. Les modèles de régression comme XGBoost offrent un bon compromis, gérant bien les caractéristiques multiples avec une complexité modérée.
Générer les Prévisions pour les 24 Prochaines Heures
Une fois votre modèle entraîné sur les données historiques (incluant les lags et caractéristiques temporelles), l'étape suivante est de l'utiliser pour prédire les 24 futures valeurs.
Stratégies de Prévision Multi-Étapes
Il existe plusieurs façons de prédire plusieurs pas de temps dans le futur :- Approche Récursive : Prédire une seule étape (t+1). Utiliser cette prédiction comme une "vraie" valeur pour prédire l'étape suivante (t+2), et ainsi de suite, 24 fois. Simple mais l'erreur peut s'accumuler. Nécessite de pouvoir générer les caractéristiques temporelles pour les 24h futures.
- Approche Directe : Entraîner 24 modèles distincts, chacun prédisant une étape spécifique (un modèle pour t+1, un pour t+2, ..., un pour t+24). Plus complexe à gérer mais évite l'accumulation d'erreur.
- Approche Multiple Output (ou Seq2Seq pour LSTMs) : Entraîner un seul modèle capable de prédire directement les 24 valeurs futures en une seule fois. C'est souvent l'approche privilégiée avec les LSTMs.
Exemple Conceptuel (Python avec modèle type ML)
Supposons que vous ayez un modèle `model` entraîné (par exemple, un XGBoost ou une Régression Linéaire) et une fonction `create_features(timestamp, historical_data)` qui génère les lags et les caractéristiques temporelles pour un `timestamp` donné.
# Importer les bibliothèques nécessaires (exemple)
# import pandas as pd
# from skforecast.ForecasterAutoreg import ForecasterAutoreg # Exemple de bibliothèque

# Supposons 'model' est votre modèle entraîné
# Supposons 'last_known_data' contient les 60 dernières valeurs réelles et leurs caractéristiques
# Supposons 'future_timestamps' est une liste des 24 prochains timestamps horaires

# Fonction pour créer les features pour un timestamp futur
def create_future_features(timestamp, recent_data):
    # Crée les caractéristiques temporelles pour 'timestamp'
    temporal_features = ... # e.g., hour, dayofweek from timestamp
    # Récupère les 60 derniers lags depuis 'recent_data'
    lags = recent_data[-60:]
    # Combine lags et caractéristiques temporelles
    features = combine(lags, temporal_features)
    return features

# Initialiser la liste des prédictions
predictions_24h = []
current_data = last_known_data.copy() # Copie des dernières données connues

# Boucle pour prédire récursivement (exemple)
for ts in future_timestamps:
    # 1. Créer les features pour le prochain pas de temps
    features_next_step = create_future_features(ts, current_data)

    # 2. Faire la prédiction pour ce pas de temps
    # Note: 'features_next_step' doit avoir le bon format (ex: DataFrame ou array 2D)
    # Parfois, il faut remodeler : features_next_step.reshape(1, -1)
    next_prediction = model.predict(features_next_step)

    # 3. Ajouter la prédiction à la liste
    predictions_24h.append(next_prediction[0]) # Récupérer la valeur prédite

    # 4. Mettre à jour 'current_data' en ajoutant la prédiction
    # (pour l'utiliser comme lag pour la prochaine itération)
    current_data = np.append(current_data, next_prediction)[1:] # Garde les 60 dernières valeurs

# 'predictions_24h' contient maintenant les 24 prédictions
print(predictions_24h)
Note : Ceci est un exemple conceptuel simplifié, surtout pour l'approche récursive. L'implémentation exacte dépend du modèle et de la bibliothèque utilisés (par exemple, `statsmodels`, `scikit-learn`, `tensorflow`, `skforecast`). Les bibliothèques comme `skforecast` ou les fonctions intégrées de `statsmodels` gèrent souvent ces stratégies de prévision de manière plus directe.
Visualisation du Processus de Prévision
Le diagramme mental ci-dessous résume les étapes clés du processus de prévision de séries temporelles, depuis la préparation initiale des données jusqu'à l'évaluation finale et au déploiement potentiel.
Séries Temporelles (24h)"] id1["1. Préparation des Données"] id1a["Collecte & Nettoyage"] id1b["Analyse Exploratoire (EDA)
- Visualisation
- Identification Tendance/Saisonnalité"] id1c["Traitement des Valeurs Manquantes"] id1d["Stationnarisation (si nécessaire)
- Différenciation"] id1e["Normalisation / Mise à l'échelle"] id1f["Division Train/Validation/Test
(Chronologique)"] id2["2. Ingénierie des Caractéristiques"] id2a["Création des Lags
(Ex: 1 à 60)"] id2b["Création des Caractéristiques Temporelles
(Heure, Jour, Mois, Fériés...)"] id2c["Autres Caractéristiques Externes (si disponibles)"] id3["3. Sélection & Entraînement du Modèle"] id3a["Choix du Modèle
(ARIMA, ETS, LSTM, XGBoost...)"] id3b["Configuration du Modèle
(Hyperparamètres)"] id3c["Entraînement sur Données Historiques"] id3d["Validation Croisée Temporelle"] id4["4. Génération de la Prévision (24h)"] id4a["Choix Stratégie Multi-Étapes
(Récursive, Directe, Multiple Output)"] id4b["Préparation des Données d'Entrée
(Derniers lags connus, futures caractéristiques temporelles)"] id4c["Application du Modèle Entraîné"] id4d["Obtention des 24 Valeurs Prédites"] id5["5. Évaluation & Visualisation"] id5a["Calcul des Métriques d'Erreur
(MAE, RMSE, MAPE) sur l'ensemble de test"] id5b["Visualisation
- Prédictions vs Réalité (Test set)
- Prévisions futures vs Historique"] id5c["Analyse des Résidus"] id6["6. Affinement & Déploiement"] id6a["Ajustement des Hyperparamètres"] id6b["Test d'autres Modèles"] id6c["Ré-entraînement périodique (Monitoring)"] id6d["Déploiement (si nécessaire)"]
Ce schéma illustre la nature itérative du processus : l'évaluation peut conduire à un retour aux étapes précédentes pour améliorer le modèle ou les caractéristiques.
Évaluation et Interprétation des Prévisions
Une fois les prévisions générées, il est crucial d'évaluer leur fiabilité potentielle.
- Métriques d'Erreur : Calculez des métriques comme l'Erreur Absolue Moyenne (MAE), l'Erreur Quadratique Moyenne (RMSE) ou l'Erreur Absolue Moyenne en Pourcentage (MAPE) sur votre ensemble de test. Cela vous donne une idée de l'ampleur moyenne des erreurs de prévision.
- Visualisation : Tracez les prévisions futures à la suite des données historiques et des prédictions sur l'ensemble de test. Cela permet de vérifier visuellement si les prévisions semblent plausibles et suivent les tendances/saisonnalités observées.
- Horizon de Prévision : Gardez à l'esprit que l'incertitude (et donc l'erreur potentielle) augmente généralement avec l'horizon de prévision. La prévision pour la 24ème heure sera probablement moins précise que celle pour la 1ère heure.
- Intervalles de Confiance : Certains modèles (comme ARIMA, ETS) peuvent fournir des intervalles de confiance autour des prévisions, indiquant une plage probable pour les valeurs futures.
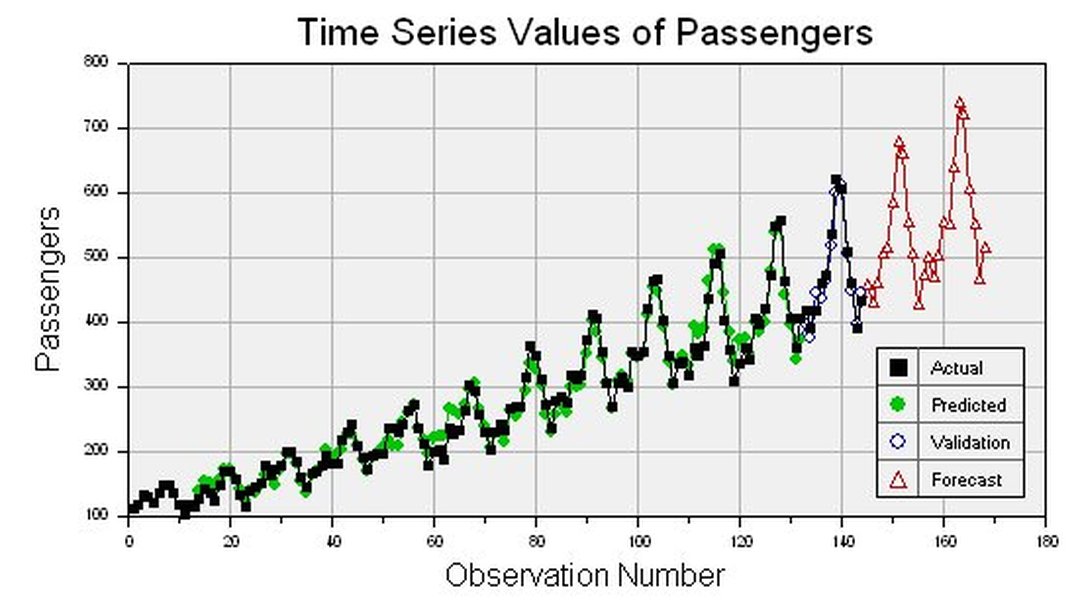
Prévisions avec intervalles de confiance
Visualiser les prévisions (ligne rouge) avec leurs intervalles de confiance (zone ombrée) aide à comprendre l'incertitude associée aux prédictions futures.
Vidéo : Introduction à la Prévision de Séries Temporelles
Pour approfondir les concepts fondamentaux de la prévision de séries temporelles, la vidéo suivante offre une excellente introduction. Elle explique le processus général de prédiction des valeurs futures à partir de données historiques, ce qui est exactement l'objectif que vous poursuivez.
Cette vidéo pose les bases nécessaires pour comprendre pourquoi et comment nous utilisons les données passées pour anticiper l'avenir, un concept clé pour votre projet de prévision des 24 prochaines heures.
FAQ - Questions Fréquentes
Comment choisir entre ARIMA, LSTM et d'autres modèles ?
Le choix dépend de plusieurs facteurs :
- Univarié vs Multivarié : Si vous n'utilisez que les valeurs passées de la variable cible, ARIMA/SARIMA/ETS sont de bons points de départ. Si vous avez des caractéristiques externes importantes (comme vos caractéristiques temporelles), les modèles ML (Régression, XGBoost, LSTM) sont plus adaptés car ils peuvent les intégrer facilement.
- Saisonnalité/Complexité : Pour une saisonnalité simple et des dépendances linéaires, SARIMA peut suffire. Pour des patterns complexes, non linéaires ou des dépendances à long terme, LSTM est souvent plus performant mais nécessite plus de données et de réglages.
- Volume de Données : Les modèles Deep Learning comme LSTM nécessitent généralement de grandes quantités de données pour bien s'entraîner. Les modèles statistiques peuvent parfois performer correctement avec moins de données.
- Interprétabilité : Les modèles statistiques et la régression linéaire sont généralement plus faciles à interpréter que les modèles complexes comme LSTM ou XGBoost.
- Point de Départ : Commencez souvent par des modèles plus simples (ARIMA, Régression Linéaire) comme baseline, puis essayez des modèles plus complexes si nécessaire.
Comment gérer les caractéristiques temporelles pour les 24h futures ?
C'est l'un des avantages des caractéristiques temporelles : elles sont généralement déterministes et connues à l'avance.
Si votre dernière donnée connue est à l'instant `T`, vous pouvez facilement générer les caractéristiques temporelles (heure, jour de la semaine, mois, etc.) pour les instants `T+1`, `T+2`, ..., `T+24`. Ces caractéristiques futures serviront d'entrée à votre modèle pour générer les prévisions.
Par exemple, si `T` est aujourd'hui à 14h00, vous savez que `T+1` sera aujourd'hui à 15h00, `T+2` sera aujourd'hui à 16h00, ..., et `T+10` sera demain à 00h00. Vous pouvez calculer les caractéristiques correspondantes (heure=15, jour=aujourd'hui ; heure=16, jour=aujourd'hui ; heure=0, jour=demain...) et les fournir au modèle.
Quelle quantité de données historiques est nécessaire ?
Il n'y a pas de règle absolue, mais quelques principes généraux s'appliquent :
- Cycles Saisonniers : Idéalement, vous devriez avoir au moins deux cycles saisonniers complets dans vos données d'entraînement. Si votre saisonnalité principale est quotidienne (cycle de 24h), quelques semaines ou mois de données horaires pourraient suffire. Si vous avez aussi une saisonnalité hebdomadaire ou annuelle, il vous faudra respectivement plusieurs mois ou plusieurs années de données pour que le modèle puisse les capturer efficacement.
- Complexité du Modèle : Les modèles plus complexes comme les LSTMs bénéficient généralement de plus de données.
- Stabilité des Patterns : Si les patterns de votre série temporelle sont stables dans le temps, moins de données peuvent être nécessaires. Si les patterns changent fréquemment, vous aurez besoin de données plus récentes et potentiellement plus longues.
Avec des données horaires et des lags jusqu'à 60, avoir plusieurs mois, voire un an ou deux de données, est généralement une bonne base, surtout si des patterns hebdomadaires ou annuels sont présents.
Comment mettre à jour les prévisions avec de nouvelles données ?
La prévision est souvent un processus continu. Lorsque de nouvelles données réelles deviennent disponibles (par exemple, après une heure), vous pouvez :
- Mettre à jour les entrées : Utilisez les données les plus récentes (y compris la nouvelle valeur réelle) pour générer un nouvel ensemble de prévisions pour les 24 prochaines heures.
- Ré-entraîner le modèle : Périodiquement (par exemple, chaque jour ou chaque semaine), ré-entraînez complètement votre modèle en incluant les nouvelles données collectées. Cela permet au modèle de s'adapter à d'éventuels changements dans les patterns de données. La fréquence de ré-entraînement dépend de la volatilité de vos données et des ressources de calcul disponibles.
Ce processus de mise à jour et de ré-entraînement est essentiel pour maintenir la précision des prévisions au fil du temps.
Références
- Time series forecasting - Predicting the next 24 hours - Cross Validated
- Time series forecasting | TensorFlow Core
- Multivariate Time Series Forecasting with LSTMs in Keras - GeeksforGeeks
- Time Series Forecasting Using Past and Future External Data with Darts - Medium
- Time Series Analysis and Forecasting | Methodology - DTREG
- Introduction to Forecasting - Skforecast Docs
Sujets Recommandés Pour Approfondir

Last updated April 12, 2025