
Comment transformer votre série temporelle de puissance en prédictions hebdomadaires logiques avec la Régression Linéaire Multiple ?
Découvrez comment adapter la RLM à vos données univariées pour une prévision sensée, même avec un modèle simple.
Vous disposez d'une longue série chronologique (437 796 mesures jusqu'au 31 octobre 2023) de valeurs de puissance normalisées et vous souhaitez prédire son évolution pour la semaine suivante en utilisant la Régression Linéaire Multiple (RLM). Bien que la RLM soit conçue pour des données multivariées, il est tout à fait possible de l'appliquer à votre série univariée en transformant intelligemment vos données. Ce guide vous explique comment procéder étape par étape avec Python, en utilisant LinearRegression ou SGDRegressor de scikit-learn, pour obtenir les résultats les plus "logiques" possibles, même si la RLM n'est pas intrinsèquement le modèle le plus sophistiqué pour les séries temporelles.
Points Clés pour la Prévision
- Ingénierie des Caractéristiques (Feature Engineering) : La clé est de transformer votre unique série temporelle en un problème multivarié. Cela se fait en créant des variables explicatives pertinentes (features) à partir des données passées, comme les valeurs décalées (lags) et les indicateurs temporels (jour de la semaine, heure, etc.).
- Choix et Entraînement du Modèle : Utilisez
LinearRegressionpour une solution simple et rapide, ouSGDRegressorpour de très grands jeux de données, potentiellement plus rapide mais nécessitant une mise à l'échelle des données. Entraînez le modèle sur une partie historique de vos données. - Prédiction Récursive : Pour prédire une semaine entière (plusieurs pas de temps futurs), vous devrez utiliser une approche récursive : prédire le prochain point, l'ajouter aux données connues, puis prédire le point suivant, et ainsi de suite.
Étape 1 : Préparation des Données et Création des Caractéristiques
Transformer une Série Univariée en Données Multivariées
La Régression Linéaire Multiple modélise une variable cible (la puissance future) comme une combinaison linéaire de plusieurs variables indépendantes (les caractéristiques). Puisque vous n'avez qu'une seule variable initiale (la puissance normalisée), nous devons créer ces variables indépendantes.
Création des Caractéristiques Temporelles
Les caractéristiques les plus courantes et efficaces pour ce type de problème sont :
- Valeurs Décalées (Lags) : Ce sont les valeurs de puissance des instants précédents (t-1, t-2, t-n). Elles sont fondamentales car elles capturent l'autocorrélation de la série (la dépendance de la valeur actuelle par rapport aux valeurs passées). Le nombre de lags (n) à inclure dépend de la périodicité de vos données (horaire, journalière...).
- Caractéristiques Temporelles Cycliques : Pour capturer la saisonnalité (patterns répétitifs), on peut ajouter :
- Le jour de la semaine (0-6)
- L'heure de la journée (0-23, si données horaires)
- Le mois de l'année (1-12)
- Des indicateurs pour les jours fériés ou événements spéciaux (si disponibles).
- Tendance (Trend) : Une variable simple qui augmente avec le temps (par exemple, un compteur de 0 à N-1) peut aider le modèle à capturer une tendance linéaire globale.
- Moyennes Mobiles : La moyenne des valeurs sur une fenêtre glissante passée peut aider à lisser le bruit et capturer la tendance locale.
Exemple de Code Python (avec Pandas)
Supposons que vos données sont dans un DataFrame df avec une colonne date (en index) et puissance_normalisee.
import pandas as pd
import numpy as np

# Supposons que df est votre DataFrame chargé avec index temporel
# Exemple: df = pd.read_csv('vos_donnees.csv', index_col='date', parse_dates=True)

def create_time_series_features(df, target_col, n_lags=24, window_size=7):
    """Crée des caractéristiques temporelles pour la RLM."""
    df_feat = df[[target_col]].copy()

    # 1. Créer les Lags
    for i in range(1, n_lags + 1):
        df_feat[f'lag_{i}'] = df_feat[target_col].shift(i)

    # 2. Créer les Moyennes Mobiles
    df_feat[f'rolling_mean_{window_size}'] = df_feat[target_col].shift(1).rolling(window=window_size).mean()

    # 3. Créer les Caractéristiques Temporelles (adapter selon la fréquence)
    if isinstance(df_feat.index, pd.DatetimeIndex):
        df_feat['hour'] = df_feat.index.hour
        df_feat['dayofweek'] = df_feat.index.dayofweek
        df_feat['month'] = df_feat.index.month
        # Ajouter d'autres caractéristiques si pertinent (année, jour du mois...)

    # 4. Créer la Tendance
    df_feat['trend'] = np.arange(len(df_feat))

    # Supprimer les lignes avec NaN créées par shift/rolling
    df_feat.dropna(inplace=True)

    # Séparer les caractéristiques (X) de la cible (y)
    features = [col for col in df_feat.columns if col != target_col]
    X = df_feat[features]
    y = df_feat[target_col]

    return X, y

# Exemple d'utilisation (ajuster n_lags et window_size)
# Assurez-vous que df contient vos données jusqu'au 31 oct 2023
# n_lags pourrait être 24*7 si données horaires pour capturer une semaine
X, y = create_time_series_features(df, 'puissance_normalisee', n_lags=24, window_size=7)

# Afficher les premières lignes des caractéristiques créées
print("Aperçu des caractéristiques (X):")
print(X.head())
print("\nAperçu de la cible (y):")
print(y.head())
Division des Données (Train/Test)
Pour les séries temporelles, il est crucial de ne pas mélanger le passé et le futur. La division doit être chronologique : entraînez le modèle sur les données les plus anciennes et validez-le sur les données les plus récentes.
# Division chronologique (ex: 80% pour l'entraînement)
split_index = int(len(X) * 0.8)

X_train = X.iloc[:split_index]
y_train = y.iloc[:split_index]
X_test = X.iloc[split_index:] # Utilisé pour évaluer la performance avant la prédiction finale
y_test = y.iloc[split_index:]

print(f"Taille Entraînement : {len(X_train)} échantillons")
print(f"Taille Test : {len(X_test)} échantillons")
Étape 2 : Choix et Entraînement du Modèle
LinearRegression vs SGDRegressor
Vous avez le choix entre deux principaux régresseurs linéaires dans scikit-learn :
LinearRegression: Utilise la méthode des moindres carrés ordinaires (OLS). C'est une solution analytique directe, souvent rapide pour des données de taille modérée et qui tient en mémoire. Elle est simple à utiliser et interpréter (via les coefficients).SGDRegressor: Utilise la descente de gradient stochastique pour trouver les coefficients. C'est une approche itérative qui traite les données par petits lots (ou un échantillon à la fois). Elle est particulièrement adaptée aux très grands jeux de données (comme le vôtre avec ~437k mesures) car elle n'a pas besoin de charger toutes les données en mémoire simultanément. Elle peut être plus rapide queLinearRegressionpour de gros volumes, mais nécessite souvent une mise à l'échelle des caractéristiques (scaling) et peut demander un ajustement des hyperparamètres (taux d'apprentissage, nombre d'itérations).
Mise à l'échelle pour SGDRegressor
La descente de gradient converge beaucoup mieux lorsque les caractéristiques ont des échelles similaires (par exemple, moyenne 0 et écart-type 1). Utilisez StandardScaler de scikit-learn.
from sklearn.preprocessing import StandardScaler

scaler_X = StandardScaler()
# Ajuster le scaler UNIQUEMENT sur les données d'entraînement
X_train_scaled = scaler_X.fit_transform(X_train)
# Transformer les données de test avec le même scaler
X_test_scaled = scaler_X.transform(X_test)

# Note: La cible (y) n'a généralement pas besoin d'être mise à l'échelle pour la RLM,
# mais si vous le faites, n'oubliez pas d'inverser la transformation sur les prédictions.
Entraînement des Modèles
from sklearn.linear_model import LinearRegression, SGDRegressor
from sklearn.metrics import mean_squared_error

# --- Modèle 1: LinearRegression ---
lr_model = LinearRegression()
# Entraîner sur les données non mises à l'échelle (ou mises à l'échelle, ça ne change pas les résultats pour LR)
lr_model.fit(X_train, y_train)

# Évaluation sur l'ensemble de test
y_pred_lr = lr_model.predict(X_test)
mse_lr = mean_squared_error(y_test, y_pred_lr)
print(f"MSE LinearRegression (sur Test): {mse_lr:.6f}")


# --- Modèle 2: SGDRegressor ---
sgd_model = SGDRegressor(max_iter=1000, tol=1e-3, random_state=42, penalty='l2', alpha=0.0001) # Exemple avec régularisation L2 légère
# Entraîner IMPÉRATIVEMENT sur les données mises à l'échelle
sgd_model.fit(X_train_scaled, y_train)

# Évaluation sur l'ensemble de test (mis à l'échelle)
y_pred_sgd = sgd_model.predict(X_test_scaled)
mse_sgd = mean_squared_error(y_test, y_pred_sgd)
print(f"MSE SGDRegressor (sur Test): {mse_sgd:.6f}")

# Choisir le "meilleur" modèle basé sur le MSE (le plus bas est le mieux)
if mse_lr < mse_sgd:
    print("LinearRegression semble plus performant sur le set de test.")
    best_model = lr_model
    use_scaled_data = False # LR n'a pas besoin de scaling pour la prédiction
else:
    print("SGDRegressor semble plus performant sur le set de test.")
    best_model = sgd_model
    use_scaled_data = True # SGD a besoin de données scalées pour la prédiction
Étape 3 : Prédiction pour la Semaine Suivante
L'Approche Récursive
Pour prédire plusieurs pas dans le futur (ici, une semaine complète), nous ne pouvons pas simplement générer les caractéristiques pour toute la semaine et prédire en une fois, car les caractéristiques (notamment les lags) dépendent des valeurs futures que nous ne connaissons pas encore. Il faut donc procéder de manière itérative :
- Prendre les dernières données connues (jusqu'au 31 oct 2023) pour construire les caractéristiques du premier pas de temps futur (1er novembre 2023, première heure/jour).
- Prédire la valeur pour ce premier pas de temps.
- Ajouter cette valeur prédite à notre historique "connu".
- Utiliser ce nouvel historique pour construire les caractéristiques du deuxième pas de temps futur.
- Prédire le deuxième pas, l'ajouter à l'historique, et ainsi de suite pour toute la semaine.
Code Python pour la Prédiction Récursive
# Nombre de pas à prédire (ex: 7 jours * 24 heures/jour = 168 pas si horaire)
n_steps_future = 168 # Adaptez à la fréquence de vos données et à la durée d'une semaine

# Récupérer les dernières données nécessaires pour initialiser les caractéristiques futures
# Il faut les dernières 'n_lags' valeurs de puissance et les infos pour la moyenne mobile
last_known_values = df['puissance_normalisee'].values[-n_lags:]
last_window_values = df['puissance_normalisee'].values[-(window_size + n_lags -1):] # Pour calculer la moyenne mobile initiale

# Historique pour la récursion (commence avec les dernières valeurs connues)
history_values = list(last_known_values)
history_index = df.index[-n_lags:] # Garder trace des dates aussi

# Liste pour stocker les prédictions
future_predictions = []
future_dates = pd.date_range(start=df.index.max() + pd.Timedelta(hours=1), periods=n_steps_future, freq=df.index.freq) # Adapter la fréquence

# Boucle de prédiction récursive
current_full_data_for_features = df.iloc[-(window_size + n_lags -1):].copy() # Pour calculer rolling mean


for i in range(n_steps_future):
    # --- 1. Construire les caractéristiques pour le pas actuel ---
    current_features = {}
    current_date = future_dates[i]

    # Lags: prendre les 'n_lags' dernières valeurs de 'history_values'
    lags = history_values[-n_lags:]
    for j in range(n_lags):
        current_features[f'lag_{j+1}'] = lags[n_lags - 1 - j]

    # Moyenne Mobile: calculer sur les 'window_size' dernières valeurs DANS history_values
    # Note: This might require tracking more history or simplifying the feature
    # Let's use the simplified rolling mean from the last known point as an approximation or recompute based on history
    rolling_mean_val = np.mean(history_values[-window_size:])
    current_features[f'rolling_mean_{window_size}'] = rolling_mean_val

    # Caractéristiques Temporelles
    current_features['hour'] = current_date.hour
    current_features['dayofweek'] = current_date.dayofweek
    current_features['month'] = current_date.month

    # Tendance (continuer la séquence)
    current_features['trend'] = X['trend'].max() + 1 + i

    # Convertir en DataFrame pour la prédiction (1 ligne)
    X_predict_step = pd.DataFrame([current_features])
    # S'assurer que l'ordre des colonnes est le même que pour l'entraînement
    X_predict_step = X_predict_step[X_train.columns]

    # --- 2. Mise à l'échelle si nécessaire (pour SGDRegressor) ---
    if use_scaled_data:
        X_predict_step_scaled = scaler_X.transform(X_predict_step)
        input_for_predict = X_predict_step_scaled
    else:
        input_for_predict = X_predict_step

    # --- 3. Prédire le pas de temps ---
    predicted_value = best_model.predict(input_for_predict)[0]

    # --- 4. Stocker la prédiction et mettre à jour l'historique ---
    future_predictions.append(predicted_value)
    history_values.append(predicted_value) # Ajouter la prédiction pour le prochain tour

# Créer une Série pandas avec les prédictions et les dates futures
predictions_series = pd.Series(future_predictions, index=future_dates)

print("\nPrédictions pour la semaine suivante :")
print(predictions_series.head())
Visualisation et Interprétation
Obtenir des Résultats "Logiques"
Même si la RLM est un modèle "simple" pour les séries temporelles complexes, les résultats peuvent être "logiques" si :
- Les caractéristiques sont pertinentes : Des lags bien choisis et des caractéristiques saisonnières/tendances aident le modèle à capturer les principaux moteurs de la série. Si la puissance dépend fortement de l'heure ou du jour, ces caractéristiques sont cruciales.
- Les relations sont approximativement linéaires : La RLM suppose des relations linéaires. Si les dynamiques sont fortement non-linéaires, le modèle aura du mal. Cependant, sur de courtes périodes ou avec des transformations, elle peut parfois fournir une approximation raisonnable.
- L'horizon de prédiction est court : Les erreurs de prédiction tendent à s'accumuler dans l'approche récursive. Les prédictions pour les premiers jours de la semaine seront probablement plus fiables que celles pour la fin de la semaine.
Le caractère "logique" de vos prédictions dépendra donc fortement de la qualité de l'ingénierie des caractéristiques et de la nature intrinsèque de votre série temporelle de puissance.
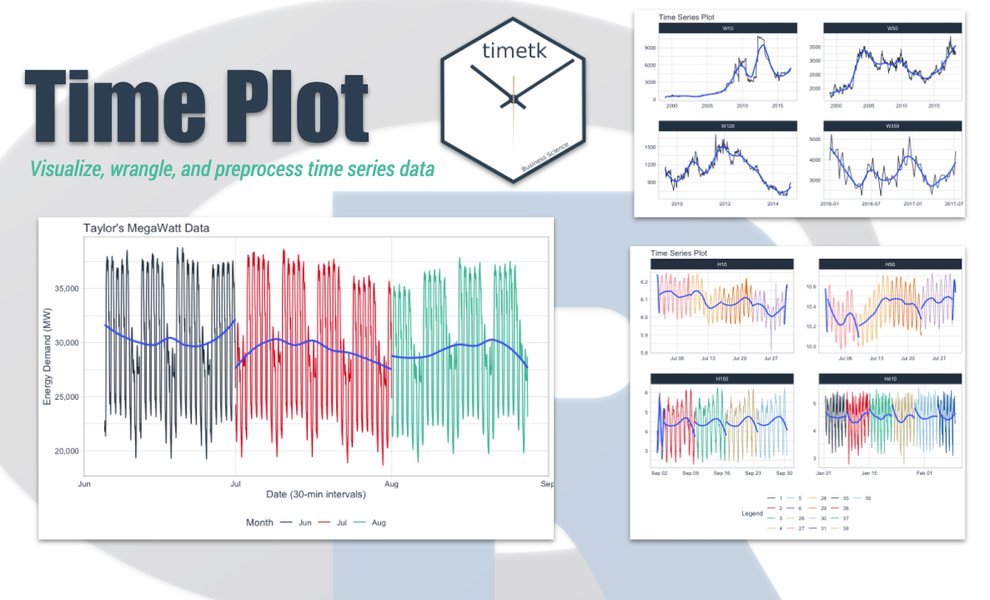
Visualisation typique d'une série temporelle montrant les données historiques.
Visualisation des Prédictions
import matplotlib.pyplot as plt

plt.figure(figsize=(15, 7))

# Afficher une partie des données historiques récentes
plt.plot(df.index[-n_steps_future*4:], df['puissance_normalisee'][-n_steps_future*4:], label='Données Historiques Récentes', color='blue')

# Afficher les prédictions
plt.plot(predictions_series.index, predictions_series, label='Prédictions RLM (Semaine Suivante)', color='red', linestyle='--')

plt.title('Prédiction de la Puissance Normalisée avec RLM')
plt.xlabel('Date')
plt.ylabel('Puissance Normalisée')
plt.legend()
plt.grid(True)
plt.show()
Comparaison des Modèles de Régression
Radar Chart: LinearRegression vs SGDRegressor
Ce graphique radar illustre une comparaison qualitative entre LinearRegression et SGDRegressor selon plusieurs critères pertinents pour votre cas d'utilisation. Les scores sont indicatifs (sur une échelle de 1 à 5, 5 étant le "meilleur" pour ce critère) et peuvent varier selon l'implémentation et les données spécifiques.
Comme le montre le graphique, LinearRegression excelle en simplicité et interprétabilité, tandis que SGDRegressor brille par sa scalabilité et sa vitesse sur de grands jeux de données, au prix d'une complexité accrue (besoin de scaling, potentiellement plus de tuning).
Synthèse du Processus : Mindmap
Visualisation des Étapes Clés
Cette carte mentale résume le flux de travail pour prédire votre série temporelle de puissance avec la Régression Linéaire Multiple.
avec RLM (Univariée)"] id1["1. Préparation Données"] id1a["Charger Données
(Puissance Normalisée)"] id1b["Ingénierie Caractéristiques (Features)"] id1b1["Valeurs Décalées (Lags)"] id1b2["Caractéristiques Temporelles
(Heure, Jour Semaine...)"] id1b3["Tendance Linéaire"] id1b4["Moyennes Mobiles"] id1c["Division Chronologique
(Train / Test)"] id1d["Mise à l'échelle (Scaling)
Si SGDRegressor utilisé"] id2["2. Choix & Entraînement Modèle"] id2a["Option A: LinearRegression"] id2a1["Simple, Rapide (petits/moyens data)"] id2a2["Moindres Carrés Ordinaires (OLS)"] id2b["Option B: SGDRegressor"] id2b1["Scalable (grands data)"] id2b2["Descente de Gradient Stochastique"] id2b3["Nécessite Scaling & Tuning"] id2c["Entraînement sur Train Set"] id2d["Évaluation sur Test Set (MSE)"] id2e["Choix du Meilleur Modèle"] id3["3. Prédiction Future (Semaine Suivante)"] id3a["Approche Récursive"] id3a1["Prédire 1 pas"] id3a2["Mettre à jour historique"] id3a3["Répéter N fois"] id3b["Utiliser le 'Meilleur Modèle'"] id3c["Générer Caractéristiques à chaque pas"] id3d["(Dés)échelonner si besoin"] id4["4. Analyse & Visualisation"] id4a["Visualiser Prédictions vs Historique"] id4b["Interpréter 'Logique' des résultats"] id4c["Comprendre Limitations RLM"]
Cette carte mentale illustre le parcours depuis les données brutes jusqu'aux prédictions finales, en passant par les étapes cruciales de création de caractéristiques et de modélisation.
Apprendre Davantage sur la Régression Multiple pour les Séries Temporelles
Vidéo Explicative
Cette vidéo (en anglais) explique les bases de l'utilisation de la régression multiple pour la prévision de séries temporelles, notamment la prise en compte de la saisonnalité, un concept clé dans l'ingénierie des caractéristiques que nous avons abordée.
Comprendre comment intégrer des variables explicatives comme la saisonnalité dans un modèle de régression est essentiel pour améliorer la "logique" et la pertinence des prédictions issues d'un modèle linéaire appliqué à des données temporelles.
Tableau Récapitulatif des Caractéristiques
Exemples de Caractéristiques et Leur Rôle
Ce tableau résume les types de caractéristiques que vous pouvez créer et leur utilité pour modéliser votre série temporelle de puissance avec une RLM.
| Type de Caractéristique | Exemple(s) | Rôle Principal | Commentaires |
|---|---|---|---|
| Valeurs Décalées (Lags) | lag_1, lag_24, lag_168 |
Capture l'autocorrélation et la dépendance à court terme. | Le nombre de lags pertinent dépend de la fréquence et de la mémoire de la série. |
| Caractéristiques Temporelles Cycliques | Heure du jour, Jour de la semaine, Mois | Modélise la saisonnalité (patterns répétitifs). | Peut nécessiter un encodage spécifique (one-hot, sin/cos). |
| Tendance (Trend) | Compteur (0, 1, 2, ...) | Capture une augmentation ou diminution linéaire globale au fil du temps. | Utile si une tendance claire est visible. |
| Moyennes Mobiles | Moyenne des 7 derniers jours | Lisse le bruit, capture la tendance locale. | La taille de la fenêtre (window) est un paramètre à choisir. |
| Indicateurs Événementiels | Jour férié (0 ou 1) | Modélise l'impact d'événements ponctuels ou irréguliers. | Nécessite des données externes sur ces événements. |
La sélection et la création judicieuse de ces caractéristiques sont l'étape la plus importante pour obtenir des prédictions RLM "logiques" à partir de données initialement univariées.
Questions Fréquemment Posées (FAQ)
Pourquoi utiliser la RLM si elle n'est pas idéale pour les séries temporelles ?
Même si des modèles comme ARIMA, Prophet ou les réseaux de neurones (LSTM) sont souvent plus performants pour les séries temporelles complexes, la RLM présente des avantages :
- Simplicité : Elle est facile à comprendre, implémenter et interpréter.
- Rapidité : L'entraînement peut être très rapide, surtout avec
LinearRegression. - Bon point de départ : Elle peut servir de baseline pour évaluer des modèles plus complexes.
- Suffisante parfois : Si les relations sous-jacentes sont majoritairement linéaires et bien capturées par les caractéristiques créées, elle peut donner des résultats acceptables, surtout pour des prévisions à court terme.
Votre demande spécifique était d'utiliser la RLM pour obtenir les résultats "les plus logiques" possibles, ce qui implique de maximiser son potentiel via l'ingénierie des caractéristiques.
Comment choisir le nombre optimal de lags (valeurs décalées) ?
Le choix du nombre de lags (paramètre n_lags) est crucial. Il n'y a pas de règle unique, mais voici des approches :
- Connaissance du domaine : Y a-t-il des cycles naturels connus (horaires, journaliers, hebdomadaires) ? Inclure des lags correspondant à ces cycles (ex: lag 24 pour données horaires, lag 7 pour données journalières) est souvent pertinent.
- Analyse d'autocorrélation : Tracer les fonctions d'autocorrélation (ACF) et d'autocorrélation partielle (PACF) de votre série peut aider à identifier les lags significatifs.
- Validation croisée : Tester différentes valeurs de
n_lagsen utilisant une validation croisée temporelle (comme `TimeSeriesSplit` dans scikit-learn) et choisir celle qui minimise l'erreur de prédiction sur les ensembles de validation. - Commencer simple : Vous pouvez commencer avec un nombre raisonnable (ex: 24 ou 48 pour des données horaires) et ajuster ensuite.
Attention, inclure trop de lags peut mener au surapprentissage (overfitting) et augmenter la complexité du modèle.
Que faire si les prédictions ne sont pas assez "logiques" ?
Si les prédictions de la RLM semblent incohérentes ou peu fiables, plusieurs pistes sont à explorer :
- Améliorer l'ingénierie des caractéristiques :
- Ajouter/retirer des lags.
- Tester différentes fenêtres pour les moyennes mobiles.
- Mieux encoder la saisonnalité (ex: sin/cos au lieu de simples numéros de jour/heure).
- Inclure des variables externes si possible (météo, événements...).
- Transformer la variable cible (ex: log-transform) si sa distribution est très asymétrique.
- Vérifier les hypothèses de la RLM : La RLM suppose la linéarité, l'indépendance des erreurs, l'homoscédasticité. L'analyse des résidus (erreurs de prédiction sur l'ensemble de test) peut révéler des violations de ces hypothèses.
- Essayer la régularisation : Pour `SGDRegressor` (ou `Ridge`, `Lasso`), la régularisation (paramètres `penalty` et `alpha`) peut aider à prévenir le surapprentissage si vous avez beaucoup de caractéristiques.
- Envisager des modèles plus adaptés : Si la RLM atteint ses limites, il faudra peut-être passer à des modèles spécifiquement conçus pour les séries temporelles qui capturent mieux les non-linéarités, les dépendances temporelles complexes et la saisonnalité (ARIMA, SARIMA, Prophet, LSTMs, etc.).
Dois-je utiliser LinearRegression ou SGDRegressor pour mes 437 796 mesures ?
Avec près de 440 000 mesures, votre jeu de données est relativement volumineux. Voici les considérations :
LinearRegression: Pourrait encore fonctionner raisonnablement vite si vous avez suffisamment de RAM pour charger toutes les données et la matrice de caractéristiques en mémoire. L'avantage est sa simplicité (pas de scaling requis, pas d'hyperparamètres à régler).SGDRegressor: Est spécifiquement conçu pour les grands jeux de données qui ne tiennent pas forcément en mémoire (bien que scikit-learn l'implémente pour des données en mémoire). Il peut être plus rapide à entraîner sur de très grands volumes car il met à jour les poids de manière itérative sur des sous-ensembles. Cependant, il nécessite une mise à l'échelle des caractéristiques et peut demander un peu de réglage des hyperparamètres (learning_rate,eta0,max_iter,penalty,alpha).
Recommandation : Essayez les deux ! L'entraînement de `LinearRegression` est rapide à tester. Si cela prend trop de temps ou consomme trop de mémoire, `SGDRegressor` est une excellente alternative. N'oubliez pas de comparer leurs performances (par exemple, via le MSE sur l'ensemble de test) pour choisir le modèle final pour vos prédictions récursives.
Recommandations de Recherche
Pour approfondir votre analyse :
- Comment améliorer la précision des prédictions de séries temporelles avec des caractéristiques saisonnières en Python ?
- Quelles sont les meilleures techniques de validation croisée pour les modèles de séries temporelles ?
- Comparer la performance de la Régression Linéaire Multiple avec ARIMA pour la prévision de la demande d'énergie.
- Comment interpréter les coefficients d'un modèle de régression linéaire entraîné sur des données de séries temporelles avec des lags ?
Références
Sources et Lectures Complémentaires :
Last updated April 29, 2025