
継続的インテグレーションにおけるテスト失敗予測:最先端の研究動向
機械学習とAIがCI/CDパイプラインの安定性向上にどう貢献するか
継続的インテグレーション(CI)環境におけるテスト失敗の予測は、ソフトウェア開発プロセスを効率化し、高品質なソフトウェアを迅速に提供するために非常に重要な研究分野です。近年、機械学習(ML)や人工知能(AI)の技術を活用して、テストの失敗を事前に検知し、開発者が問題をより早く特定・修正できるよう支援する研究が活発に行われています。
主要な研究ハイライト
- 機械学習モデルの活用: CIにおけるテスト失敗予測のために、様々な機械学習アルゴリズムが検討されています。特に、履歴データからのパターン学習により、将来のテスト結果を予測するアプローチが一般的です。
- 予測精度の向上: モデルの精度を高めるために、コード変更の種類、過去のビルド情報、プロジェクトの特性など、多様な特徴量が分析されています。ディープラーニングや進化的探索を用いた手法も提案されています。
- 継続的テスト選択への応用: テスト失敗予測は、コード変更に関連する最も重要なテストのみを実行する「予測的テスト選択」に応用され、CIのコストと時間を削減する可能性を秘めています。
CI環境におけるテスト失敗予測の重要性
継続的インテグレーションは、コード変更を頻繁に統合し、自動化されたビルドとテストを実行することで、問題を早期に発見することを目的としています。しかし、CIパイプラインにおけるテスト失敗は頻繁に発生し、開発者の生産性低下やリリースの遅延を招く可能性があります。特に、同じコードでテスト結果が不安定になる「フレーキーテスト」は、原因特定が難しく、開発チームにとって大きな課題となります。
テスト失敗予測の研究は、これらの課題に対処するために登場しました。テストが失敗する可能性を事前に警告することで、開発者は問題の根本原因をより迅速に調査し、修正することができます。これにより、無駄なビルド実行や手動でのデバッグ作業を削減し、開発効率を向上させることが期待されます。
ソフトウェアテストの種類
機械学習によるテスト失敗予測のアプローチ
機械学習を用いたテスト失敗予測は、過去のCIビルドやテスト実行のデータを分析し、パターンを学習することで実現されます。一般的なアプローチは以下のステップで構成されます。
データ収集と前処理
モデルのトレーニングには、過去のビルド結果(成功/失敗)、テスト結果、コード変更に関するメタデータ(コミット情報、変更されたファイルの種類や量)、テストスイートの情報、開発者の情報など、様々なデータが必要です。これらのデータは、バージョン管理システムやCIサーバーから収集され、機械学習モデルが利用できる形式に前処理されます。
特徴量エンジニアリング
収集されたデータから、テスト失敗との関連性が高い特徴量を抽出または生成します。例えば、過去のビルドの失敗率、変更されたファイルの数、コードの複雑さ、特定のテストケースの過去の失敗履歴などが特徴量として考慮されます。効果的な特徴量エンジニアリングは、モデルの予測性能に大きく影響します。
モデル選択とトレーニング
予測モデルとしては、ロジスティック回帰、サポートベクターマシン、決定木、勾配ブースティング(XGBoostなど)、ニューラルネットワークなど、様々な機械学習アルゴリズムが利用されます。これらのモデルは、前処理および特徴量エンジニアリングが施された履歴データを用いてトレーニングされ、テスト失敗を予測するための規則やパターンを学習します。
評価とデプロイ
トレーニングされたモデルは、未知のデータを用いてその予測精度が評価されます。精度、再現率、F値などの指標が用いられます。性能が十分であれば、モデルはCIパイプラインに統合され、新しいコード変更に対してテスト失敗の可能性を予測するために使用されます。
機械学習アルゴリズムの比較
テスト失敗予測に用いられる機械学習アルゴリズムにはそれぞれ特徴があります。以下にいくつかの代表的なアルゴリズムとその特性を示します。
| アルゴリズム | 特徴 | CIテスト失敗予測への適用 |
|---|---|---|
| ロジスティック回帰 | 線形モデル、解釈が容易 | 基本的な分類タスク、特定の要因の寄与度分析 |
| 決定木 / ランダムフォレスト | 非線形関係を捉える、解釈が比較的容易 | 複雑なパターン分析、重要な特徴量の特定 |
| 勾配ブースティング (XGBoost, LightGBM) | 高い予測精度、アンサンブル学習 | 複雑なデータセットでの高性能予測 |
| サポートベクターマシン (SVM) | 高次元データに強い、マージン最大化 | 線形分離不可能なデータの分類 |
| ニューラルネットワーク / ディープラーニング | 複雑な非線形関係を学習、大量データに強い | テキストデータ(ログなど)や時系列データの分析、より複雑なパターン学習 |
ある研究では、クラウド環境でのジョブおよびタスク失敗予測において、Random Forestと決定木が89.75%の精度を示したと報告されています。
テスト失敗予測モデルの評価指標
テスト失敗予測モデルの性能を評価するためには、いくつかの重要な指標があります。これらの指標は、モデルが実際にどれだけ有用であるかを判断するために不可欠です。
一般的な評価指標
- 精度 (Accuracy): 正しく予測されたケースの総数に対する割合。ただし、失敗ケースが少ない不均衡データでは誤解を招く可能性がある。
- 再現率 (Recall/Sensitivity): 実際に失敗したテストのうち、モデルが正しく失敗と予測できた割合。偽陰性(失敗を見逃す)を減らすことが重要な場合に重視される。
- 適合率 (Precision): モデルが失敗と予測したテストのうち、実際に失敗であった割合。偽陽性(正常を失敗と誤って予測する)を減らすことが重要な場合に重視される。
- F値 (F1-score): 再現率と適合率の調和平均。不均衡データセットにおいて、モデルの全体的な性能を示す指標として有用。
- AUC (Area Under the ROC Curve): ランダムな推測よりもモデルがどれだけ優れているかを示す。0.5はランダム、1.0は完璧な予測。
CIにおけるテスト失敗予測では、失敗を見逃すこと(偽陰性)が開発プロセスに大きな影響を与える可能性があるため、再現率を重視することがよくあります。また、頻繁な誤警報(偽陽性)は開発者を疲弊させるため、適合率も重要です。F値は、これら二つのバランスを見るのに役立ちます。
予測モデルの課題と改善策
テスト失敗予測モデルの構築と運用にはいくつかの課題が存在します。研究ではこれらの課題への対処法も検討されています。
不均衡データへの対応
CIビルドでは成功するテストの数が失敗するテストよりも圧倒的に多い場合があり、データが不均衡になります。これにより、モデルが多数派である成功クラスに偏って予測する可能性があります。対応策としては、オーバーサンプリング、アンダーサンプリング、またはSMOTEのような手法を用いたデータのリサンプリング、あるいは不均衡データに特化したアルゴリズム(例: LightGBMのis_unbalanceパラメータ)の利用が挙げられます。
フレーキーテストの影響
フレーキーテストは、コード変更がないにも関わらず、実行ごとに結果が変動するテストです。これは予測モデルにとってノイズとなり、予測精度を低下させます。フレーキーテストを特定し、その影響を軽減または除外する手法や、フレーキーテスト自体を予測する研究も行われています。
変化するソフトウェアシステムへの適応
ソフトウェアシステムは常に進化しており、コードベース、テストスイート、開発プラクティスが変化します。これにより、過去のデータでトレーニングされたモデルの予測性能が時間とともに劣化する可能性があります。継続的なモデルの再トレーニングや、新しいデータへの適応能力を持つオンライン学習や転移学習のアプローチが研究されています。
解釈可能性と信頼性
予測モデルが「なぜ」特定のテスト失敗を予測したのかを開発者が理解できることは重要です。モデルの予測根拠を説明可能な形で提供することで、開発者は問題の特定や修正に役立てることができます。Explainable AI (XAI) の技術を用いた研究も進められています。
予測的テスト選択への応用
テスト失敗予測は、CIパイプラインの効率化に直結する「予測的テスト選択」に応用されています。これは、コード変更に関連するテストの中から、失敗する可能性が高いテストや、ソフトウェア品質に大きな影響を与えるテストを優先的に実行する手法です。
従来のテスト影響分析は、コードの依存関係に基づいて実行すべきテストを判断しますが、全ての関連テストを実行すると時間がかかる場合があります。予測的テスト選択は、機械学習モデルの予測を用いて、実行すべきテストのサブセットをインテリジェントに選択します。これにより、CIの実行時間を短縮しつつ、重要な失敗を見逃すリスクを低減することが目指されています。
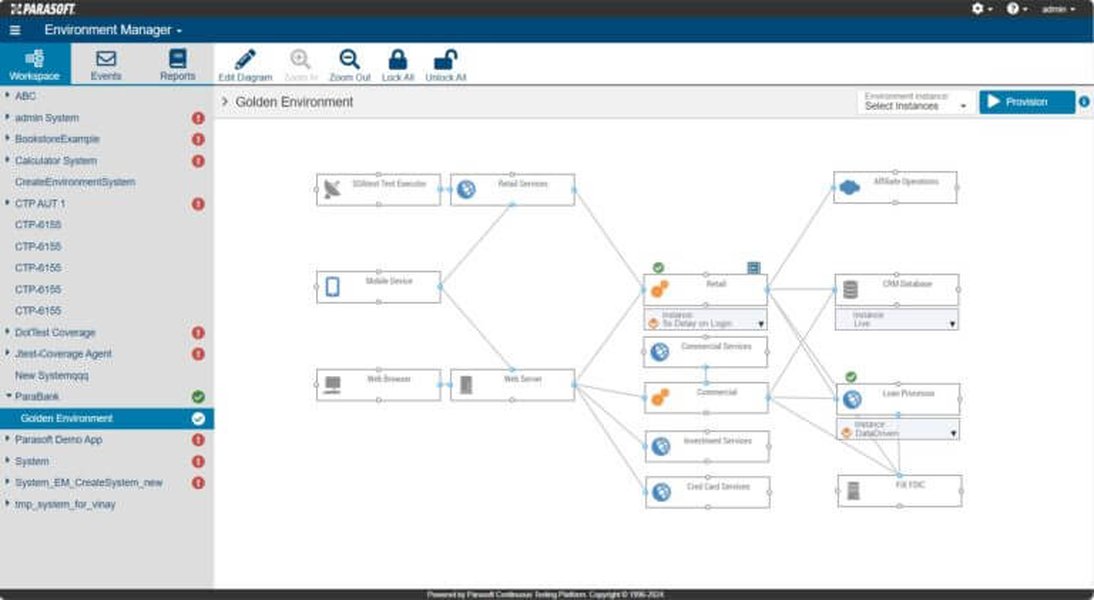
シフトレフトテストと予測的テスト選択
研究の現状と将来展望
CIにおけるテスト失敗予測に関する研究は進展しており、一部のツールやプラットフォームでは既にこの機能が組み込まれています。しかし、前述の課題、特にフレーキーテストへの対応や、変化し続ける環境へのモデルの適応は、依然として活発な研究領域です。
将来的には、より高精度で信頼性の高い予測モデルの開発、多様な種類のテスト失敗(例: パフォーマンス劣化、セキュリティ脆弱性)の予測、そして予測結果を開発者に効果的にフィードバックし、デバッグプロセスを支援するツールの進化が期待されます。また、CI/CDパイプライン全体の最適化に、テスト失敗予測がさらに統合されていくと考えられます。
CIテスト失敗予測に関連する研究分野のレーダーチャート
上記のレーダーチャートは、CIにおけるテスト失敗予測に関連する主要な研究分野の相対的な活発さと成熟度に関する私の分析を示しています。機械学習アルゴリズムの適用は広範に行われており、特徴量エンジニアリングも重要な要素です。モデルの評価と改善は継続的な取り組みであり、特に不均衡データやフレーキーテストへの対応は現在も盛んに研究されています。予測的テスト選択への応用は、この分野の実践的な価値を高める重要な方向性です。解釈可能性と信頼性は、モデルの採用を促進するために今後さらに重要になる分野と言えるでしょう。
また、AIを活用してCIのテスト失敗を自動的に診断し、根本原因を特定する取り組みも進められています。これにより、開発者は手動でのログ分析にかかる時間を削減し、問題修正に集中できるようになります。
AIを用いたCIパイプラインジョブ失敗のトラブルシューティングに関するYouTube動画
この動画は、AIがどのようにCIパイプラインのジョブ失敗をトラブルシューティングし、原因特定を支援するかについて解説しています。AIがテスト失敗ログを解析し、具体的な失敗箇所や原因を示唆することで、開発者のデバッグ作業を大幅に効率化できる可能性が示されています。これは、テスト失敗を予測するだけでなく、発生した失敗に迅速に対処するという点で、CI/CDの効率化におけるAIの役割を示す良い例です。
FAQ
おすすめの関連検索
- CI/CDにおける予測的テスト選択とは何ですか?
- 機械学習はフレーキーテストの検出にどう役立ちますか?
- AIを活用したCIテスト失敗デバッグの効率化について教えてください。
- CIビルド失敗予測における課題は何ですか?
参考文献

Last updated May 20, 2025