
CIにおける連続テスト失敗の予測に関する研究
継続的インテグレーション環境でのテスト信頼性向上に向けた取り組み
要点
- CI環境特有の要因がテストの断続的な失敗(Flaky Test)を引き起こす可能性がある。 リソース制限や非同期処理、環境の差異などが挙げられます。
- テスト失敗の早期発見と迅速な修正が重要です。 これにより、開発サイクルを加速し、手戻りによるコストを削減できます。
- 機械学習を活用してテスト失敗を予測する研究が進んでいます。 コード変更や過去の実行履歴に基づいて、失敗しそうなテストを特定し、優先的に実行するなどのアプローチが試みられています。
継続的インテグレーション(CI)とテストの重要性
継続的インテグレーション(CI)は、現代のソフトウェア開発において不可欠なプラクティスとなっています。開発者がコード変更を頻繁に共有リポジトリにマージし、自動化されたビルドとテストを実行することで、問題を早期に発見し、開発プロセス全体の効率と品質を向上させます。CIは継続的デリバリー(CD)と組み合わせて語られることが多く、合わせてCI/CDと呼ばれ、継続的に価値を提供するための重要な仕組みです。
CIにおいて自動テストは中心的な役割を担います。特にユニットテストは、個々の機能やメソッドが正しく動作することを確認するために重要であり、ソフトウェアの品質保証に欠かせません。テストの自動化により、手動テストと比較して時間とコストを大幅に削減できます。
CIツールは、コード変更を監視し、新しい変更が検出されると自動的にビルドプロセスをトリガーします。これにより、定義済みのワークフローとビルドスクリプトが実行され、テストの準備が整います。主要なCIツールには、Jenkins、CircleCI、GitHub Actions、GitLab CIなどがあります。
CI環境でのテスト失敗の原因
ローカル開発環境では問題なく動作するテストが、CI環境で断続的に失敗する、いわゆる「Flaky Test」は、CI運用における一般的な課題です。これらの失敗は予測困難であり、開発者に混乱をもたらし、テスト結果への信頼を損なう可能性があります。連続したテスト失敗は、さらなる調査と修正に時間を要し、開発サイクルを遅延させる要因となります。
CI環境でテストが失敗する主な原因はいくつか考えられます。
リソースの制限
CI環境は、開発環境と比較してCPUやメモリなどのリソースが制限されている場合があります。これにより、サーバーの起動や処理に時間がかかり、テストのタイムアウトや予期せぬエラーが発生することがあります。
非同期処理とタイミングの問題
非同期処理を含むテストや、複数のテストが並列実行される場合に、処理の完了順序やタイミングに依存してテストが失敗することがあります。特定の条件下でのみ発生するため、原因の特定が難しい場合があります。
環境の差異
ローカル環境とCI環境で、オペレーティングシステム、言語バージョン、ライブラリのバージョン、タイムゾーンなどの設定が異なる場合、テストの実行結果に影響を与える可能性があります。
外部依存関係
テストが外部サービスやデータベースに依存している場合、これらのサービスの応答時間や可用性の問題がテスト失敗の原因となることがあります。
テストの順序依存性
テストケースが特定の順序で実行されることを前提としている場合、CI環境でのテスト実行順序の違いにより失敗することがあります。これは、テスト間に不適切な依存関係が存在することを示唆しています。
連続テスト失敗予測に関する研究アプローチ
CI環境における連続したテスト失敗は、開発効率とソフトウェア品質に悪影響を与えるため、これらの失敗を予測し、事前に対処するための研究が進められています。主な研究アプローチとして、テスト実行履歴の分析や機械学習の活用が挙げられます。
テスト実行履歴の分析
過去のCIパイプラインの実行履歴を分析することで、特定のテストケースがどのような条件下で失敗しやすいかのパターンを特定することができます。例えば、特定のコード変更後に頻繁に失敗するテストや、特定のCIエージェントで失敗しやすいテストなどを識別できます。
機械学習による予測
機械学習は、テスト失敗予測において有望なアプローチとして注目されています。コードの変更内容、過去のテスト実行結果、テストに関連するメタデータなどを特徴量として利用し、テストが失敗するかどうかを予測するモデルを構築します。
テスト選択と優先順位付け
機械学習モデルによって失敗する可能性が高いと予測されたテストを優先的に実行することで、問題を早期に発見し、フィードバックサイクルを短縮することができます。これにより、CIの実行時間を最適化し、開発者が問題に迅速に対応できるようになります。Googleでは、機械学習を用いて「次に失敗しそうなテスト」を予測し、優先的に実行することでバグ発見時間を短縮した事例が報告されています。
Flaky Testの特定
連続したテスト実行で結果が不安定なテスト(Flaky Test)を機械学習を用いて特定する研究も行われています。Flaky Testは、見過ごされると偽陽性(誤って失敗と報告される)や偽陰性(失敗を見逃す)の原因となり、テスト結果の信頼性を低下させます。機械学習によりFlaky Testの可能性をスコアリングし、開発者がこれらのテストを優先的に修正できるようにすることが目指されています。
失敗原因の分析支援
テストが失敗した場合に、過去のデータから類似の失敗パターンや可能性のある原因を提示することで、開発者のデバッグ作業を支援する研究も行われています。
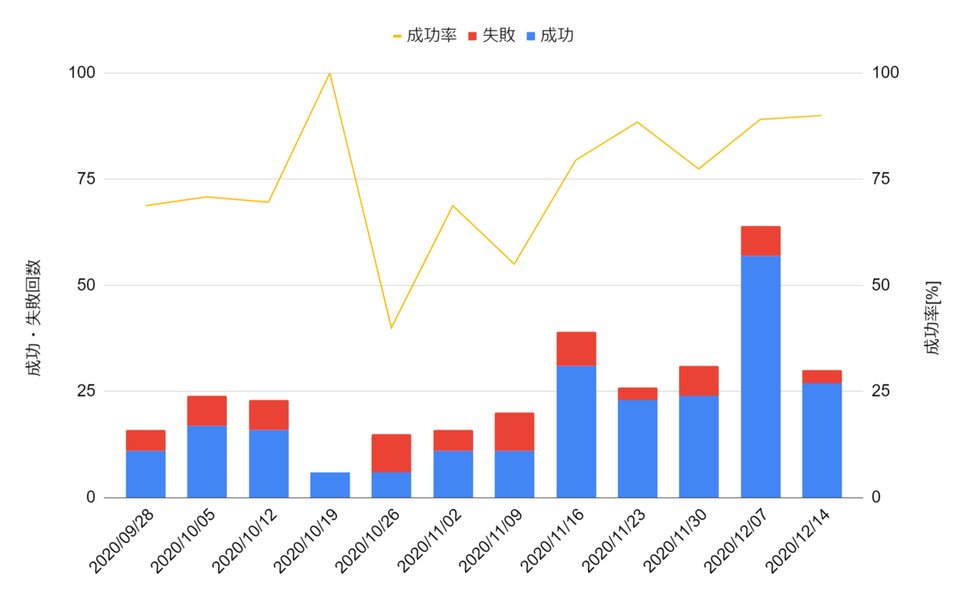
CI環境でのテスト実行とフィードバックのイメージ
Flaky Testへの対処
連続テスト失敗の多くはFlaky Testに起因します。Flaky Testへの対処方法としては、以下の点が挙げられます。
- テストの隔離: 信頼性の低いテストを一時的に隔離し、主要なCIパイプラインの実行を妨げないようにします。
- 原因の調査と修正: 失敗したテストケースを詳細に調査し、タイミングの問題、外部依存、環境の差異などの根本原因を特定して修正します。
- テストの改善: テストコード自体を見直し、非同期処理に対する適切な待機処理を追加したり、外部依存をモック化したりするなど、テストの信頼性を向上させるための改善を行います。
関連研究事例
CIにおけるテスト失敗、特に連続失敗の予測やFlaky Testに関する研究は活発に行われています。以下にいくつかの関連研究の方向性を示します。
T-Evos: CI試験実行と故障に関する大規模縦断研究
この研究では、実際のソフトウェアプロジェクトにおけるCIの実行とテスト故障に関する大規模なデータに基づいた分析が行われています。連続的なテスト失敗(Ringing Test Alarms: RTA)に着目し、その発生パターンやCI運用への影響などが調査されています。
機械学習によるテスト失敗の予測
コードの変更や過去のテスト結果データを用いて、機械学習モデルによりテスト失敗を予測する研究が進められています。これにより、開発者への早期フィードバックや、テストリソースの効率的な利用を目指しています。
Flaky Testの特定と分類
Flaky Testを自動的に特定し、その原因を分類する手法に関する研究も重要です。原因に応じた効果的な対処法を適用するために、Flaky Testの性質を理解することが不可欠です。
CI環境におけるタイミング問題の解決
CI環境特有のタイミング問題に起因するテスト失敗の解決事例に関する報告も行われています。リソース不足や非同期処理など、具体的な問題とその解決策は、CIの信頼性向上に役立ちます。
テスト失敗予測のメリットと課題
テスト失敗予測を導入することには、いくつかのメリットと課題があります。
メリット
- 問題の早期発見: 失敗しそうなテストを事前に検知することで、開発者は問題に早期に対応でき、修正にかかるコストと時間を削減できます。
- フィードバックの高速化: 重要なテストや失敗しやすいテストを優先的に実行することで、開発者へのフィードバックサイクルを短縮できます。
- リソースの最適化: 失敗する可能性の低いテストの実行をスキップするなど、テストリソースを効率的に利用できます。
- 開発者の信頼向上: Flaky Testによる偽陽性を減らすことで、テスト結果への信頼が高まり、開発者はテストをより安心して利用できるようになります。
課題
- 予測モデルの精度: テスト失敗の要因は複雑であり、高精度な予測モデルを構築するには多くのデータと継続的な改善が必要です。
- Flaky Testの特定: Flaky Testは発生が不定期であるため、その特定自体が課題となることがあります。
- 原因の特定: 予測はできても、具体的な失敗原因の特定は依然として開発者の作業となる場合があります。
- 導入と運用コスト: 予測システムの構築、維持、およびモデルの継続的な学習には、時間とリソースが必要です。
テスト失敗予測に関する能力分析
テスト失敗予測システムに求められる能力をレーダーチャートで視覚化します。これは、システムの総合的なパフォーマンスと各側面の強み・弱みを理解するのに役立ちます。
このチャートは、テスト失敗予測システムに期待される能力項目と、それぞれに対する理想的なシステムと一般的なシステムの推定パフォーマンスを示しています。「予測精度」はどれだけ正確に失敗を予測できるか、「早期検知能力」は問題発生から検知までの速さ、「Flaky Test特定」は不安定なテストを識別する能力、「原因分析支援」は失敗原因特定を助ける機能、「リソース効率化」はテスト実行リソースの最適化、そして「導入容易性」はシステムを導入・設定する際の容易さを示します。理想的なシステムはすべての項目で高いスコアを持ちますが、現実的なシステムではトレードオフが存在することが多いです。
CI/CDパイプラインとテスト失敗
CI/CDパイプラインは、コード変更が本番環境にデプロイされるまでの一連の自動化されたプロセスです。このパイプラインにおいて、テストは重要なゲートウェイの役割を果たします。テストが失敗した場合、パイプラインの実行を停止し、開発者に問題を通知することで、欠陥のあるコードが後続のステージに進むのを防ぎます。
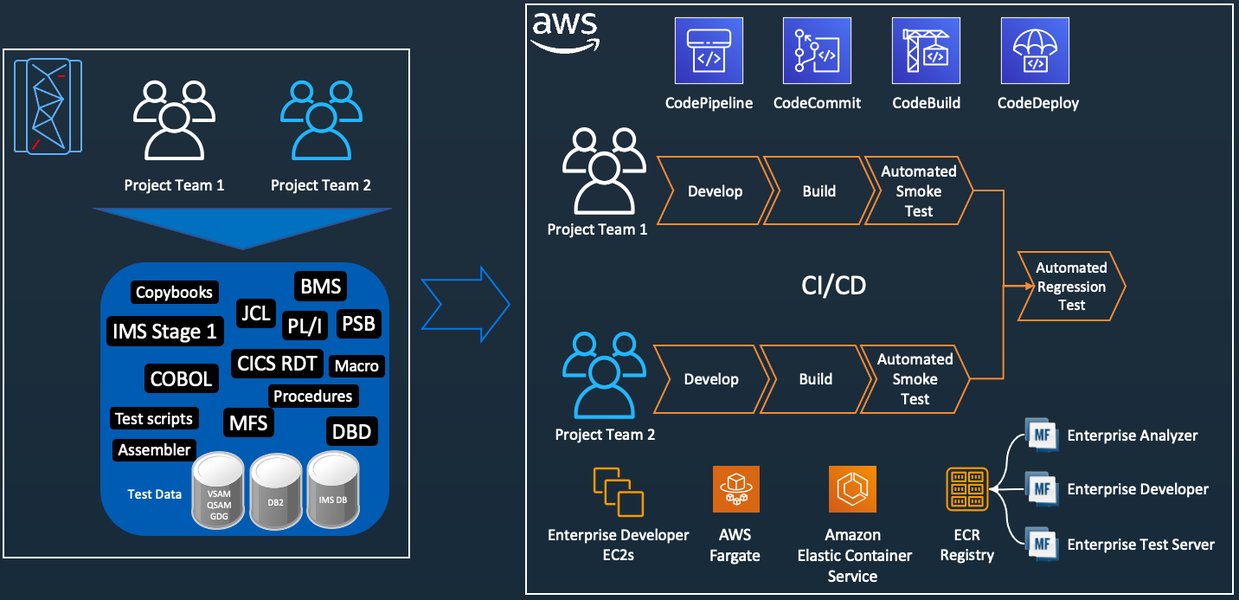
CI/CDパイプラインの例
テストの失敗がCIパイプラインに与える影響は、実行ルールによって制御できます。例えば、テスト失敗がパイプライン全体を停止させる「blocking」として設定されている場合、開発者はすぐに失敗に対処する必要があります。一方、「non_blocking」や「skipped」として設定されている場合は、パイプラインは継続されるものの、問題が未解決のまま残るリスクがあります。「Fail Fast」の原則に基づき、テスト失敗時にはできるだけ早くパイプラインを停止させ、開発者に通知することが推奨されます。これにより、問題を早期に検出し、修正にかかるコストを最小限に抑えることができます。
CIにおけるテスト失敗関連情報の整理
CI環境でのテスト失敗に関する情報を表にまとめると、より理解が深まります。以下の表は、テスト失敗の種類、考えられる原因、および一般的な対処法を示しています。
| テスト失敗の種類 | 考えられる原因 | 一般的な対処法 |
|---|---|---|
| 恒常的な失敗 | コードのバグ、テストコードの誤り、環境設定の間違い | コードまたはテストコードの修正、環境設定の見直し |
| 断続的な失敗 (Flaky Test) | タイミング問題、リソース競合、外部依存の不安定性、テストの順序依存性、環境の差異 | テストの隔離、原因の調査と修正、テストの信頼性向上、環境の標準化 |
| CI環境固有の失敗 | CI環境のリソース制限、CIツールの設定ミス、キャッシュの問題 | CI環境のリソース確認、CI設定の見直し、キャッシュのクリア |
この表は、テスト失敗の種類に応じて、原因の切り分けと対処法の選択に役立ちます。特に断続的な失敗(Flaky Test)は原因特定が難しく、継続的な監視と分析が必要です。
CI環境でのテスト信頼性向上のための実践
テスト失敗の予測と対処に加え、CI環境におけるテスト全体の信頼性を向上させるための実践も重要です。
安定したテスト環境の維持
CI環境は可能な限り安定しており、再現性があるべきです。コンテナ化技術などを利用して、テスト実行環境を標準化し、環境による差異を最小限に抑えます。
適切なテスト設計
テストコードは、外部依存を排除したり、非同期処理に対する適切な待機を実装したりするなど、Flakyになりにくいように設計することが重要です。テストは小さく、独立しており、決定論的であるべきです。
テスト実行の最適化
テストスイートが大きくなるにつれて、テスト実行時間が増加します。テストの並列実行や、変更されたコードに関連するテストのみを実行するテストセレクションなどの手法を導入することで、フィードバックサイクルを短縮できます。
継続的な監視と分析
CIの実行結果を継続的に監視し、テストの失敗率やFlaky Testの発生状況などを分析します。これにより、潜在的な問題を早期に発見し、テストインフラストラクチャやテストコードの改善に繋げることができます。
WMSにおけるCI/CD活用の事例紹介ビデオ
上記のビデオは、WMS (倉庫管理システム) におけるCI/CDの活用事例を紹介しています。これは、CI/CDがソフトウェア開発の様々な領域でどのように活用され、品質向上や効率化に貢献しているかを示す一例です。動画では、CI/CDによる自動テストのメリットや、それによって解決される課題について触れられています。CI/CD、ひいては継続的な自動テストは、システムの種類に関わらず、開発プロセスの改善に大きく貢献します。
FAQ
おすすめの関連検索
参考文献
Last updated May 20, 2025