
CIにおける連続テスト失敗の予測に関する研究
継続的インテグレーション環境でのテスト安定性向上への洞察
ハイライト
- CIにおけるテスト失敗の早期発見と根本原因分析の重要性: CI環境での自動テスト失敗は、開発プロセスを遅延させ、生産性を低下させる可能性があります。ログの詳細な確認やAIを活用した根本原因分析が、問題の迅速な特定と解決に役立ちます。
- 不安定なテスト(Flaky Tests)が連続失敗の原因となる可能性: ローカル環境では成功するテストがCI環境で失敗する場合、タイミング依存の問題、環境の差異(言語/パッケージバージョン、タイムゾーン)、ファイルの読み込み順序、サービスの起動時間の違いなどが考えられます。これらの不安定なテストは、連続失敗として現れることがあります。
- 予測モデルの構築とその応用: ベイズ推論やロジスティック回帰などの統計的手法や、機械学習モデルを用いることで、過去のテスト結果やコードの変更履歴などのデータを基に、将来的なテスト失敗の可能性を予測する研究が進められています。
継続的インテグレーション(CI)は、現代のソフトウェア開発において不可欠なプラクティスとなっています。コードの変更を頻繁に統合し、自動化されたビルドとテストを実行することで、問題を早期に発見し、開発の効率とソフトウェアの品質を向上させることが可能です。しかし、CI環境でテストが失敗することは避けられず、特に連続したテストの失敗は開発ワークフローを大きく阻害する要因となります。この課題に対処するため、連続したテスト失敗を予測し、未然に防ぐ、あるいは迅速に対処するための研究が進められています。
継続的インテグレーション(CI)とその重要性
CIは、開発者がコードの変更を共有リポジトリに頻繁にコミットし、その度に自動的にビルド、テスト、検証を行うプラクティスです。これにより、統合による問題を早期に検出し、修正コストを削減できます。手動での統合に比べて、CIはヒューマンエラーを減らし、開発チームの生産性を向上させ、より迅速なリリースサイクルを実現します。
CIツールは、コードがコミットされると自動的に一連のプロセスを開始し、統合エラーを迅速に検出して開発者にフィードバックします。この迅速なフィードバックループが、問題を小さく保ち、修正を容易にします。
CIにおけるテスト失敗の主な原因
CI環境でテストが失敗する原因は多岐にわたります。一般的な原因としては、コード内の構文エラーや論理的なバグ、コードの不具合によるテストの失敗が挙げられます。しかし、特に連続した失敗や、ローカル環境では再現しない失敗の場合、以下のような原因が考えられます。
環境の差異
ローカル開発環境とCI環境の間で、言語やパッケージのバージョン、タイムゾーンなどの設定が異なる場合、テスト結果に影響を与えることがあります。構成ファイルでバージョンを明示的に指定するなどの対策が必要です。
# 例: Node.jsのバージョンを固定
node:
  version: '14'
タイミング依存の問題
テストの実行順序や、非同期処理、外部サービスへの依存など、時間やタイミングによってテストの成否が変動する「不安定なテスト(Flaky Tests)」は、CI環境での連続失敗の大きな原因となります。サーバー起動とテスト実行のタイミングの不一致などが例として挙げられます。
// 例: 非同期処理完了を待たずにテストが実行される
async function fetchData() {
  // データ取得処理
}

test('データが正しく取得できるか', async () => {
  fetchData();
  // データが取得される前にテストが終了する可能性
  expect(data).toBeDefined();
});
不安定なテストは、見かけ上の失敗を引き起こし、開発者の信頼を損ねる可能性があります。これらのテストを特定し、修正することが重要です。
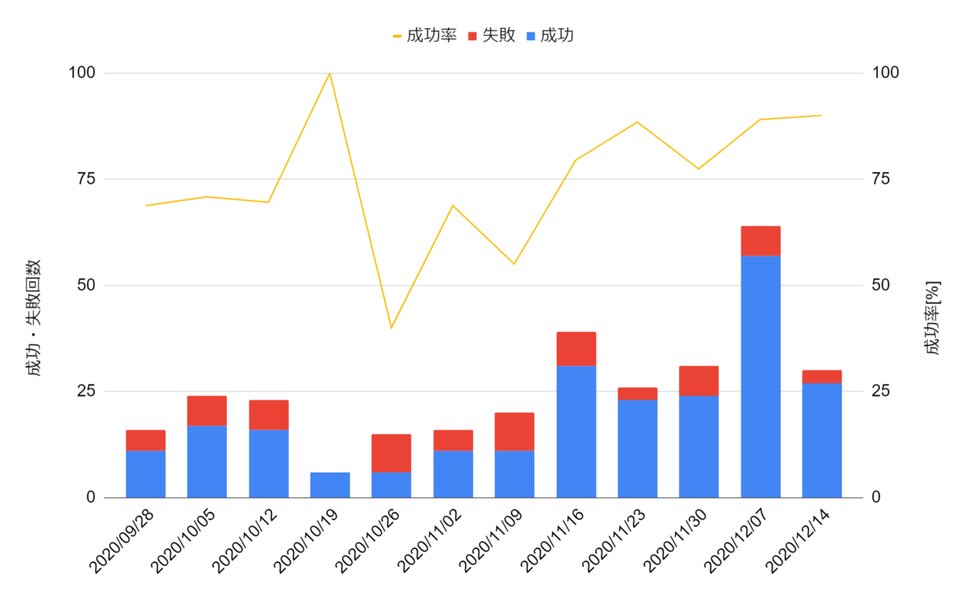
不安定なテスト(Flaky Test)の概念図
テストデータの衝突
特に並列実行されるテストにおいて、同じテストデータを共有したり、一時的なリソースを適切に解放しなかったりすることで、テストケース間で予期せぬ干渉が発生し、失敗を引き起こすことがあります。ハードコーディングされたIDの衝突などがこれに該当します。
外部サービスの不安定性
CIパイプラインが依存する外部サービス(データベース、APIなど)の一時的な問題や応答遅延が、テスト失敗の原因となることがあります。サービスが利用可能になるまで明示的に待機するなどの対策が有効です。
連続テスト失敗の予測に関する研究アプローチ
連続テスト失敗を予測するための研究は、主に過去のデータ分析と統計的モデリング、および機械学習アプローチに焦点を当てています。
統計的アプローチ
統計的手法を用いた予測では、過去のテスト実行データ、コード変更履歴、開発者のコミットパターンなどを分析し、連続失敗の発生確率をモデル化します。ロジスティック回帰は、二値の結果(成功/失敗)を予測するためによく用いられます。
\[ P(\text{Failure}) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_1 + \beta_2 x_2 + \dots)}} \]ここで、\(P(\text{Failure})\) はテスト失敗の確率、\(x_i\) は予測因子(例: 過去の失敗回数、コードの変更量)、\(\beta_i\) は回帰係数です。オッズ比(Odds Ratio, OR)は、特定の因子が存在する場合としない場合での失敗のオッズの比を示し、その95%信頼区間が1を含むかどうかで因子の影響を評価できます。
ベイズ推論もまた、事前知識や過去のデータを活用して確率的な予測を行うための強力な枠組みを提供します。例えば、ベータ分布を用いてテストの成功確率の事後分布を更新することで、連続失敗の可能性を推測することができます。
\[ P(\theta | k, n) \propto P(k | \theta, n) P(\theta) \]ここで、\(\theta\) は成功確率、\(k\) は成功回数、\(n\) は試行回数、\(P(k | \theta, n)\) は尤度、\(P(\theta)\) は事前分布です。
機械学習アプローチ
近年、機械学習モデルを用いた予測も活発に行われています。決定木、ランダムフォレスト、サポートベクターマシン(SVM)、ニューラルネットワークなどが、テスト結果、コードメトリクス、システムログ、開発者の活動などの多様なデータを学習し、テスト失敗を予測するために検討されています。
予測モデルの構築においては、以下の要素が重要な役割を果たします。
- 特徴量エンジニアリング: 予測に有効な特徴量(例: 過去N回のテスト結果、直前のコミットに含まれるファイルの数、コードの複雑さなど)を設計・抽出するプロセスです。
- モデル選択と評価: 複数の機械学習モデルを比較し、予測精度や解釈性などの観点から最適なモデルを選択します。混同行列、精度、再現率、F1スコアなどの指標を用いてモデルの性能を評価します。
- 継続的な学習と更新: ソフトウェア開発は継続的に行われるため、モデルも新しいデータを取り込んで継続的に学習・更新していく必要があります。
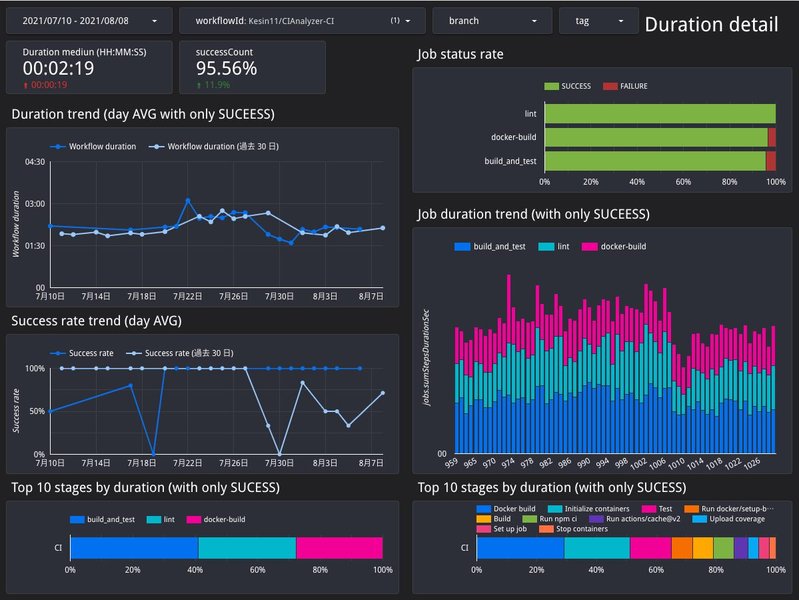
CI/CDのデータ収集の概念
AIによる根本原因分析
テスト失敗の予測だけでなく、失敗が発生した際にその根本原因を迅速に特定することも重要です。AIを活用した根本原因分析ツールは、CI/CDのログデータを分析し、失敗の可能性のある原因や修正方法を提案することで、問題解決にかかる時間を短縮します。
連続テスト失敗予測の応用と効果
連続テスト失敗の予測モデルは、様々な方法で応用できます。
リスクの高いコミットの特定
コードコミットが行われた際に、その変更が連続テスト失敗を引き起こす可能性が高いと予測された場合、開発者に追加のレビューやローカルでの入念なテストを促すなどの対策を講じることができます。
テスト実行の最適化
予測に基づいて、失敗しやすいテストケースを早期に実行したり、関連性の高いテストをグループ化したりすることで、フィードバックサイクルを短縮し、リソースの利用効率を向上させることができます。
テストの信頼性向上
予測モデルが不安定なテストのパターンを特定するのに役立つ場合、その情報を基にテストコード自体の改善に取り組むことができます。
CI環境での自動テスト失敗と対策
CI環境での自動テストの失敗は、開発のボトルネックとなり得ます。失敗が発生した場合の迅速な対応と、再発防止のための対策が重要です。
失敗発生時の対応フロー
CIテストが失敗した場合、以下のステップで原因を特定し、対処することが推奨されます。
- ログの詳細な確認: GitHub ActionsなどのCIツールの実行ログには、エラーの詳細情報が含まれています。各ステップのログを確認し、どの段階で、どのようなエラーが発生したかを特定します。
- 失敗したテストケースの分析: 失敗した具体的なテストケースを特定し、そのテストコードや対象となるアプリケーションコードを確認します。
- 環境の確認: CI環境の構成(言語バージョン、依存ライブラリ、環境変数など)が予期したものと一致しているかを確認します。
- ローカルでの再現試行: 可能であれば、CI環境に近い状態でローカル環境で失敗を再現してみます。これにより、問題が環境固有のものか、コード自体の問題かを切り分けることができます。
環境構築ミスとヒューマンエラーのイメージ
失敗を防ぐためのベストプラクティス
連続テスト失敗を未然に防ぐためには、以下のベストプラクティスが有効です。
- テストの安定性向上: 不安定なテスト(Flaky Tests)を特定し、時間依存や環境依存の問題を解消するようにテストコードを修正します。リトライ機構の導入も一時的な対策として有効な場合があります。
- CI設定の標準化と文書化: CI環境の構成を明確に定義し、開発者間で共有することで、環境差異による問題を減らします。
- コードレビューの強化: コード変更がテストに与える影響をレビュープロセスで十分に検討します。
- テスト戦略の見直し: ユニットテスト、結合テスト、E2Eテストなどのテストレベルのバランスを見直し、それぞれの役割を明確にします。
- CIパイプラインの監視と分析: CI実行時間、失敗率、失敗の種類などのメトリクスを継続的に収集・分析し、ボトルネックや改善点を発見します。
予測モデル構築における課題
連続テスト失敗の予測モデルを構築・運用する際には、いくつかの課題が存在します。
- データの質と量: 予測モデルの精度は、学習に用いるデータの質と量に大きく依存します。過去のテスト実行データ、コード変更履歴、環境情報などを網羅的かつ正確に収集・蓄積する必要があります。
- 特徴量の選定: 連続失敗に影響を与える因子は多岐にわたるため、どのような特徴量を用いるかがモデルの性能に大きく影響します。ドメイン知識やデータ分析に基づいて適切な特徴量を選定する必要があります。
- 変化への適応: ソフトウェアは常に変化しているため、過去のデータで学習したモデルが将来のテスト結果を正確に予測できなくなることがあります。モデルを定期的に再学習したり、変化に強いモデル構造を採用したりするなどの対応が必要です。
- 解釈可能性: 特に複雑な機械学習モデルの場合、なぜ特定のテストが失敗すると予測されたのかを開発者が理解するのが難しい場合があります。モデルの解釈可能性を高める工夫や、予測結果と合わせて関連情報を提供する仕組みが必要です。
CIテスト失敗予測モデルの能力評価
ここでは、架空のCIテスト失敗予測モデルの能力をレーダーチャートで表現します。これは、モデルの様々な側面における性能を比較するための概念的な評価であり、具体的な数値は実際のモデルによって異なります。
予測モデルの能力比較(概念図)
以下のレーダーチャートは、予測精度、早期警告能力、原因特定支援、解釈可能性、データ要求量といった側面から、異なるアプローチのモデルを比較したものです。円の中心に近いほど能力が低く、外側に行くほど高いことを示します。
統計モデルは解釈可能性に優れる一方、複雑なパターンを捉えにくい場合があります。機械学習モデルは高い予測精度を示すことが多いですが、解釈が難しい場合があります。AIによる根本原因分析ツールは、予測自体よりも、失敗発生後の原因特定と解決支援に強みがあります。
連続テスト失敗予測におけるデータ活用の具体例
連続テスト失敗を予測するためには、様々なデータを収集し、分析することが不可欠です。以下に、活用できるデータの種類と分析例を示します。
| データカテゴリ | 具体的なデータ例 | 分析による洞察 |
|---|---|---|
| テスト実行履歴 | 各テストケースの過去の実行結果(成功/失敗)、実行時間、失敗時のエラーメッセージ、リトライ回数 | 不安定なテストの特定、失敗パターンの検出、特定のテストケースの失敗率予測 |
| コード変更履歴 | コミットメッセージ、変更されたファイルの数と種類、コードの行数変化、コードの複雑さ | コード変更とテスト失敗の関連性、リスクの高い変更の特定 |
| CI環境情報 | OS、言語バージョン、ライブラリの依存関係、テスト実行環境のリソース状況 | 環境差異に起因する失敗の特定 |
| 開発者情報 | コミッター、過去のテスト失敗率、開発経験 | 特定の開発者に関連する失敗傾向の分析(ただしプライバシーに配慮が必要) |
| システムログ | CIサーバーのログ、依存サービスのログ | 外部要因による失敗の原因特定 |
これらのデータを組み合わせることで、より精度の高い予測モデルを構築し、連続テスト失敗のリスクを低減することが期待できます。
CI/CDにおける予測の重要性
CI/CDパイプライン全体において、予測は重要な役割を果たします。テスト失敗の予測だけでなく、デプロイ失敗の予測、パフォーマンス低下の予測なども、より安定した高品質なソフトウェアデリバリーを実現するために研究されています。
AIによる将来予測に関する動画(サム・アルトマン氏のビジョンに触れていますが、直接的なCIテスト失敗予測の技術的内容ではありません)
この動画は直接CIのテスト失敗予測に特化したものではありませんが、AIが様々な事象の予測に活用され始めている現状を示唆しています。ソフトウェア開発の領域においても、過去のデータから将来のリスクを予測する試みは、効率と信頼性の向上に不可欠となってきています。
FAQ
CI環境でテストが連続して失敗する主な原因は何ですか?
連続テスト失敗の予測にはどのようなデータが利用できますか?
予測モデルを構築する際の課題は何ですか?
予測モデルはどのようにCIプロセスに活用できますか?
AIはCIテスト失敗の予測や分析にどのように役立ちますか?
おすすめの関連検索
- CI環境における不安定なテスト(Flaky Tests)の特定と対策
- ソフトウェア開発におけるテスト自動化の効果と課題
- 機械学習を用いたソフトウェアテスト失敗予測モデル
- DevOpsにおける継続的インテグレーションのベストプラクティス
参考文献
 docs.aws.amazon.com
 aws.amazon.com
Last updated May 20, 2025