
Desentrañando el Comando by() en R: ¿A Qué Universo Pertenece?
Descubre el origen y funcionamiento de by(R[,6:8], R$Género, summary) dentro del ecosistema de RStudio.
Cuando te encuentras con un comando como by(R[,6:8], R$Género, summary) en R o RStudio, es natural preguntarse de dónde proviene y qué hace exactamente. Este comando es una herramienta poderosa para el análisis de datos agrupados. Vamos a explorar en detalle su origen y funcionalidad.
Puntos Clave
- Origen en la Base de R: La función
by(), al igual quesummary(), pertenece al paquete base de R. No necesitas instalar ni cargar librerías adicionales para utilizarlas. - Análisis por Grupos Simplificado: El comando aplica la función
summary()a un subconjunto de datos (columnas 6 a 8 del dataframeR), separando los resultados según los niveles de la variable categóricaGénero. - Eficiencia sin Dependencias: Es una solución integrada en R, ideal para análisis exploratorios rápidos y scripts que requieren mínimas dependencias externas.
Entendiendo el Comando: by(R[,6:8], R$Género, summary)
Este comando específico le indica a R que realice una tarea de resumen estadístico, pero de una manera agrupada. Desglosemos sus componentes para entender su propósito.
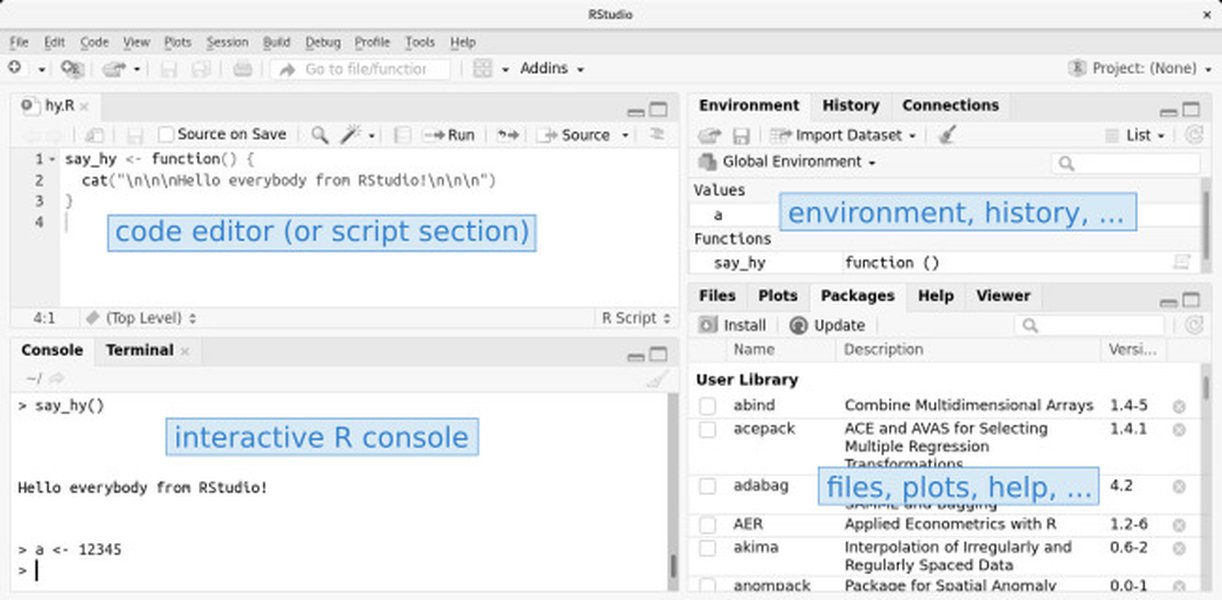
Interfaz típica de RStudio donde se ejecutarían comandos como by().
Funciones Centrales: by() y summary()
El comando se basa en dos funciones esenciales del lenguaje R:
La Función by()
La función by() es la protagonista aquí. Su rol principal es dividir un objeto de datos (como un data frame) en subconjuntos basados en los niveles de uno o más factores (variables categóricas) y luego aplicar una función específica a cada uno de esos subconjuntos.
En esencia, actúa como un aplicador de funciones por grupos. Su sintaxis general es:
by(data, INDICES, FUN, ..., simplify = TRUE)La Función summary()
La función summary() es una función genérica utilizada para obtener resúmenes concisos de diferentes tipos de objetos en R. Cuando se aplica a datos numéricos (como probablemente sean las columnas 6 a 8), calcula estadísticas descriptivas clave:
- Mínimo (Min.)
- Primer Cuartil (1st Qu.)
- Mediana (Median)
- Media (Mean)
- Tercer Cuartil (3rd Qu.)
- Máximo (Max.)
Si alguna de las columnas fuera categórica (factor), proporcionaría un recuento de frecuencias para cada nivel.
Pertenencia: La Librería Base de R
Tanto by() como summary() son funciones fundamentales que forman parte del paquete base de R. Este paquete contiene las funciones y conjuntos de datos esenciales que se cargan automáticamente cada vez que inicias una sesión de R o RStudio.
Esto tiene una implicación importante: no necesitas instalar ningún paquete adicional ni usar el comando library() para cargar una librería específica con el fin de utilizar by() o summary(). Están disponibles de inmediato.
La función by() es, de hecho, considerada un "wrapper" (envoltorio) orientado a objetos para otra función base llamada tapply(), diseñada específicamente para trabajar cómodamente con data frames.
Desglose Detallado del Comando
Analicemos cada parte del comando by(R[,6:8], R$Género, summary):
R[,6:8]: Este es el argumentodata. Selecciona un subconjunto del data frame llamadoR. Específicamente, elige todas las filas pero solo las columnas desde la 6 hasta la 8. Estos son los datos sobre los cuales se calculará el resumen.R$Género: Este es el argumentoINDICES. Indica la variable de agrupación. R tomará la columna llamadaGénerodel data frameRy la usará para dividir las filas deR[,6:8]en grupos distintos, uno por cada valor único presente en la columnaGénero(por ejemplo, "Hombre", "Mujer", u otras categorías).summary: Este es el argumentoFUN. Es la función que se aplicará a cada uno de los subconjuntos de datos creados en el paso anterior (es decir, a las columnas 6-8 para cada grupo deGénero).
El resultado de este comando será una lista (de clase "by") donde cada elemento corresponde a un nivel de la variable Género, y contiene el resumen estadístico (generado por summary()) de las columnas 6 a 8 para ese grupo específico.
Argumentos de la Función by()
La siguiente tabla resume los argumentos principales de la función by() para mayor claridad:
| Argumento | Descripción | Ejemplo en el Comando |
|---|---|---|
data |
El objeto de datos (usualmente data frame o matriz) al que se aplicará la función. | R[,6:8] |
INDICES |
Un factor o lista de factores que definen cómo agrupar los datos. | R$Género |
FUN |
La función que se aplicará a cada subconjunto de datos. | summary |
... |
Argumentos adicionales que se pasarán a la función FUN. |
(No se usan en este comando) |
simplify |
Un valor lógico (TRUE/FALSE) que indica si el resultado debe simplificarse si es posible. Por defecto es TRUE. | (Usa el valor por defecto TRUE) |
Visualizando el Contexto: Mapa Mental
Para comprender mejor dónde encaja el comando by() dentro del ecosistema de R y su relación con otros conceptos, el siguiente mapa mental puede ser útil:
Este mapa ilustra cómo el comando utiliza funciones del paquete base para realizar análisis agrupados, y menciona algunas alternativas populares en otros paquetes de R.
Ejemplo Práctico
Para ilustrar cómo funciona by(), usemos el conocido conjunto de datos iris que viene incluido en R. Supongamos que queremos ver el resumen estadístico de las longitudes y anchuras de sépalos y pétalos (columnas 1 a 4) para cada especie de flor.
# Cargar el dataset iris (ya está en R base)
data(iris)

# Ver las primeras filas y estructura
head(iris)
str(iris)

# Aplicar by() para obtener resúmenes por especie
resumen_por_especie <- by(iris[, 1:4], iris$Species, summary)

# Imprimir el resultado
print(resumen_por_especie)
La salida mostrará tres secciones, una para cada Species (setosa, versicolor, virginica), y dentro de cada sección, el resumen estadístico (Min, Q1, Median, Mean, Q3, Max) para las cuatro variables numéricas (Sepal.Length, Sepal.Width, Petal.Length, Petal.Width).
Comparativa: Base R vs. Alternativas
Si bien by() es una función base útil, el ecosistema de R, especialmente a través del tidyverse (con dplyr) y data.table, ofrece alternativas modernas y a menudo más potentes o flexibles para operaciones agrupadas.
Alternativa con dplyr
El paquete dplyr proporciona los verbos group_by() y summarise() (o summarize()) que realizan tareas similares, a menudo con una sintaxis considerada más legible y coherente dentro del flujo de trabajo del tidyverse.
# Instalar dplyr si no lo tienes: install.packages("dplyr")
library(dplyr)

# Equivalente usando dplyr para el ejemplo de iris
resumen_dplyr <- iris %>%
  group_by(Species) %>%
  summarise(across(Sepal.Length:Petal.Width, summary))

# Imprimir resultado (la estructura de salida es diferente, más tipo 'tibble')
print(resumen_dplyr)
Mientras que by() pertenece al paquete base y no requiere instalación, dplyr es un paquete externo que debe instalarse y cargarse.
Radar de Comparación (Subjetivo)
El siguiente gráfico compara subjetivamente las funciones base de R (como by/tapply) con las alternativas populares dplyr y data.table en varias dimensiones relevantes para el análisis de datos.
Este gráfico sugiere que, si bien las funciones base son fáciles de usar inicialmente y no tienen dependencias, dplyr a menudo ofrece mejor legibilidad y data.table destaca en rendimiento con grandes volúmenes de datos, aunque ambos pueden tener curvas de aprendizaje más pronunciadas y requieren paquetes externos.
Preguntas Frecuentes (FAQ)
¿Necesito instalar algo para usar el comando by()?
No. La función by(), así como la función summary(), forman parte del paquete base de R. Este paquete se carga automáticamente al iniciar R o RStudio, por lo que no se requiere ninguna instalación ni carga explícita mediante library().
¿Qué hace exactamente la función `summary()` en este contexto?
La función summary() calcula estadísticas descriptivas básicas para cada una de las columnas seleccionadas (R[,6:8]) dentro de cada grupo definido por R$Género. Para columnas numéricas, proporciona el mínimo, máximo, cuartiles (Q1, Q3), mediana y media. Si hubiera columnas de tipo factor (categóricas) entre la 6 y la 8, mostraría el conteo de cada categoría.
¿Es `by()` la única forma de agrupar y resumir datos en R?
No, existen varias alternativas. Dentro del paquete base, la función tapply() realiza una tarea similar, y by() es en parte un envoltorio para ella. Paquetes externos muy populares como dplyr (con group_by() y summarise()) y data.table (usando la sintaxis DT[...]) ofrecen funcionalidades equivalentes o más avanzadas, a menudo con mejor rendimiento para grandes conjuntos de datos y una sintaxis diferente.
¿Qué significa la parte `R[,6:8]` del comando?
Esta es la notación estándar de R para seleccionar subconjuntos de un data frame (o matriz). R es el nombre del data frame. El corchete [] se usa para indexar. Dentro del corchete, la coma , separa las dimensiones (filas, columnas). Al dejar el espacio antes de la coma vacío ([,]), se seleccionan todas las filas. El 6:8 después de la coma indica que se seleccionan las columnas desde la 6 hasta la 8 (inclusive). Por lo tanto, R[,6:8] extrae todas las filas pero únicamente las columnas 6, 7 y 8 del data frame R.
Consultas Recomendadas
- ¿Cómo usar group_by y summarise en dplyr para análisis agrupado en R?
- ¿Cuál es la diferencia entre by() y tapply() en R?
- ¿Cuáles son las mejores prácticas para resumir datos en R?
- ¿Cómo manejar variables de tipo factor en R para agrupación?
Referencias
Last updated April 28, 2025