
利用AI强化学习彻底改变免疫应答:从头生成T细胞受体序列
探索结合深度生成模型与强化学习,设计具有特定功能的TCR序列,加速免疫疗法发展。
核心洞见
- 强化学习 (RL) 优化: RL 不仅能生成TCR序列,更能通过奖励机制引导生成过程,优化序列以获得特定功能(如高亲和力、高特异性)。
- 生成模型协同: 深度生成模型(如Transformer、自回归模型)学习TCR序列的复杂模式,为RL优化提供高质量的候选序列基础。
- 精准靶向设计: 结合RL和生成模型,可以针对特定抗原(如癌细胞表位)设计全新的TCR序列,为个性化免疫疗法开辟新途径。
免疫系统的“哨兵”:T细胞受体 (TCR)
T细胞受体(TCR)是免疫系统中T细胞表面的关键蛋白,它们如同高度特异性的“哨兵”,负责识别并结合由主要组织相容性复合体(MHC)分子呈递的抗原肽片段。这种识别是启动适应性免疫应答的核心环节,使免疫系统能够精确打击被感染的细胞或癌细胞。
TCR的多样性极其巨大,主要来源于V(D)J基因片段的随机重组过程,尤其是在互补决定区3(CDR3)。这个区域直接参与抗原肽的识别,其序列的细微变化就能显著影响TCR的结合特异性和亲和力。正是这种巨大的多样性,使得免疫系统能够应对几乎无限种类的病原体和异常细胞。

T细胞受体结构及其与抗原肽-MHC复合物相互作用示意图
从头生成 (De Novo Generation) 的挑战
尽管TCR对免疫疗法(如CAR-T、TCR-T细胞疗法)和疫苗设计至关重要,但从海量的天然TCR库中筛选或通过传统实验方法设计具有特定抗原识别能力的TCR序列,面临巨大挑战:
- 序列空间巨大: 理论上可能的TCR序列数量是天文数字,搜索难度极大。
- 功能预测困难: 序列与其功能(特别是与特定抗原的结合能力)之间的关系复杂,难以直接预测。
- 实验成本高昂: 湿实验验证过程耗时费力,成本高昂。
因此,开发能够高效、准确地从头生成具有所需功能的TCR序列的计算方法,成为该领域的前沿研究方向。
强强联合:生成模型与强化学习
为了应对上述挑战,研究人员开始探索结合深度生成模型和强化学习(RL)的策略。这两种技术各有所长,结合使用可以实现优势互补。
生成模型:学习TCR的“语言”
深度生成模型,特别是借鉴自然语言处理领域的模型(如Transformer、自回归模型如GPT、变分自编码器VAE),在学习复杂序列数据的内在模式方面表现出色。它们可以:
- 学习概率分布: 从大规模真实的TCR序列数据(如通过高通量测序获得)中学习序列的底层语法和结构,构建TCR序列的概率分布模型。
- 生成新序列: 基于学习到的分布,生成与真实TCR序列相似的新序列,为后续优化提供大量候选。
- 条件生成: 结合抗原肽信息,尝试生成可能与特定抗原结合的TCR序列。例如,GRATCR模型就利用预训练的表位编码器和TCR生成器进行特异性生成。
强化学习:引导生成走向“功能”
虽然生成模型能产生看似合理的TCR序列,但无法保证这些序列具备特定的生物学功能(如高效识别目标抗原)。这时,强化学习就能发挥其优化能力。
强化学习框架
在TCR序列生成任务中,RL框架通常这样设定:
- 智能体 (Agent): 生成或修改TCR序列的模型(可以是生成模型本身,或一个独立的优化策略)。
- 环境 (Environment): 模拟生物学现实,评估生成的TCR序列的质量。这通常通过计算预测模型(如预测结合亲和力、稳定性、免疫原性的模型)或与实验数据的交互来实现。
- 状态 (State): 当前正在生成或已被修改的TCR序列(或其表示)。
- 动作 (Action): 在序列生成任务中,通常是选择下一个氨基酸;在序列优化任务中,可以是替换、插入或删除某个氨基酸。
- 奖励 (Reward): 基于生成的TCR序列的功能性评估给予的信号。奖励函数的设计至关重要,需要反映期望的特性,例如:
- 与目标抗原肽的高结合亲和力预测得分。
- 与非目标抗原肽的低结合亲和力(特异性)。
- 序列的预测稳定性。
- 与已知功能性TCR序列的相似性。
- 生成序列的多样性(避免模式崩溃)。
智能体的目标是通过不断尝试(探索)和利用已知的有效策略(利用),学习一个最优策略(Policy),以最大化长期累积奖励,从而生成功能更优的TCR序列。
关于 "GRPO"
您提到的“GRPO”可能指代某类基于策略梯度(Policy Gradient)的强化学习算法,例如广义策略优化(Generalized Policy Optimization)或类似的变体。虽然“GRPO”并非此领域广泛使用的标准缩写,但其核心思想——通过优化策略来指导生成过程——是共通的。
目前,更常被引用的、应用于TCR优化和生成的RL框架包括:
- TCRPPO: 利用近端策略优化(Proximal Policy Optimization, PPO)算法来优化TCR序列,使其识别效率更高。PPO是一种稳定且高效的策略梯度方法。
- TCR-GPT: 结合了自回归生成模型(类似GPT)和强化学习。先由生成模型产生序列,再通过RL调整生成分布,使其倾向于生成能识别特定肽段的TCR。
这些方法本质上都是利用RL的优化能力,引导序列生成朝着具有特定生物学功能的目标前进。
关键框架与方法比较
当前存在多种结合AI进行TCR设计的方法,各有侧重。下表比较了几个代表性框架/思路:
| 框架/思路 | 核心技术 | 主要目标 | 关键优势 | 潜在挑战 |
|---|---|---|---|---|
| TCR-GPT | 自回归模型 + 强化学习 (RL) | 生成能识别特定肽段的TCR序列 | 结合生成能力和RL优化,端到端生成功能性序列 | 依赖高质量配对数据,RL训练稳定性 |
| TCRPPO | 强化学习 (PPO) + 突变策略 | 优化现有或生成的TCR序列以提高识别效率 | 专注于优化,RL策略高效稳定 | 可能需要初始序列作为起点,奖励函数设计复杂 |
| GRATCR (类比) | 预训练 (BERT/GPT) + 微调/嫁接 | 生成针对特定表位的TCR序列 | 数据高效,利用预训练知识 | 更侧重生成,对RL优化依赖较少(但可结合) |
| 通用RL优化 | 各种RL算法 (如PPO, DQN等) | 根据特定奖励函数优化TCR序列 | 灵活性高,可定制奖励函数 | 需要明确定义环境和奖励,计算成本可能较高 |
不同AI驱动TCR设计方法的比较
这些方法并非完全独立,实践中常常相互借鉴或结合。例如,可以使用类似GRATCR的方法初步生成候选序列,再利用TCRPPO的思想进行优化。
可视化理解:过程与评估
RL引导的TCR生成工作流
下面的思维导图展示了利用强化学习进行TCR序列生成的基本流程:
利用强化学习生成TCR序列的概念流程图
多维度评估TCR设计方法
评估一个TCR设计方法的优劣需要从多个维度考量。下面的雷达图基于综合分析,比较了几种关键属性在不同策略下的侧重程度(评分越高代表该方面表现越突出或越受重视,评分基于定性分析而非精确数据)。
不同TCR设计策略关键属性比较雷达图 (示意)
这个图表帮助我们理解不同方法的设计哲学和侧重点。例如,纯粹的RL优化可能在亲和力和特异性上表现突出,而结合生成模型的方法可能在序列多样性上更有优势。选择哪种方法取决于具体的应用需求和可用资源。
实践步骤与考量
要成功实施基于RL的TCR序列生成,需要考虑以下关键步骤:
1. 数据获取与准备
高质量的数据是基础。需要收集:
- 大规模TCR序列数据: 来自公共数据库(如iReceptor, VDJdb)或内部测序项目,用于预训练生成模型。
- TCR-抗原肽配对数据: 已知的TCR序列及其识别的特定抗原肽信息,对于训练和评估至关重要。
- 功能性数据(可选): 实验测定的结合亲和力、稳定性、交叉反应性等数据,可用于构建更准确的奖励函数或评估模型。
数据清洗、标准化和预处理是确保模型性能的关键步骤。
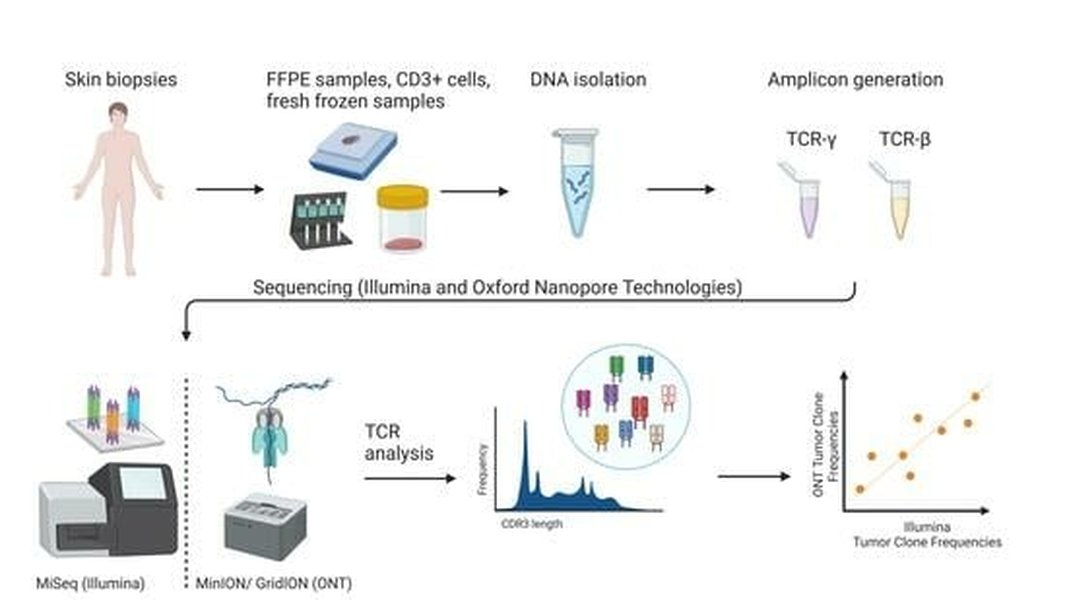
TCR测序数据分析是获取训练数据的基础
2. 模型架构选择与训练
- 生成模型: 选择合适的架构,如Transformer或基于RNN的模型,进行预训练,学习TCR序列的基本模式。
- RL智能体: 设计策略网络,可以是生成模型本身或一个独立的网络。选择合适的RL算法(如PPO)进行训练。
3. 设计有效的奖励函数
这是RL中最具挑战性但也最关键的一步。奖励函数需要精确反映期望的TCR特性。可以整合多个预测模型的分数:
- 使用pMTnet、TEINet等模型预测TCR-肽结合亲和力。
- 使用蛋白质结构预测和能量计算工具评估稳定性。
- 考虑与已知功能性序列的相似度、避免产生免疫原性的潜在模式等。
奖励函数需要仔细调整权重和形式,以平衡不同目标(如亲和力 vs 特异性)。
4. 验证与迭代
生成的TCR序列必须经过验证:
- 计算验证 (In Silico): 使用独立的预测工具评估性能。
- 实验验证 (Wet Lab): 这是最终确认功能的金标准,包括合成TCR、进行体外结合实验、在细胞模型中测试功能等。
根据验证结果,可能需要返回调整模型架构、奖励函数或训练过程,进行迭代优化。
优势与挑战并存
为何选择强化学习?
- 目标导向优化: RL能够直接针对复杂的功能性目标(通过奖励函数定义)进行优化,而不仅仅是模仿现有数据分布。
- 探索广阔空间: RL的探索机制有助于发现传统方法难以触及的新颖且功能优越的序列。
- 效率提升: 相较于纯粹的随机搜索或大规模湿实验筛选,计算驱动的生成和优化能显著提高效率。
- 精准设计: 可以针对特定抗原(如肿瘤新抗原)设计高度特异性的TCR,推动个性化免疫疗法。
强化学习等AI技术正加速生物医学发现
面临的挑战
- 数据依赖性: 高质量、大规模的TCR序列及功能数据是模型成功的关键,尤其是有标注的配对数据。
- 奖励函数设计: 如何设计既能准确反映生物学目标又易于优化的奖励函数是一个难题。
- 计算资源: 训练大型生成模型和RL智能体需要强大的计算能力。
- 验证瓶颈: 计算生成的序列最终仍需实验验证,这仍然是时间和成本的限制因素。
- 模型可解释性: 理解模型为何生成特定序列及其功能机制仍有待深入研究。
常见问题解答 (FAQ)
参考文献
- TCR-GPT: Integrating Autoregressive Model and Reinforcement Learning for TCR generation - arXiv
- T-Cell Receptor Optimization with Reinforcement Learning and Mutation Policies (TCRPPO) - SpringerLink
- T-Cell Receptor Optimization with Reinforcement Learning and Mutation Policies for Precision Immunotherapy - arXiv
- GRATCR: epitope-specific T cell receptor sequence generation with data-efficient pre-trained models - bioRxiv
- Learning the continuous landscape of T cell receptor sequence space using generative models - Nature Communications
- Deep generative models for functional protein sequence generation: a survey of methods and challenges - IEEE Xplore
推荐探索
Last updated April 26, 2025