
Das Geheimnis von STOCK_IND_L2: Wie SAP S/4HANA Bestandsindikatoren intelligent berechnet
Eine Tiefenanalyse der Berechnung, Geschäftsregeln und Replikationsmöglichkeiten von STOCK_IND_L2 in der MATDOC_EXTRACT-Tabelle.
Die Spalte STOCK_IND_L2 in der SAP-Tabelle MATDOC_EXTRACT spielt eine entscheidende Rolle im modernen Bestandsmanagement von SAP S/4HANA. Sie ist Teil des New Simplified Data Model (NSDM) und dient der Optimierung von Bestandsberechnungen. Das Verständnis ihrer Funktionsweise, der zugrundeliegenden Geschäftsregeln und wie ihre Logik potenziell nachgebildet werden kann, ist für Entwickler und Berater gleichermaßen wichtig.
Wichtige Erkenntnisse auf einen Blick
- Performance-Optimierung:
MATDOC_EXTRACT, einschließlichSTOCK_IND_L2, wurde entwickelt, um die Performance von Bestandsaggregationen in S/4HANA durch Vorverdichtung von Daten aus derMATDOC-Tabelle signifikant zu verbessern. - Abgeleiteter Indikator:
STOCK_IND_L2ist kein direkt berechnetes Feld im herkömmlichen Sinne, sondern ein Indikator, der während der Materialbuchung und durch periodische Kompaktierungsprozesse basierend auf komplexen Geschäftsregeln abgeleitet und inMATDOC_EXTRACTgespeichert wird. - Kontextabhängige Logik: Die Werte von
STOCK_IND_L2hängen von einer Vielzahl von Faktoren ab, darunter Bewegungsarten, Bestandsarten, Sonderbestände und Systemeinstellungen, deren genaue Logik tief in SAP-Standardprozessen verankert ist.
Die Rolle von MATDOC_EXTRACT und STOCK_IND_L2 im Detail
In SAP S/4HANA hat sich das Datenmodell für das Bestandsmanagement grundlegend geändert. Die Tabelle MATDOC ist nun die zentrale Tabelle für alle Materialbelege und ersetzt die früheren Tabellen MKPF (Belegkopf) und MSEG (Belegsegment). Um die Performance bei der Auswertung von Bestandsdaten zu gewährleisten, wurde die Tabelle MATDOC_EXTRACT eingeführt.
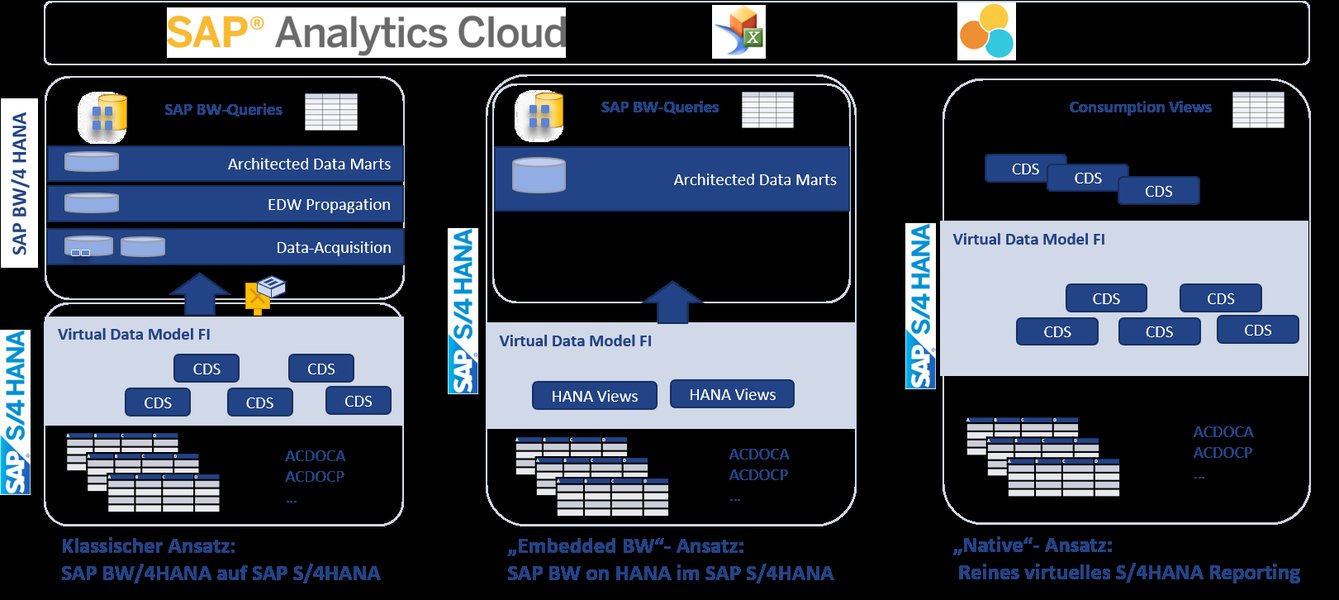
Architekturübersicht im SAP S/4HANA Umfeld, die die Bedeutung optimierter Datentabellen wie MATDOC_EXTRACT unterstreicht.
MATDOC_EXTRACT: Der Schlüssel zur schnellen Bestandsanalyse
MATDOC_EXTRACT ist eine kondensierte und aggregierte Version der MATDOC-Tabelle. Ihr Hauptzweck ist es, "On-the-fly"-Berechnungen von Lagerbeständen zu beschleunigen. Anstatt bei jeder Abfrage die riesigen Datenmengen der MATDOC-Tabelle vollständig zu durchsuchen und zu aggregieren, greifen viele Standardberichte und Kompatibilitätsviews (z.B. für die alte Tabelle MARD) auf die vorverdichteten Daten in MATDOC_EXTRACT zurück. Datensätze werden parallel zur MATDOC-Tabelle in MATDOC_EXTRACT eingefügt und durch periodische "Precompacting"-Prozesse (z.B. beim Periodenabschluss mit Transaktion MMPV) weiter verdichtet.
STOCK_IND_L2: Ein feingranularer Bestandsindikator
Die Spalte STOCK_IND_L2 in MATDOC_EXTRACT ist ein Bestandsindikator auf einer zweiten Ebene (Level 2). Sie hat den Datentyp CHAR(1) und ist mit dem Datenelement NSDM_STOCK_IND_L2 verknüpft. Dieser Indikator ermöglicht eine feinere Differenzierung des Bestandsstatus als traditionelle Indikatoren. Er wird verwendet, um Materialbestände spezifischer zu klassifizieren, was für Aggregationen und Filterungen in Core Data Services (CDS)-Views und anderen Auswertungen genutzt wird. Ein häufiges Muster in CDS-Views ist beispielsweise eine Bedingung wie WHERE stock_ind_l2 = '', was darauf hindeutet, dass bestimmte Werte (oder das Fehlen eines spezifischen Wertes) für Standardaggregationen relevant sind.
Geschäftsregeln, die den Wert von STOCK_IND_L2 beeinflussen
Die genaue Logik zur Ableitung von STOCK_IND_L2 ist nicht explizit als Formel dokumentiert, da sie Teil der internen Verarbeitungslogik von SAP S/4HANA ist. Der Wert wird dynamisch auf Basis einer Kombination von Geschäftsregeln und Daten aus dem Materialbeleg bestimmt. Zu den wichtigsten Einflussfaktoren gehören:
Bewegungsarten (BWART)
Jede Materialbewegung (z.B. Wareneingang, Warenausgang, Umlagerung, Verbrauchsbuchung) wird durch eine Bewegungsart klassifiziert. Unterschiedliche Bewegungsarten können zu unterschiedlichen STOCK_IND_L2-Werten führen, da sie den Bestandsstatus auf spezifische Weise verändern.
Bestandsarten und Sonderbestandsindikatoren (SOBKZ)
Der Status des Bestands (z.B. frei verfügbarer Bestand, Qualitätsprüfbestand, gesperrter Bestand) ist entscheidend. Auch Sonderbestände wie Konsignationsbestand, Kundenbeistellbestand oder Projektbestand, die durch den Sonderbestandsindikator (SOBKZ) in MATDOC gekennzeichnet sind, beeinflussen die Logik. Oftmals deutet ein leerer STOCK_IND_L2-Wert darauf hin, dass es sich um Standardbestände ohne besondere Kennzeichnung handelt.
Organisatorische Ebenen
Buchungskreis, Werk und Lagerort, an dem die Materialbewegung stattfindet, können ebenfalls die Bestimmung von STOCK_IND_L2 beeinflussen, da hier spezifische Konfigurationen oder Regeln greifen können.
Qualitätsmanagement-Status
Falls das Qualitätsmanagement aktiv ist, kann der QM-Status eines Materials (z.B. ob es sich in der Qualitätsprüfung befindet) die Zuordnung des STOCK_IND_L2-Wertes mitbestimmen.
Periodenabschluss und Kompaktierungsprozesse
Wie bereits erwähnt, wird MATDOC_EXTRACT durch periodische Kompaktierungsprozesse (Precompacting) aktualisiert. Diese Prozesse aggregieren ältere Bewegungsdaten und können dabei auch die Werte in STOCK_IND_L2 konsolidieren oder anpassen, um die Performance zu optimieren.
Nachbildung der STOCK_IND_L2-Logik auf Basis der MATDOC-Tabelle
Eine exakte 1:1-Nachbildung der STOCK_IND_L2-Berechnung ist eine komplexe Aufgabe, da die proprietäre SAP-Logik nicht vollständig offengelegt ist. Dennoch kann man sich annähern, indem man die Prinzipien versteht und die relevanten Daten aus der MATDOC-Tabelle analysiert.
Schlüsselschritte zur Replikation
Um die Logik hinter STOCK_IND_L2 basierend auf MATDOC nachzubilden, sind folgende Schritte denkbar:
- Identifizierung relevanter Felder in MATDOC: Analysieren Sie die
MATDOC-Tabelle auf Felder, die den Bestandsstatus beeinflussen. Dazu gehören typischerweise:MATERIAL(Materialnummer)WERKS(Werk)LGORT(Lagerort)BWART(Bewegungsart)SOBKZ(Sonderbestandsindikator)STOCK_QTY(oder äquivalente Mengenfelder)- Felder, die den Bestandsstatus direkt angeben (z.B. frei, gesperrt, QM)
- Buchungsdatum und Belegdatum zur zeitlichen Abgrenzung
- Analyse von SAP Standard-CDS-Views: Untersuchen Sie SAP-Standard-CDS-Views (z.B.
NSDM_V_MARD_AGG,nsdm_e_mard_agg), dieMATDOC_EXTRACTverwenden. Die Filterbedingungen und Aggregationslogiken in diesen Views können Aufschluss über die Verwendung und Bedeutung vonSTOCK_IND_L2geben. - Entwicklung einer regelbasierten Zuordnung: Basierend auf den Erkenntnissen muss ein Regelwerk definiert werden, das Kombinationen von
MATDOC-Feldern (insbesondere Bewegungsart, Bestandsart, Sonderbestandskennzeichen) auf plausibleSTOCK_IND_L2-Werte abbildet. Diese Logik wäre wahrscheinlich eine komplexe Fallunterscheidung. - Aggregation der Daten: Die Daten aus
MATDOCmüssen aggregiert werden, ähnlich wie esMATDOC_EXTRACTtut. Dies beinhaltet das Summieren von Mengen unter Berücksichtigung der Bewegungsrichtung (Zugänge positiv, Abgänge negativ) und Gruppierung nach den relevanten Kriterien. - Implementierung (z.B. ABAP oder SQL): Die entwickelte Logik kann mittels ABAP-Programmierung oder direkter SQL-Skripte (insbesondere in einer HANA-Datenbankumgebung) umgesetzt werden.
Konzeptuelles Beispiel für eine Replikationslogik
Die folgende ABAP-artige Pseudocode-Struktur illustriert, wie eine vereinfachte Logik aussehen könnte. Beachten Sie, dass dies stark vereinfacht ist und die tatsächliche SAP-Logik wesentlich komplexer ist.
REPORT z_replicate_stock_ind_l2.

TYPES: BEGIN OF ty_matdoc_data,
         material TYPE matnr,
         werks    TYPE werks_d,
         lgort    TYPE lgort_d,
         sobkz    TYPE sobkz,
         bwart    TYPE bwart,
         menge    TYPE menge_d,
         stock_ind_l2 TYPE nsdm_stock_ind_l2,
       END OF ty_matdoc_data.

DATA: lt_matdoc_input TYPE STANDARD TABLE OF matdoc, " Angenommen, MATDOC-Daten sind hier
      lt_aggregated_data TYPE STANDARD TABLE OF ty_matdoc_data.

FIELD-SYMBOLS: <ls_input>    TYPE matdoc,
               <ls_aggregated> TYPE ty_matdoc_data.

* 1. Daten aus MATDOC selektieren (vereinfacht)
SELECT * FROM matdoc INTO TABLE @lt_matdoc_input. " Ggf. mit Zeitabgrenzung

LOOP AT lt_matdoc_input ASSIGNING <ls_input>.
  APPEND INITIAL LINE TO lt_aggregated_data ASSIGNING <ls_aggregated>.
  <ls_aggregated>-material = <ls_input>-matnr.
  <ls_aggregated>-werks = <ls_input>-werks.
  <ls_aggregated>-lgort = <ls_input>-lgort_d. " Beispielhaftes Mapping
  <ls_aggregated>-sobkz = <ls_input>-sobkz.
  <ls_aggregated>-bwart = <ls_input>-bwart.
  <ls_aggregated>-menge = <ls_input>-menge. " Beispielhaftes Mengenfeld

  * 2. Regelbasierte Zuweisung für STOCK_IND_L2 (stark vereinfacht)
  IF <ls_input>-sobkz IS INITIAL AND
     ( <ls_input>-bwart = '101' OR <ls_input>-bwart = '501' ). " Wareneingang Standard
    <ls_aggregated>-stock_ind_l2 = ''. " Standardindikator
  ELSEIF <ls_input>-sobkz = 'K' AND <ls_input>-bwart = '101'. " Konsignationseingang
    <ls_aggregated>-stock_ind_l2 = 'K'. " Beispiel für Konsi-Indikator
  ELSE.
    <ls_aggregated>-stock_ind_l2 = 'X'. " Anderer Fall
  ENDIF.
ENDLOOP.

* 3. Weitere Aggregation und Verdichtung wären hier notwendig,
*    z.B. Summierung der Mengen pro Material, Werk, Lagerort und STOCK_IND_L2.
*    Dies würde dem "Precompacting" von MATDOC_EXTRACT nahekommen.

* Ausgabe der Ergebnisse (Beispiel)
LOOP AT lt_aggregated_data ASSIGNING <ls_aggregated>.
  WRITE: / <ls_aggregated>-material, <ls_aggregated>-werks, <ls_aggregated>-lgort, <ls_aggregated>-stock_ind_l2, <ls_aggregated>-menge.
ENDLOOP.
Eine SQL-basierte Annäherung könnte CASE-Anweisungen innerhalb einer GROUP BY-Klausel verwenden, um den simulated_stock_ind_l2 basierend auf Feldern wie sobkz und bwart zu bestimmen und dann Mengen zu aggregieren.
Visuelle Darstellung der Einflussfaktoren
Die Komplexität und die verschiedenen Einflussfaktoren auf STOCK_IND_L2 lassen sich gut in einem Diagramm darstellen. Das folgende Radar-Diagramm visualisiert die relative Bedeutung und Komplexität verschiedener Aspekte, die bei der Bestimmung und Replikation von STOCK_IND_L2 eine Rolle spielen.
Dieses Diagramm verdeutlicht, dass insbesondere die Logik der Sonderbestände und die spezifische Systemkonfiguration einen hohen Einfluss haben und gleichzeitig komplex in der Nachbildung sind.
Abhängigkeiten bei der Ermittlung von STOCK_IND_L2
Die Ermittlung von STOCK_IND_L2 ist ein mehrstufiger Prozess, der von verschiedenen Datenquellen und Regeln abhängt. Die folgende Mindmap illustriert diese Abhängigkeiten von den Quelldaten in MATDOC bis hin zur Nutzung in MATDOC_EXTRACT.
Ermittlung & Nutzung"] id1["MATDOC Quelldaten"] id1_1["Material (MATNR)"] id1_2["Werk (WERKS)"] id1_3["Lagerort (LGORT)"] id1_4["Bewegungsart (BWART)"] id1_5["Sonderbestandskennzeichen (SOBKZ)"] id1_6["Bestandsmenge & -art"] id1_7["QM-Informationen"] id1_8["Buchungsdatum"] id2["Geschäftsregeln & Logik"] id2_1["SAP Standardlogik (intern)"] id2_2["Abbildung Bewegungsart auf Bestandsstatus"] id2_3["Behandlung von Sonderbeständen"] id2_4["QM-Status Einfluss"] id2_5["Periodenabschluss-Logik"] id2_6["Kundenspezifische Anpassungen (potenziell)"] id3["MATDOC_EXTRACT Ziel"] id3_1["Speicherung von STOCK_IND_L2"] id3_2["Voraggregierte Bestandsmengen (STOCK_QTY_L2)"] id3_3["Voraggregierte Bestandswerte (STOCK_VKWRT_L2)"] id3_4["Nutzung in CDS-Views"] id3_5["Performance-Optimierung für Berichte"] id4["Replikationsansatz (falls benötigt)"] id4_1["Analyse MATDOC Felder"] id4_2["Definition abgeleiteter Regeln"] id4_3["Aggregation & Transformation"] id4_4["Implementierung (ABAP/SQL)"] id4_5["Validierung gegen SAP Verhalten"]
Diese Mindmap zeigt, wie Felder aus der MATDOC-Tabelle durch Geschäftsregeln interpretiert werden, um den STOCK_IND_L2-Wert zu bestimmen, der dann in MATDOC_EXTRACT für schnelle Auswertungen genutzt wird.
Vergleichstabelle: MATDOC vs. MATDOC_EXTRACT in Bezug auf STOCK_IND_L2
Die folgende Tabelle stellt die Unterschiede und Beziehungen zwischen MATDOC und MATDOC_EXTRACT im Kontext von STOCK_IND_L2 dar:
| Merkmal | MATDOC | MATDOC_EXTRACT | Relevanz für STOCK_IND_L2 |
|---|---|---|---|
| Primärer Zweck | Transaktionale Materialbelegdaten (alle Details) | Performance-optimierte Bestandsaggregation | MATDOC_EXTRACT leitet STOCK_IND_L2 aus MATDOC-Details ab. |
| Datengranularität | Einzelpostendetail | Aggregierte/Verdichtete Daten | STOCK_IND_L2 hilft bei der Kategorisierung für die Aggregation. |
| Schlüsselfelder für Bestand | BWART, SOBKZ, MENGE, WERKS, LGORT etc. |
STOCK_QTY_L2, STOCK_VKWRT_L2, STOCK_IND_L2 etc. |
STOCK_IND_L2 ist eines dieser Schlüsselaggregationsfelder. |
| Aktualisierungsfrequenz | Echtzeit pro Transaktion | Echtzeit-Einfügung + periodische Verdichtung ("Precompacting") | STOCK_IND_L2 wird bei der Einfügung befüllt und durch Verdichtung potenziell beeinflusst. |
| Herkunft von STOCK_IND_L2 | N/A (Quelldaten) | Abgeleitet/befüllt basierend auf MATDOC-Einträgen und Regeln |
Dies ist das Feld, um das es geht; es existiert in dieser Tabelle. |
| Abfrageperformance für Bestände | Potenziell langsam für vollständige historische Aggregation | Schnell aufgrund von Voraggregation | STOCK_IND_L2 trägt zu dieser optimierten Abfrageperformance bei. |
Häufig gestellte Fragen (FAQ)
Was ist der Hauptzweck der Spalte STOCK_IND_L2?
STOCK_IND_L2 dient als feingranularer Bestandsindikator in der Tabelle MATDOC_EXTRACT. Er hilft, Bestände für performanceoptimierte Aggregationen und Auswertungen in SAP S/4HANA spezifischer zu klassifizieren und zu filtern, insbesondere in CDS-Views und Standardberichten.
Ist die genaue Berechnungsformel für STOCK_IND_L2 öffentlich dokumentiert?
Nein, die exakte, detaillierte Berechnungslogik oder Formel für STOCK_IND_L2 ist nicht öffentlich von SAP dokumentiert. Sie ist Teil der internen, proprietären Logik des SAP S/4HANA Bestandsmanagements und des New Simplified Data Model (NSDM). Die Werte werden basierend auf einer Kombination von Materialbewegungsdaten und Konfigurationen abgeleitet.
Welche Rolle spielt der Precompacting-Prozess für STOCK_IND_L2?
Der Precompacting-Prozess, der typischerweise beim Periodenabschluss (z.B. über Transaktion MMPV) ausgeführt wird, verdichtet die Daten in MATDOC_EXTRACT. Dies dient der Performance-Optimierung, indem ältere Datensätze aggregiert werden. STOCK_IND_L2 ist Teil dieser aggregierten Datensätze und seine Verteilung kann durch diesen Prozess beeinflusst werden, um konsistente und performante Auswertungen zu gewährleisten.
Kann STOCK_IND_L2 benutzerdefiniert angepasst werden?
Die direkte benutzerdefinierte Anpassung der Logik, wie STOCK_IND_L2 befüllt wird, ist im SAP-Standard in der Regel nicht vorgesehen, da es sich um ein systeminternes Feld zur Performanceoptimierung handelt. Indirekt kann die Befüllung durch die Konfiguration von Bewegungsarten, Bestandsarten oder durch Erweiterungen (BAdIs) im Materialbuchungsprozess beeinflusst werden, dies erfordert jedoch tiefgreifende Kenntnisse und sollte mit Vorsicht erfolgen.
Warum wird STOCK_IND_L2 = '' oft in Abfragen verwendet?
Die Bedingung STOCK_IND_L2 = '' (ein leerer Wert) wird in vielen Standard-CDS-Views und Abfragen verwendet, um "normale" oder Standard-Lagerbestände zu selektieren. Dies impliziert, dass Datensätze ohne einen spezifischen STOCK_IND_L2-Wert oft den Hauptteil des frei verfügbaren oder unkritischen Bestands repräsentieren, während andere Werte (z.B. 'K' für Konsignation) für spezielle Bestandscharakteristika reserviert sind.
Empfohlene weiterführende Suchanfragen
- Wie funktionieren CDS-Views für das Bestandsreporting in SAP S/4HANA?
- Welche Rolle spielt die Tabelle MATDOC im New Simplified Data Model von SAP S/4HANA?
- Details zum Precompacting-Prozess für MATDOC_EXTRACT in SAP S/4HANA
- Unterschiede im Datenmodell des Bestandsmanagements zwischen SAP ECC und SAP S/4HANA
Referenzen
Last updated May 20, 2025