
Scala czy Rust: Który Język Zdominuje Przyszłość Inżynierii Danych?
Dogłębna analiza potencjału Scali i Rusta w dynamicznie zmieniającym się świecie Data Engineering na rok 2025.
Wybór odpowiedniego języka programowania jest kluczową decyzją w każdym projekcie z zakresu inżynierii danych. W obliczu rosnących wolumenów danych, zapotrzebowania na przetwarzanie w czasie rzeczywistym i konieczności zapewnienia bezpieczeństwa oraz wydajności, deweloperzy i architekci systemów stają przed dylematem: postawić na sprawdzone rozwiązania czy zainwestować w technologie zyskujące na popularności? Na dzień 6 maja 2025 roku, zarówno Scala, jak i Rust, odgrywają istotne role, ale ich trajektorie rozwoju i postrzeganie "przyszłościowości" w Data Engineering znacząco się różnią.
Najważniejsze Wnioski: Scala vs. Rust w Inżynierii Danych
- Rust zyskuje na znaczeniu jako język do tworzenia wysokowydajnych i bezpiecznych komponentów backendowych w inżynierii danych, podczas gdy Scala utrzymuje silną pozycję w ekosystemach opartych na JVM, zwłaszcza w kontekście Apache Spark.
- Python i SQL prawdopodobnie pozostaną głównymi językami interfejsu API wykorzystywanymi przez inżynierów danych, z Rustem i Scalą pełniącymi role specjalistyczne.
- Wybór między Scalą a Rustem często zależy od specyfiki projektu, wymagań dotyczących wydajności, istniejącej infrastruktury oraz długoterminowej wizji rozwoju systemu.
Scala: Weteran Ekosystemów Big Data
Scala, język programowania działający na Wirtualnej Maszynie Javy (JVM), od lat cieszy się uznaniem w świecie przetwarzania dużych zbiorów danych. Jego siła tkwi w połączeniu paradygmatów programowania obiektowego i funkcyjnego, co oferuje programistom elastyczność i ekspresyjność.
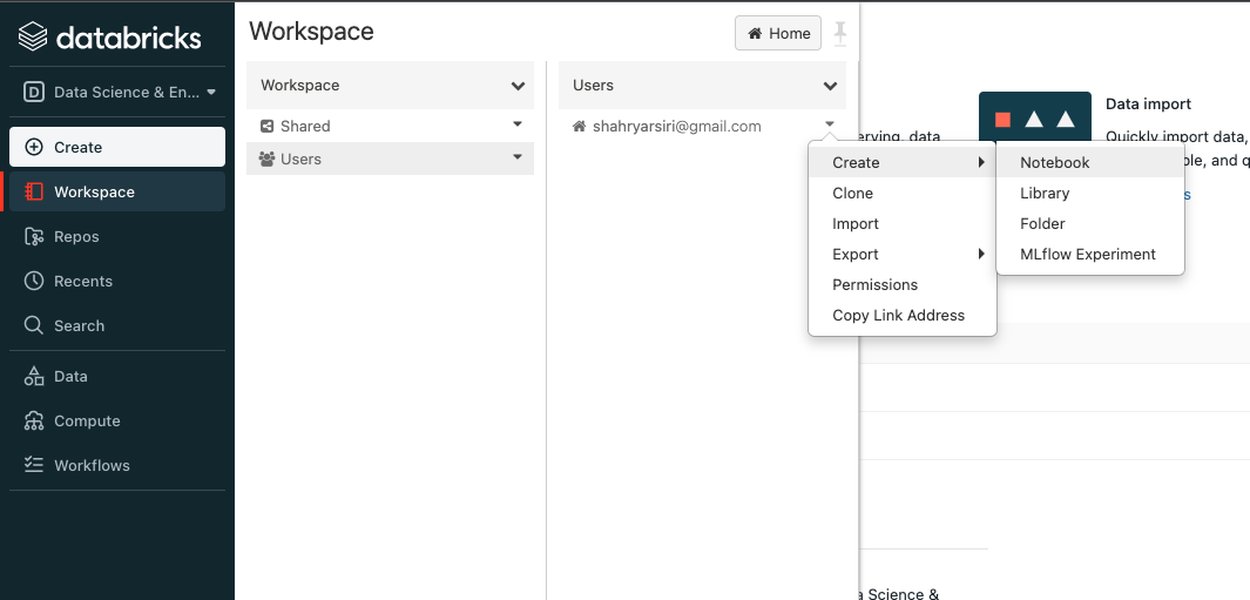
Prototypowanie i budowanie kodu Scala Spark w notatnikach Databricks.
Mocne Strony Scali
Dominacja w Ekosystemie Apache Spark
Scala jest językiem pierwszego wyboru dla Apache Spark, jednego z najważniejszych frameworków do przetwarzania danych na dużą skalę. Ta ścisła integracja zapewnia naturalną przewagę w projektach Big Data, gdzie Spark stanowi rdzeń architektury.
Hybrydowy Model Programowania
Możliwość płynnego łączenia cech programowania funkcyjnego (np. niemutowalność, funkcje wyższego rzędu) z podejściem obiektowym daje programistom potężne narzędzia do modelowania skomplikowanych logik przetwarzania danych.
Dojrzałość i Ekosystem JVM
Dzięki działaniu na JVM, Scala ma dostęp do ogromnej liczby bibliotek Javy oraz korzysta ze stabilności i dojrzałości tej platformy. To ułatwia integrację z istniejącymi systemami i narzędziami.
Wyzwania dla Scali
Krzywa Uczenia
Scala, szczególnie z jej zaawansowanymi koncepcjami funkcyjnymi, może stanowić wyzwanie dla programistów nieznających tego paradygmatu. Opanowanie jej subtelności wymaga czasu i wysiłku.
Narzędzia i Konfiguracja Środowiska
Choć sytuacja ulega poprawie, konfiguracja środowiska programistycznego dla Scali i zarządzanie zależnościami bywają postrzegane jako mniej przyjazne użytkownikowi w porównaniu do niektórych nowszych języków.
Dynamika Popularności
Mimo swojej ugruntowanej pozycji, w ostatnich latach obserwuje się pewne osłabienie dynamiki wzrostu popularności Scali w niektórych obszarach Data Engineering, częściowo na rzecz Pythona i rosnącego zainteresowania Rustem dla specyficznych zastosowań.
Rust: Wschodząca Gwiazda Wydajności i Bezpieczeństwa
Rust to stosunkowo młodszy język programowania systemowego, który zdobywa coraz większe uznanie dzięki swojemu naciskowi na szybkość, bezpieczeństwo pamięci i współbieżność. Jego unikalny model własności i pożyczania (ownership and borrowing) eliminuje wiele typowych błędów związanych z zarządzaniem pamięcią, takich jak wyścigi danych czy dangling pointers, i to wszystko na etapie kompilacji, bez potrzeby użycia garbage collectora.
Integracja Rust dla wysokowydajnego przetwarzania danych w ekosystemie Delta Lake.
Mocne Strony Rusta
Niezrównana Wydajność i Kontrola Pamięci
Rust kompiluje się do natywnego kodu maszynowego, co zapewnia wydajność porównywalną z C/C++. Brak garbage collectora i precyzyjna kontrola nad alokacją pamięci czynią go idealnym wyborem dla komponentów systemów wymagających minimalnych opóźnień i wysokiej przepustowości.
Gwarancje Bezpieczeństwa Pamięci
System własności Rusta jest jego cechą charakterystyczną. Gwarantuje on, że dane mutowalne są posiadane i modyfikowane tylko przez jeden wątek naraz, co jest sprawdzane statycznie w czasie kompilacji i eliminuje całą klasę błędów współbieżności.
Doskonałe Wsparcie dla Współbieżności
Rust oferuje "fearless concurrency" – mechanizmy pozwalające pisać bezpieczny i wydajny kod współbieżny bez obaw o typowe pułapki programowania wielowątkowego.
Rosnący Ekosystem dla Inżynierii Danych
Choć ekosystem Rusta dla Data Engineering jest młodszy niż Scali, dynamicznie się rozwija. Projekty takie jak DataFusion (część Apache Arrow w Rust, mająca na celu zastąpienie węzłów roboczych Sparka), Polars (wysokowydajna biblioteka do manipulacji ramkami danych) czy integracje z Delta Lake pokazują rosnące znaczenie Rusta w tej dziedzinie, szczególnie w budowie narzędzi backendowych i silników przetwarzania.
Wyzwania dla Rusta
Stroma Krzywa Uczenia
Unikalny system własności i pożyczania, choć potężny, wymaga od programistów zmiany sposobu myślenia o zarządzaniu pamięcią i może być początkowo trudny do opanowania.
Młodszy Ekosystem Specyficzny dla DE
W porównaniu do Scali i Pythona, Rust wciąż ma mniej gotowych bibliotek i frameworków dedykowanych bezpośrednio analizie danych czy kompleksowym potokom ETL. Obecnie częściej jest wykorzystywany do tworzenia narzędzi wspierających lub krytycznych pod względem wydajności komponentów istniejących systemów.
Integracja z Istniejącymi Systemami
Wiele programów Rust w Data Engineering przez długi czas będzie wymagać wrapperów Pythona, aby zintegrować się z istniejącymi potokami danych, które są w większości oparte na Pythonie.
Scala kontra Rust: Porównanie i Perspektywy na Przyszłość
Decyzja o wyborze między Scalą a Rustem w kontekście inżynierii danych nie jest jednoznaczna i zależy od wielu czynników. Poniżej przedstawiamy kluczowe aspekty porównania oraz prognozy na przyszłość.
Film analizujący porównanie języków Python, Scala i Rust w kontekście inżynierii danych, omawiający ich mocne i słabe strony oraz przypadki użycia.
Tabela Porównawcza: Scala vs. Rust w Inżynierii Danych
Poniższa tabela podsumowuje kluczowe różnice i cechy obu języków w kontekście zastosowań w inżynierii danych:
| Cecha | Scala | Rust | Kluczowe Różnice |
|---|---|---|---|
| Główne Zastosowanie w DE | Przetwarzanie Big Data (Apache Spark, Hadoop), systemy oparte na JVM. | Wysokowydajne komponenty backendowe, narzędzia systemowe, przetwarzanie strumieniowe, silniki baz danych. | Scala dominuje w istniejących ekosystemach Spark; Rust zyskuje w nowych, wydajnościowo krytycznych narzędziach. |
| Wydajność | Dobra dzięki JVM, ale z narzutem garbage collectora. | Doskonała, porównywalna z C/C++, brak GC. | Rust oferuje znacznie wyższą i bardziej przewidywalną wydajność. |
| Bezpieczeństwo Pamięci | Zarządzane przez JVM (garbage collection); możliwe problemy typowe dla GC. | Gwarantowane w czasie kompilacji przez system własności, brak GC. | Rust zapewnia wyższy poziom bezpieczeństwa pamięci bez kosztów runtime. |
| Ekosystem Narzędzi DE | Bardzo dojrzały i bogaty, zwłaszcza wokół Sparka i ekosystemu Hadoop. | Dynamicznie rosnący, z obiecującymi projektami jak DataFusion, Polars; silny w narzędziach systemowych. | Scala ma przewagę w gotowych rozwiązaniach Big Data; Rust szybko nadrabia w obszarze fundamentalnych bibliotek i narzędzi. |
| Krzywa Uczenia | Umiarkowana do stromej, szczególnie aspekty funkcyjne. | Stroma, głównie ze względu na system własności i pożyczania. | Oba języki wymagają znaczącego nakładu pracy, ale z różnych powodów. |
| Wsparcie dla Współbieżności | Dobre, oparte na modelach JVM (np. Akka). | Doskonałe, z "fearless concurrency" wbudowanym w język. | Rust oferuje bardziej fundamentalne i bezpieczne mechanizmy współbieżności. |
| Trendy Rozwoju i Popularność | Stabilna pozycja, ale mniejszy impet wzrostu; postrzegana jako bardziej niszowa. | Dynamiczny wzrost popularności, uznawany za "język przyszłości" w wielu dziedzinach, w tym w komponentach DE. | Rust wykazuje znacznie większą dynamikę wzrostu i zainteresowania społeczności. |
Wizualne Porównanie Atrybutów
Poniższy wykres radarowy przedstawia subiektywną ocenę Scali i Rusta w kluczowych kategoriach istotnych dla inżynierii danych. Skala ocen od 1 (słabo) do 10 (doskonale).
Wykres ten ilustruje, że Rust przoduje w kategoriach wydajności i bezpieczeństwa pamięci oraz dynamiki rozwoju, podczas gdy Scala ma silniejszą pozycję w dojrzałości i ekosystemie specyficznym dla Big Data. Krzywa uczenia dla obu języków jest stroma, choć z różnych powodów.
Mapa Myśli: Scala i Rust w Ekosystemie Inżynierii Danych
Poniższa mapa myśli przedstawia relacje i kluczowe aspekty Scali oraz Rusta w kontekście inżynierii danych, uwzględniając ich mocne i słabe strony oraz ogólny kontekst technologiczny.
Hadoop)"] idS_P2["Dojrzałość w JVM"] idS_P3["Hybryda OO i FP"] idS_P4["Integracja z Javą"] idS_M["Minusy"] idS_M1["Stroma krzywa uczenia"] idS_M2["Mniejszy impet wzrostu"] idS_M3["Narzędzia i konfiguracja"] idR["Rust"] idR_P["Plusy"] idR_P1["Najwyższa wydajność"] idR_P2["Bezpieczeństwo pamięci (brak GC)"] idR_P3["Rosnąca popularność i społeczność"] idR_P4["Narzędzia backendowe (np. DataFusion
Polars)"] idR_P5["Świetna obsługa współbieżności"] idR_M["Minusy"] idR_M1["Nowszy w Data Engineering"] idR_M2["Mniej bibliotek analitycznych"] idR_M3["Stroma krzywa uczenia (system własności)"] idC["Kontekst Ogólny"] idC1["Python/SQL jako główne języki API"] idC2["Wybór zależny od projektu"] idC3["Rust dla komponentów niskopoziomowych
i wydajności krytycznej"] idC4["Scala dla istniejących systemów Spark
i ekosystemów JVM"] idC5["Rosnąca dywersyfikacja narzędzi w DE"]
Mapa myśli ukazuje, że oba języki mają swoje nisze i mocne strony. Scala jest głęboko zakorzeniona w tradycyjnych systemach Big Data, podczas gdy Rust napędza innowacje w obszarze wydajnych, bezpiecznych komponentów systemowych.
Podsumowanie Perspektyw
Na dzień 6 maja 2025 roku, Rust wydaje się mieć większy impet jako język przyszłościowy dla budowy nowych, wydajnych i bezpiecznych komponentów niskiego poziomu w inżynierii danych. Jego zdolność do zastępowania części systemów napisanych w C/C++ lub nawet komponentów opartych na JVM (jak sugerują projekty typu DataFusion mające na celu zastąpienie workerów Sparka) czyni go strategicznym wyborem dla firm dążących do optymalizacji i skalowalności.
Nie oznacza to jednak końca Scali. Pozostaje ona kluczowym językiem w dojrzałych ekosystemach Big Data, zwłaszcza tam, gdzie Apache Spark jest fundamentem. Istniejące systemy i zespoły ze specjalizacją w Scali będą nadal ją wykorzystywać. Co więcej, Scala 3 wprowadziła ulepszenia mające na celu uczynienie języka bardziej spójnym i przyjaznym.
Ostatecznie, krajobraz inżynierii danych staje się coraz bardziej zróżnicowany. Python prawdopodobnie utrzyma swoją pozycję jako główny język skryptowy i interfejsowy, podczas gdy Rust będzie coraz częściej wybierany do zadań wymagających maksymalnej wydajności i bezpieczeństwa. Scala znajdzie swoje miejsce w utrzymaniu i rozwoju istniejących, dużych systemów przetwarzania danych.
Warto zauważyć, że wiele narzędzi pisanych w Rust będzie posiadać wrappery Pythona, co umożliwi łatwą integrację z istniejącymi potokami danych i wykorzystanie zalet Rusta bez konieczności przepisywania całych systemów.
FAQ: Scala vs. Rust w Inżynierii Danych
Czy Rust całkowicie zastąpi Scalę w inżynierii danych?
Jest to mało prawdopodobne w najbliższej przyszłości. Scala ma ugruntowaną pozycję w ekosystemach Big Data, zwłaszcza z Apache Spark, i wiele istniejących systemów opiera się na tym języku. Rust zyskuje na popularności jako język do tworzenia wysokowydajnych komponentów backendowych i narzędzi, potencjalnie zastępując niektóre elementy, ale nie całe ekosystemy Scali. Oba języki będą prawdopodobnie współistnieć, pełniąc różne role.
W jakich sytuacjach Scala jest wciąż lepszym wyborem niż Rust?
Scala pozostaje silnym wyborem w projektach głęboko zintegrowanych z ekosystemem Apache Spark i Hadoop, gdzie jej dojrzałość, bogactwo bibliotek i wsparcie dla JVM są kluczowe. Jest również dobrym wyborem, gdy zespół ma już doświadczenie w Scali lub programowaniu funkcyjnym na JVM. W przypadku dużych, istniejących systemów opartych na Scali, kontynuacja rozwoju w tym języku jest często najbardziej praktycznym podejściem.
Jaką rolę odgrywa Python w kontekście wyboru między Scalą a Rustem?
Python, wraz z SQL, prawdopodobnie pozostanie dominującym językiem interfejsu API i "klejem" dla wielu potoków danych. Zarówno komponenty napisane w Scali (np. zadania Spark), jak i w Rust (np. szybkie moduły przetwarzające) często będą integrowane i zarządzane z poziomu Pythona. Rust jest często postrzegany jako język do tworzenia wysokowydajnych rozszerzeń dla Pythona, poprawiających wydajność w krytycznych miejscach.
Czy trudno jest nauczyć się Rusta w porównaniu do Scali?
Oba języki mają stromą krzywą uczenia, ale z różnych powodów. Scala wymaga zrozumienia paradygmatów funkcyjnych i obiektowych oraz ekosystemu JVM. Rust z kolei stawia wyzwanie poprzez swój unikalny system własności i pożyczania, który jest kluczowy dla bezpieczeństwa pamięci. Wybór "trudniejszego" języka zależy od wcześniejszych doświadczeń programisty; oba wymagają jednak znacznego zaangażowania, aby osiągnąć biegłość.
Rekomendowane Zapytania
Aby zgłębić temat, rozważ poniższe zapytania:
- Jakie są najlepsze frameworki Rust do przetwarzania danych w 2025 roku?
- Porównanie wydajności Apache Spark w Scali vs DataFusion w Rust.
- Przyszłość programowania funkcyjnego w inżynierii danych poza Scalą.
- Jak integrować komponenty Rust z istniejącymi potokami danych w Pythonie?
Referencje
Last updated May 6, 2025