
Svelare i Nodi Complessi: Le Molteplici Sfide dell'Apprendimento Federato
Un'analisi approfondita degli ostacoli che l'apprendimento federato deve superare per rivoluzionare l'IA preservando la privacy.
Punti Chiave da Considerare
- La privacy non è un dato di fatto: Sebbene l'apprendimento federato (FL) sia progettato per proteggere i dati grezzi mantenendoli locali, gli aggiornamenti del modello scambiati possono involontariamente rivelare informazioni sensibili, richiedendo sofisticate contromisure.
- L'eterogeneità regna sovrana: La diversità intrinseca dei dispositivi client (in termini di capacità computazionali, connettività) e dei loro dati (spesso non indipendenti e identicamente distribuiti, o non-IID) pone sfide significative alla stabilità e all'efficacia dell'addestramento del modello globale.
- La comunicazione è un collo di bottiglia critico: Il trasferimento continuo di aggiornamenti del modello tra i client e il server (o tra peer) può essere estremamente costoso in termini di larghezza di banda e latenza, limitando la scalabilità e l'efficienza dei sistemi FL.
Introduzione: La Promessa dell'Apprendimento Federato
L'Apprendimento Federato (FL) emerge come un paradigma rivoluzionario nell'ambito dell'intelligenza artificiale e del machine learning. Il suo principio fondamentale è addestrare modelli di machine learning in modo collaborativo su dati distribuiti su una moltitudine di dispositivi (come smartphone, ospedali, o organizzazioni diverse) senza che questi dati debbano mai lasciare la loro sede originale. Questo approccio decentralizzato offre un enorme potenziale per sbloccare insight preziosi da vasti dataset, mantenendo al contempo un elevato grado di privacy e sicurezza dei dati sensibili. Immagina di poter migliorare i modelli predittivi per la diagnosi medica utilizzando dati da numerosi ospedali, senza che nessun dato paziente venga centralizzato. Tuttavia, la realizzazione pratica di questa visione è costellata di sfide complesse che toccano aspetti tecnici, di sicurezza, di privacy e di efficienza.
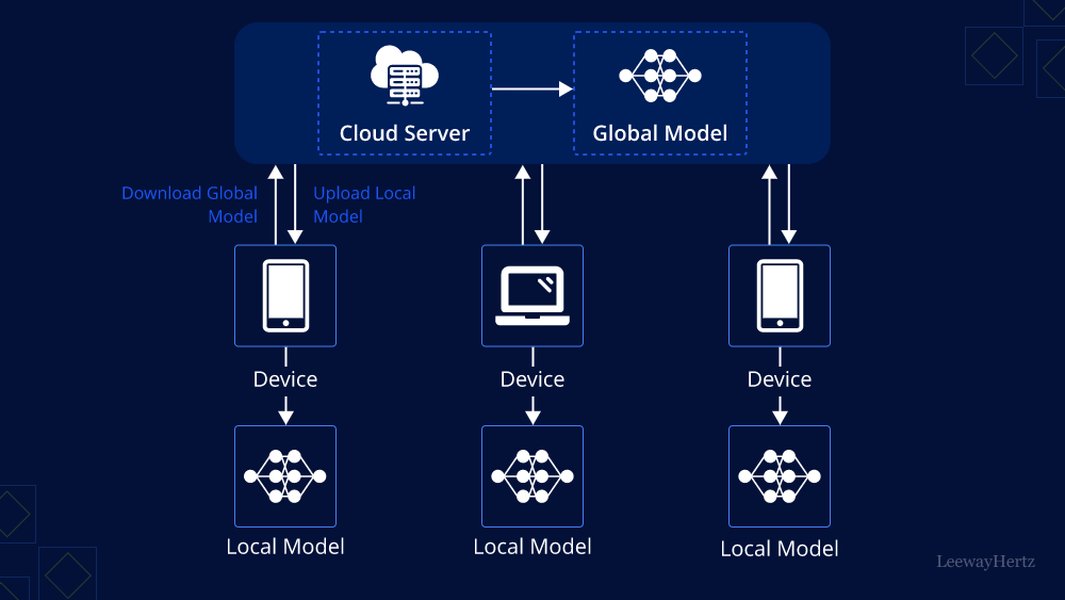
Schema concettuale dell'Apprendimento Federato che mostra i dati locali sui dispositivi e gli aggiornamenti del modello inviati a un server centrale per l'aggregazione.
Le Sfide Cruciali dell'Apprendimento Federato
Nonostante le sue promesse, l'implementazione su larga scala dell'apprendimento federato si scontra con una serie di ostacoli significativi. Queste sfide devono essere comprese e affrontate per sfruttare appieno il potenziale di questa tecnologia.
Eterogeneità: Un Duplice Ostacolo
L'eterogeneità è una caratteristica intrinseca degli ambienti di apprendimento federato e si manifesta su due fronti principali: i dati e i sistemi.
Eterogeneità Statistica dei Dati (Non-IID)
I dati conservati sui dispositivi client sono raramente Indipendenti e Identicamente Distribuiti (Non-IID). Questo significa che la distribuzione dei dati, la loro quantità e la loro qualità possono variare drasticamente da un client all'altro. Ad esempio, nell'ambito sanitario, i dati di un ospedale potrebbero riflettere una demografia specifica o patologie prevalenti diverse da quelle di un altro. Questa eterogeneità statistica può portare a un modello globale "sbilanciato", con prestazioni scadenti per alcune sottopopolazioni, e può rendere più difficile la convergenza del processo di addestramento verso una soluzione ottimale. Affrontare la sfida dei dati non-IID è cruciale per garantire che il modello federato sia equo ed efficace per tutti i partecipanti.
Eterogeneità dei Sistemi Client
I dispositivi che partecipano a una rete di apprendimento federato possono variare enormemente in termini di capacità computazionali (CPU, RAM), storage disponibile, durata della batteria e stabilità della connessione di rete. Smartphone, sensori IoT e server aziendali presentano profili hardware e software molto diversi. Questa eterogeneità sistemica complica la gestione del processo di addestramento: dispositivi più lenti ("stragglers") possono rallentare interi round di addestramento, e la disconnessione improvvisa di client può interrompere il loro contributo. È necessario sviluppare algoritmi robusti che possano tollerare questa variabilità e scalare efficacemente su hardware eterogeneo, garantendo una partecipazione equa ed efficiente.

Illustrazione della diversità dei dispositivi (client) che partecipano a un sistema di Apprendimento Federato, evidenziando l'eterogeneità del sistema.
Comunicazione: Il Tallone d'Achille
La comunicazione tra i client e il server centrale (o tra i peer in architetture decentralizzate) è una componente fondamentale ma anche una delle maggiori fonti di inefficienza nel FL.
Costi Elevati e Larghezza di Banda
In ogni round di addestramento, i client devono inviare gli aggiornamenti del loro modello locale (gradienti o pesi) al server per l'aggregazione, e successivamente ricevere il modello globale aggiornato. Questo scambio di informazioni, specialmente con modelli complessi e un gran numero di partecipanti, può consumare una quantità significativa di larghezza di banda e introdurre latenze considerevoli. In contesti con connessioni di rete instabili o limitate (come su dispositivi mobili o IoT), questi costi di comunicazione possono rendere l'FL impraticabile o estremamente lento, limitandone la scalabilità e l'applicabilità nel mondo reale.
Strategie di Ottimizzazione della Comunicazione
Per mitigare l'impatto dei costi di comunicazione, la ricerca si concentra su diverse strategie. Queste includono tecniche di compressione degli aggiornamenti del modello (ad esempio, quantizzazione o sparsificazione) per ridurre la quantità di dati trasmessi, la selezione intelligente dei client che partecipano a ogni round, e l'aggiornamento meno frequente o asincrono dei modelli. Tuttavia, queste tecniche spesso introducono un compromesso tra efficienza della comunicazione e accuratezza del modello finale.
Privacy: Un Equilibrio Delicato
Sebbene l'FL sia stato concepito primariamente per migliorare la privacy, non la garantisce in modo assoluto. La protezione dei dati sensibili rimane una preoccupazione centrale.
Rischi di Fuga di Informazioni (Privacy Leakage)
Anche se i dati grezzi non lasciano mai i dispositivi locali, le informazioni scambiate (gli aggiornamenti del modello) possono, in determinate circostanze, essere sfruttate da un avversario per inferire dati sensibili sui dati di addestramento originali. Attacchi di inferenza di appartenenza (membership inference), di ricostruzione dei dati (data reconstruction) o di estrazione di proprietà (property inference) hanno dimostrato che è possibile estrarre una sorprendente quantità di informazioni private. Questo è particolarmente vero se l'avversario ha accesso agli aggiornamenti di un singolo utente o può osservare le variazioni del modello globale nel tempo.

Diagramma che illustra il ciclo di base dell'Apprendimento Federato: addestramento locale, invio degli aggiornamenti e aggregazione centrale.
Tecniche di Potenziamento della Privacy (PETs) e Loro Compromessi
Per rafforzare le garanzie di privacy, l'FL viene spesso combinato con Tecnologie per il Potenziamento della Privacy (PETs). Le più comuni includono:
- Differential Privacy (DP): Aggiunge rumore statistico controllato agli aggiornamenti del modello o ai dati prima dell'addestramento, rendendo difficile per un avversario distinguere il contributo di un singolo utente. Tuttavia, l'introduzione di rumore può degradare l'accuratezza del modello.
- Crittografia Omomorfica (HE): Consente di eseguire calcoli (come l'aggregazione) direttamente sui dati crittografati, senza decifrarli. Questo offre una forte protezione, ma comporta un notevole sovraccarico computazionale.
- Secure Multi-Party Computation (SMPC): Permette a più parti di calcolare congiuntamente una funzione sui loro input privati senza rivelare tali input l'una all'altra. Come l'HE, può essere computazionalmente intensiva.
Sicurezza: Minacce nel Mondo Decentralizzato
La natura distribuita dell'FL introduce nuove vulnerabilità di sicurezza che possono compromettere l'integrità del modello globale e l'affidabilità del processo di addestramento.
Tipologie di Attacchi alla Sicurezza
I sistemi FL possono essere bersaglio di diversi tipi di attacchi, spesso perpetrati da client malintenzionati o compromessi:
- Poisoning Attacks (Avvelenamento dei Dati/Modello): I client malevoli possono manipolare i loro dati di addestramento locali (data poisoning) o gli aggiornamenti del modello che inviano (model poisoning) per degradare le prestazioni del modello globale o per introdurre specifici comportamenti errati.
- Backdoor Attacks (Attacchi Backdoor): Un attaccante può tentare di inserire una "backdoor" nel modello globale. Questa backdoor fa sì che il modello si comporti normalmente sulla maggior parte degli input, ma produca output specifici e dannosi quando riceve un input trigger predefinito dall'attaccante.
- Byzantine Attacks: Client malintenzionati (o difettosi) possono inviare aggiornamenti arbitrari o dannosi al server di aggregazione, con l'obiettivo di sabotare il processo di apprendimento o di corrompere il modello globale.
Robustezza dell'Aggregazione e Difese
Per contrastare queste minacce, sono necessarie tecniche di aggregazione robuste che possano identificare e mitigare l'impatto di aggiornamenti malevoli o anomali. Questo include algoritmi che pesano o scartano i contributi sospetti. Inoltre, meccanismi di verifica dell'identità dei client e di auditing dei modelli possono contribuire a migliorare la sicurezza complessiva del sistema FL.
Qualità del Modello, Scalabilità e Aspetti Operativi
Oltre alle sfide principali di eterogeneità, comunicazione, privacy e sicurezza, esistono altre considerazioni importanti.
Convergenza, Bias e Generalizzazione
L'eterogeneità dei dati (non-IID) può rallentare la convergenza del modello globale o portarlo a convergere verso soluzioni subottimali. Inoltre, se i dati locali di alcuni client non sono rappresentativi della popolazione target complessiva, il modello aggregato può ereditare e persino amplificare questi bias, portando a risultati ingiusti o inaccurati per determinati gruppi di utenti. Garantire che il modello generalizzi bene a dati mai visti e sia equo rimane un'area di ricerca attiva.
Scalabilità e Gestione Pratica
Gestire sistemi FL con un numero elevato di dispositivi (potenzialmente milioni) presenta sfide significative in termini di coordinamento, sincronizzazione degli aggiornamenti e gestione dei fallimenti dei client. Anche la valutazione realistica delle prestazioni degli algoritmi FL è complessa, data la difficoltà di creare banchi di prova standardizzati che riflettano la diversità degli scenari del mondo reale.
Conformità Normativa e Incentivi
Sebbene l'FL aiuti a rispettare normative sulla privacy come il GDPR, la conformità deve essere attentamente considerata. Inoltre, per garantire una partecipazione continua e onesta dei client, specialmente in contesti commerciali, possono essere necessari modelli di incentivi e meccanismi per costruire fiducia tra i partecipanti.
Tabella Riepilogativa: Tipologie di Attacchi e Rischi nel Federated Learning
Comprendere le potenziali minacce è fondamentale per costruire sistemi di apprendimento federato robusti. La tabella seguente riassume alcuni dei principali attacchi e rischi discussi:
| Categoria di Rischio | Tipo Specifico | Descrizione | Impatto Potenziale |
|---|---|---|---|
| Attacchi alla Sicurezza (Integrità del Modello) | Poisoning Attacks | Client malintenzionati forniscono dati di addestramento corrotti o manipolati, o aggiornamenti del modello alterati. | Degradazione delle prestazioni del modello globale, introduzione di bias specifici, predizioni errate. |
| Backdoor Attacks | Inserimento di funzionalità nascoste e malevole nel modello, attivate da input specifici. | Il modello si comporta in modo anomalo o dannoso solo per input trigger, altrimenti appare normale. | |
| Byzantine Attacks | Client (malintenzionati o guasti) inviano aggiornamenti arbitrari, corrotti o contraddittori al server. | Sabotaggio del processo di aggregazione, corruzione del modello globale, instabilità dell'apprendimento. | |
| Attacchi alla Privacy (Riservatezza dei Dati) | Attacchi di Inferenza di Appartenenza (Membership Inference) | Un avversario cerca di determinare se un specifico record di dati è stato utilizzato nel training set di un client. | Rivelazione della partecipazione di dati sensibili all'addestramento. |
| Attacchi di Ricostruzione dei Dati (Data Reconstruction) | Tentativi di ricostruire, parzialmente o totalmente, i dati di addestramento originali a partire dagli aggiornamenti del modello o dal modello stesso. | Esposizione diretta di dati sensibili e privati dei client. | |
| Attacchi di Estrazione di Proprietà (Property Inference) | Deduzione di proprietà aggregate o statistiche sui dati di addestramento di un client che non erano intese per essere pubbliche. | Rivelazione di pattern o caratteristiche sensibili presenti nei dati locali. |
Visualizzazione delle Complessità: Le Sfide a Confronto
Per fornire una prospettiva visiva sulla natura multidimensionale delle sfide nel Federated Learning, il seguente grafico radar illustra la percezione della loro severità in termini di "Impatto sulla Performance del Modello" e "Complessità della Soluzione/Mitigazione". Valori più alti indicano un impatto o una complessità maggiori. Si noti che questa è una valutazione qualitativa basata sull'attuale stato della ricerca.
Questo grafico evidenzia come sfide quali l'eterogeneità dei dati, i rischi per la privacy e le minacce alla sicurezza siano percepite come particolarmente impattanti e complesse da risolvere, richiedendo sforzi di ricerca significativi e soluzioni innovative.
Mappa Mentale: Una Visione d'Insieme delle Sfide
Per cogliere la natura interconnessa delle sfide dell'apprendimento federato, la seguente mappa mentale ne offre una rappresentazione strutturata, evidenziando le principali categorie di problemi e le loro diramazioni.
qualità variabile,
sbilanciamento)"] id1b["Sistemi Client (Hardware,
Software, Connessione,
Disponibilità)"] id2["Comunicazione"] id2a["Costi Elevati (Banda)"] id2b["Latenza Significativa"] id2c["Overhead per Modelli Complessi"] id2d["Necessità di Compressione
e Ottimizzazione"] id3["Privacy"] id3a["Attacchi di Inferenza
(Membership, Property)"] id3b["Ricostruzione Dati Sensibili"] id3c["Compromessi con Tecniche
di Protezione (DP, HE, SMPC)"] id3d["Identificazione e Anonimizzazione"] id4["Sicurezza"] id4a["Poisoning Attacks
(Data & Model)"] id4b["Backdoor Attacks"] id4c["Byzantine Attacks/Failures"] id4d["Sybil Attacks"] id4e["Aggregazione Robusta"] id5["Qualità e Affidabilità del Modello"] id5a["Convergenza Lenta o Subottimale"] id5b["Bias e Equità (Fairness)"] id5c["Generalizzazione su Nuovi Dati"] id5d["Robustezza ad Attacchi Adversarial"] id6["Scalabilità e Gestione Operativa"] id6a["Coordinamento di Migliaia/Milioni di Client"] id6b["Gestione dei Client 'Straggler'
e Disconnessioni"] id6c["Valutazione Realistica e Benchmarking"] id6d["Mancanza di Standardizzazione"] id7["Aspetti Sociali e Regolamentari"] id7a["Conformità Normativa (es. GDPR)"] id7b["Incentivi per la Partecipazione Onesta"] id7c["Fiducia e Trasparenza del Sistema"] id7d["Interpretabilità dei Modelli Federati"]
Questa mappa mentale illustra come le diverse sfide non siano isolate, ma spesso si influenzino a vicenda, richiedendo un approccio olistico per la loro risoluzione.
Approfondimento Video: Le Sfide del Federated Learning
Per un'ulteriore disamina di alcune delle sfide chiave nell'apprendimento federato, come la potenziale fuga di informazioni private (privacy leakage) e la gestione di dati etichettati in modo insufficiente (label deficiency), il seguente video offre spunti interessanti. Questi aspetti sono cruciali perché toccano direttamente l'affidabilità e la praticità delle soluzioni FL in scenari reali, dove la qualità e la completezza dei dati locali possono variare enormemente.
Il video discute come, nonostante i dati rimangano locali, le informazioni trasmesse per aggiornare il modello globale possano essere vulnerabili e come la mancanza di etichette accurate e sufficienti sui dati distribuiti possa ostacolare l'addestramento di modelli performanti. Queste sono considerazioni vitali per chiunque intenda implementare o sviluppare tecnologie di apprendimento federato.
Domande Frequenti (FAQ)
Cos'è esattamente l'eterogeneità dei dati (non-IID) nel FL?
L'apprendimento federato garantisce la privacy al 100%?
Quali sono le principali tecniche per mitigare i rischi di privacy nel FL?
Come influiscono i costi di comunicazione sull'efficacia del FL?
Qual è la differenza tra un attacco di poisoning e un attacco backdoor nel FL?
Letture Consigliate per Approfondire
- Quali sono le soluzioni emergenti per superare le sfide dell'apprendimento federato?
- Come funziona la differential privacy nel contesto del federated learning e quali sono i suoi limiti?
- Quali sono le applicazioni pratiche di successo dell'apprendimento federato nonostante le sue sfide?
- Esistono architetture di apprendimento federato completamente decentralizzate e quali vantaggi offrono rispetto all'approccio client-server?
Riferimenti
Last updated May 10, 2025