
Раскрываем секреты SQL: Как найти совпадения Ф.И.О. между разными базами данных?
Полное руководство по SQL-запросам для эффективного сопоставления имен в ваших данных, от точных совпадений до интеллектуального поиска.
Сравнение записей Ф.И.О. (Фамилия, Имя, Отчество) между двумя различными базами данных или таблицами — частая задача в управлении данными, интеграции систем или анализе. SQL предоставляет мощные инструменты для этой цели, позволяя находить точные совпадения, частичные вхождения и даже учитывать возможные расхождения в написании. Этот материал подробно осветит различные методики SQL-запросов, которые помогут вам эффективно решить эту задачу.
Ключевые моменты для эффективного сравнения Ф.И.О.
- Определите структуру хранения Ф.И.О.: Имена могут храниться как единая строка или в отдельных столбцах (Фамилия, Имя, Отчество), что влияет на подход к запросу.
- Выберите подходящий метод сравнения: В зависимости от задачи, вам может потребоваться точное совпадение, поиск по части строки или более сложные алгоритмы нечеткого поиска.
- Учитывайте производительность: На больших объемах данных неоптимизированные запросы могут выполняться очень долго. Использование индексов и выбор правильных операторов критически важны.
Понимание структуры данных Ф.И.О.
Прежде чем приступить к написанию SQL-запросов, важно понять, как Ф.И.О. представлены в ваших базах данных. Существует два основных подхода:
- Ф.И.О. в отдельных столбцах: Например, таблицы могут содержать поля
LastName,FirstName,MiddleName. Этот формат более структурирован и облегчает точное сравнение по компонентам. - Ф.И.О. в одном столбце: Например, поле
FullNameсодержит строку "Иванов Иван Иванович". Этот вариант требует использования функций работы со строками для сравнения или разбора.
Знание структуры позволит выбрать наиболее эффективный метод сравнения.
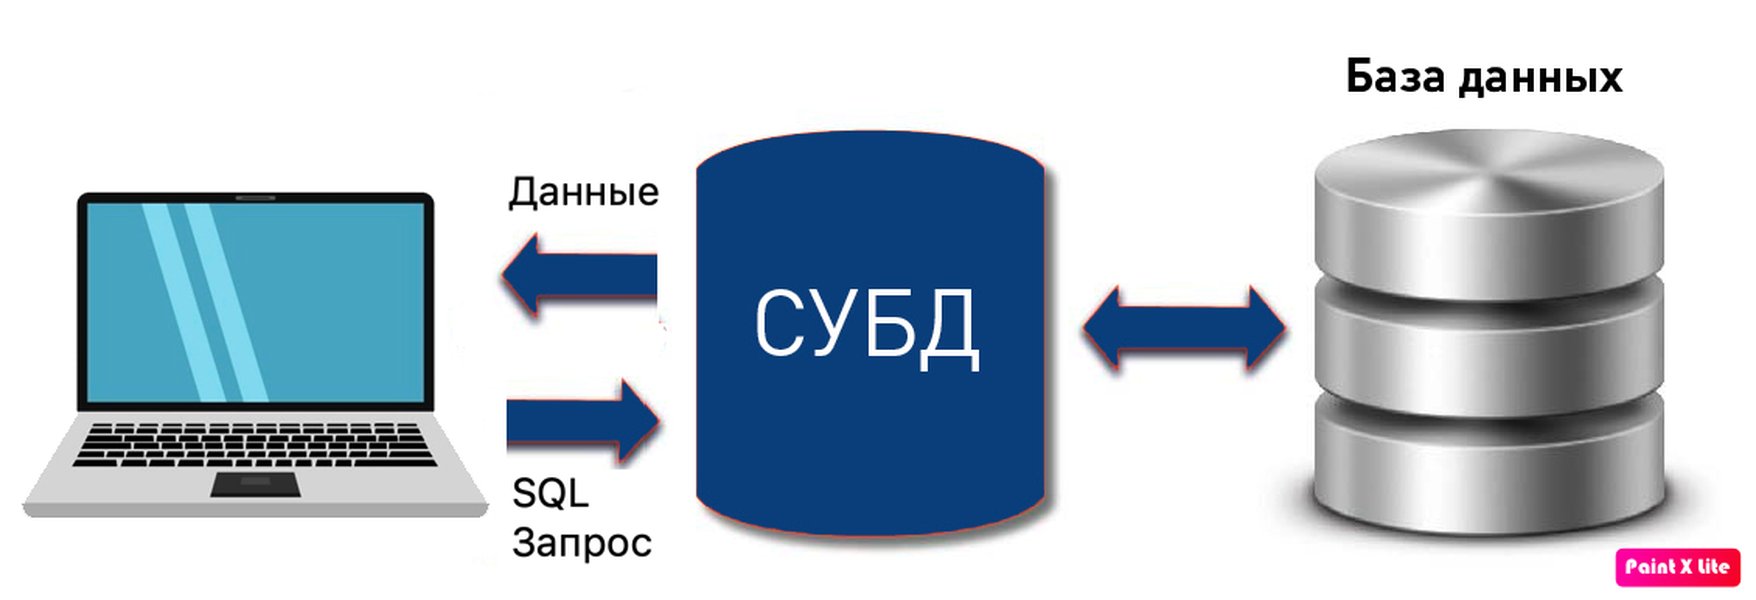
Иллюстрация структуры реляционной базы данных.
Методы SQL для сравнения Ф.И.О.
Рассмотрим основные SQL-операторы и подходы для поиска вхождений Ф.И.О. из одной базы (или таблицы) в другую. Предположим, у нас есть две таблицы: `db1.dbo.Persons` (или `Table1`) и `db2.dbo.Persons` (или `Table2`).
1. Поиск точных совпадений
Этот метод используется, когда необходимо найти записи, где все компоненты Ф.И.О. полностью идентичны.
Использование `INNER JOIN`
Оператор `INNER JOIN` объединяет строки из двух таблиц, если условие соединения истинно. Это наиболее распространенный способ найти точные совпадения.
Если Ф.И.О. в отдельных столбцах:
SELECT T1.LastName, T1.FirstName, T1.MiddleName
FROM db1.dbo.Persons AS T1
INNER JOIN db2.dbo.Persons AS T2
ON T1.LastName = T2.LastName
    AND T1.FirstName = T2.FirstName
    AND (T1.MiddleName = T2.MiddleName OR (T1.MiddleName IS NULL AND T2.MiddleName IS NULL));
Примечание: Условие `(T1.MiddleName = T2.MiddleName OR (T1.MiddleName IS NULL AND T2.MiddleName IS NULL))` корректно обрабатывает случаи, когда отчество может отсутствовать (быть `NULL`) в обеих таблицах.
Если Ф.И.О. в одном столбце (`FullName`):
SELECT T1.FullName
FROM db1.dbo.Persons AS T1
INNER JOIN db2.dbo.Persons AS T2
ON T1.FullName = T2.FullName;
Использование `INTERSECT`
Оператор `INTERSECT` возвращает только те строки, которые присутствуют в результатах обоих запросов. Это удобный способ найти общие записи.
SELECT LastName, FirstName, MiddleName
FROM db1.dbo.Persons
INTERSECT
SELECT LastName, FirstName, MiddleName
FROM db2.dbo.Persons;
Примечание: `INTERSECT` обрабатывает `NULL` значения как равные, если они сравниваются с другими `NULL`.
Использование `EXISTS`
Подзапрос с `EXISTS` проверяет наличие хотя бы одной совпадающей записи во второй таблице, не извлекая сами данные из нее. Это может быть эффективнее, если вам нужно только знать о факте существования.
SELECT T1.LastName, T1.FirstName, T1.MiddleName
FROM db1.dbo.Persons AS T1
WHERE EXISTS (
    SELECT 1
    FROM db2.dbo.Persons AS T2
    WHERE T2.LastName = T1.LastName
        AND T2.FirstName = T1.FirstName
        AND (T2.MiddleName = T1.MiddleName OR (T1.MiddleName IS NULL AND T2.MiddleName IS NULL))
);
2. Поиск отсутствующих записей (различий)
Эти методы помогают найти Ф.И.О., которые есть в одной базе, но отсутствуют в другой.
Использование `LEFT JOIN ... WHERE IS NULL`
Этот подход выбирает все записи из левой таблицы (`db1.dbo.Persons`) и пытается найти соответствия в правой. Если соответствие не найдено, поля из правой таблицы будут `NULL`.
SELECT T1.LastName, T1.FirstName, T1.MiddleName
FROM db1.dbo.Persons AS T1
LEFT JOIN db2.dbo.Persons AS T2
ON T1.LastName = T2.LastName
    AND T1.FirstName = T2.FirstName
    AND (T1.MiddleName = T2.MiddleName OR (T1.MiddleName IS NULL AND T2.MiddleName IS NULL))
WHERE T2.LastName IS NULL; -- Или любое другое ключевое поле из T2
Этот запрос вернет Ф.И.О. из `db1.dbo.Persons`, которых нет в `db2.dbo.Persons`.
Использование `EXCEPT` (или `MINUS` в Oracle)
Оператор `EXCEPT` возвращает строки из первого запроса, которых нет во втором запросе.
SELECT LastName, FirstName, MiddleName
FROM db1.dbo.Persons
EXCEPT -- В Oracle используется MINUS
SELECT LastName, FirstName, MiddleName
FROM db2.dbo.Persons;
3. Поиск по частичному совпадению (шаблону)
Оператор `LIKE` используется для поиска строк, соответствующих определенному шаблону. Это полезно, когда Ф.И.О. может быть неполным, содержать инициалы или иметь вариации.
- `%` (процент): Соответствует любой последовательности символов (включая пустую).
- `_` (подчеркивание): Соответствует любому одиночному символу.
Пример: Найти Ф.И.О. из `db1`, если фамилия из `db1` содержится в фамилии из `db2`.
SELECT T1.LastName, T1.FirstName, T1.MiddleName
FROM db1.dbo.Persons AS T1
WHERE EXISTS (
    SELECT 1
    FROM db2.dbo.Persons AS T2
    -- Синтаксис конкатенации зависит от СУБД:
    -- SQL Server: '%' + T1.LastName + '%'
    -- PostgreSQL, Oracle: '%' || T1.LastName || '%'
    -- MySQL: CONCAT('%', T1.LastName, '%')
    WHERE T2.LastName LIKE '%' + T1.LastName + '%' -- Пример для SQL Server
    -- Можно добавить аналогичные условия для FirstName, MiddleName
);
Или, если нужно найти, где Ф.И.О. из первой таблицы является подстрокой Ф.И.О. из второй (когда Ф.И.О. в одном поле `FullName`):
SELECT T1.FullName AS NameFromDB1, T2.FullName AS NameFromDB2
FROM db1.dbo.Persons AS T1
JOIN db2.dbo.Persons AS T2
ON T2.FullName LIKE '%' + T1.FullName + '%'; -- Пример для SQL Server
Будьте осторожны: запросы с `LIKE '%...%'` могут быть медленными на больших таблицах без соответствующих индексов (например, полнотекстовых или триграммных).
4. Продвинутые и нечеткие методы поиска
Для случаев, когда возможны опечатки, разные транслитерации или порядок слов, стандартных операторов `LIKE` может быть недостаточно. В таких ситуациях применяются более сложные подходы:
- Полнотекстовый поиск: Функции вроде `FREETEXT` или `CONTAINS` (SQL Server), `MATCH ... AGAINST` (MySQL), или использование `tsvector` и `tsquery` (PostgreSQL) позволяют искать по смыслу, с учетом словоформ и ранжирования релевантности.
- Функции схожести строк:
- `SOUNDEX` и `DIFFERENCE` (SQL Server, MySQL, PostgreSQL): Позволяют сравнивать слова по их звучанию. Полезны для поиска фонетически схожих фамилий.
- Триграммный поиск (например, расширение `pg_trgm` в PostgreSQL с функцией `similarity()`): Оценивает схожесть строк на основе количества общих последовательностей из трех символов. Эффективен при опечатках.
Пример с `SOUNDEX` (SQL Server):
SELECT T1.LastName, T1.FirstName
FROM db1.dbo.Persons AS T1
WHERE EXISTS (
    SELECT 1
    FROM db2.dbo.Persons AS T2
    WHERE SOUNDEX(T1.LastName) = SOUNDEX(T2.LastName)
      AND SOUNDEX(T1.FirstName) = SOUNDEX(T2.FirstName)
);
Эти методы требуют более глубокой настройки и понимания специфики вашей СУБД.
Сравнительная таблица методов SQL для сопоставления Ф.И.О.
Эта таблица обобщает основные SQL-операторы и их применение для сравнения Ф.И.О. между базами данных.
| Метод / Оператор | Назначение | Тип совпадения | Пример использования для Ф.И.О. | Особенности |
|---|---|---|---|---|
INNER JOIN ON T1.FIO = T2.FIO |
Найти полностью совпадающие Ф.И.О. | Точное | Поиск идентичных записей | Эффективен с индексами |
INTERSECT |
Найти общие Ф.И.О. | Точное | Выборка Ф.И.О., присутствующих в обеих таблицах | Удобен для простых пересечений |
LEFT JOIN ... WHERE T2.Key IS NULL |
Найти Ф.И.О. из первой таблицы, отсутствующие во второй | Отсутствие точного совпадения | Выявление уникальных записей в первой таблице | Стандартный способ поиска различий |
EXCEPT (или MINUS) |
Найти Ф.И.О. из первой таблицы, отсутствующие во второй | Отсутствие точного совпадения | Альтернатива `LEFT JOIN ... IS NULL` | Более декларативный синтаксис |
WHERE EXISTS (...) |
Проверить наличие Ф.И.О. из одной таблицы в другой | Точное (в подзапросе) | Оптимизирован для проверки существования без выборки данных | Часто производительнее, чем `IN` с подзапросом на больших наборах |
LIKE '%часть_ФИО%' |
Найти Ф.И.О., содержащие определенную подстроку | Частичное (по шаблону) | Поиск по части фамилии, имени или отчества | Может быть медленным без специальных индексов (например, `LIKE 'начало%'` может использовать обычный индекс) |
SOUNDEX(), pg_trgm (similarity) |
Найти Ф.И.О., схожие по звучанию или написанию (с опечатками) | Нечеткое (Fuzzy) | Поиск людей с похожими, но не идентичными Ф.И.О. | Требует поддержки со стороны СУБД, специфичен для диалекта |
Визуализация выбора метода сравнения Ф.И.О.
При выборе метода сравнения Ф.И.О. важно учитывать несколько факторов, таких как требуемая точность, ожидаемая производительность и сложность реализации. Представленная ниже диаграмма иллюстрирует относительные характеристики различных подходов.
Эта диаграмма помогает визуально оценить, какой метод может быть предпочтительнее в зависимости от приоритетов вашего проекта. Например, если важна максимальная точность и стандартность SQL, `INNER JOIN` является отличным выбором. Если же необходимо обрабатывать опечатки и вариации написания, стоит рассмотреть нечеткие методы, помня об их потенциально более высокой сложности реализации и специфичности для СУБД.
Процесс выбора подходящего SQL-запроса: Ментальная карта
Выбор конкретного SQL-запроса для сравнения Ф.И.О. зависит от множества факторов: цели сравнения, структуры хранения данных, требований к точности и производительности. Приведенная ниже ментальная карта поможет сориентироваться в этом процессе.
Эта карта представляет собой дерево решений. Начиная с определения цели, вы можете двигаться по ветвям, чтобы выбрать наиболее подходящие SQL-конструкции и учесть важные нюансы для вашей конкретной задачи.
Видеоурок: Объединение данных из нескольких полей
Часто Ф.И.О. хранится в отдельных полях (Фамилия, Имя, Отчество). Для сравнения или отображения может потребоваться объединить эти поля в одну строку. Следующее видео демонстрирует, как это можно сделать в контексте баз данных, что является полезным навыком при работе с Ф.И.О.
В видео рассматриваются практические примеры конкатенации строковых данных, что напрямую применимо при формировании полного Ф.И.О. из отдельных компонентов перед сравнением или для вывода результатов. Понимание этих техник поможет вам гибко манипулировать данными Ф.И.О. в ваших SQL-запросах.
Важные соображения при сравнении Ф.И.О.
- Права доступа: Убедитесь, что у вас есть необходимые права для чтения данных из обеих баз или таблиц.
- Чувствительность к регистру и пробелы: Разные СУБД по-разному обрабатывают регистр символов при сравнении. Используйте функции `LOWER()` или `UPPER()` для приведения строк к одному регистру и `TRIM()` для удаления лишних пробелов перед сравнением.
- Обработка `NULL` значений: Особенно актуально для отчества, которое может отсутствовать. Используйте `COALESCE(MiddleName, '')` или проверяйте на `IS NULL`, как показано в примерах.
- Производительность: Для больших таблиц запросы на сравнение могут быть ресурсоемкими. Создавайте индексы на столбцах, участвующих в условиях `JOIN` и `WHERE`. Для `LIKE` с начальным wildcard (`'%text'`) обычные B-tree индексы часто неэффективны; рассмотрите полнотекстовые индексы или триграммные индексы (в PostgreSQL).
- Различия в диалектах SQL: Синтаксис некоторых функций (например, конкатенация строк: `+` в SQL Server, `||` в PostgreSQL/Oracle, `CONCAT()` в MySQL) и операторов (`EXCEPT` vs `MINUS`) может отличаться. Адаптируйте запросы под вашу СУБД.
- Специализированные инструменты: Для комплексного сравнения не только данных, но и схем баз данных, существуют специализированные инструменты, такие как SQL Server Data Tools (SSDT), Redgate SQL Compare, DBComparer, SQL Examiner. Они могут автоматизировать процесс и предоставить детальные отчеты о различиях.
Интерфейс программы для управления базами данных.
Часто задаваемые вопросы (FAQ)
Как сравнить Ф.И.О., если они хранятся в одном поле в одной базе и в разных полях в другой?
Вам потребуется привести данные к единому формату перед сравнением. Возможные варианты:
- Объединить раздельные поля: В базе, где Ф.И.О. хранится в отдельных полях, сконкатенируйте их (например, `LastName + ' ' + FirstName + ' ' + ISNULL(MiddleName, '')` в SQL Server) для получения строки, аналогичной той, что в другой базе.
- Разделить единое поле: Это сложнее и менее надежно. Если возможно, лучше работать с объединенным вариантом. Если необходимо, можно использовать строковые функции (`SUBSTRING`, `CHARINDEX`, `PATINDEX`) для попытки извлечения частей Ф.И.О., но это чревато ошибками из-за разнообразия форматов.
- Затем используйте стандартные методы сравнения (`JOIN`, `LIKE`) для полученных строк.
Что делать, если в Ф.И.О. есть опечатки или разные форматы написания?
Для таких случаев подходят методы нечеткого поиска:
- Функции `SOUNDEX` или `DIFFERENCE`: Помогают найти фонетически схожие имена.
- Триграммный поиск (например, `pg_trgm` в PostgreSQL): Эффективен для выявления небольших опечаток, перестановки букв. Функция `similarity()` может оценить степень схожести.
- Полнотекстовый поиск: Может учитывать словоформы и находить совпадения даже при наличии лишних слов или другого порядка.
- Нормализация данных: Перед сравнением приведите Ф.И.О. к единому регистру, удалите лишние пробелы, возможно, стандартизируйте сокращения (например, "Ив." -> "Иван").
Выбор конкретного метода зависит от СУБД и характера ожидаемых расхождений.
Как учесть отсутствие отчества у некоторых людей при сравнении?
Если отчество (`MiddleName`) может быть `NULL`, это нужно учесть в условии `JOIN` или `WHERE`:
(T1.MiddleName = T2.MiddleName OR (T1.MiddleName IS NULL AND T2.MiddleName IS NULL))
Это условие означает, что отчества считаются совпадающими, если они оба равны (не `NULL`), или если они оба `NULL` (отсутствуют).
Альтернативно, можно использовать функцию `COALESCE` (или `ISNULL` в SQL Server) для замены `NULL` на пустую строку перед сравнением, если это приемлемо для вашей логики:
COALESCE(T1.MiddleName, '') = COALESCE(T2.MiddleName, '')
Выбор зависит от того, считаете ли вы отсутствие отчества эквивалентным пустой строке в контексте вашего сравнения.
Какой метод сравнения Ф.И.О. самый быстрый?
Скорость выполнения запроса зависит от многих факторов, включая объем данных, наличие и тип индексов, сложность запроса и конфигурацию сервера СУБД.
- Точное совпадение по индексированным полям (`INNER JOIN` по равенству) обычно является самым быстрым, так как СУБД может эффективно использовать индексы.
- Операторы `INTERSECT` и `EXCEPT` также могут быть достаточно быстрыми, особенно если СУБД оптимизирует их выполнение.
- Поиск с `LIKE 'текст%'` (без начального `%`) может использовать индекс на соответствующем поле и быть относительно быстрым.
- Поиск с `LIKE '%текст%'` или `LIKE '%текст'` (с начальным или обоими `%`) обычно приводит к полному сканированию таблицы (table scan) или индекса (index scan), что медленно на больших таблицах.
- Нечеткий поиск (`SOUNDEX`, триграммы, полнотекстовый поиск) может иметь различную производительность. Полнотекстовые индексы специально разработаны для таких задач и могут быть быстрыми, но требуют дополнительной настройки.
Всегда тестируйте производительность запросов на реальных или репрезентативных данных и анализируйте план выполнения запроса (execution plan) для выявления узких мест.
Нужно ли специальное программное обеспечение для сравнения данных в базах?
Для большинства задач сравнения данных Ф.И.О. достаточно стандартных SQL-запросов, выполняемых через любую среду управления СУБД (например, SQL Server Management Studio, pgAdmin, DBeaver, DataGrip и т.д.).
Однако, если требуется комплексное сравнение не только данных, но и структур (схем) баз данных, выявление всех различий, генерация скриптов для синхронизации, то могут быть полезны специализированные инструменты:
- SQL Server Data Tools (SSDT) для SQL Server.
- Redgate SQL Compare и Redgate SQL Data Compare.
- dbForge Schema Compare и dbForge Data Compare.
- Другие аналогичные коммерческие или open-source утилиты.
Эти инструменты часто предоставляют графический интерфейс, упрощают процесс и могут автоматизировать рутинные задачи сравнения и синхронизации.
Рекомендуемые запросы для дальнейшего изучения
- Как оптимизировать SQL запросы для поиска по ФИО на больших таблицах?
- Различия в синтаксисе SQL для сравнения строк в PostgreSQL, MySQL и SQL Server.
- Использование полнотекстового поиска для нахождения ФИО с учетом морфологии.
- Примеры использования триграммных индексов в PostgreSQL для нечеткого поиска имен.
Источники и полезные ссылки
Last updated May 7, 2025