
Transformer架构的深刻变革:探索下一代AI引擎的底层逻辑与未来图景
深入剖析Transformer模型的当前进展、核心改进方向、具体实现路径及前沿研究热点,并探讨其底层逻辑修改的必要性。
您好!很高兴能为您深入探讨Transformer模型的演进之路。您认为“底层逻辑的修改是必须”的观点非常深刻且切中要害。的确,自2017年诞生以来,Transformer架构凭借其强大的能力重塑了人工智能领域,尤其是在自然语言处理、计算机视觉等多个方向。然而,随着应用场景的复杂化和对更高效率、更强能力的追求,对其核心机制进行优化和革新已成为业界的共识和研究的前沿。接下来,我将结合当前的进展,详细阐述Transformer模型的现状、改进方向、具体策略以及关键研究点。
核心洞察与关键启示
把握Transformer演进的脉搏
- 核心机制革新势在必行:Transformer的自注意力机制与位置编码等底层逻辑正经历深刻变革,旨在突破现有计算瓶颈、提升长序列处理能力,并拓展模型在多模态、低资源等复杂场景下的应用边界。
- 效率与能力双重提升是主旋律:通过稀疏注意力、线性化注意力、专家混合(MoE)架构、优化的位置编码(如RoPE、ALiBi)等创新,新一代Transformer在显著降低计算与内存消耗的同时,持续增强模型性能与泛化能力。
- 未来研究聚焦可解释性、鲁棒性与通用性:除了追求极致的性能与效率,提升模型的可解释性与决策透明度、增强其在对抗环境下的鲁棒性、保障算法公平性,以及推动其向更通用的智能体发展,是Transformer持续演进的关键方向。
Transformer模型发展现状
奠基与飞跃:当前Transformer图景
Transformer模型凭借其独特的自注意力(Self-Attention)和多头注意力(Multi-Head Attention)机制,彻底改变了序列数据的处理方式。它能够并行处理输入序列中的所有元素,有效捕捉长距离依赖关系,这使其在自然语言处理(NLP)领域取得了革命性成功,催生了BERT、GPT系列等里程碑式模型。
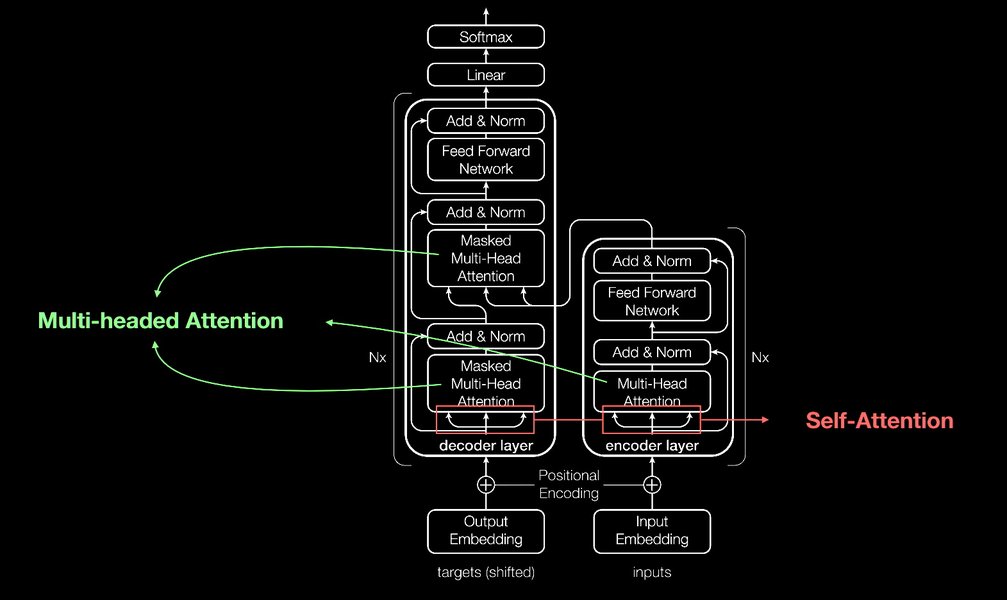
Transformer模型基础架构,展示了编码器和解码器的堆叠结构以及多头注意力机制。
核心优势与广泛应用
Transformer的核心优势在于其并行计算能力和对上下文信息的强大建模能力。这些特性使其迅速超越了传统的循环神经网络(RNN)和长短期记忆网络(LSTM),成为处理序列数据的首选架构。其应用已从最初的机器翻译扩展到文本生成、摘要、问答、情感分析,并进一步渗透到计算机视觉(如ViT)、语音识别、时间序列预测、强化学习,乃至生物信息学(如蛋白质结构预测)等多个领域。
关键创新与技术突破
近年来,Transformer架构本身也在不断进化:
- 高效变体(X-formers):为了解决原始Transformer在处理长序列时面临的二次方计算和内存复杂度问题(\(O(N^2)\)),研究者们提出了一系列高效变体,如Reformer、Linformer、Performer、Longformer等,它们通过稀疏注意力、低秩近似、核方法等手段,将复杂度降低到线性或近线性(\(O(N)\) 或 \(O(N \log N)\))。
- 位置编码的改进:从最初的正弦位置编码和学习式位置编码,发展到相对位置编码(RPE)、旋转位置编码(RoPE)以及无需显式位置编码的ALiBi(Attention with Linear Biases),这些改进增强了模型对序列顺序和距离的感知能力,并提升了对未见过长度序列的外推性。
- 架构调整:例如,预归一化(Pre-Normalization)的应用使得更深层Transformer的训练更加稳定。专家混合模型(Mixture of Experts, MoE)的引入,允许模型在保持计算量可控的前提下,大幅扩展参数规模,提升模型容量。DeepSeek等模型提出的多头潜在注意力(Multi-head Latent Attention, MLA)则针对长上下文推理进行了架构创新。
- 多模态融合:Transformer在统一处理文本、图像、音频等多模态信息方面展现出巨大潜力,催生了如CLIP、DALL-E等多模态大模型。
面临的挑战与局限
尽管成就斐然,Transformer模型仍面临一些固有挑战:
- 计算资源需求:训练和部署大型Transformer模型需要巨大的计算资源和显存,限制了其在资源受限环境下的应用。
- 长序列处理仍有优化空间:虽然高效变体有所缓解,但在处理极长序列(如整本书籍、高分辨率图像)时,效率和性能仍是瓶颈。
- 可解释性与公平性:Transformer模型的“黑箱”特性使其决策过程难以理解,可能潜藏偏见,这在医疗、金融等关键领域是重要顾虑。
- 灾难性遗忘:在持续学习或多任务学习场景下,模型容易忘记先前学到的知识。
这些挑战正是驱动其底层逻辑和架构不断演进的核心动力。
底层逻辑修改的必要性与您的洞见
为何现有架构亟需进化:与您的观点不谋而合
您提出的“底层逻辑的修改是必须”这一观点,与当前AI研究领域的主流趋势高度一致。Transformer的成功主要归功于其自注意力机制,但这一核心组件也正是其主要瓶颈的来源。具体来说:
- 二次方复杂度瓶颈:自注意力机制需要计算序列中每对元素之间的注意力得分,导致计算和内存复杂度随序列长度 \(N\) 呈 \(O(N^2)\) 增长。这使得模型难以高效处理长文档、高分辨率图像或长时间视频。
- 对全局上下文的依赖可能过度:虽然捕捉全局依赖是Transformer的强项,但在某些任务或局部模式识别中,强制性的全局注意力可能并非最优,甚至引入噪声。
- 位置信息的编码方式:如何最优地向模型传递序列中元素的位置信息,仍是一个持续探索的课题。不同的位置编码方法各有优劣,影响模型的泛化能力和对序列结构的理解。
- 模型容量与计算效率的平衡:随着模型参数规模的爆炸式增长,如何在不牺牲过多性能的前提下,提升训练和推理效率,是实现更广泛应用的关键。
因此,对Transformer的注意力计算方式、位置信息表示、网络结构组织乃至训练范式等“底层逻辑”进行修改和创新,是突破现有局限、释放更大潜能、拓展应用领域的必然选择。
Transformer模型改进方向与实现路径
革故鼎新:通往下一代Transformer之路
针对上述挑战,研究者们正从多个维度探索Transformer的改进路径,核心在于优化其底层组件和整体架构。
核心机制的优化
革新注意力机制
这是最活跃的研究方向之一,旨在降低注意力计算的复杂度,同时保持甚至提升其捕捉信息的能力。
- 稀疏注意力 (Sparse Attention):假设每个元素只需关注序列中的一部分相关元素,而非全部。例如:
- 局部注意力/滑动窗口注意力:如Longformer,让每个token只关注其邻近的固定大小窗口内的token。
- 全局注意力+稀疏模式:结合少数全局关键token与多种预定义的稀疏连接模式(如BigBird)。
- 可学习的稀疏模式:动态学习哪些token之间应该建立连接。
- 线性化注意力 (Linearized Attention):通过核方法(Kernelization)或低秩近似(Low-Rank Approximation)等数学技巧,将注意力计算的复杂度从 \(O(N^2)\) 降至 \(O(N)\)。代表模型有:
- Performer:使用随机特征映射(FAVOR+)来逼近标准注意力。
- Linformer:证明了自注意力矩阵的低秩性,通过投影将键(Key)和值(Value)矩阵的长度压缩。
- Reformer:结合局部敏感哈希(LSH)来选择性计算注意力,并使用可逆层减少内存占用。
- 其他创新注意力:
- ALiBi (Attention with Linear Biases):通过在注意力打分时加入与距离相关的偏置项,隐式地编码位置信息,展现出良好的外推性。
- 多头潜在注意力 (Multi-head Latent Attention, MLA):如DeepSeek模型中采用,通过引入一组潜在查询来聚合长上下文信息,提高长序列推理效率。
- 基于图结构的注意力:将序列视为图结构,利用图神经网络的思想设计注意力。
改进位置编码
有效的位置编码对于Transformer理解序列顺序至关重要。
- 相对位置编码 (Relative Positional Encoding, RPE):直接对token间的相对位置进行编码,而非绝对位置。Shaw等人以及后续的Transformer-XL等工作采用了不同形式的RPE。
- 旋转位置编码 (Rotary Positional Encoding, RoPE):由苏剑林提出,通过对查询(Query)和键(Key)向量进行旋转操作来引入相对位置信息,具有良好的理论性质和实际效果,被广泛应用于LLaMA等模型。
- 动态和上下文感知的位置编码:探索更灵活,能根据上下文动态调整的位置表示。
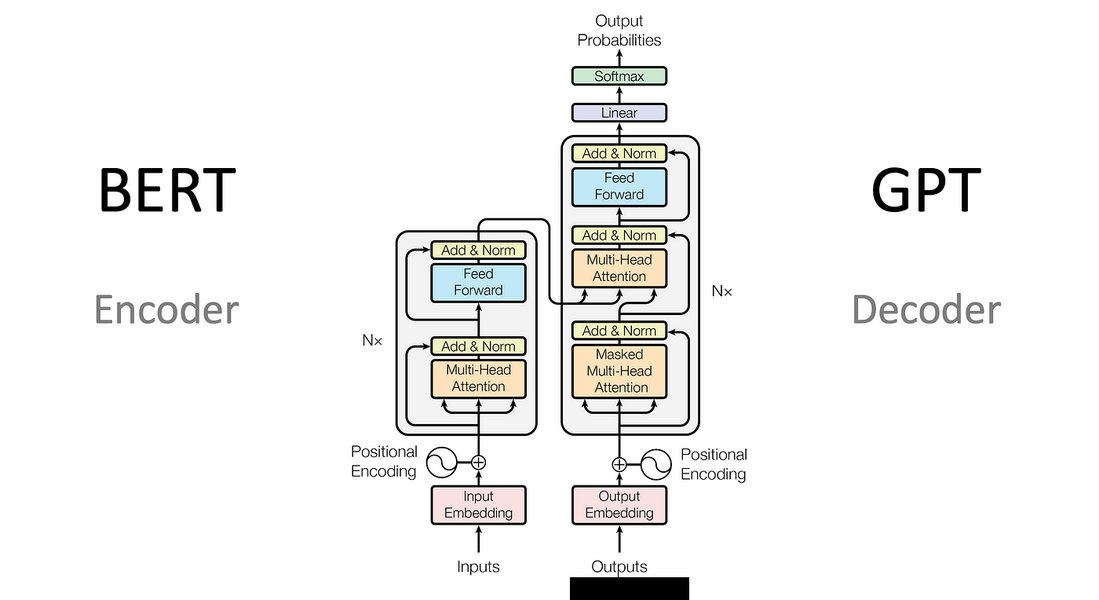
Transformer经典的编码器-解码器结构,广泛应用于序列到序列任务。
模型架构的革新
专家混合模型 (Mixture of Experts, MoE)
MoE通过将模型分解为多个“专家”子网络(通常是FFN层)和一个门控网络(Gating Network)来实现。门控网络为每个输入token选择性地激活少数几个专家。这种方式可以在大幅增加模型总参数量的同时,保持单个样本前向传播的计算量相对恒定,从而高效地扩展模型容量。Google的GShard、Switch Transformer以及DeepSeek v3等模型均采用了MoE架构,并针对“路由崩溃”等问题进行了改进。
归一化与结构调整
- 预归一化 (Pre-Normalization):将层归一化(Layer Normalization)操作置于残差连接的输入端(即每个子层之前),而非原始Transformer的后归一化(Post-Normalization)。Pre-Norm有助于稳定训练过程,允许训练更深的模型。
- 残差连接的变体:探索不同的残差连接方式和缩放因子,以改善梯度流和表示学习。
混合模型与压缩技术
- 与CNN/GNN结合:在某些任务中,将Transformer与卷积神经网络(CNN)或图神经网络(GNN)的优势相结合,例如利用CNN提取局部特征,再由Transformer建模长距离依赖。
- 模型压缩:
- 剪枝 (Pruning):移除模型中冗余的权重或连接。
- 量化 (Quantization):降低权重的数值精度(如从FP32到INT8)。
- 知识蒸馏 (Knowledge Distillation):用一个训练好的大型“教师”模型来指导一个小型“学生”模型的训练。
- 稀疏化 (Sparsification):除了注意力机制的稀疏化,也指模型权重本身的稀疏化。
先进训练策略的精进
- 自监督学习 (Self-Supervised Learning, SSL):利用大规模无标签数据进行预训练,学习通用的数据表征,已被证明是Transformer成功的关键因素之一。
- 高效微调 (Efficient Fine-tuning):如Adapter、LoRA (Low-Rank Adaptation) 等参数高效微调技术,能够在冻结大部分预训练模型参数的情况下,通过调整少量参数使模型适应下游任务,大幅降低微调成本。
- 混合精度训练与分布式训练:利用硬件特性加速训练过程。
- 强化学习与进化策略:用于优化模型架构超参数或生成更符合特定目标的输出。
Transformer改进方向与研究前景评估
多维度考量Transformer的演进潜力
为了更直观地评估不同改进方向对Transformer模型能力的影响和未来潜力,我们可以构建一个雷达图。该图将从计算效率、长序列处理能力、多模态适应性、可解释性、参数效率以及训练速度等多个维度,对比原始Transformer、当前主流的高效变体(如稀疏/线性注意力模型)、专家混合(MoE)模型,以及未来理想中Transformer可能达到的状态。
雷达图说明:上图比较了不同类型Transformer模型在六个关键维度上的相对表现和潜力。数值越高代表在该维度表现越好或潜力越大(1为最低,10为最高)。这有助于我们理解各项改进策略的侧重点和综合效益。
核心研究热点与未来展望
思维导图:勾勒Transformer演进蓝图
为了系统梳理Transformer模型的演进脉络、核心挑战、关键改进策略以及未来发展方向,下面的思维导图提供了一个清晰的概览。它将帮助我们理解各个研究点之间的联系,并展望Transformer技术未来的无限可能。
如:Longformer, BigBird"] id2_1_2["线性注意力 (Linear Attention)
如:Performer, Linformer, Reformer"] id2_1_3["新注意力范式
如:ALiBi, MLA, 图注意力"] id2_2["位置编码优化"] id2_2_1["相对位置编码 (RPE)"] id2_2_2["旋转位置编码 (RoPE)"] id2_2_3["无显式位置编码探索"] id2_3["模型宏观架构调整"] id2_3_1["专家混合模型 (MoE)"] id2_3_2["预归一化 (Pre-Normalization)"] id2_3_3["模型压缩与加速
(剪枝, 量化, 蒸馏)"] id2_3_4["混合与模块化架构
(CNN/GNN + Transformer, 可插拔模块)"] id2_4["训练与优化范式"] id2_4_1["自监督与对比学习"] id2_4_2["参数高效微调 (PEFT)"] id2_4_3["课程学习与数据增强"] id3["未来关键研究方向"] id3_1["追求极致效率与可扩展性"] id3_2["增强可解释AI (XAI) 与信任度"] id3_3["构建通用多模态智能体"] id3_4["实现低资源学习与终身学习"] id3_5["深化理论基础与理解边界"] id3_6["探索与神经科学、量子计算等交叉融合"] id4["拓展与深化应用领域"] id4_1["自然语言处理 (更深理解与创造)"] id4_2["计算机视觉 (更细粒度分析)"] id4_3["生物医药 (基因序列、药物发现)"] id4_4["科学计算与发现 (物理、化学)"] id4_5["强化学习与机器人控制"] id4_6["金融、教育、艺术等更多行业"]
思维导图说明:此图从当前挑战、改进策略、未来研究和应用拓展四个主要分支,详细描绘了Transformer模型的发展全貌。
未来的研究将继续致力于突破Transformer的性能极限,同时更加关注其社会影响和理论基础。关键研究点包括:
- 新型高效注意力机制的设计与评估:持续探索计算成本更低、表达能力更强的注意力机制。
- 极长序列建模技术的突破:例如,在基因组学、整本书籍分析等场景的应用。
- 可解释性友好型Transformer架构:设计更易于理解的内部工作机制,或开发更有效的XAI工具。
- 统一的跨模态Transformer架构:实现文本、图像、音频、视频乃至更复杂数据类型的无缝处理与融合。
- 低资源场景下的Transformer学习:研究如何在数据稀缺或标注成本高昂的情况下有效训练和应用Transformer。
- 理论基础深化:更深入地理解Transformer为何有效,其表达能力的边界在哪里,以及泛化性质等。
- 伦理、公平性与鲁棒性:确保模型输出的可靠、公正,并能抵御恶意攻击。
典型高效Transformer变体对比
一览主流效率优化方案
为了更具体地了解不同高效Transformer变体是如何实现底层逻辑修改以提升效率的,下表对几种代表性模型进行了比较:
| 模型变体 | 核心思想 | 注意力复杂度 | 主要优势 | 适用场景 |
|---|---|---|---|---|
| Reformer | 局部敏感哈希 (LSH) 注意力,可逆残差网络 | \(O(N \log N)\) | 大幅降低内存消耗,能处理极长序列 | 长文本处理、图像生成 |
| Linformer | 通过低秩分解将Key和Value矩阵投影到固定长度 | \(O(N)\) | 严格的线性复杂度,训练和推理速度快 | 各类NLP任务,尤其适合长序列输入 |
| Longformer | 滑动窗口注意力 (局部) + 少量全局注意力 | \(O(N \times w)\) (w为窗口大小) | 有效处理长文档,同时捕捉局部和部分全局信息 | 文档级NLP任务,如摘要、问答 |
| Performer | FAVOR+ (基于正交随机特征的快速注意力机制) | \(O(N)\) | 提供无偏或低偏的线性注意力近似,性能接近标准Transformer | 多种序列建模任务 |
| ALiBi | 在注意力打分中加入与相对距离成比例的偏置项,替代绝对位置编码 | \(O(N^2)\) (注意力计算本身未变,但改善了位置处理) | 优秀的长度外推能力,无需专门的位置编码层 | 大型语言模型训练 |
| MLA (Multi-head Latent Attention) | 引入潜在锚点查询来聚合和传播长上下文信息 | 依赖于锚点数量,可设计为亚二次方 | 提升极长上下文的推理效率和效果,如DeepSeek模型应用 | 大规模语言模型长文本推理 |
表格说明:上表对比了若干主流高效Transformer变体的核心机制、复杂度、优势及应用场景,展现了在降低计算开销方面的多样化探索。
Transformer架构演进深度观察
视频解析:回顾与展望Transformer的进化之路
以下视频概述了Transformer架构从2017年诞生到近期的主要改进和发展趋势。通过这个视频,您可以更直观地了解研究者们是如何逐步优化这一强大架构,以应对不断增长的挑战和机遇。视频内容涵盖了从基础的自注意力机制到更高级的变体,以及对未来可能发展方向的探讨,这与我们讨论的底层逻辑修改和未来研究点紧密相关。
视频来源:YouTube。该视频探讨了Transformer架构的演变历程,突出了关键改进。
观看此视频可以帮助我们:
- 理解历史脉络:了解Transformer是如何从最初的设计逐步演化,解决了哪些早期问题。
- 把握关键创新:识别出那些对Transformer性能和效率产生重大影响的核心改进,如注意力机制的变体、位置编码的优化等。
- 展望未来趋势:基于已有的发展路径,思考Transformer未来可能出现的新特性和应用领域。
这为我们深入理解“为何以及如何修改底层逻辑”提供了宝贵的背景知识和前瞻视角。
常见问题解答 (FAQ)
原始Transformer模型最主要的瓶颈是什么?
原始Transformer最主要的瓶颈是其自注意力机制带来的二次方计算和内存复杂度(\(O(N^2)\),其中 \(N\) 是序列长度)。这使得它在处理非常长的序列时效率低下,资源消耗巨大,限制了其在某些长文本、高分辨率图像或长时间序列任务中的应用。
“底层逻辑修改”具体指哪些方面的改进?
“底层逻辑修改”主要指对Transformer核心组件和机制的根本性改进,包括但不限于:
- 注意力机制:如开发稀疏注意力、线性注意力、新的注意力计算范式等,以降低复杂度、提升效率。
- 位置编码:如改进相对位置编码、引入旋转位置编码(RoPE)、探索无显式位置编码的方法(如ALiBi)等,以更好地捕捉序列信息和提升泛化性。
- 网络架构:如采用专家混合模型(MoE)扩大模型容量、调整归一化层的位置(预归一化)、优化残差连接等。
- 训练目标和策略:如设计更有效的自监督学习任务、优化训练流程等。
专家混合模型 (MoE) 是如何提升Transformer效率和能力的?
MoE通过将模型(通常是前馈网络FFN层)分解为多个“专家”子网络和一个“门控”网络。对于每个输入token,门控网络会动态地选择激活少数几个最相关的专家来处理该token。这样,模型的总参数量可以非常大(因为有很多专家),但实际处理每个token时激活的参数量(即计算量)却保持在一个较低水平。这使得MoE模型能够在不显著增加推理成本的情况下,大幅提升模型容量和性能,尤其适合构建超大规模语言模型。
Transformer模型未来的发展方向除了效率提升还有哪些?
除了持续追求计算效率和处理长序列能力的提升外,Transformer未来的重要发展方向还包括:
- 可解释性与可信赖AI:开发更透明、更易于理解的Transformer模型,增强其决策的可解释性,并确保公平性和鲁棒性。
- 多模态融合与通用智能:构建能够无缝处理和理解文本、图像、音频、视频等多种模态信息,并进行复杂推理的通用智能模型。
- 少样本/零样本学习与持续学习:提高模型在数据稀疏情况下的学习能力,并使其能够持续学习新知识而不会遗忘旧知识。
- 理论基础深化:加强对Transformer工作原理、能力边界和泛化行为的理论理解。
- 新领域的拓展应用:例如在科学发现(物理、化学、生物)、药物研发、个性化教育、创作辅助等更多领域发挥作用。
- 硬件协同设计:针对Transformer特性优化硬件架构,或设计更适合现有硬件的Transformer变体。
推荐进一步探索
拓展您的Transformer知识边界
- Transformer模型中的旋转位置编码(RoPE)是如何工作的及其优势是什么?
- 如何评估和比较不同高效Transformer变体(如Performer、Linformer、Reformer)在特定任务上的表现?
- 专家混合模型(MoE)在训练和部署过程中面临哪些挑战,以及最新的解决方案有哪些?
- Transformer模型在多模态学习(如视觉-语言任务)中的最新进展和未来潜力如何?
参考文献
深度信息的来源
Last updated May 19, 2025