
解密AI的“火眼金睛”:轻松理解“Attention Is All You Need”中的注意力机制
不再死记硬背!了解让AI模型像人一样智能聚焦关键信息的神奇技术。
您是否好奇像ChatGPT这样的大型语言模型是如何理解并生成如此流畅自然的语言的?其中一个核心秘密武器就是“注意力机制”(Attention Mechanism),尤其是在一篇名为《Attention Is All You Need》的开创性论文中被发扬光大。这篇论文彻底改变了我们处理序列数据(如文本、语音)的方式。让我们用最通俗易懂的语言,揭开它的神秘面纱。
核心亮点速览
- 智能聚焦: 注意力机制让AI模型在处理信息时,能够像人一样自动识别并“关注”最重要的部分,忽略无关干扰。
- 打破顺序依赖: 不同于传统模型(如RNN)必须按顺序处理信息,注意力机制可以直接计算序列中任意两个元素间的关系,有效捕捉长距离依赖。
- 效率与性能革命: 《Attention Is All You Need》提出的Transformer模型完全基于注意力机制,实现了高效的并行计算,并在多种任务上取得了突破性成果。
注意力机制:AI的“聚焦能力”是如何炼成的?
想象一下:你如何阅读?
当你阅读句子“小明昨天去公园玩,看到了可爱的猫咪”时,你的大脑并不会平等地对待每一个字。如果问题是“小明看到了什么?”,你会立刻聚焦到“可爱的猫咪”;如果问题是“小明去了哪里?”,你的注意力会转向“公园”。
注意力机制就是模仿人类这种认知过程。它赋予AI模型一种能力,在处理一长串信息(比如一个句子或段落)时,能够动态地判断哪些部分与当前任务或正在处理的信息点最相关,并给予这些部分更高的“关注度”权重。
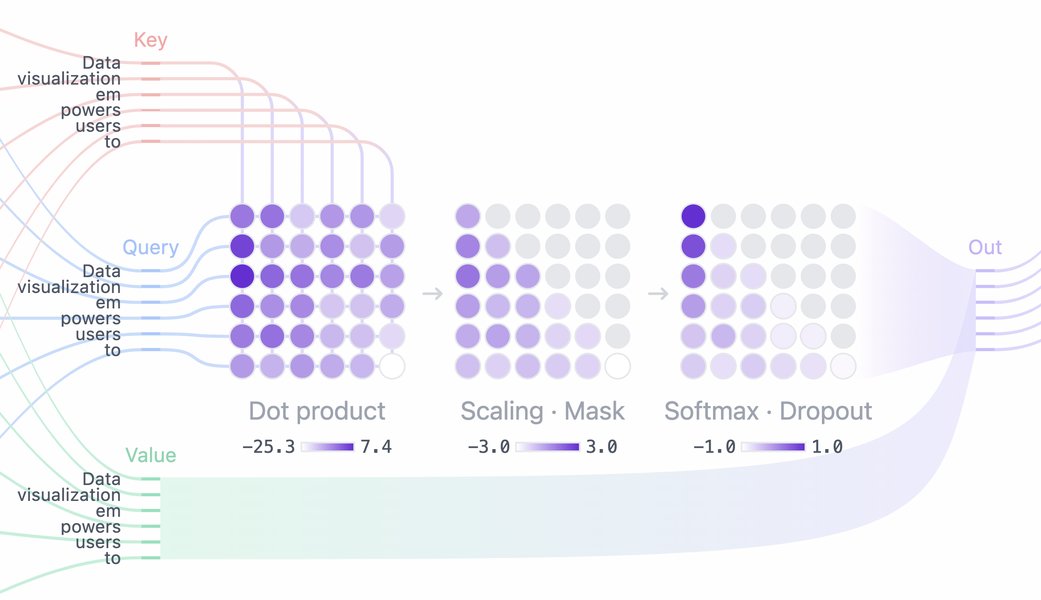
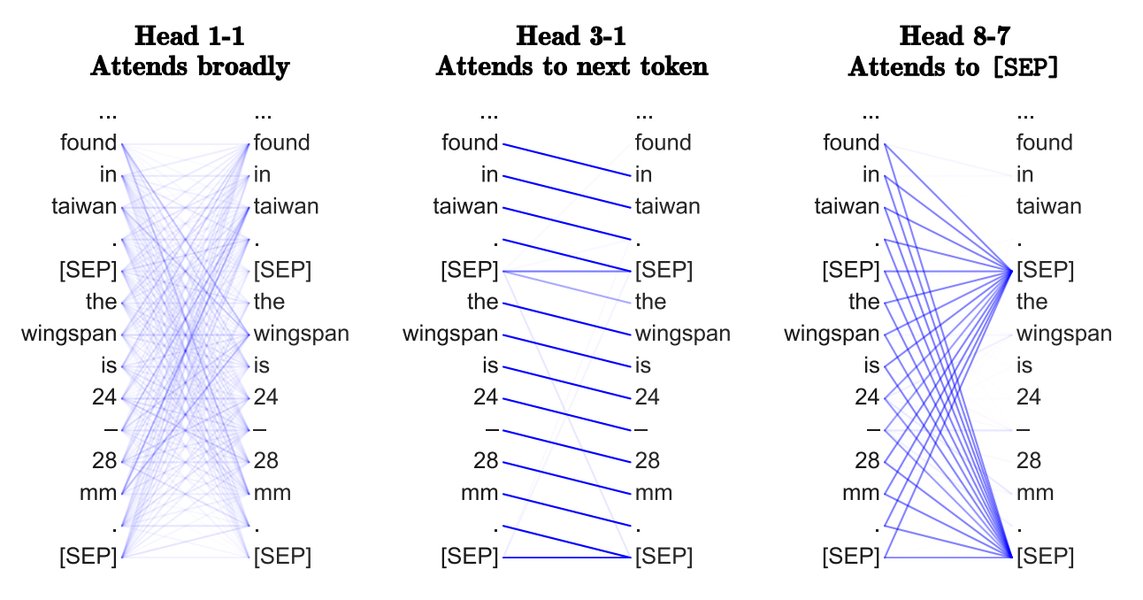
一个简单的注意力机制可视化,展示了模型如何将注意力集中在相关的输入词上。
告别“健忘”:为什么我们需要注意力机制?
在注意力机制出现之前,处理序列数据的主流模型是循环神经网络(RNN)及其变种(如LSTM)。它们像接力赛跑者一样,按顺序一个接一个地传递信息。这种方式存在明显弊端:
- 长距离依赖问题: 当句子很长时,模型很难记住开头的信息,信息在传递过程中容易丢失或变得模糊,就像传话游戏一样,最后的信息可能已经失真。
- 无法并行计算: 必须处理完前一个元素才能处理后一个,这限制了计算效率,训练大型模型非常耗时。
注意力机制的出现,就像给AI装上了“全景雷达”。它允许模型在处理任何一个元素时,都能同时“看到”输入序列中的所有其他元素,直接计算它们之间的关联度,从而克服了上述限制。
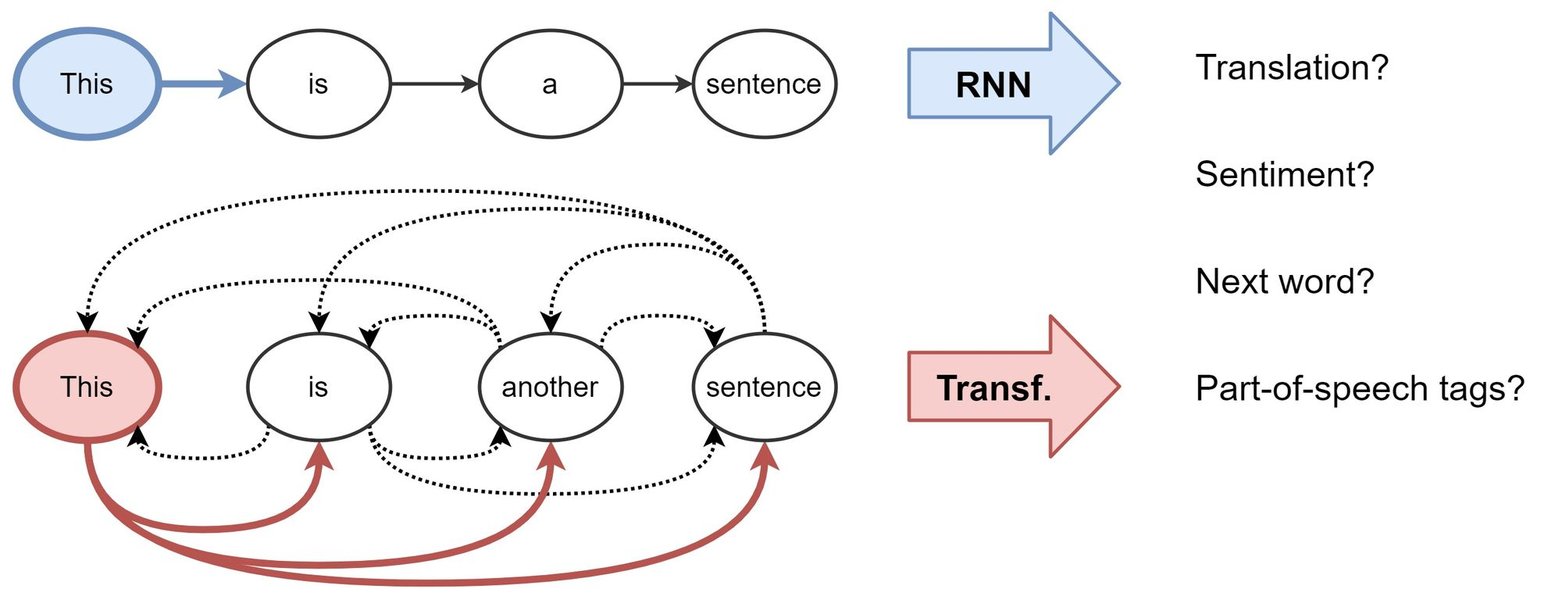
RNN(左)顺序处理信息,而Transformer(右)利用注意力机制并行处理并捕捉全局依赖。
注意力机制的核心运作:Query, Key, Value 的“匹配游戏”
为了理解注意力机制如何计算“关注度”,我们可以把它想象成一个信息检索或匹配的过程,其中涉及三个关键角色:查询(Query)、键(Key)和值(Value)。这三个角色都是从输入元素的原始表示(比如词向量)变换而来的向量。
三大主角:Q, K, V
查询(Query, Q):
代表当前正在处理的元素或信息需求。可以把它想象成你在数据库里输入的“搜索词”,你想知道:“关于我这个信息点,输入序列里哪些内容是相关的?”
键(Key, K):
代表输入序列中各个元素的“标识”或“标签”。就像数据库中每条记录的索引关键词,用来与“查询”进行匹配。
值(Value, V):
代表输入序列中各个元素的实际“内容”或信息。一旦“查询”通过与“键”匹配找到了相关的元素,对应的“值”就是模型真正需要提取的信息。
计算注意力权重的步骤(以缩放点积注意力为例)
《Attention Is All You Need》论文中主要使用的是“缩放点积注意力”(Scaled Dot-Product Attention)。这个过程可以简化为以下几步:
- 计算相似度分数: 将当前元素的Query向量与序列中所有元素的Key向量进行点积运算(一种衡量向量相似度的数学方法)。得到的分数越高,表示Query和对应的Key越相关。
- 缩放(Scaling): 为了防止点积结果过大影响后续计算的稳定性(尤其是在向量维度较高时),将得到的分数除以Key向量维度的平方根进行缩放。
- 归一化(Softmax): 将缩放后的分数通过Softmax函数转换成概率分布。这样,每个元素都得到一个介于0和1之间的权重,所有权重加起来等于1。这个权重就代表了模型对该元素的“关注度”。
- 加权求和: 将每个元素的Value向量乘以它对应的注意力权重,然后将所有加权后的Value向量求和。最终得到的结果就是融合了全局上下文信息的、当前元素的新的表示(注意力输出)。
简单来说,模型通过Query去“询问”序列中的所有Key,根据匹配程度(相似度分数)决定给每个对应的Value分配多少“注意力”(权重),最后将所有被关注的Value信息汇总起来,形成对当前元素的更深刻理解。
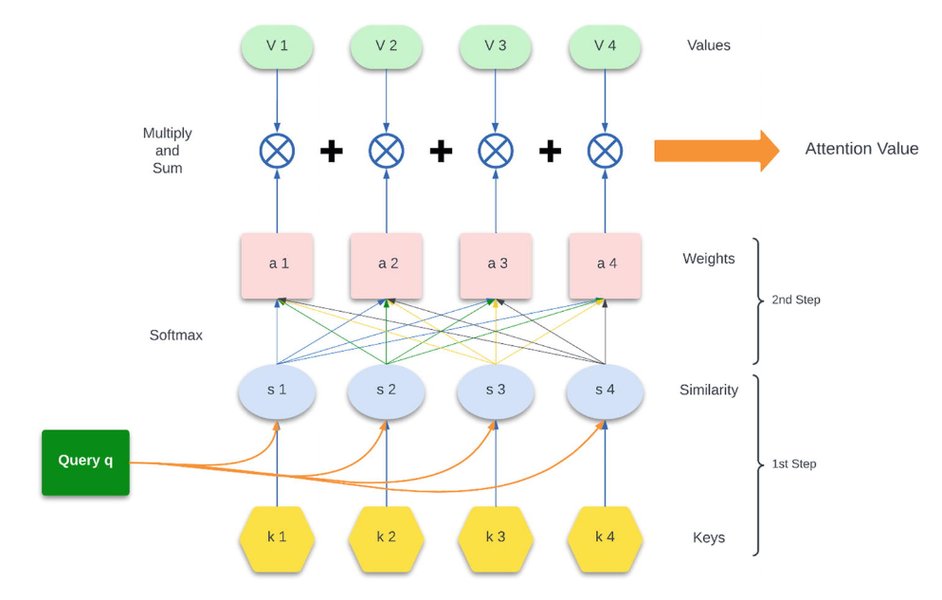
注意力机制计算流程示意图:Query与所有Key计算相似度,通过Softmax得到权重,再对Value进行加权求和。
《Attention Is All You Need》的核心创新
这篇论文的革命性在于,它证明了仅靠注意力机制,完全不需要RNN或卷积神经网络(CNN)的序列处理结构,就能构建出强大的模型。这个完全基于注意力的模型被称为**Transformer**。
自注意力(Self-Attention)
这是Transformer模型的核心。自注意力允许模型在处理一个序列(比如一个句子)时,计算序列内部不同位置(词语)之间的相互关系。例如,在处理句子“The animal didn't cross the street because it was too tired”时,自注意力机制能够帮助模型理解单词“it”指代的是“The animal”,因为它会计算出“it”和“The animal”之间有很高的注意力分数。
自注意力使得模型能够直接捕捉句子内部的长距离依赖关系,而无需像RNN那样层层传递信息。
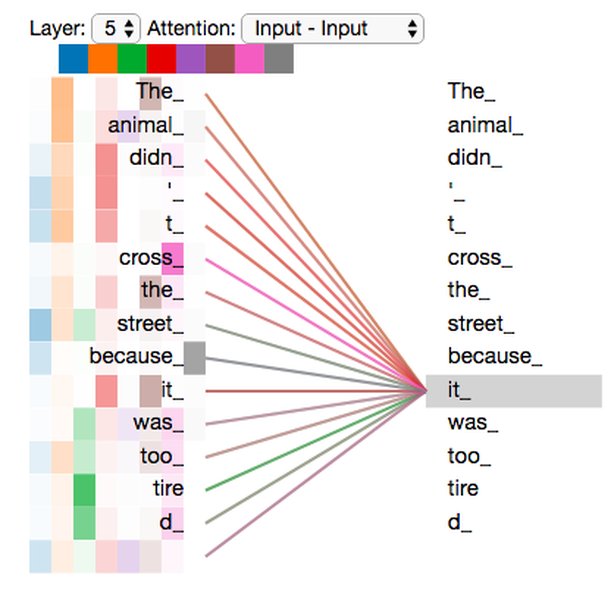
自注意力机制可视化:单词 "it" 与句子中其他单词的注意力关系,重点关注 "animal"。
多头注意力(Multi-Head Attention)
为了让模型能够从不同角度、关注不同的信息子空间,论文提出了多头注意力机制。这相当于同时运行多个独立的自注意力“头”(Head)。
每个头使用不同的、独立学习的线性变换(不同的Q, K, V权重矩阵),捕捉输入序列的不同方面的依赖关系。例如,一个头可能关注语法结构,另一个头可能关注语义关联,还有一个头可能关注词语位置信息等。
最后,将所有头的注意力输出拼接起来,再通过一次线性变换,融合成最终的多头注意力输出。这样做的好处是:
- 增强了模型捕捉不同类型相关性的能力。
- 允许注意力层在不同表示子空间中共同学习信息。
- 由于各个头的计算可以并行进行,因此计算效率很高。
多头注意力示意图:输入被送入多个并行的注意力头,每个头关注不同的表示子空间。
模型能力对比:Transformer (Attention) vs. RNN
为了更直观地展示基于注意力机制的Transformer模型相较于传统RNN模型的优势,下面的雷达图从几个关键维度进行了对比(评分基于普遍认知,非精确数值):
从图中可以看出,基于注意力的Transformer模型在并行计算、捕捉长距离依赖、训练速度和整体性能上普遍优于传统的RNN模型,但在处理极长序列时,其二次方复杂度的计算成本(相对于序列长度n,复杂度为O(n²))是需要考虑的因素,而RNN的单步计算复杂度较低(O(n))。
注意力机制概念总览:思维导图
下面的思维导图总结了注意力机制的核心概念及其在Transformer模型中的应用:
聚焦重要信息"] id1_2["动态权重分配"] id1_3["克服RNN局限"] id2["关键组件 (Q, K, V)"] id2_1["查询 (Query): 当前需求/焦点"] id2_2["键 (Key): 信息标识/用于匹配"] id2_3["值 (Value): 实际信息内容"] id3["计算过程 (Scaled Dot-Product)"] id3_1["计算相似度 (点积)"] id3_2["缩放 (Scaling)"] id3_3["归一化 (Softmax) -> 权重"] id3_4["加权求和 -> 输出"] id4["《Attention Is All You Need》创新"] id4_1["Transformer 模型"] id4_1_1["完全基于Attention"] id4_1_2["抛弃RNN/CNN结构"] id4_2["自注意力 (Self-Attention)"] id4_2_1["序列内部元素关联"] id4_2_2["捕捉长距离依赖"] id4_3["多头注意力 (Multi-Head Attention)"] id4_3_1["并行Attention计算"] id4_3_2["多角度捕捉信息"] id4_3_3["提升模型表达能力"] id5["主要优势"] id5_1["并行计算能力强"] id5_2["有效捕捉长距离依赖"] id5_3["模型性能优越"] id5_4["应用广泛 (NLP, CV等)"] id6["挑战"] id6_1["计算复杂度 (O(n²))"] id6_2["对超长序列的处理"]
这个导图清晰地展示了从注意力机制的基本概念到Transformer模型中具体实现(自注意力和多头注意力)以及其带来的优势和挑战。
深入理解:注意力机制如何运作?
下面的视频用可视化的方式进一步解释了注意力机制,特别是Transformer架构中的注意力是如何工作的,有助于加深理解:
这个视频("Attention in transformers, step-by-step")通过逐步演示,揭示了注意力在Transformer和大型语言模型中的关键作用,解释了Query、Key、Value以及它们如何相互作用来计算注意力权重,是理解注意力机制内部运作的优质资源。
模型架构对比:RNN vs Transformer
下表总结了基于循环结构的RNN/LSTM模型与基于注意力机制的Transformer模型在关键特性上的对比:
| 特性 | RNN / LSTM | Transformer (Attention-based) |
|---|---|---|
| 核心机制 | 循环连接,按时间步顺序处理 | 自注意力机制 |
| 序列处理方式 | 顺序处理 | 并行处理(主要部分) |
| 长距离依赖捕捉 | 有限(梯度消失/爆炸问题) | 非常有效(直接计算任意位置关系) |
| 计算并行性 | 低(受序列长度限制) | 高(同一层内计算可并行) |
| 训练速度 | 较慢 | 较快(得益于并行性) |
| 表示能力 | 逐步积累上下文信息 | 直接融合全局上下文信息 |
| 典型应用 | 早期NLP任务、时间序列分析 | 现代NLP(翻译、生成、理解)、CV、多模态 |
| 代表性论文 | - | 《Attention Is All You Need》 |
这个表格清晰地展示了Transformer模型通过引入注意力机制,在处理序列数据方面相较于传统RNN模型的显著优势。
常见问题解答 (FAQ)
▸ 注意力机制和自注意力机制有什么区别?
注意力机制是一个更广泛的概念,指的是让模型关注输入(或输出)不同部分的技术。它可以用于连接编码器和解码器(如机器翻译中关注源句子的不同词),也可以用于其他场景。
自注意力机制(Self-Attention)是注意力机制的一种特殊形式,特指在处理同一个序列时,序列内部元素之间相互计算注意力。它是Transformer模型的核心,用于捕捉序列内部的依赖关系。
▸ 为什么需要“多头”注意力?一个头不够吗?
单个注意力头可能只能学到一种类型的依赖关系或关注模式。多头注意力允许模型同时从不同的“角度”(表示子空间)学习信息。
想象一下,一个头可能专注于捕捉词语的语法关系,另一个头专注于语义相似性,还有一个头关注相对位置等。通过结合多个头的输出,模型可以获得更丰富、更全面的信息表示,从而提升性能。此外,多头的设计也方便了并行计算。
▸ 注意力机制只用于自然语言处理(NLP)吗?
不是的。虽然注意力机制最初在NLP领域(尤其是机器翻译)取得了巨大成功,并因Transformer模型而闻名,但它的思想已经被成功应用到其他领域。
例如,在计算机视觉(CV)领域,出现了Vision Transformer (ViT)等模型,它们将图像分割成小块(patches),然后像处理词语一样使用自注意力机制来分析图像内容。注意力机制也被用于语音识别、推荐系统、图神经网络等多种任务中。
▸ 注意力机制有什么缺点吗?
主要的缺点是计算复杂度。标准的自注意力机制需要计算序列中每对元素之间的关系,对于长度为N的序列,其计算复杂度和内存需求大约是 O(N²)。这意味着当序列非常长时,计算成本会急剧增加。
为了解决这个问题,研究人员已经提出了许多改进的注意力机制,如稀疏注意力(Sparse Attention)、线性注意力(Linear Attention)等,试图在保持性能的同时降低计算复杂度。
推荐探索
如果您对注意力机制和Transformer模型感兴趣,可以继续探索以下相关问题:
参考文献
Last updated May 4, 2025