
揭秘PCA:高维数据降维的魔术之手,它究竟是如何化繁为简的?
深入探索主成分分析的核心原理、应用场景及其对数据科学的深远影响。
核心洞察
- 核心功能:主成分分析(PCA)是一种强大的统计方法,通过保留数据中的主要变异信息(方差)来简化复杂的高维数据集,实现数据降维。
- 基本原理:PCA的核心在于将原始可能相关的变量通过线性变换,转换为一组新的、线性不相关的变量,这些新变量被称为主成分。第一个主成分捕捉数据中最大的方差,后续主成分依次捕捉剩余方差,且与前者正交。
- 广泛应用:PCA被广泛应用于数据可视化、特征提取(如人脸识别)、去噪、数据压缩以及作为机器学习算法的预处理步骤,以提高模型效率和性能。
主成分分析 (PCA) 概述
什么是主成分分析 (PCA)?
主成分分析(Principal Component Analysis,简称PCA)是一种广泛应用的无监督学习算法和统计技术。它的主要目标是对高维数据集进行降维,即减少数据变量(特征)的数量,同时尽可能多地保留原始数据集中的重要信息。通过PCA,可以将大量相关性较高的原始变量转化为少数几个线性不相关的新变量,这些新变量被称为“主成分”(Principal Components)。这些主成分是原始特征的线性组合,并按照其解释数据方差的能力从大到小排序。
为何需要PCA:高维数据的挑战
在现代数据分析中,我们经常遇到包含大量特征(维度)的数据集。例如,在基因组学、图像处理或金融建模中,特征数量可能达到成百上千甚至更多。高维数据带来了诸多挑战:
- “维度灾难”:随着维度的增加,数据点之间的空间变得越来越稀疏,使得许多算法的性能下降,需要更多的样本来支持模型的泛化能力。
- 计算复杂度:处理高维数据需要更多的计算资源和时间。
- 多重共线性:许多特征之间可能高度相关,导致信息冗余,并可能影响某些统计模型的稳定性和解释性。
- 可视化困难:人类难以直观理解超过三维的数据。
- 噪声积累:高维数据中可能包含更多噪声特征,干扰有效信息的提取。
PCA通过识别数据中最重要的变化方向(即方差最大的方向),将数据投影到由这些方向构成的低维子空间中,从而有效应对上述挑战,简化数据结构,便于后续分析和建模。
PCA 的核心原理与运作机制
寻找主导数据变异的“主成分”
PCA 的核心思想是找到一个新的坐标系,使得数据在这些新坐标轴上的投影方差最大化。这些新的坐标轴就是所谓的主成分。第一个主成分(PC1)是数据中方差最大的方向。第二个主成分(PC2)是在与PC1正交(垂直)的平面中方差最大的方向,以此类推。每个后续的主成分都会捕捉数据中剩余方差的尽可能大的部分,并且与之前所有主成分都正交。由于主成分是正交的,它们之间线性无关,从而消除了原始特征间的冗余。
通过选择方差贡献最大的前几个主成分,我们就可以用一个远低于原始维度的子空间来表示数据,同时最大限度地保留原始数据的主要变异信息。那些方差较小的主成分通常被认为是噪声或不太重要的信息,可以被舍弃。
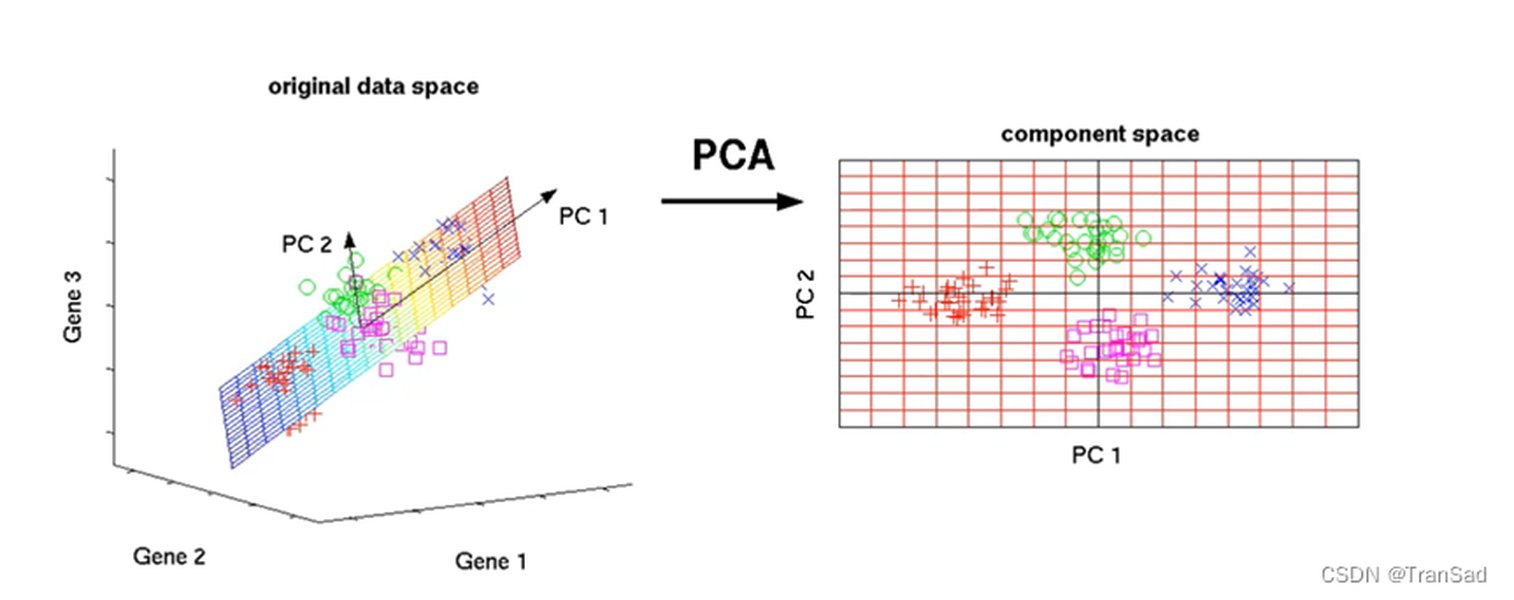
图示:PCA 将原始数据点投影到方差最大的新轴(主成分)上。
数学直觉:协方差与特征分解
从数学角度看,PCA 的实现依赖于对数据协方差矩阵的分析。协方差矩阵描述了数据集中不同特征之间的线性关系强度和方向。PCA通过对协方差矩阵进行特征值分解(Eigenvalue Decomposition)或对数据矩阵进行奇异值分解(Singular Value Decomposition, SVD)来实现。
- 特征向量(Eigenvectors):协方差矩阵的特征向量定义了新坐标系的方向,即主成分的方向。
- 特征值(Eigenvalues):每个特征向量对应一个特征值,该特征值的大小表示数据在相应主成分方向上的方差大小。特征值越大,说明该主成分包含的信息越多。
通过将特征值从大到小排序,我们可以选择那些对应较大特征值的特征向量作为新的主成分轴,从而构建降维后的数据表示。
PCA 的实施步骤:一步步化繁为简
应用主成分分析通常遵循以下明确的步骤,将高维复杂数据转化为低维简化表示:
1. 数据标准化(Standardization)
由于PCA对特征的尺度非常敏感(即特征的数值范围),如果不同特征的量纲或数值范围差异很大,那些数值范围较大的特征可能会在主成分的计算中占据主导地位。为了避免这种情况,通常需要对数据进行标准化处理,最常见的方法是Z-score标准化,即对每个特征减去其均值然后除以其标准差,使得所有特征都具有零均值和单位方差。 \[ X_{standardized} = \frac{X - \mu}{\sigma} \] 其中 \(X\) 是原始数据,\(\mu\) 是特征的均值,\(\sigma\) 是特征的标准差。
2. 计算协方差矩阵(Covariance Matrix Calculation)
在标准化数据的基础上,下一步是计算协方差矩阵。协方差矩阵是一个对称矩阵,其对角线元素是各个特征的方差,非对角线元素是不同特征对之间的协方差。协方差矩阵揭示了特征之间的线性相关性。对于一个包含 \(p\) 个特征的数据集,协方差矩阵 \(C\) 是一个 \(p \times p\) 的矩阵。 \[ C = \frac{1}{n-1} X_{standardized}^T X_{standardized} \] 其中 \(n\) 是样本数量。
3. 特征值分解(Eigenvalue Decomposition)
对计算得到的协方差矩阵 \(C\) 进行特征值分解。这一步旨在找到协方差矩阵的特征值(eigenvalues)和对应的特征向量(eigenvectors)。 \[ C \mathbf{v} = \lambda \mathbf{v} \] 其中 \(\lambda\) 是特征值,\(\mathbf{v}\) 是对应的特征向量。特征向量代表了主成分的方向,而特征值则代表了数据在这些方向上的方差大小。一个 \(p \times p\) 的协方差矩阵会有 \(p\) 个特征值和 \(p\) 个对应的特征向量。
4. 选择主成分(Selection of Principal Components)
将特征值从大到小排序。每个特征值对应一个主成分,其大小反映了该主成分解释原始数据方差的程度。通常,我们会选择前 \(k\) 个最大的特征值及其对应的特征向量,其中 \(k\) 是我们希望降到的维度数量。选择 \(k\) 的方法有多种:
- 累计方差贡献率:选择足以解释原始数据总方差一定百分比(例如85%-95%)的主成分数量。第 \(i\) 个主成分的方差贡献率为 \(\lambda_i / \sum_{j=1}^p \lambda_j\)。
- 碎石图(Scree Plot):绘制特征值大小的图形,寻找特征值开始趋于平缓的“拐点”,拐点之前的主成分通常被保留。
- 预设维度:根据应用需求直接指定降维后的维度数量。
5. 数据转换(Data Transformation)
最后一步是将原始(标准化后)的数据投影到由选定的 \(k\) 个主成分(即 \(k\) 个特征向量)构成的新子空间中。这是通过将原始数据矩阵乘以由这 \(k\) 个特征向量组成的投影矩阵 \(W\)(其中 \(W\) 的列是选定的特征向量)来实现的。 \[ X_{new} = X_{standardized} W \] \(X_{new}\) 就是降维后的数据集,它有 \(n\) 个样本和 \(k\) 个特征(主成分)。
交互式探索:PCA与其他降维方法比较
主成分分析(PCA)是众多降维技术中的一种。下图通过雷达图直观比较了PCA与另外两种流行的降维方法:t-分布随机邻域嵌入(t-SNE)和均匀流形逼近与投影(UMAP)在几个关键特性上的表现。这些评估是基于普遍的认知和经验,而非严格的定量测试结果。
从图中可以看出,PCA在方差保留能力、计算成本和大规模数据可扩展性方面表现优越,且其成分具有一定的可解释性。然而,在捕捉非线性结构和保留复杂数据的全局结构方面,t-SNE和UMAP通常表现更好,尽管它们计算成本更高,且成分可解释性较差。选择哪种方法取决于具体的数据特性和分析目标。
PCA 概览:思维导图
为了更系统地理解主成分分析(PCA),下面的思维导图概述了其核心定义、目标、关键步骤、典型应用场景以及主要的优缺点。这有助于快速把握PCA的全貌。
(线性无关)"] id2.4["保留关键信息"] id3["主要步骤"] id3.1["1. 数据标准化"] id3.2["2. 计算协方差矩阵"] id3.3["3. 特征值分解
(获特征值与特征向量)"] id3.4["4. 选择主成分
(基于特征值大小)"] id3.5["5. 数据投影
(转换到低维空间)"] id4["应用场景"] id4.1["数据可视化
(高维数据转2D/3D)"] id4.2["特征提取
(例如: 人脸识别、基因表达)"] id4.3["去噪与数据压缩"] id4.4["解决多重共线性问题"] id4.5["机器学习预处理"] id5["优点"] id5.1["简化数据结构"] id5.2["去除冗余信息"] id5.3["计算相对高效"] id5.4["无需数据标签"] id5.5["主成分正交,消除共线性"] id6["缺点"] id6.1["线性假设
(不擅长非线性结构)"] id6.2["可能丢失有用信息
(低方差成分)"] id6.3["对数据缩放敏感
(需标准化)"] id6.4["主成分可解释性
可能不如原始特征直观"]
该思维导图清晰地展示了PCA从基本概念到实际考量的各个方面,帮助理解其在数据分析流程中的地位和作用。
视频深入解析:直观理解PCA
理论知识之外,观看一个直观的解释视频能更好地帮助理解PCA的原理和应用。下面的视频由小旭学长制作,用生动形象的方式讲解了什么是主成分分析,非常适合初学者快速入门。
这个视频通过可视化和实例,解释了PCA如何在高维数据中找到最重要的方向(主成分),以及如何利用这些主成分来降低数据维度,同时保留数据的主要特征。它涵盖了PCA的基本思想,例如方差最大化和数据投影,使得复杂的概念更容易被消化和吸收。观看此类视频是巩固理论学习、建立直观感受的有效途径。
PCA 的广泛应用领域
主成分分析因其强大的降维和特征提取能力,在众多领域都有着广泛的应用:
数据可视化
高维数据很难直接可视化。PCA可以将数据降至二维或三维,使得我们可以在散点图等图表上直观地观察数据点的分布、聚类趋势和异常值,从而更好地理解数据结构。
特征提取与模式识别
在机器学习中,PCA常被用作特征提取技术。例如,在图像识别(如人脸识别的Eigenfaces方法)中,可以将高维的像素数据转换为少数几个主成分特征,这些特征能有效代表图像的主要信息,减少计算量并提高识别效率。在生物信息学中,PCA可用于分析基因表达数据,找出区分不同样本类别的关键基因模式。
去噪与数据压缩
PCA假设方差较大的主成分代表了信号,而方差较小的主成分可能代表了噪声。通过舍弃那些方差很小的主成分,可以在一定程度上实现数据去噪。同时,由于保留的主成分数量远少于原始特征数量,PCA也实现了数据压缩,减少了存储需求。
提高机器学习模型性能
在高维数据上训练机器学习模型时,可能会遇到过拟合、计算成本高等问题。通过PCA降维,可以减少特征数量,降低模型复杂度,从而可能提高模型的泛化能力和训练效率。降维后的数据也更不容易受到“维度灾难”的影响。
解决多重共线性问题
在回归分析等统计模型中,如果自变量之间存在高度相关性(多重共线性),会导致模型参数估计不稳定且难以解释。PCA可以将相关的自变量转换为一组不相关的主成分,用这些主成分代替原始自变量进行建模,从而有效缓解多重共线性问题。
例如,在金融领域,PCA可以用于分析大量相关的经济指标,提取少数几个能概括市场状况的主成分,用于风险管理或投资组合构建。在化学领域,葡萄酒数据集案例展示了如何使用PCA对葡萄酒的多种化学成分进行降维,以便更好地进行分类。
PCA 的优势与局限性
主成分分析(PCA)作为一种经典且广泛应用的降维技术,具有其独特的优点,但也存在一些固有的局限性。理解这些方面对于在实践中有效运用PCA至关重要。
| 方面 | 描述 |
|---|---|
| 优势:简化数据 | PCA能有效减少数据集的维度,使得数据更易于处理、可视化和分析,降低了计算复杂性。 |
| 优势:去除冗余 | 通过保留方差最大的方向,PCA能自动识别并整合高度相关的变量,消除数据中的冗余信息。主成分之间是正交的,从而消除了多重共线性。 |
| 优势:无监督性 | PCA是一种无监督学习方法,它不需要类别标签或其他目标变量即可进行,非常适合探索性数据分析和数据预处理。 |
| 优势:计算效率 | 对于线性变换而言,PCA的计算相对高效,尤其是在特征数量不是特别巨大的情况下。 |
| 局限性:线性假设 | PCA是一种线性降维方法,它假设数据中的主要结构可以通过线性组合来捕获。如果数据分布在复杂的非线性流形上,PCA可能无法有效地揭示其真实结构。 |
| 局限性:信息损失 | 虽然PCA旨在保留尽可能多的方差,但在降维过程中,舍弃方差较小的主成分必然会导致一部分信息的损失。这些被舍弃的成分有时可能包含对特定任务有用的信息。 |
| 局限性:对数据缩放敏感 | PCA的结果对原始特征的尺度非常敏感。如果未进行数据标准化,数值范围较大的特征可能会主导主成分的计算,导致结果失真。因此,在应用PCA之前通常需要对数据进行标准化处理。 |
| 局限性:可解释性 | 主成分是原始特征的线性组合,这可能使得降维后的新特征(主成分)难以直观地解释其物理意义或业务含义,不如原始特征那样直接。 |
| 局限性:对异常值敏感 | 异常值可能会对均值和方差的计算产生较大影响,进而影响协方差矩阵和主成分的确定。 |
尽管存在这些局限性,PCA仍然是数据科学工具箱中一个非常有价值的工具。在应用时,需要根据具体数据的特性和分析目标,权衡其利弊,并可能考虑与其他方法(如非线性降维技术t-SNE, UMAP)结合使用。
常见问题解答 (FAQ)
PCA的主要目标是什么?
PCA的主要目标是通过将原始高维数据投影到一个新的低维子空间,来减少数据集的维度(特征数量)。这个过程旨在最大程度地保留原始数据中的方差(即信息量),同时生成一组新的、线性不相关的变量(主成分)。简而言之,PCA致力于用更少的特征来概括数据的主要模式和结构,从而简化数据、方便可视化、提高后续分析任务(如机器学习)的效率和性能。
PCA是监督学习还是无监督学习算法?
PCA是一种无监督学习算法。它在进行降维时,仅仅依赖于数据本身的内在结构(如特征间的协方差关系),而不需要任何预先定义的标签或目标变量。这意味着PCA可以应用于未标记的数据集,用于探索性数据分析、特征提取和数据预处理等任务。
为什么在进行PCA之前数据标准化很重要?
数据标准化(通常是Z-score标准化,即将数据转换为均值为0,标准差为1)在PCA之前非常重要,因为PCA对特征的尺度(即数值范围和单位)非常敏感。如果不同特征的尺度差异很大,那些数值范围较大的特征在计算协方差和方差时会占据主导地位,从而使得PCA的结果偏向于这些特征,而忽略了其他可能同样重要的特征。标准化可以确保所有特征在PCA计算中具有同等的贡献机会,使得主成分能够更公平地反映数据中所有特征的变异情况。
PCA的一个主要局限性是什么?
PCA的一个主要局限性是它的线性假设。PCA通过线性变换来寻找主成分,这意味着它假设数据中的主要变异方向是线性的。如果数据分布在复杂的非线性流形(如曲线或螺旋状结构)上,PCA可能无法有效地捕捉到这种非线性结构,导致降维效果不佳或丢失关键信息。在这种情况下,可能需要使用非线性降维方法(如t-SNE、UMAP、核PCA等)来更好地保留数据的非线性特性。
如何选择主成分的数量?
选择主成分的数量(即降维后的维度 \(k\))是PCA应用中的一个关键步骤。常用的方法包括:
- 累计方差贡献率:计算每个主成分解释的方差占总方差的比例,然后选择足够数量的主成分,使其累计方差贡献率达到一个预设的阈值(例如,85%、90%或95%)。这意味着选定的主成分能够解释原始数据大部分的变异。
- 碎石图(Scree Plot):将特征值按从大到小的顺序绘制出来。通常,特征值会急剧下降然后趋于平缓。图中“拐点”(elbow point)之前的主成分被认为是重要的,可以保留。
- 基于应用需求:根据具体的应用场景和后续任务的需求来确定维度,例如,如果目标是数据可视化,通常会选择2或3个主成分。
- 交叉验证:在监督学习任务中,可以将PCA降维作为预处理步骤,并通过交叉验证来评估不同数量主成分对模型性能的影响,选择使模型性能最优的 \(k\) 值。
选择合适的 \(k\) 值需要在信息保留和维度降低之间进行权衡。
推荐探索
如果您希望更深入地了解主成分分析及其相关领域,以下是一些建议的探索方向:
- PCA如何应用于图像压缩技术?
- PCA与其他降维技术(如t-SNE或LDA)有何核心区别与适用场景?
- 在Python的scikit-learn库中如何实现和调优PCA?
- PCA中的特征值和特征向量在实际数据分析中究竟代表什么具体含义?
参考文献
 docs.aws.amazon.com
Last updated May 18, 2025