
視覺大型語言模型在文件OCR的雙面刃:革命性突破與現實挑戰
深入解析VLLM如何重塑文件辨識技術,以及企業導入前不可不知的關鍵考量。
視覺大型語言模型(Vision Large Language Models, VLLM),亦常被稱為視覺語言模型(Vision Language Models, VLM),近年來在文件光學字元辨識(Optical Character Recognition, OCR)領域掀起了一股革新浪潮。這些模型結合了先進的電腦視覺技術與強大的自然語言處理能力,使其不僅能夠「看見」文件中的文字,更能「理解」其深層含義與上下文結構。相較於傳統OCR技術,VLLM在處理複雜、多樣化文件方面展現出顯著優勢,但也伴隨著一些挑戰與限制。以下將詳細探討VLLM應用於文件OCR的各項優點與缺點。
核心亮點速覽
- 卓越的語境理解與複雜文件處理能力:VLLM 不僅辨識文字,更能理解文件結構、視覺元素與上下文資訊,大幅提升處理手寫稿、多格式文件及包含圖表的複雜文件的準確性。
- 高昂的資源需求與潛在的資訊風險:雖然功能強大,但VLLM通常需要龐大的計算資源(如GPU)進行訓練與推論,部署成本較高。同時,模型可能出現「幻覺」(hallucination),產生不實資訊,需要謹慎評估與驗證。
- 未來趨勢與技術互補的智慧選擇:VLLM無疑代表了文件OCR技術的未來發展方向,但在現階段,將其與成熟的傳統OCR技術相結合,形成互補策略,可能是兼顧效能、成本與可靠性的最佳途徑。
VLLM 在文件 OCR 應用上的優點
增強的準確性與無與倫比的語境理解
VLLM 最顯著的優勢之一在於其超凡的準確性和深度語境理解能力。傳統OCR系統主要聚焦於字元本身的辨識,對於字元間的語義關聯、文件整體結構的理解有限。VLLM則不同,它們能夠:
- 精準辨識多樣性文字:有效處理手寫字跡、模糊不清的文字、印刷瑕疵或在複雜背景下的文字。傳統OCR在這些情境下錯誤率較高。
- 理解上下文資訊:VLLM能分析文字在句子、段落乃至整個文件中的意義,有助於修正單純基於視覺特徵可能產生的辨識錯誤。例如,在發票或提貨單等文件中,VLLM能理解特定欄位(如日期、金額)的含義,而不僅僅是孤立的字串。
- 處理非標準格式:對於排版不規則、包含多欄位或混合內容(文字、圖片、表格)的文件,VLLM展現出更強的適應性。
這種深層次的理解能力,使得VLLM在處理需要高度準確性和語義分析的文件時,遠勝於傳統OCR方法。
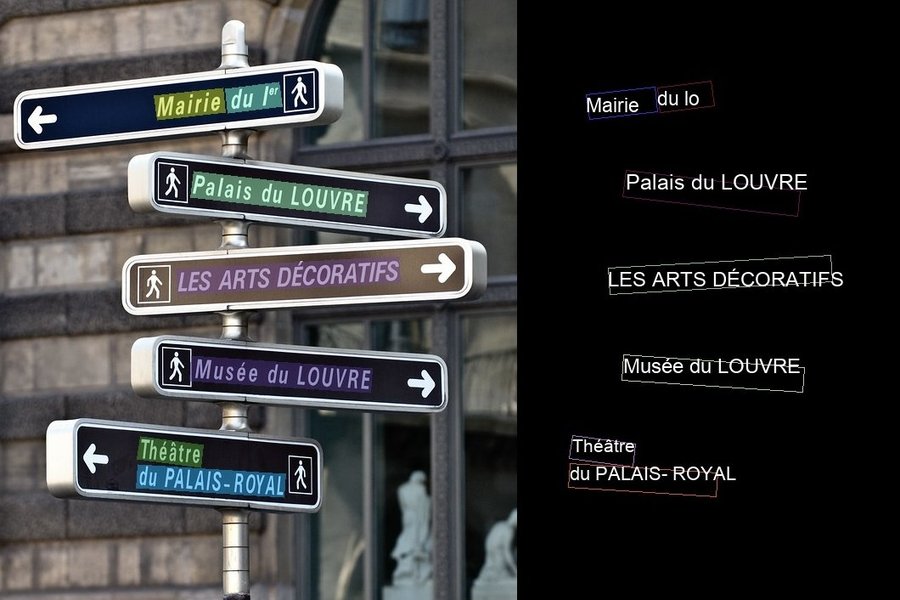
光學字元辨識技術將圖像中的文字轉換為可編輯的數位文本。
卓越處理複雜與非標準文件的能力
現代文件往往格式多樣,包含豐富的視覺元素。VLLM在這方面展現出卓越的處理能力:
- 理解圖文混合內容:VLLM能夠辨識文件中的圖片、表格、圖表等非文字元素,並理解它們與周圍文字的關聯性。例如,它可以辨識表格的行列結構,並將表頭與對應的數據元格關聯起來。
- 支援多種文件格式與語言:許多先進的VLLM(如Qwen系列模型)原生支援多種語言的辨識,無需針對特定語言進行專門訓練。同時,它們也能較好地處理PDF、掃描件、照片等多種來源的文件圖像。
- 空間佈局感知:VLLM能理解文件中元素的空間佈局關係,這對於解析表單、發票等結構化文件至關重要。
全面的資訊提取與結構化輸出
VLLM不僅僅是文字的「搬運工」,更能成為資訊的「提煉師」:
- 關鍵資訊提取:能夠從非結構化或半結構化的文件中自動提取關鍵資訊,如發票號碼、合約日期、客戶名稱、產品序號等。
- 結構化數據輸出:許多VLLM可以將提取的資訊直接轉換為結構化格式(如JSON),極大地方便了後續的數據分析、資料庫存儲或自動化流程整合。這減少了大量的人工整理和格式轉換工作。
- 超越純文字辨識:它們可以回答關於文件內容的問題,進行內容摘要,甚至根據文件內容生成描述,實現更深層次的文檔理解。
高度適應性與客製化潛力
VLLM的靈活性為其在不同應用場景下的部署提供了便利:
- 微調能力 (Fine-tuning):可以針對特定類型的文件(如特定行業的報告、特定格式的表單)或特定任務進行微調,以進一步提升在該領域的辨識準確度和資訊提取效果。
- 指令引導與互動式查詢:部分VLLM允許用戶透過自然語言指令來引導模型的辨識和提取行為,例如指定只提取文件中的特定章節或特定類型的資訊。
- 處理動態影像中的文字:研究顯示,VLLM在處理影片等動態影像中的OCR任務方面也表現出潛力,這對於影片字幕生成、場景文字分析等應用非常重要。
提升處理效率與自動化水平
借助於大型模型的並行計算能力和優化的推論框架(如vLLM框架),VLLM在處理大量文件時可以展現出較高的效率:
- 加速處理流程:對於需要處理海量文件的企業而言,VLLM有望縮短整體處理時間,提升作業效率。
- 減少人工干預:由於其更高的準確性和更強的理解能力,VLLM可以顯著減少人工校對和後續處理的需求,從而降低人力成本,提升自動化水平。
VLLM 在文件 OCR 應用上的缺點
高昂的計算資源需求與部署成本
VLLM的強大功能是建立在複雜的模型結構和海量參數之上的,這也帶來了顯著的資源挑戰:
- GPU依賴:高效運行VLLM通常需要高性能的GPU(圖形處理單元)支援,這對於硬體設備提出了較高要求。
- 記憶體開銷:尤其在處理多模態輸入或高解析度圖像時,VLLM會產生較大的記憶體佔用,可能比傳統OCR模型更耗費資源。
- 訓練與推論成本:模型的訓練和推論過程都需要大量的計算資源,這直接轉化為較高的能源消耗和雲端服務費用,對於中小型企業而言可能是一筆不小的開支。
模型複雜性與專業知識門檻
駕馭VLLM並非易事,需要一定的技術積累:
- 理解與除錯困難:VLLM的內部運作機制比傳統OCR更為複雜,當出現問題時,理解其原因並進行有效的除錯可能更具挑戰性。
- 專業知識要求:模型的部署、微調和維護通常需要具備深度學習、自然語言處理等領域的專業知識和技能。
- 參數調整複雜:為了在特定任務上達到最佳性能,可能需要對模型的眾多參數進行細緻調整,這需要經驗和反覆試驗。
「幻覺」風險與潛在的準確性波動
作為生成式AI模型的一種,VLLM也可能面臨「幻覺」(Hallucination)問題:
- 生成不實資訊:在處理模糊、損壞或信息不完整的文檔時,VLLM有時可能會「杜撰」或填補不存在的文字或資訊,導致提取結果的可靠性下降。
- 字元級精度問題:儘管在語境理解上表現優越,但在某些極端要求字元級別絕對精確的場景(如法律條文、精密儀器讀數),VLLM的純文字辨識精確度有時可能不及經過長期優化的專用OCR工具。
- 性能因模型而異:不同VLLM模型在OCR任務上的性能可能存在差異,選擇合適的模型需要進行充分的評估和測試。一些輕量級VLLM雖然效率較高,但在複雜任務上的表現可能不如大型模型。
特定任務的局限性與整合挑戰
儘管VLLM功能強大,但在某些特定情境下仍有其局限性:
- 專業化不足:VLLM通常是為多種視覺語言任務設計的通用模型,並非專門為OCR優化。因此,在一些高度特化的OCR任務中,可能仍需輔助工具或更專業化的模型。
- 處理極端複雜版面:對於包含極其特殊版式、大量手寫註解、密集印章或水印的文件,VLLM可能仍需要傳統OCR技術或其他專門視覺演算法的輔助才能達到最佳效果。
- 整合複雜性:將VLLM整合到現有工作流程中,可能需要依賴第三方API、框架(如vLLM)或額外的OCR模組,這會增加系統的整體複雜度和維護成本。
VLLM OCR 與傳統 OCR 比較
為了更直觀地理解 VLLM 在 OCR 應用上的特性,下表比較了 VLLM OCR 與傳統 OCR 在多個關鍵維度上的差異:
| 特性 | 傳統 OCR | VLLM OCR |
|---|---|---|
| 準確性 (Accuracy) | 高度依賴清晰圖像和標準字體,對噪點和變形敏感。 | 在複雜情境(如手寫、低質量圖像、多樣佈局)下通常具有更高準確性。 |
| 語境理解 (Contextual Understanding) | 有限或幾乎沒有語境理解能力,主要進行字元級辨識。 | 強大的語境理解能力,能理解文字、段落乃至整個文件的語義和結構。 |
| 處理複雜文件 (Complex Documents) | 處理包含圖表、多欄位、混合內容的文件時效果不佳。 | 擅長處理包含圖像、表格、複雜排版的現代文件。 |
| 手寫辨識 (Handwriting Recognition) | 通常是主要挑戰,準確率較低。 | 辨識手寫文字的能力有顯著提升,但仍依賴模型訓練數據。 |
| 多語言支援 (Multilingual Support) | 通常需要為每種語言加載特定的語言包或模型。 | 許多模型原生支援多種語言,適應性更強。 |
| 結構化提取 (Structured Extraction) | 通常需要額外的後處理步驟(如規則引擎、模板匹配)來提取結構化資訊。 | 具備直接提取關鍵資訊並以結構化格式(如JSON)輸出的能力。 |
| 計算資源需求 (Computational Resources) | 相對較低,可在普通CPU上運行。 | 非常高,通常需要強大的GPU進行高效推論。 |
| 模型複雜性與維護 (Model Complexity & Maintenance) | 相對簡單,技術門檻較低。 | 模型龐大且複雜,部署、調優和維護需要專業知識。 |
| 幻覺風險 (Hallucination Risk) | 無此類風險,錯誤通常是辨識錯誤或遺漏。 | 可能存在生成不實或與原文不符內容的風險。 |
| 部署成本 (Deployment Cost) | 初期和運行成本相對較低。 | 硬體、雲服務及專業人力成本較高。 |
VLLM OCR 與傳統 OCR 性能維度比較
下方的雷達圖直觀地比較了視覺大型語言模型(VLLM)OCR 與傳統 OCR 在幾個關鍵性能維度上的相對表現。這些評估是基於普遍的行業認知和技術特性,旨在提供一個概覽性的比較,實際表現可能因具體模型和應用場景而異。
在此雷達圖中,「整體準確性」指在多樣化文件上的平均辨識成功率;「語境理解」評估模型理解文字含義和上下文的能力;「複雜文件處理」衡量其處理包含圖表、多欄位等文件的效能;「手寫辨識」專指對手寫文字的辨識能力;「成本效益」綜合考量部署成本與帶來的效益;「部署簡易性」評估整合和實施的難易程度;「處理速度」則關注其完成OCR任務的快慢。顯然,VLLM在理解和處理複雜性方面具有優勢,但在成本和部署簡易性方面則面臨挑戰。
VLLM 在文件 OCR 應用中的核心能力概覽
下方的思維導圖總結了視覺大型語言模型(VLLM)在文件光學字元辨識(OCR)應用中的主要優點和潛在缺點,幫助您快速掌握其核心特性。
及複雜背景"] id1_2["理解文件整體結構
與語義關聯"] id2["處理複雜與非標準文件"] id2_1["支援含圖像、表格、圖表的文件"] id2_2["廣泛的文件格式
(PDF, 掃描件, 圖片)"] id2_3["多語言能力"] id3["全面的資訊提取"] id3_1["結構化數據輸出 (如JSON)"] id3_2["關鍵資訊識別
(如發票號碼、日期)"] id3_3["超越純文字辨識
實現文件問答、摘要"] id4["可微調與指令引導"] id4_1["針對特定任務進行優化"] id4_2["透過指令控制提取內容"] id5["提升處理效率"] id5_1["利用vLLM等框架加速推論"] ("缺點") id6["高計算資源需求"] id6_1["依賴高性能GPU"] id6_2["部署與運行成本高"] id6_3["記憶體開銷大"] id7["模型複雜性與專業門檻"] id7_1["需要專業知識進行調校與維護"] id7_2["除錯相對困難"] id8["「幻覺」風險"] id8_1["可能生成不實或捏造的資訊"] id8_2["需謹慎驗證輸出結果"] id9["特定場景精度問題"] id9_1["純文字字元級精度
偶爾不及專用OCR"] id9_2["性能因模型版本而異"] id10["整合與專業化局限"] id10_1["可能需輔助工具或與傳統OCR結合"] id10_2["對極特殊版面處理能力有限"]
這張思維導圖清晰地展示了VLLM在OCR領域的雙面性:一方面,它憑藉強大的理解和處理能力,為複雜文件辨識帶來了突破;另一方面,其資源需求和潛在風險也不容忽視。
VLLM 與 OCR 的未來:專家觀點
隨著技術的發展,視覺大型語言模型(VLLM)是否會完全取代傳統的光學字元辨識(OCR)技術?這是一個業界廣泛討論的話題。以下的影片深入探討了VLLM的能力、局限性,以及它們在文件處理領域的潛在未來,為我們提供了有價值的見解。
影片探討:視覺語言模型(VLM)能否取代傳統OCR?
影片中通常會討論到,VLLM在處理如稅務表格等多樣化文件格式時的表現,並比較其與傳統OCR在準確性、上下文理解和處理複雜性方面的差異。專家們普遍認為,雖然VLLM展現出巨大潛力,特別是在需要深度理解和結構化提取的任務中,但傳統OCR在某些特定、對資源要求較低的場景下仍有其價值。未來,更可能是兩者結合,發揮各自優勢,形成更強大、更全面的文件智能解決方案。
常見問題 (FAQ)
Q: VLLM 與傳統 OCR 的最大區別是什麼?
最大的區別在於語境理解能力和處理複雜性。傳統OCR主要側重於將圖像中的字元轉換為文本,對文字的意義和文件結構的理解有限。而VLLM不僅能辨識文字,還能理解其上下文、文件佈局、圖像內容,甚至進行推理和結構化資訊提取。簡而言之,傳統OCR「讀取」文字,VLLM則力求「理解」文件。
Q: VLLM 在處理哪些類型的文件時特別有優勢?
VLLM在處理以下類型的文件時特別有優勢:
- 手寫文件:如手寫筆記、表格填寫。
- 複雜排版文件:包含多欄、圖文混排、表格、圖表的報告、雜誌、發票等。
- 非標準格式文件:掃描質量不高、有污漬、文字方向不一的文件。
- 需要結構化提取的文件:如從合約中提取條款、從履歷中提取關鍵技能。
- 多語言文件:許多VLLM具備較好的多語言處理能力。
Q: 導入 VLLM 進行 OCR 的主要挑戰有哪些?
導入VLLM進行OCR的主要挑戰包括:
- 高昂的計算資源需求:需要強大的GPU和相應的硬體設施,導致初始投資和運行成本較高。
- 模型複雜性與專業技能:部署、微調和維護VLLM需要專業的AI和機器學習知識。
- 「幻覺」風險:模型可能生成不準確或虛構的資訊,需要建立驗證機制。
- 數據隱私與安全:若使用雲端VLLM服務,需考慮數據傳輸和存儲的安全性。
- 整合難度:將VLLM整合到現有業務系統和工作流程中可能存在技術挑戰。
- 對特定任務的適應性:通用VLLM可能需要針對特定業務場景進行微調才能達到最佳效果。
Q: VLLM 會完全取代傳統 OCR 嗎?
目前來看,VLLM不太可能在短期內完全取代傳統OCR。儘管VLLM在許多方面表現出顯著優勢,但傳統OCR在某些特定場景下仍具備成本效益高、部署簡單、對資源要求低等優點。更可能的情況是兩者並存並相互補充:對於簡單、標準化的文字辨識任務,傳統OCR可能仍是有效選擇;而對於複雜、需要深度理解和結構化提取的任務,VLLM則能發揮其強大潛力。未來,混合式解決方案,即結合VLLM的理解能力和傳統OCR的效率,可能會成為主流趨勢。
推薦查詢
若想更深入了解相關主題,您可以嘗試以下查詢:
參考資料
本回應綜合參考了以下資訊來源,以提供全面且基於事實的分析:
Last updated May 18, 2025