
释放潜能:深入剖析vLLM优化策略,实现卓越推理性能
探索尖端技术与参数调优,助您极致提升大型语言模型服务效率与速度。
vLLM (Very Large Language Model) 是一个开源库,专为提升大型语言模型(LLM)的推理和服务效率而设计。它通过一系列创新性的优化技术,显著提高了LLM部署的吞吐量、降低了延迟,并优化了内存使用。理解并应用这些优化策略对于充分发挥vLLM的强大性能至关重要。
核心亮点速览
- PagedAttention技术: 革命性地优化了注意力机制中的KV缓存管理,大幅减少显存碎片,显著提升内存效率和系统吞吐量(据称可达24倍性能提升)。
- 连续批处理 (Continuous Batching): 通过动态合并传入请求,确保GPU资源持续高效运转,有效提升处理并发请求的能力并降低平均延迟。
- 精细化参数调优与多维度优化: 提供包括显存利用率、批处理大小在内的多项可调参数,并结合张量并行、模型量化等策略,支持在不同硬件上实现性能最大化。
vLLM核心优化技术详解
vLLM的卓越性能源于其底层多项关键技术的协同工作。这些技术主要针对LLM推理过程中的核心瓶颈——显存管理和计算效率——进行优化。
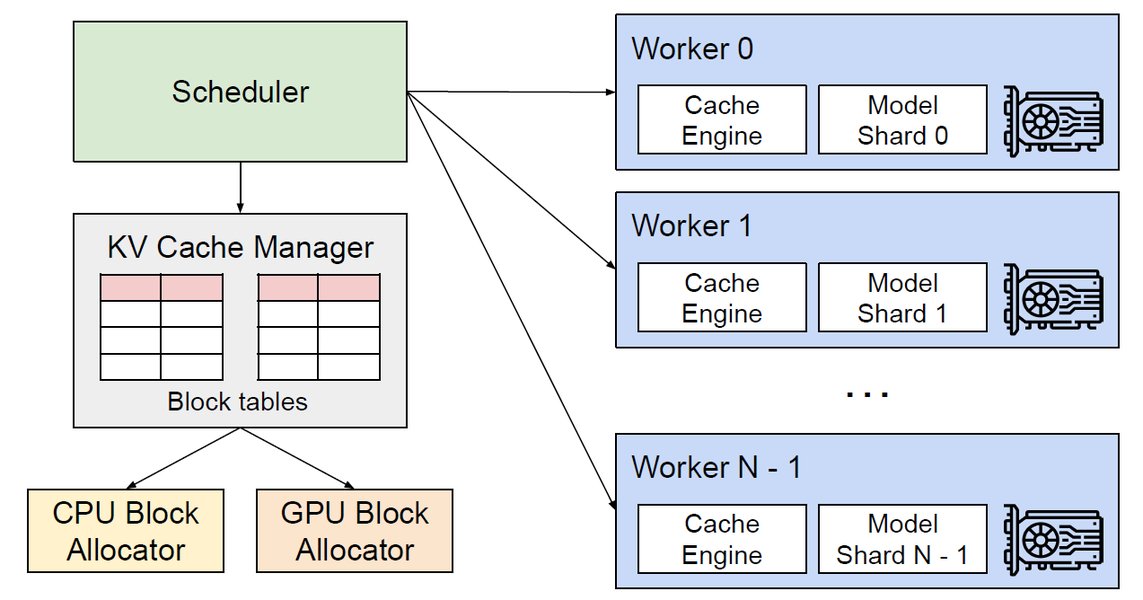
vLLM通过创新技术优化LLM推理流程
PagedAttention:革新性的注意力KV缓存管理
传统的Transformer模型在推理过程中,注意力机制产生的键值缓存(KV Cache)会占用大量GPU显存。随着序列长度和批处理大小的增加,显存消耗急剧上升,成为性能瓶颈。vLLM引入了PagedAttention技术来解决这一问题。
PagedAttention借鉴了操作系统中虚拟内存和分页的思想:
- 非连续空间存储: 它将KV缓存分割成固定大小的“块”(pages),这些块在物理显存中可以非连续存储。这种方式极大减少了因寻找大段连续显存而导致的内存碎片问题。
- 按需分配与共享: 显存块按需分配给各个序列。更重要的是,对于采用相同前缀的多个序列(例如在束搜索或并行采样中),PagedAttention可以实现这些块的共享(Copy-on-Write机制),避免了冗余存储和复制开销。
- 高效内存利用: 通过细粒度的块管理,PagedAttention显著提高了显存的实际利用率,使得在有限的显存条件下能够服务更大的模型、处理更长的序列或容纳更多的并发请求。据报告,相比传统方法,PagedAttention能将在使用一半GPU内存的情况下,将LLM服务性能提升约24倍。
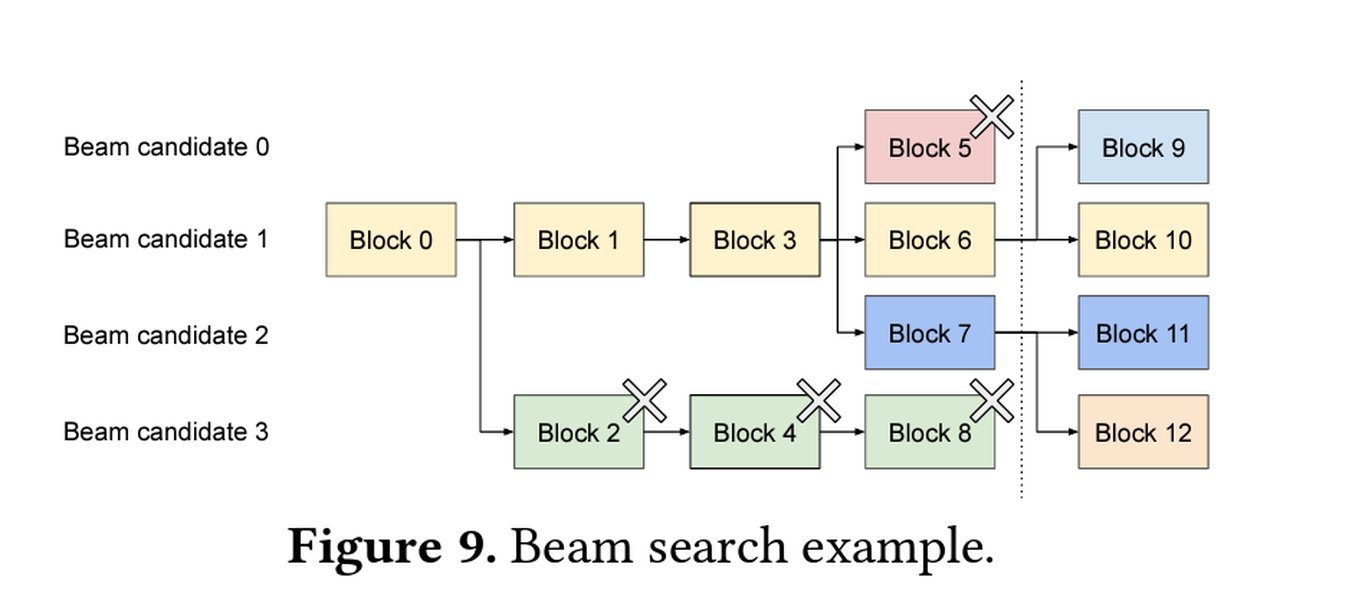
PagedAttention通过分页机制高效管理KV缓存
Continuous Batching:实现不间断的GPU高效处理
传统的静态批处理(Static Batching)要求等待一个批次中的所有请求都完成后才能开始下一个批次的处理,或者需要将不同长度的序列填充到相同长度,这会导致GPU在请求生成速率不均或序列长度差异较大时出现空闲,降低了硬件利用率。vLLM采用连续批处理(Continuous Batching,也称动态批处理或迭代级调度)来克服这一限制。
- 动态请求入队: 新的请求可以在当前批次处理过程中动态加入,无需等待整个批次完成。vLLM的调度器会在每个解码步骤后检查是否有新的请求或已完成的请求。
- 最大化GPU利用率: 这种机制使得GPU能够持续处理数据流,显著减少了空闲时间,从而提高了整体吞吐量。即使在低并发或请求到达时间不确定的情况下,也能保持较高的GPU利用率。
- 降低平均延迟: 请求无需长时间等待凑齐批次,一旦GPU有计算能力处理,就可以被调度执行,从而降低了请求的平均等待时间和首个Token的生成延迟(ITL)。
KV缓存的其他优化
除了PagedAttention,vLLM还采用了其他KV缓存优化技术:
前缀缓存 (Prefix Caching)
对于多轮对话或具有共享前缀的请求,vLLM支持前缀缓存。这意味着一旦某个前缀的KV状态被计算并缓存,后续请求如果包含相同的前缀,可以直接复用这部分缓存,避免重复计算,从而加速响应。这是一种零开销的技术,能有效提升特定场景下的性能。
分块预填充 (Chunked Prefill)
当处理非常长的输入序列(预填充阶段)时,一次性计算整个序列的KV缓存可能会消耗大量显存并导致处理延迟。vLLM的`enable-chunked-prefill`选项允许将大型预填充请求分割成较小的块进行处理,并将这些块与解码请求一起批处理。这有助于更平滑地管理显存峰值,并改善长上下文场景下的响应速度和吞吐量。
vLLM优化技术影响因素雷达图
下图展示了vLLM中几种关键优化技术在不同性能维度上的主观评估影响。这些维度包括吞吐量提升、延迟降低、内存效率、批处理能力、易用性以及硬件普适性。数值越高代表在该维度的正面影响越大或表现越优越(评分范围3-10,不从0开始以突出差异)。此图表旨在提供一个直观的比较,帮助理解各项技术的核心优势。
关键参数调优指南
vLLM提供了丰富的参数配置项,允许用户根据具体应用场景和硬件环境进行细致调优,以达到最佳性能。
核心性能参数
gpu_memory_utilization (GPU显存利用率)
此参数控制vLLM预分配给KV缓存的GPU显存占总可用显存的百分比。默认值通常为0.9(即90%)。增加此值可以为KV缓存提供更多空间,减少因空间不足导致的请求抢占和重计算,从而可能提高吞吐量,尤其对于长序列或大模型。但设置过高可能导致其他进程显存不足。建议从0.9开始,根据实际负载和显存情况调整。
max_num_batched_tokens (最大批处理Token数)
该参数定义了单个批次中可以处理的最大Token总数(包括输入和生成的部分)。此值影响批处理的规模。较大的值通常能带来更高的吞吐量,因为GPU可以一次处理更多数据,但可能会增加首个Token的延迟(ITL)。较小的值可能降低ITL,但吞吐量可能受限。推荐根据模型大小、GPU型号和期望的吞吐量/延迟平衡点进行调整。例如,对于小型模型在大型GPU上,可以尝试大于8096的值以获得最优吞吐量;有些场景下,16384甚至更高也是可行的。
max_model_len (模型最大长度)
设置模型能处理的最大序列长度(上下文窗口大小)。此参数会影响KV缓存的预分配大小。应根据所用模型的固有最大上下文长度以及应用需求来设定。例如,如果模型支持16384的上下文,可以将此值设为16384。
kv_cache_dtype (KV缓存数据类型)
指定KV缓存的数据类型。设置为 'auto' 通常是最佳选择,vLLM会自动选择合适的精度(如FP16或BF16)。在某些情况下,显式设置为 'fp8' (如果硬件支持且模型兼容FP8量化)可以进一步减少显存占用并可能加速计算,但这属于一种量化策略。
功能启用参数
enable-prefix-caching:启用前缀缓存功能,对多轮对话等场景有益。enable-chunked-prefill:启用对长预填充序列的分块处理。
下表总结了部分关键参数及其调优建议:
| 参数 (Parameter) | 描述 (Description) | 建议调优方向 (Recommended Tuning Direction) |
|---|---|---|
gpu_memory_utilization |
GPU显存用于KV缓存的比例 | 通常设为0.9或更高,根据实际显存和并发需求调整,避免OOM。 |
max_num_batched_tokens |
单批次最大Token总数 | 增大以提高吞吐量,减小以降低首Token延迟。需实验找到平衡点。 |
max_model_len |
模型支持的最大序列长度 | 根据模型规格和应用需求设置,影响KV缓存分配。 |
tensor_parallel_size |
张量并行度(使用的GPU数量) | 在多GPU环境下,设为可用的GPU数量以充分利用并行计算能力。 |
kv_cache_dtype |
KV缓存的数据类型 | 推荐 'auto'。可尝试 'fp8' (FP8 E4M3 无缩放) 以节省显存,需硬件和模型支持。 |
enable_prefix_caching |
是否启用前缀缓存 | 对于多轮对话或有共享上下文的场景,启用可加速。 |
enable_chunked_prefill |
是否启用分块预填充 | 对于非常长的输入序列,启用有助于管理显存峰值和提高响应性。 |
调度与并行处理优化
vLLM不仅在内存管理上创新,其调度机制和并行处理能力也是性能提升的关键。
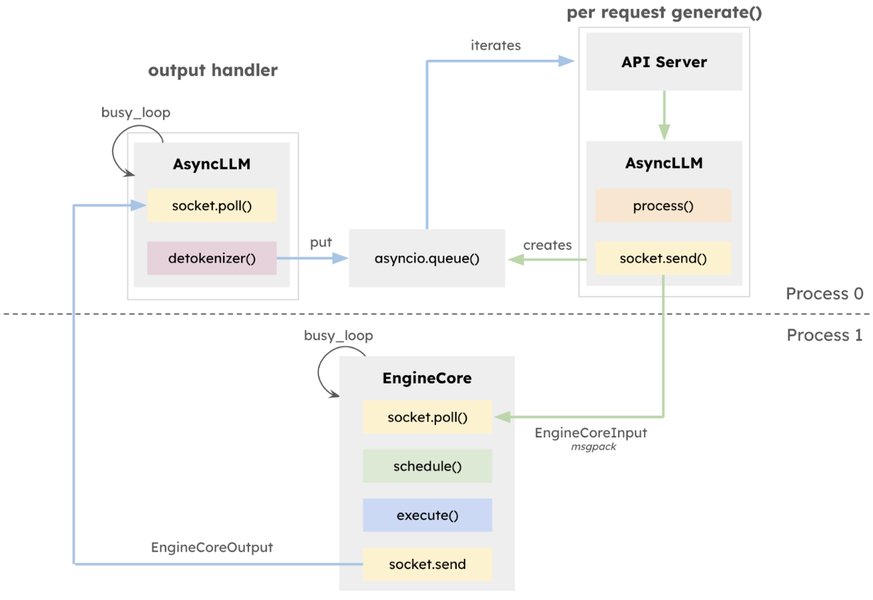
vLLM V1版本服务器架构,展示了其高效的请求处理流程
异步输出与多步调度
vLLM采用了先进的调度策略来最小化CPU开销并保持GPU高度繁忙:
- 多步调度 (Multi-Step Scheduling): 允许一次性批处理多个调度步骤,而不是每个Token生成后都进行一次完整的调度决策。这能更有效地规划GPU任务,减少调度器本身的开销,从而保持GPU的持续饱和状态,有助于降低延迟并提高吞吐量。
- 异步输出处理 (Asynchronous Output Processing): 将Token的生成与网络传输等I/O操作解耦。生成的Token可以异步地发送给客户端,而不会阻塞后续的计算过程。这对于流式输出场景尤其重要,能显著提高并发处理能力。例如,在Llama 70B模型上,此优化据称可将4xH100 GPU集群的吞吐量提高28%。
张量并行 (Tensor Parallelism)
对于无法在单个GPU上完整加载的大型模型,或者为了进一步提升计算速度,vLLM支持张量并行。通过设置 tensor_parallel_size 参数(例如,设为服务器上的GPU数量),vLLM可以将模型的权重张量分割并分布到多个GPU上进行并行计算。这不仅使得能够运行更大的模型,还能通过并行化注意力和前馈网络等计算密集型操作来缩短推理时间。合理的张量并行配置是最大化多GPU服务器吞吐量的关键。
进程分离 (Process Separation)
在vLLM的某些版本(如v0.6.0)中引入了进程分离机制。通过将Python主进程与CUDA计算进程分离,可以消除Python全局解释器锁(GIL)以及其他CPU密集型操作(如请求解析、日志记录)对GPU计算的潜在争抢和干扰。这种分离有助于降低CPU瓶颈,进一步提升GPU的有效利用率和整体系统性能,据称可带来约40%的性能提升。
vLLM 优化策略心智导图
以下心智导图概述了vLLM主要的优化策略和相关技术点,帮助您从宏观上理解vLLM如何实现高性能推理服务。
模型量化与硬件适配
除了上述核心技术,模型量化和广泛的硬件支持也是vLLM提升效率和普适性的重要方面。
模型量化 (Model Quantization)
量化是通过降低模型参数(权重)和/或激活值的数值精度来减小模型大小和加速计算的技术。vLLM支持多种量化方案:
- FP8量化: 特别是对于NVIDIA Hopper架构(如H100)等支持FP8计算的硬件,使用FP8(例如E4M3格式)进行动态或静态量化可以显著减少显存占用并加速推理,同时尽可能保持模型精度。vLLM对FP8有良好支持,通常是性能和精度之间的一个很好平衡点。
- INT8量化: vLLM也支持如AWQ (Activation-aware Weight Quantization) 和GPTQ (Generalized Post-Training Quantization) 等INT8量化方法。这些方法通常能实现更高的压缩率,但可能需要更仔细的校准以维持模型性能。
- 注意事项: 某些量化方案(如早期的bitsandbytes库中的部分功能)可能与vLLM的高效批处理机制不太兼容,可能导致速度下降。因此,在选择量化方法时,建议优先考虑vLLM原生或明确支持的方案,并进行充分的基准测试。
硬件兼容性与优化
vLLM致力于在多种硬件平台上提供高性能推理:
- NVIDIA GPU: 这是vLLM主要优化和测试的平台,对从Pascal到最新的Hopper和Blackwell架构都有良好支持。
- AMD GPU: 通过ROCm软件栈,vLLM也逐步增强了对AMD Instinct系列等GPU的支持。
- Intel硬件: Intel正在积极贡献代码,以优化vLLM在Intel Xeon CPU以及Intel Arc和Gaudi系列GPU/加速器上的性能。
- Google TPU: vLLM社区也在探索和优化其在Google TPU上的部署。
这种广泛的硬件兼容性使得用户可以根据成本效益和现有基础设施灵活选择部署方案。针对特定硬件的优化,如利用硬件原生的低精度计算单元(如NVIDIA Tensor Cores),是vLLM持续提升性能的一部分。
观看视频,了解更多关于如何使用vLLM优化LLM推理性能的信息。 (来源: YouTube - Red Hat)
此视频概述了vLLM如何通过其创新技术(如PagedAttention和连续批处理)来加速大型语言模型的推理过程。它解释了vLLM相较于传统方法的优势,并展示了其易用性和强大的性能表现,对于希望提升LLM服务效率的开发者而言,这是一个很好的入门介绍。
性能基准测试与实践建议
为了最大化vLLM的性能,进行针对性的基准测试和遵循一些实践建议至关重要。
进行基准测试
vLLM项目通常会提供基准测试脚本(例如在其GitHub仓库中),或者可以使用兼容OpenAI API风格的负载生成工具(如 `llmperf` 或自定义脚本)来衡量性能。关注的关键指标包括:
- 吞吐量 (Throughput): 通常以每秒处理的序列数(seq/sec)或每秒生成的Token数(tokens/sec)来衡量。
- 首Token延迟 (Initial Token Latency, ITL): 从发送请求到接收到第一个生成Token的时间。
- 每输出Token时间 (Time Per Output Token, TPOT): 生成后续Token的平均时间。
- GPU利用率和显存占用。
通过调整不同的参数组合(如 `max_num_batched_tokens`, `gpu_memory_utilization`, `tensor_parallel_size` 等)并运行基准测试,可以找到最适合您特定模型、硬件和负载特性的配置。
实践建议
- 从默认参数开始: vLLM的默认参数通常是一个不错的起点。
- 逐步调优: 一次更改一个主要参数,观察其对性能指标的影响。
- 考虑负载特性: 如果应用场景对延迟非常敏感(如实时聊天机器人),可能需要牺牲一些吞吐量来优化ITL和TPOT。如果追求最大吞吐量(如离线批处理任务),则可以调高批处理相关参数。
- 监控系统资源: 使用 `nvidia-smi` 或其他监控工具检查GPU利用率、显存使用情况和温度,确保系统稳定运行。
- 多实例部署: 对于非常高的并发需求,可以考虑在单个服务器上运行多个vLLM实例(如果GPU资源允许),或者在多个服务器上部署vLLM,并使用负载均衡器(如LiteLLM Router)分发请求。
- 保持vLLM更新: vLLM项目迭代迅速,新版本通常会带来性能改进和新功能。
据报告,vLLM v0.6.0版本在Llama 8B模型上实现了2.7倍的吞吐量提升和5倍的TPOT降低;在Llama 70B模型上,吞吐量提升1.8倍。相较于Hugging Face Transformers基线,vLLM平均可达到24倍以上的吞吐提升,相较于TGI(Transformers Generation Interface),提升可达3.5倍。这些数字展示了vLLM的巨大潜力。
常见问题解答 (FAQ)
vLLM相较于其他推理框架(如Hugging Face Transformers、TGI)有何核心优势?
vLLM的核心优势在于其创新的内存管理技术PagedAttention和高效的Continuous Batching机制。PagedAttention极大减少了KV缓存的内存碎片和冗余,显著提高了GPU显存利用率,使得在相同硬件下能服务更大模型或更高并发。Continuous Batching则通过动态请求处理,保持GPU持续高效运行,大幅提升吞吐量并降低延迟。综合来看,vLLM通常能在吞吐量和延迟方面提供比传统框架(如直接使用Hugging Face Transformers进行推理)高出数倍甚至数十倍的性能,也常优于其他优化框架如TGI。
如何为我的特定LLM模型和硬件选择最佳的vLLM参数组合?
选择最佳参数组合通常需要实验和基准测试。首先,了解您的模型(大小、最大上下文长度)和硬件(GPU型号、显存大小、数量)。
- 从
gpu_memory_utilization=0.9开始,根据显存占用调整。 - 调整
max_num_batched_tokens:对于高吞吐量目标,尝试逐步增大此值;对于低延迟目标,可能需要较小值。观察吞吐量和延迟指标的变化。 - 设置
max_model_len为模型的实际最大上下文长度。 - 如果有多GPU,设置
tensor_parallel_size为可用GPU数。 - 对于支持的硬件,可以尝试
kv_cache_dtype='fp8'等量化选项。 - 使用与您预期负载相似的请求模式进行基准测试,记录吞吐量、延迟等指标,找到最优平衡点。
没有一刀切的答案,关键在于系统性测试和迭代优化。
PagedAttention具体是如何工作的,它与传统注意力机制中的KV缓存有何不同?
传统注意力机制中,每个序列的KV缓存通常需要在显存中占据一块连续的空间。当序列长度不一时,这会导致内存碎片化(外部碎片),即有很多小的空闲显存块但没有足够大的连续块来容纳新的序列。此外,不同请求之间的KV缓存通常是独立存储的,即使它们有共同的前缀。
PagedAttention借鉴操作系统虚拟内存管理:
- 分页存储: 将KV缓存逻辑上划分为固定大小的“块”或“页”。这些页在物理显存中可以非连续存储,从而解决了外部碎片问题。
- 动态映射: 维护一个逻辑块到物理块的映射表。
- 内存共享: 当多个序列共享相同的前缀时(例如,在beam search或多个采样路径中),它们的逻辑KV缓存块可以映射到相同的物理显存块。只有当某个序列需要修改这部分共享内容时,才会通过“写时复制”(Copy-on-Write)机制为其分配新的物理块。这极大地减少了内存浪费。
因此,PagedAttention能更有效地利用显存,支持更大的批处理规模和更长的序列,从而提高吞吐量。
vLLM支持哪些类型的模型量化技术,选择时应注意什么?
vLLM支持多种模型量化技术,旨在减少模型大小、降低显存占用并加速推理。主要包括:
- FP8 量化: 对于支持FP8(如E4M3、E5M2格式)的现代GPU(如NVIDIA Hopper H100),vLLM可以利用硬件加速FP8计算。可以通过设置
kv_cache_dtype='fp8'以及模型本身的权重采用FP8格式来实现。 - INT8 量化: vLLM支持常见的INT8后训练量化(PTQ)方法,如AWQ (Activation-aware Weight Quantization) 和 GPTQ (Generalized Post-Training Quantization)。这些方法通常需要预先对模型进行量化处理。
- 其他低精度格式: 如FP16和BF16,虽然不是严格意义上的“量化到更低位”,但vLLM默认会使用这些半精度格式以平衡性能和精度。
选择时应注意:
- 硬件支持: 确保您的硬件支持所选的量化格式(特别是FP8)。
- 模型兼容性: 并非所有模型都能在量化后保持良好性能,可能需要进行精度评估。
- vLLM集成度: 优先选择vLLM原生支持或社区验证过的量化方案,以确保与PagedAttention、Continuous Batching等核心优化兼容。
- 性能测试: 量化后务必进行基准测试,评估对吞吐量、延迟和实际任务精度的影响。避免使用可能与vLLM批处理机制冲突的量化库(如某些场景下的bitsandbytes)。
推荐探索
若想进一步深入了解vLLM的优化与应用,您可能对以下相关问题感兴趣:
- vLLM在多GPU环境下的最佳部署实践是什么?
- 如何为特定的LLM模型选择vLLM的量化策略以平衡性能与精度?
- vLLM的PagedAttention技术与其他注意力机制优化(如FlashAttention)有何区别与联系?
- 详细解析vLLM的连续批处理(Continuous Batching)如何影响推理延迟和吞吐量指标?
参考资料
本文综合了以下来源的信息,为您提供关于vLLM优化的全面视角:
Last updated May 15, 2025