
探索 ChatGPT 背後的力量:大型語言模型究竟是什麼?
揭開正在革新人機互動方式的人工智慧
重點摘要
- 核心定義: 大型語言模型(LLM)是透過海量文本數據訓練而成的人工智慧(AI),能夠深入理解語義、上下文並生成類似人類的自然語言。
- 技術基礎: 牠們通常基於擁有數十億甚至數兆個參數(權重)的 Transformer 神經網路架構,利用自注意力機制高效處理語言資訊,從而能夠執行複雜的語言任務。 - 應用廣泛: LLM 的能力涵蓋文本生成、語言翻譯、問答系統、內容摘要、情感分析乃至程式碼編寫,被廣泛應用於聊天機器人、內容創作工具、客戶服務和數據分析等領域。
大型語言模型(LLM)是什麼?
大型語言模型(Large Language Model,簡稱 LLM)是一種先進的人工智慧程式,屬於深度學習領域。具體來說,牠們是由包含大量參數(通常是數十億到數兆個可訓練的權重)的類神經網路構成的語言模型。這些模型的核心目標是理解、處理、生成甚至翻譯人類的自然語言。
牠們之所以被稱為「大型」,正是因為其龐大的參數數量。這些參數是在訓練過程中透過分析海量的文本數據(例如來自網際網路的文章、書籍、對話等)學習和調整得來的。這個規模賦予了 LLM 強大的能力,能夠捕捉語言的細微差別,包括語法規則、語義關係、上下文邏輯以及潛在的知識。
LLM 的根本目標是模仿人類理解和使用語言的方式。透過學習大量的語言範例,牠們能夠分析使用者輸入的文本(稱為提示或 prompt),理解其意圖和語境,並生成連貫、相關且聽起來自然的文本回應。這種能力使牠們能夠執行從簡單的句子補全到複雜的文章撰寫或程式碼生成等多種任務。
LLM 如何運作?
大型語言模型的運作依賴於先進的深度學習架構和精密的訓練過程。
基礎:Transformer 架構
現代 LLM 的技術基石是「Transformer」模型架構,該架構於 2017 年被提出。Transformer 的一個革命性創新是「自注意力機制」(Self-Attention Mechanism)。這個機制允許模型在處理一個詞語時,同時權衡句子中所有其他詞語的重要性,無論它們在句子中的距離有多遠。這使得模型能夠更好地理解長距離的依賴關係和複雜的上下文,這對於理解自然語言至關重要。
Transformer 架構通常包含編碼器(Encoder)和解碼器(Decoder)部分,或僅包含其中之一(如 GPT 系列主要使用解碼器)。這種架構支援並行處理輸入序列,大大提高了訓練效率,使得在極大規模的數據集上訓練擁有數十億參數的模型成為可能。
訓練過程
LLM 的訓練通常分為兩個主要階段:
預訓練階段(Pre-training)
在這個階段,模型會接觸海量的、未標記的文本數據。這些數據可能來自公開的網頁、數位圖書館、程式碼庫等多種來源。訓練的目標通常是「自監督學習」,例如,模型學習預測句子中的下一個詞語,或者填補文本中被遮蔽的詞語。透過完成這些任務,模型逐漸學習到語言的底層結構、語法規則、詞彙知識以及一定程度的世界常識。
這個階段需要極大的計算資源和時間,但它為模型打下了一個通用的語言理解基礎。
微調階段(Fine-tuning)
經過預訓練的通用模型,可以針對特定的任務或應用場景進行進一步的訓練,這個過程稱為微調。微調通常使用規模較小、帶有標籤的數據集,這些數據與目標任務直接相關(例如,用於翻譯任務的平行語料庫,或用於問答機器人的問答對)。
透過微調,可以讓模型在特定領域或任務上表現得更好,例如提高其在醫學問答、法律文件摘要或特定風格寫作方面的能力。這種兩階段的訓練方法使得 LLM 具有高度的靈活性和適應性。
主要能力與特色
大型語言模型展現出多方面的強大能力,使其成為推動當前 AI 發展的核心技術之一。牠們的主要特色和能力包括:
- 文本生成(Text Generation): 能夠根據提示創作出連貫、多樣化且符合語境的文本,涵蓋文章、故事、詩歌、郵件、甚至劇本等。
- 自然語言理解(Natural Language Understanding, NLU): 深入理解文本的意義,包括識別語義、情感傾向、實體關係和上下文邏輯。
- 機器翻譯(Machine Translation): 在多種語言之間進行高質量的翻譯,促進跨語言溝通。
- 問答與對話(Question Answering & Dialogue): 理解問題並提供相關答案,或進行多輪、有上下文連貫性的對話,是聊天機器人和虛擬助理的基礎。
- 程式碼生成(Code Generation): 根據自然語言描述或現有程式碼片段,生成、補全或除錯程式碼,提升開發效率。代表性應用如 GitHub Copilot。 - 文本摘要(Summarization): 將長篇文章或文件濃縮成簡潔的摘要,快速提取核心資訊。
- 多任務處理能力(Multi-task Capability): 一個經過預訓練的 LLM 可以透過微調或僅僅透過不同的提示,就適應並執行多種不同的自然語言任務,而無需為每個任務從頭訓練模型。
LLM 的這些能力使其極具靈活性,能夠應用於廣泛的場景,並且其性能隨著模型規模和訓練數據的增加而不斷提升。
視覺化 LLM 概念
為了更直觀地理解大型語言模型的構成要素和關聯性,以下的思維導圖(Mindmap)概述了其核心概念,包括定義、關鍵技術、訓練過程、主要能力以及廣泛的應用領域。
比較 LLM 的各項能力
不同的 LLM 可能會在特定能力上有所側重。例如,有些模型可能更擅長創意寫作,而另一些則在邏輯推理或程式碼生成方面表現更佳。下面的雷達圖旨在示意性地比較幾種假設性的 LLM 類型在不同維度上的相對能力。請注意,這是一個概念性的說明,而非基於精確的基準測試數據。
圖表展示了四種假想的 LLM 類型:通用型 (Generalist)、創意型 (Creative)、分析型 (Analytical) 和程式碼專用型 (Coding-focused),並比較了牠們在創意、邏輯推理、程式碼能力、翻譯準確度、對話流暢度和事實準確性這六個方面的表現(分數範圍 3-10,分數越高代表能力越強)。
LLM 的多元應用場景
大型語言模型的通用性和強大能力使其在眾多領域都有廣泛的應用潛力,正在改變許多行業的運作方式:
內容創作與行銷
LLM 可以自動生成或輔助撰寫各種類型的內容,例如部落格文章、新聞稿、產品描述、社交媒體貼文、廣告文案甚至是創意寫作。這不僅提高了內容生產的效率,還能提供新的靈感來源。
客戶服務與支援
基於 LLM 的聊天機器人(Chatbots)和虛擬助理能夠 24/7 全天候提供即時、智能的客戶支援。牠們可以理解客戶的查詢,提供標準答案,處理常見問題,甚至引導客戶完成某些流程,從而提升客戶滿意度並降低人力成本。
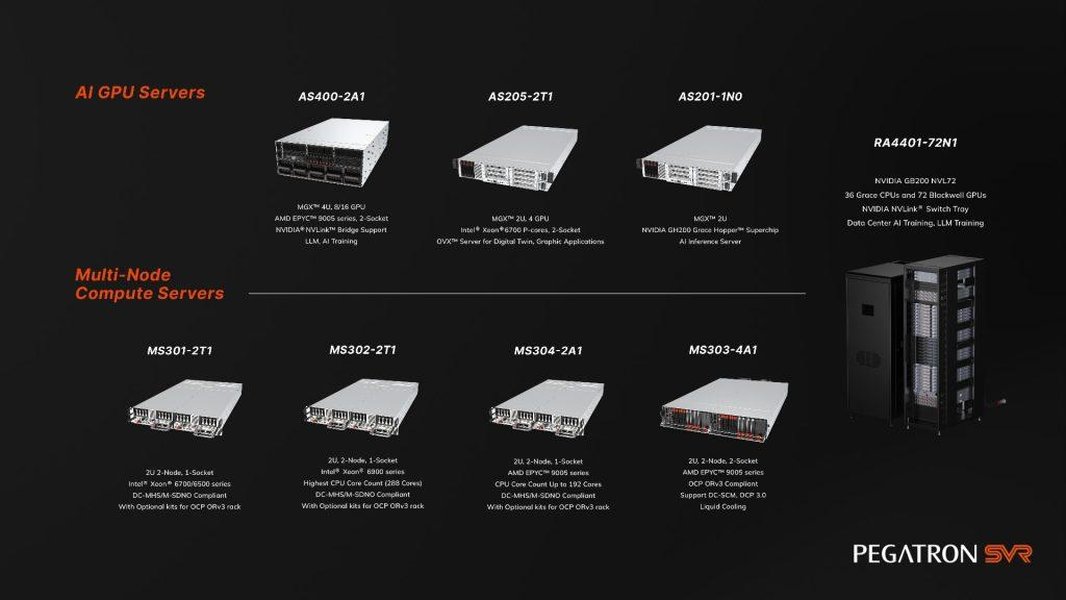
專為 AI 和 LLM 設計的伺服器,為這些模型的訓練和部署提供強大的計算支持。
程式設計與開發
LLM 正在成為開發者的得力助手。牠們可以根據自然語言描述生成程式碼片段、自動完成程式碼、解釋程式碼邏輯、協助除錯,甚至將程式碼從一種語言轉換為另一種語言。這大大加速了軟體開發的過程。
教育與研究
在教育領域,LLM 可以作為個性化輔導工具,回答學生的問題,生成練習題,甚至提供寫作建議。在研究領域,牠們可以協助研究人員快速閱讀和總結大量文獻,分析文本數據,或產生研究假設。
商業智慧與數據分析
LLM 能夠處理和分析大量的非結構化文本數據,例如客戶評論、市場報告、社交媒體討論等。牠們可以從中提取關鍵資訊、識別趨勢、進行情感分析,並生成易於理解的報告,輔助企業做出更明智的決策。
翻譯與全球溝通
憑藉強大的多語言處理能力,LLM 正顯著改善機器翻譯的質量和流暢度,打破語言隔閡,促進全球範圍內的資訊交流與合作。
著名的 LLM 範例
近年來,許多科技公司和研究機構都推出了各自的大型語言模型。以下表格列出了一些廣為人知的 LLM 及其特點,展現了該領域的多樣性:
| 模型 (Model) | 開發者 (Developer) | 主要焦點/特色 (Key Focus/Features) |
|---|---|---|
| GPT 系列 (例如 GPT-4) | OpenAI | 通用型,強大的文本生成與理解能力,推動了生成式 AI 的普及。 |
| BERT / PaLM / Gemini | 早期專注於理解上下文 (BERT),後期發展為強大的對話應用 (LaMDA/PaLM) 和多模態能力 (Gemini)。 | |
| Llama 系列 | Meta | 側重於開源,促進學術研究和社區發展,有多種規模和針對性微調版本。 |
| Claude 系列 | Anthropic | 強調 AI 安全和倫理,採用「憲法 AI」方法進行訓練,旨在產生更有益、誠實和無害的回應。 |
| Code Llama | Meta | 基於 Llama 微調,專門針對程式碼生成、補全和理解任務進行了優化。 |
深入了解 LLM
想要更深入地了解大型語言模型的基本概念嗎?下面的影片來自 Google 的 AI 課程,用淺顯易懂的方式介紹了 LLM 是什麼,非常適合初學者建立基礎認識。
優勢與挑戰
大型語言模型作為一項突破性技術,帶來了巨大的機遇,但也伴隨著一些挑戰。
LLM 的優勢
- 高度通用性: 同一個基礎模型可以應用於多種不同的語言任務,適應性強。
- 卓越性能: 在許多自然語言處理基準測試中達到了頂尖水平,能夠生成高質量、類似人類的文本。
- 提升效率: 可以自動化許多原本需要人工處理的語言相關任務,如寫作、摘要、翻譯、客服等,顯著提高生產力。
- 降低門檻: 使得開發複雜的 AI 應用(如智能助手、內容生成工具)更加容易,推動了 AI 技術的普及。
需要克服的挑戰
- 準確性與「幻覺」: LLM 有時會產生看似合理但事實上錯誤或無意義的資訊,這種現象被稱為「幻覺」(Hallucination)。
- 數據偏見: 模型可能學習並放大了訓練數據中存在的偏見(如性別、種族、文化偏見),導致生成帶有歧視性的內容。
- 計算成本高昂: 訓練和運行大型 LLM 需要龐大的計算資源(GPU/TPU)和能源消耗,成本高昂。
- 可解釋性差: LLM 的決策過程往往像一個「黑盒子」,難以完全理解牠們為何會生成特定的輸出,這給除錯和信任帶來挑戰。
- 倫理與安全風險: 可能被用於生成假新聞、進行網絡釣魚、侵犯版權或隱私等惡意目的,需要建立相應的規範和防護措施。
常見問題
推薦探索
- 深入了解大型語言模型的具體訓練步驟和所需資源。
- 探索 Transformer 架構的核心機制(如自注意力)及其對 NLP 領域的影響。
- 比較市面上主流的大型語言模型(例如 GPT、BERT、Llama、Claude)在架構、能力和應用上的主要差異。
- 發掘大型語言模型在不同行業(如金融、醫療、電商)的成功應用案例與效益。
參考資料
 aws.amazon.com
aws.amazon.com
Last updated April 27, 2025