
揭開隨機性的面紗:深入了解隨機變數的奧秘
從擲骰子到股市波動,理解量化不確定性的關鍵概念
在我們的日常生活中,充滿了各種不確定性。從明天是否會下雨,到投資的報酬率,再到擲骰子的結果,這些事件的結果都是隨機的。為了能更精確地描述、分析並預測這些隨機現象,數學家和統計學家引入了一個強大的工具——隨機變數(Random Variable)。這個概念是機率論與統計學的基石,幫助我們將抽象的隨機事件轉化為可量化的數值,從而進行科學的研究與決策。
精華摘要
- 核心定義: 隨機變數是一個將隨機實驗的每個可能結果映射到一個數值的函數,而非變數本身具有隨機性。
- 主要類型: 分為離散隨機變數(取有限或可數值,如擲骰子點數)和連續隨機變數(取區間內任意值,如身高)。
- 關鍵作用: 它是連接理論機率與現實世界數據分析的橋樑,廣泛應用於科學、工程、金融等多個領域。
什麼是隨機變數?
核心定義
許多人聽到「隨機變數」這個詞,可能會誤以為它是一個會隨機變化的數。然而,更精確地說,隨機變數並不是一個傳統意義上的「變數」,而是一個函數。它的作用是將一個隨機實驗中所有可能發生的結果(構成樣本空間)與一個數值(通常是實數)建立對應關係。換句話說,它為每一個隨機結果貼上了一個數字標籤,使得我們可以對這些結果進行數學運算和分析。
不只是「隨機」
雖然隨機變數處理的是隨機現象,但變數本身(作為一個函數)的定義是確定的。它的「隨機性」體現在其取值是由隨機實驗的結果決定的。例如,我們定義一個隨機變數 X 代表擲一次公平骰子的點數。這個函數 X 將「擲出1點」映射到數字 1,「擲出2點」映射到數字 2,依此類推。實驗結果是隨機的,但 X 這個映射規則是固定的。
量化結果
隨機變數最重要的功能是量化隨機事件的結果。如果沒有隨機變數,我們很難對「擲出正面」或「明天下雨」這類非數值的結果進行統計分析。通過將這些結果轉換成數字(例如,正面=1,反面=0;下雨=1,不下雨=0),我們就能夠計算平均值(期望值)、變異程度(變異數)等重要的統計量,從而更深入地理解隨機現象的規律。
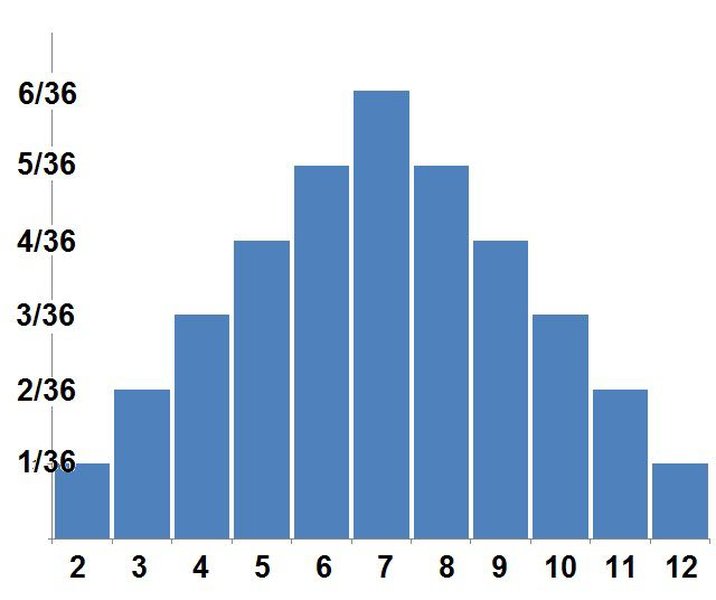
上圖:擲骰子的點數(1到6)是典型的離散隨機變數,每個點數出現的機率是1/6。
隨機變數的類型
根據隨機變數可能取的值的特性,主要可以分為兩種類型:離散隨機變數和連續隨機變數。
離散隨機變數 (Discrete Random Variable)
定義與特性
離散隨機變數是指其可能取的值是有限個或可數無限個的。這些值通常是互相獨立的、可以一一列舉出來的點,例如整數。它們之間存在明確的間隔,不能取這些間隔中的值。
機率質量函數 (Probability Mass Function - PMF)
離散隨機變數的機率分佈由機率質量函數(PMF)描述。PMF 直接給出了隨機變數取每一個特定值的機率。如果 X 是一個離散隨機變數,其 PMF 通常表示為 \( P(X = x_i) = p_i \),其中 \( x_i \) 是 X 可能取的一個值,\( p_i \) 是取該值的機率。所有可能值的機率總和必須等於 1,即 \( \sum p_i = 1 \)。
\[ P(X = x_i) = p_i \quad \text{且} \quad \sum_{i} P(X = x_i) = 1 \]常見範例
- 擲一枚硬幣的結果(例如,令 X=1 代表正面,X=0 代表反面)。
- 擲一顆骰子的點數(X 可以是 1, 2, 3, 4, 5, 6)。
- 一個小時內到達某服務台的顧客數量(可以是 0, 1, 2, ...)。
- 一批產品中的瑕疵品數量。
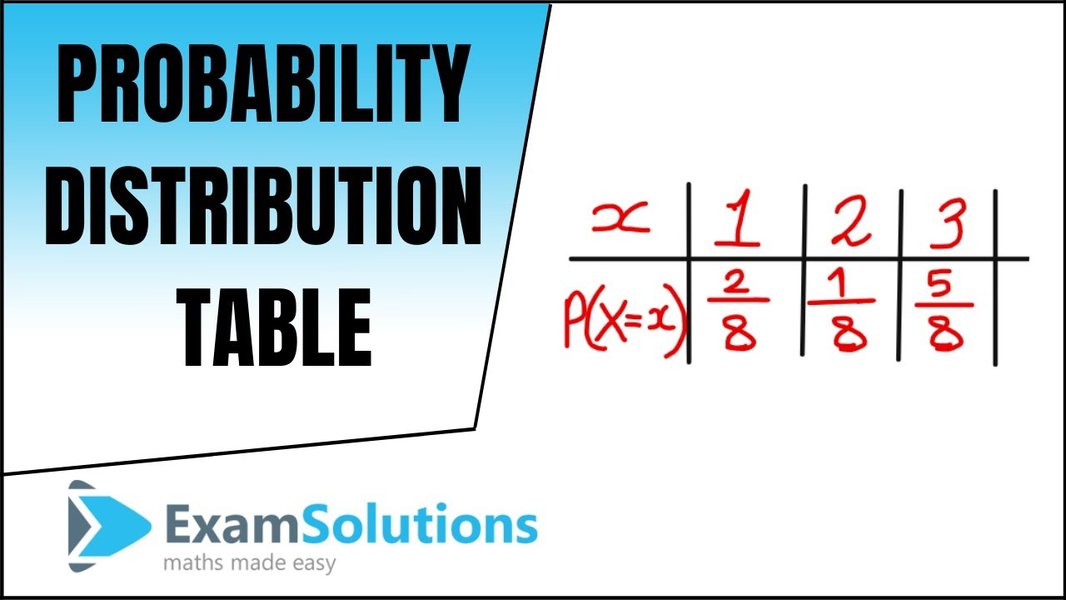
上圖:離散隨機變數的機率分佈可以用表格或圖形(如條形圖)來表示,顯示每個可能值的機率。
連續隨機變數 (Continuous Random Variable)
定義與特性
連續隨機變數是指其可能取的值可以覆蓋一個或多個連續的區間,可以是無限多個值。在任意兩個可能的取值之間,都還存在無限多個其他可能的取值。因此,連續隨機變數的值是無法一一列舉的。
機率密度函數 (Probability Density Function - PDF)
連續隨機變數的機率分佈由機率密度函數(PDF)描述,通常表示為 \( f(x) \)。與 PMF 不同,PDF 本身 \( f(x) \) 並不代表隨機變數取特定值 x 的機率。事實上,對於任何連續隨機變數,其取任何單一特定值的機率恆為 0(因為可能的值有無限多個)。PDF 的值表示隨機變數在該點附近的機率密度。我們關心的是隨機變數落在某個區間 \( [a, b] \) 內的機率,這可以通過對 PDF 在該區間上進行積分得到:
\[ P(a \leq X \leq b) = \int_a^b f(x) \, dx \]整個定義域上的積分值必須等於 1,即 \( \int_{-\infty}^{\infty} f(x) \, dx = 1 \),並且 \( f(x) \geq 0 \) 對於所有 x。
常見範例
- 一個人的身高或體重。
- 某個城市一天的溫度或降雨量。
- 完成一項任務所需的時間。
- 股票的價格(雖然實際交易價格是離散的,但在模型中常視為連續)。
- 測量誤差。

上圖:常態分佈(鐘形曲線)是連續隨機變數最常見的機率分佈之一,其機率由曲線下的面積表示。
隨機變數概念圖
為了更清晰地展示隨機變數的核心概念及其關聯,以下提供一個心智圖:
將隨機實驗結果
映射到數值的函數"] id2["類型"] id2a["離散 (Discrete)"] id2a1["有限/可數值"] id2a2["機率質量函數 (PMF)"] id2a3["範例:骰子點數、硬幣"] id2b["連續 (Continuous)"] id2b1["區間內任意值"] id2b2["機率密度函數 (PDF)"] id2b3["範例:身高、溫度"] id3["關鍵性質"] id3a["機率分佈
(描述取值可能性)"] id3b["期望值 E(X)
(長期平均值)"] id3c["變異數 Var(X)
(離散程度)"] id4["應用"] id4a["統計學"] id4b["機率論"] id4c["金融與經濟"] id4d["工程學"] id4e["自然科學"]
這個心智圖總結了隨機變數的定義、兩種主要類型(離散與連續)及其特徵、關鍵的統計性質(如機率分佈、期望值和變異數),以及它在不同領域的廣泛應用。
隨機變數特性比較
離散和連續隨機變數在許多方面存在顯著差異。下面的雷達圖從六個維度比較了這兩種類型,分數越高(或描述越趨向外圈)通常意味著更複雜或涵蓋範圍更廣(評分範圍 1-5,其中 1 代表最低/最簡單,5 代表最高/最複雜)。
這個比較圖直觀地展示了兩種類型隨機變數在不同特性上的差異。例如,連續隨機變數可以取無限多個值(數值數量得分高),其機率計算涉及積分(區間機率計算得分高),概念上相對不那麼直觀(概念直觀性得分較低)。
隨機變數的關鍵性質與計算
一旦定義了隨機變數及其機率分佈,我們就可以計算一些重要的統計量來描述其行為特性。
期望值 (Expected Value - E(X))
期望值是隨機變數所有可能取值按其機率加權的平均值,代表了在大量重複實驗中,我們預期隨機變數的平均結果會趨近於哪個值。它常被用來衡量隨機變數的「中心趨勢」。
- 對於離散隨機變數 X: \[ E(X) = \mu = \sum_{i} x_i \cdot P(X = x_i) \]
- 對於連續隨機變數 X: \[ E(X) = \mu = \int_{-\infty}^{\infty} x \cdot f(x) \, dx \]
例如,擲一顆公平骰子的期望值是 \( E(X) = 1 \cdot \frac{1}{6} + 2 \cdot \frac{1}{6} + \dots + 6 \cdot \frac{1}{6} = 3.5 \)。
變異數 (Variance - Var(X))
變異數衡量隨機變數的取值相對於其期望值的離散程度或波動性。變異數越大,表示隨機變數的取值越分散;變異數越小,表示取值越集中在期望值附近。
- 對於離散隨機變數 X: \[ \text{Var}(X) = \sigma^2 = E[(X - \mu)^2] = \sum_{i} (x_i - \mu)^2 \cdot P(X = x_i) \]
- 對於連續隨機變數 X: \[ \text{Var}(X) = \sigma^2 = E[(X - \mu)^2] = \int_{-\infty}^{\infty} (x - \mu)^2 \cdot f(x) \, dx \]
變異數也可以通過 \( \text{Var}(X) = E(X^2) - [E(X)]^2 \) 來計算。
標準差 (Standard Deviation)
標準差是變異數的平方根,記為 \( \sigma = \sqrt{\text{Var}(X)} \)。它與原始數據具有相同的單位,因此更容易解釋其離散程度。
離散 vs 連續隨機變數總結
下表總結了離散和連續隨機變數之間的主要區別:
| 特徵 (Feature) | 離散隨機變數 (Discrete RV) | 連續隨機變數 (Continuous RV) |
|---|---|---|
| 數值類型 (Value Type) | 特定的、分離的值 (例如:0, 1, 2) | 連續區間內的任何值 (例如:[0, 1] 之間所有實數) |
| 可能值的數量 (Number of Values) | 有限個 或 可數無限個 | 不可數無限個 |
| 機率函數 (Probability Func.) | 機率質量函數 (PMF): P(X=x) | 機率密度函數 (PDF): f(x) |
| 特定值的機率 (Prob. of Specific Value) | P(X=x) ≥ 0 | P(X=x) = 0 |
| 區間機率計算 (Interval Prob. Calc.) | 對區間內所有值的 P(X=x) 進行加總 | 對區間內的 PDF f(x) 進行積分 |
| 常見範例 (Examples) | 擲骰子點數、硬幣出現正面次數、客戶數量 | 身高、體重、溫度、時間、測量值 |
理解這兩種變數的區別對於選擇合適的統計模型和分析方法至關重要。
視覺化解釋:隨機變數入門
觀看以下影片可以幫助您更直觀地理解隨機變數的基本概念,特別是它作為一個函數將樣本空間映射到數值的過程。
這個來自可汗學院(Khan Academy)的影片介紹了隨機變數的基礎定義和概念,並透過簡單的例子說明其作用。它強調隨機變數是連接機率理論與實際數據分析的關鍵工具。
隨機變數的重要性與應用
連接理論與實務
隨機變數最大的價值在於它提供了一種數學框架,使我們能夠系統地研究和分析不確定性。它將現實世界中看似混亂隨機的事件,轉化為可以用數學語言描述和處理的對象(機率分佈、期望值、變異數等),從而實現從理論機率到實際數據分析和預測的過渡。
跨領域應用
隨機變數的概念幾乎滲透到所有需要處理不確定性的領域:
- 統計學與機率論: 構成這兩個學科的核心基礎。
- 金融與經濟學: 用於模擬股票價格、利率、匯率的波動,評估投資風險(如VaR),建立經濟模型。
- 工程學: 用於信號處理、可靠性分析、品質控制、模擬複雜系統(如交通流量)。
- 物理與化學: 描述粒子運動(如布朗運動)、放射性衰變等隨機過程。
- 生物學與醫學: 分析基因遺傳、疾病傳播、藥物反應的隨機性。
- 計算機科學: 用於算法分析(如隨機算法)、機器學習(如貝葉斯網路)、模擬。
- 氣象學: 預測溫度、降水等天氣變數。
- 作業研究: 優化排隊系統、庫存管理等。
理解隨機變數及其性質,是進行現代數據分析、風險管理和科學研究不可或缺的能力。
常見問題 (FAQ)
隨機變數本身是隨機的嗎? ➕
不完全是。隨機變數是一個定義明確的函數,它將隨機實驗的結果映射到數值。是實驗的結果具有隨機性,導致隨機變數的取值具有隨機性,但函數本身(映射規則)是確定的。
離散和連續變數的主要區別是什麼? ➕
主要區別在於它們可能取的值的性質:
- 離散變數只能取有限個或可數無限個特定的、分離的值(如 0, 1, 2, ...)。
- 連續變數可以取某個區間內無限多個、不可數的任意值(如身高可以是 170.1cm, 170.11cm 等)。
這個區別決定了它們使用不同的機率函數(PMF vs PDF)和計算方法。
期望值代表什麼? ➕
期望值(E(X))代表隨機變數的長期平均值。如果我們重複進行同一個隨機實驗非常多次,並記錄下每次實驗中隨機變數的取值,那麼這些取值的平均數會趨近於期望值。它是衡量隨機變數中心趨勢的一個重要指標。
為什麼需要隨機變數? ➕
我們需要隨機變數,因為它們提供了一種標準化和量化的方式來處理隨機現象和不確定性。通過將各種隨機結果(無論是數值還是非數值)轉換為數字,隨機變數使得:
- 可以應用強大的數學和統計工具進行分析。
- 可以計算期望值、變異數等描述性統計量。
- 可以建立機率模型來預測未來事件的可能性。
- 可以在不同領域中用統一的語言來描述和比較隨機性。
參考資料
- Random variable - Wikipedia
- Random Variable: Definition, Types, How Its Used, and Example - Investopedia
- Random Variables | Definition, Types, Formulas & Examples - BYJU'S
- Random Variable - GeeksforGeeks
- Random Variables - Math is Fun
推薦探索
Last updated April 14, 2025