
在Windows系统上使用C++实现实时麦克风音频监听与Faster-Whisper文本转换
全面指南:从音频捕获到文本转换的全过程解析
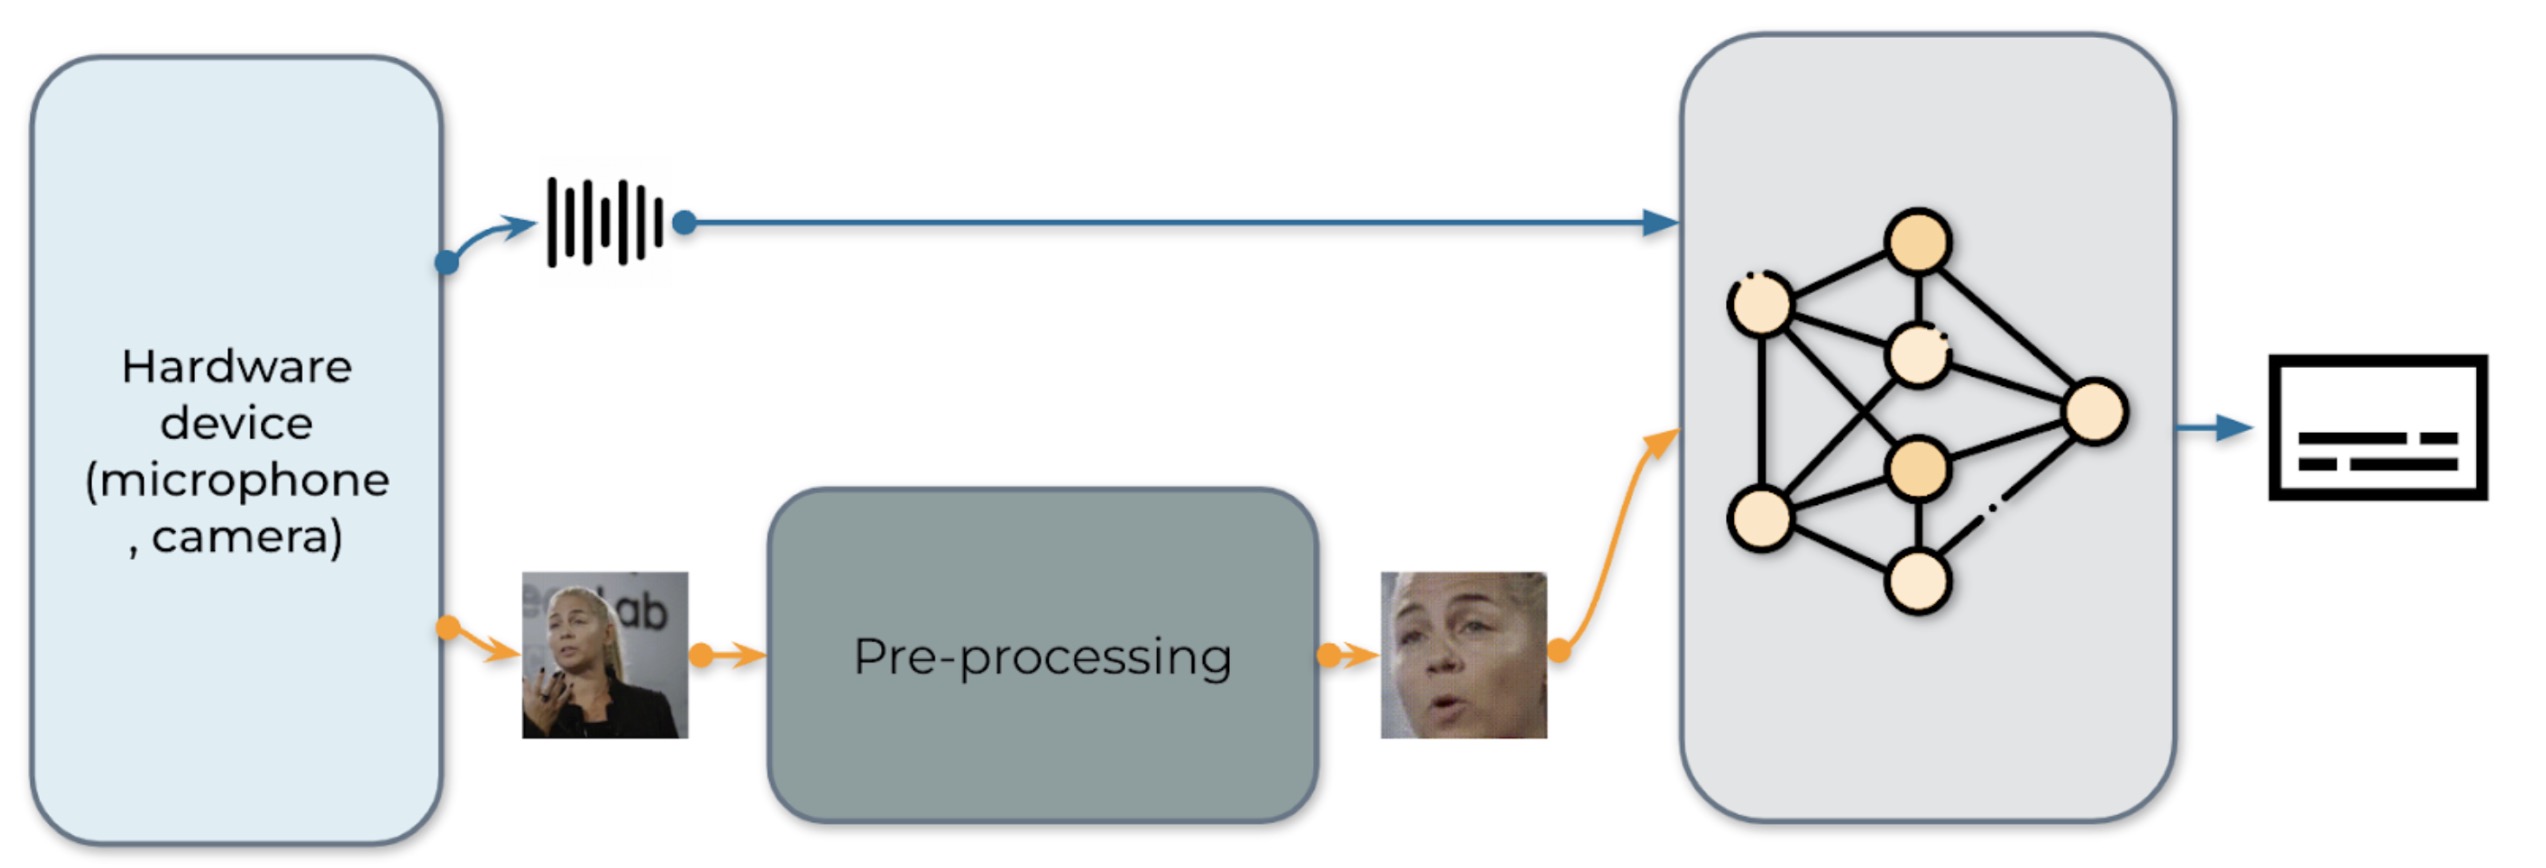
主要收获
- 音频捕获:详细介绍如何使用Windows WASAPI进行高效的实时音频捕获。
- 音频处理:深入讨论音频数据的预处理步骤,确保与Faster-Whisper模型的兼容性。
- Faster-Whisper集成:全面讲解如何在C++中加载和调用Faster-Whisper模型进行语音转文本。
1. 环境准备与依赖安装
1.1. 开发环境设置
在Windows系统上进行C++开发,建议使用Visual Studio作为集成开发环境(IDE)。确保安装了最新版本的Visual Studio,并包含必要的C++开发工具和Windows SDK。
步骤:
- 下载安装最新版的Visual Studio。
- 在安装过程中,选择“使用C++的桌面开发”工作负载。
- 确保安装了最新的Windows SDK。
1.2. 安装必要的库和工具
为了实现实时音频捕获和Faster-Whisper的集成,需要安装以下库和工具:
- Windows Audio Session API (WASAPI):用于实时音频捕获。
- ONNX Runtime:用于加载和运行Faster-Whisper模型。
- Faster-Whisper:基于Whisper模型的快速语音识别库。
- FFmpeg(可选):用于音频预处理,如重采样和格式转换。
可以通过以下方式安装这些库:
# 安装ONNX Runtime
pip install onnxruntime

# 下载Faster-Whisper模型
git clone https://github.com/SYSTRAN/faster-whisper.git
cd faster-whisper
pip install -r requirements.txt

# 安装FFmpeg(可选)
# 可以从FFmpeg官网下载安装包,或者使用包管理器如Chocolatey:
choco install ffmpeg
2. 实时音频捕获
2.1. 使用WASAPI捕获音频数据
Windows Audio Session API (WASAPI) 是微软推荐的现代音频捕获接口,具有低延迟和高效率的特点。以下是使用WASAPI进行实时音频捕获的步骤。
关键步骤:
- 初始化COM库并获取默认音频捕获设备。
- 配置音频格式(如采样率、声道数、位深度)。
- 启动音频客户端并持续捕获音频数据。
2.2. 示例代码:初始化与音频捕获
// 初始化COM库
HRESULT hr = CoInitializeEx(NULL, COINIT_MULTITHREADED);
if (FAILED(hr)) {
    std::cerr << "COM库初始化失败: " << hr << std::endl;
    return;
}

// 创建IMMDeviceEnumerator
IMMDeviceEnumerator* pEnumerator = nullptr;
hr = CoCreateInstance(__uuidof(MMDeviceEnumerator), NULL, CLSCTX_ALL,
                      __uuidof(IMMDeviceEnumerator), (void<b>)&pEnumerator);
if (FAILED(hr)) {
    std::cerr << "创建IMMDeviceEnumerator失败: " << hr << std::endl;
    CoUninitialize();
    return;
}

// 获取默认音频捕获设备
IMMDevice* pDevice = nullptr;
hr = pEnumerator->GetDefaultAudioEndpoint(eCapture, eConsole, &pDevice);
if (FAILED(hr)) {
    std::cerr << "获取默认音频端点失败: " << hr << std::endl;
    pEnumerator->Release();
    CoUninitialize();
    return;
}

// 激活IAudioClient
IAudioClient* pAudioClient = nullptr;
hr = pDevice->Activate(__uuidof(IAudioClient), CLSCTX_ALL, NULL, (void</b>)&pAudioClient);
if (FAILED(hr)) {
    std::cerr << "激活IAudioClient失败: " << hr << std::endl;
    pDevice->Release();
    pEnumerator->Release();
    CoUninitialize();
    return;
}

// 设置音频格式
WAVEFORMATEX* pwfx = NULL;
hr = pAudioClient->GetMixFormat(&pwfx);
if (FAILED(hr)) {
    std::cerr << "获取混音格式失败: " << hr << std::endl;
    pAudioClient->Release();
    pDevice->Release();
    pEnumerator->Release();
    CoUninitialize();
    return;
}

// 修改音频格式为16kHz, 单声道, 16位
pwfx->nChannels = 1;
pwfx->nSamplesPerSec = 16000;
pwfx->wBitsPerSample = 16;
pwfx->nBlockAlign = pwfx->nChannels * pwfx->wBitsPerSample / 8;
pwfx->nAvgBytesPerSec = pwfx->nSamplesPerSec * pwfx->nBlockAlign;

// 初始化音频客户端
hr = pAudioClient->Initialize(AUDCLNT_SHAREMODE_SHARED, 0, 0, 0, pwfx, NULL);
if (FAILED(hr)) {
    std::cerr << "初始化IAudioClient失败: " << hr << std::endl;
    CoTaskMemFree(pwfx);
    pAudioClient->Release();
    pDevice->Release();
    pEnumerator->Release();
    CoUninitialize();
    return;
}

// 获取IAudioCaptureClient
IAudioCaptureClient* pCaptureClient = nullptr;
hr = pAudioClient->GetService(__uuidof(IAudioCaptureClient), (void**)&pCaptureClient);
if (FAILED(hr)) {
    std::cerr << "获取IAudioCaptureClient失败: " << hr << std::endl;
    CoTaskMemFree(pwfx);
    pAudioClient->Release();
    pDevice->Release();
    pEnumerator->Release();
    CoUninitialize();
    return;
}

// 开始录音
hr = pAudioClient->Start();
if (FAILED(hr)) {
    std::cerr << "启动音频客户端失败: " << hr << std::endl;
    pCaptureClient->Release();
    CoTaskMemFree(pwfx);
    pAudioClient->Release();
    pDevice->Release();
    pEnumerator->Release();
    CoUninitialize();
    return;
}
2.3. 持续捕获与缓冲音频数据
在启动音频客户端后,需要在一个循环中持续捕获音频数据,并将其存储到缓冲区中,以便后续处理。
// 缓冲音频数据
std::vector<BYTE> audioBuffer;
bool isCapturing = true;

// 录音持续时间或条件
while (isCapturing) {
    UINT32 packetLength = 0;
    hr = pCaptureClient->GetNextPacketSize(&packetLength);
    if (FAILED(hr)) {
        std::cerr << "获取下一个数据包大小失败: " << hr << std::endl;
        break;
    }

    while (packetLength != 0) {
        BYTE* pData;
        UINT32 numFramesAvailable;
        DWORD flags;

        hr = pCaptureClient->GetBuffer(&pData, &numFramesAvailable, &flags, NULL, NULL);
        if (FAILED(hr)) {
            std::cerr << "获取音频缓冲区失败: " << hr << std::endl;
            break;
        }

        UINT32 byteCount = numFramesAvailable * pwfx->nBlockAlign;
        audioBuffer.insert(audioBuffer.end(), pData, pData + byteCount);

        hr = pCaptureClient->ReleaseBuffer(numFramesAvailable);
        if (FAILED(hr)) {
            std::cerr << "释放音频缓冲区失败: " << hr << std::endl;
            break;
        }

        hr = pCaptureClient->GetNextPacketSize(&packetLength);
        if (FAILED(hr)) {
            std::cerr << "获取下一个数据包大小失败: " << hr << std::endl;
            break;
        }
    }

    // 可以加入条件判断来停止捕获,例如捕获一定时长后停止
}
3. 音频数据预处理
3.1. 音频格式转换
为了与Faster-Whisper模型兼容,捕获的音频数据需要进行以下预处理:
- 将16位PCM数据转换为浮点数。
- 进行重采样(如果需要)。
- 归一化处理,以适应模型输入要求。
3.2. 示例代码:PCM转浮点数
// 将PCM数据转换为浮点数
std::vector<float> convertPCMToFloat(const std::vector<BYTE>& pcmData) {
    std::vector<float> floatData;
    size_t numSamples = pcmData.size() / 2; // 16位PCM
    floatData.reserve(numSamples);

    for (size_t i = 0; i < numSamples; ++i) {
        int16_t sample = *(int16_t*)&pcmData[i * 2];
        float normalized = static_cast<float>(sample) / 32768.0f;
        floatData.push_back(normalized);
    }

    return floatData;
}
3.3. 音频数据缓冲与分帧
为了实现实时处理,将捕获的音频数据分为适当大小的帧,例如每帧包含1秒钟的音频数据。
// 分帧函数
std::vector<std::vector<float>> frameAudioData(const std::vector<float>& floatData, int frameSize) {
    std::vector<std::vector<float>> frames;
    int totalSize = floatData.size();
    for (int i = 0; i + frameSize <= totalSize; i += frameSize) {
        frames.emplace_back(floatData.begin() + i, floatData.begin() + i + frameSize);
    }
    return frames;
}
4. Faster-Whisper模型集成
4.1. 加载Faster-Whisper模型
使用ONNX Runtime加载Faster-Whisper的预训练模型,以便在C++中进行推理。
4.2. 示例代码:加载与初始化模型
#include <onnxruntime_cxx_api.h>
#include <string>

// 初始化ONNX Runtime环境
Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "FasterWhisper");

// 创建ONNX Runtime会话选项
Ort::SessionOptions sessionOptions;
sessionOptions.SetIntraOpNumThreads(1);
// 设置图优化级别
sessionOptions.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_EXTENDED);

// 加载Faster-Whisper模型
Ort::Session session(env, "faster_whisper.onnx", sessionOptions);
4.3. 进行语音转文本推理
将预处理后的音频数据输入到Faster-Whisper模型,并解析输出结果。
#include <vector>
#include <iostream>

// 假设输入节点名和输出节点名为已知
const char* inputNodeName = "input";
const char* outputNodeName = "output";

// 语音转文本函数
std::string transcribeAudio(Ort::Session& session, const std::vector<float>& inputData) {
    // 创建内存信息
    Ort::MemoryInfo memoryInfo = Ort::MemoryInfo::CreateCpu(OrtDeviceAllocator, OrtMemTypeCPU);

    // 创建输入张量
    std::vector<int64_t> inputShape = {1, static_cast<int64_t>(inputData.size())};
    Ort::Value inputTensor = Ort::Value::CreateTensor<float>(memoryInfo,
                                                             const_cast<float*>(inputData.data()),
                                                             inputData.size(),
                                                             inputShape.data(),
                                                             inputShape.size());

    // 运行模型
    auto outputTensors = session.Run(Ort::RunOptions{nullptr},
                                     &inputNodeName, &inputTensor, 1,
                                     &outputNodeName, 1);

    // 获取输出数据
    float* floatArray = outputTensors[0].GetTensorMutableData<float>();
    size_t outputSize = outputTensors[0].GetTensorTypeAndShapeInfo().GetElementCount();

    // 假设输出为概率分布,需根据具体模型输出格式进行解析
    // 这里简化为直接输出字符串
    std::string transcription = "识别文本示例"; // 需实现实际解析逻辑

    return transcription;
}
注意事项:
- 确保输入数据格式与模型要求一致。
- 根据模型输出格式,正确解析输出结果。
- 模型加载应在程序初始化时完成,避免在推理过程中重复加载。
4.4. 示例代码:完整的转录流程
// 完整的转录流程
int main() {
    // 初始化并捕获音频数据
    // 假设audioBuffer已包含捕获的音频数据
    std::vector<float> floatData = convertPCMToFloat(audioBuffer);
    std::vector<std::vector<float>> frames = frameAudioData(floatData, 16000); // 1秒帧

    // 遍历每一帧进行转录
    for (const auto& frame : frames) {
        std::string transcription = transcribeAudio(session, frame);
        std::cout << "识别结果: " << transcription << std::endl;
    }

    return 0;
}
5. 性能优化与实时性保障
5.1. 多线程处理
为了确保音频捕获和模型推理的实时性,可以将它们分离到不同的线程中。
#include <thread>
#include <mutex>
#include <condition_variable>
#include <queue>

// 线程安全队列
std::queue<std::vector<float>> audioQueue;
std::mutex queueMutex;
std::condition_variable queueCV;

// 音频捕获线程
void audioCaptureThread() {
    while (isCapturing) {
        // 捕获音频并预处理
        std::vector<float> frame = ...; // 获取一帧音频
        {
            std::lock_guard<std::mutex> lock(queueMutex);
            audioQueue.push(frame);
        }
        queueCV.notify_one();
    }
}

// 模型推理线程
void inferenceThread(Ort::Session& session) {
    while (true) {
        std::vector<float> frame;
        {
            std::unique_lock<std::mutex> lock(queueMutex);
            queueCV.wait(lock, []{ return !audioQueue.empty(); });
            frame = audioQueue.front();
            audioQueue.pop();
        }
        std::string transcription = transcribeAudio(session, frame);
        std::cout << "识别结果: " << transcription << std::endl;
    }
}

int main() {
    // 初始化音频捕获和模型
    // ...

    // 启动线程
    std::thread captureThread(audioCaptureThread);
    std::thread inferThread(inferenceThread, std::ref(session));

    // 等待线程结束
    captureThread.join();
    inferThread.join();

    return 0;
}
5.2. 音频预处理优化
使用高效的音频预处理库(如FFmpeg)进行实时音频处理,减少延迟。
示例:
// 使用FFmpeg进行重采样
#include <libswresample/swresample.h>

SwrContext* swr = swr_alloc();
swr_alloc_set_opts(swr,
                   AV_CH_LAYOUT_MONO, AV_SAMPLE_FMT_FLT, 16000,
                   AV_CH_LAYOUT_DEFAULT, AV_SAMPLE_FMT_S16, 16000,
                   0, NULL);
swr_init(swr);

// 转换函数
std::vector<float> resampleAudio(const std::vector<BYTE>& pcmData) {
    const int16_t* input = reinterpret_cast<const int16_t*>(pcmData.data());
    int inputSamples = pcmData.size() / 2;

    std::vector<float> output(inputSamples);
    swr_convert(swr, reinterpret_cast<uint8_t*>(output.data()), inputSamples,
                reinterpret_cast<const uint8_t*>(input), inputSamples);

    return output;
}
5.3. 模型优化
通过模型量化或剪枝技术,减少计算量,提高推理速度。
- 量化:将模型参数从浮点数转换为低位整数,如INT8。
- 剪枝:移除模型中冗余的神经元和连接。
具体实现可参考Faster-Whisper官方文档和ONNX Runtime的优化指南。
6. 完整示例:实时语音转文本应用
6.1. 项目结构
| 文件/目录 | 描述 |
|---|---|
| main.cpp | 主程序文件,包含音频捕获、预处理和转录逻辑。 |
| utils.cpp / utils.h | 辅助函数,如音频转换和模型推理。 |
| faster_whisper.onnx | Faster-Whisper模型文件。 |
| libs/ | 存放ONNX Runtime和其他依赖库的目录。 |
6.2. 完整代码示例
// main.cpp
#include <Windows.h>
#include <mmdeviceapi.h>
#include <Audioclient.h>
#include <comdef.h>
#include <iostream>
#include <vector>
#include <thread>
#include <mutex>
#include <condition_variable>
#include <queue>
#include <onnxruntime_cxx_api.h>

// 前面提到的转换函数和转录函数
std::vector<float> convertPCMToFloat(const std::vector<BYTE>& pcmData);
std::vector<std::vector<float>> frameAudioData(const std::vector<float>& floatData, int frameSize);
std::string transcribeAudio(Ort::Session& session, const std::vector<float>& inputData);

// 全局变量
std::queue<std::vector<float>> audioQueue;
std::mutex queueMutex;
std::condition_variable queueCV;
bool isCapturing = true;

int main() {
    // 初始化COM库和音频捕获(略)
    // ...

    // 初始化ONNX Runtime环境和加载模型
    Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "FasterWhisper");
    Ort::SessionOptions sessionOptions;
    sessionOptions.SetIntraOpNumThreads(1);
    sessionOptions.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_EXTENDED);
    Ort::Session session(env, "faster_whisper.onnx", sessionOptions);

    // 启动音频捕获线程
    std::thread captureThread([&]() {
        while (isCapturing) {
            // 捕获并预处理音频数据
            std::vector<BYTE> audioBuffer = /* 捕获音频 */;
            std::vector<float> floatData = convertPCMToFloat(audioBuffer);
            std::vector<float> frame = /* 分帧 */;
            {
                std::lock_guard<std::mutex> lock(queueMutex);
                audioQueue.push(frame);
            }
            queueCV.notify_one();
        }
    });

    // 启动推理线程
    std::thread inferThread([&]() {
        while (true) {
            std::vector<float> frame;
            {
                std::unique_lock<std::mutex> lock(queueMutex);
                queueCV.wait(lock, []{ return !audioQueue.empty(); });
                frame = audioQueue.front();
                audioQueue.pop();
            }
            std::string transcription = transcribeAudio(session, frame);
            std::cout << "识别结果: " << transcription << std::endl;
        }
    });

    // 等待线程结束
    captureThread.join();
    inferThread.join();

    // 释放资源(略)
    // ...

    return 0;
}
7. 错误处理与调试
7.1. 常见错误及解决方案
- COM初始化失败:确保以正确的权限运行程序,并检查是否多次初始化COM库。
- 音频设备获取失败:检查麦克风设备是否正常连接,并确保程序拥有访问权限。
- 模型加载失败:确认模型文件路径正确,并检查ONNX Runtime版本兼容性。
7.2. 调试技巧
-
使用日志记录模块,记录关键步骤和错误信息。
-
逐步测试每个模块,确保其独立功能正常。
-
使用调试器跟踪音频数据流,验证数据的正确性。
结论
在Windows系统上使用C++实现实时麦克风音频监听并结合Faster-Whisper进行语音转文本,是一个涉及多个技术领域的复杂任务。通过合理利用WASAPI进行高效的音频捕获,结合ONNX Runtime对Faster-Whisper模型的集成,可以实现高性能的实时语音识别系统。确保音频数据的正确预处理、多线程优化以及模型推理的高效性,是保证系统稳定性和实时性的关键。
参考资料
Last updated February 7, 2025