
เจาะลึกกลไก XGBoost และ LightGBM: ปรับ Loss เลือก Feature อย่างไรให้โมเดลทรงพลัง?
ไขความลับเบื้องหลังสองอัลกอริทึม Gradient Boosting ยอดนิยม สู่การสร้างแบบจำลองที่แม่นยำและรวดเร็ว
XGBoost (Extreme Gradient Boosting) และ LightGBM (Light Gradient Boosting Machine) คือสองไลบรารีการเรียนรู้ของเครื่อง (Machine Learning) ที่ทรงพลังและได้รับความนิยมอย่างสูงในหมู่นักวิทยาศาสตร์ข้อมูล ทั้งคู่มีพื้นฐานมาจากเทคนิค Gradient Boosting ซึ่งสร้างโมเดลจากการรวมต้นไม้ตัดสินใจ (Decision Trees) จำนวนมากเข้าด้วยกัน อย่างไรก็ตาม ทั้งสองอัลกอริทึมมีรายละเอียดและกลยุทธ์ที่แตกต่างกันในการปรับฟังก์ชันการสูญเสีย (Loss Function) การเลือกคุณลักษณะ (Feature Selection) สำหรับการสร้างต้นไม้ และการปรับแต่งพารามิเตอร์ (Hyperparameter Tuning) เพื่อให้ได้ประสิทธิภาพสูงสุด การทำความเข้าใจความแตกต่างเหล่านี้จะช่วยให้คุณเลือกใช้เครื่องมือที่เหมาะสมกับปัญหาและชุดข้อมูลของคุณได้ดียิ่งขึ้น
ประเด็นสำคัญที่คุณจะค้นพบ
- กลยุทธ์การสร้างต้นไม้ที่แตกต่าง: XGBoost มักใช้การเติบโตแบบ Level-wise ในขณะที่ LightGBM โดดเด่นด้วยการเติบโตแบบ Leaf-wise ซึ่งส่งผลต่อความเร็วและความซับซ้อนของโมเดล
- ประสิทธิภาพในการจัดการข้อมูล: LightGBM ถูกออกแบบมาเพื่อความเร็วและประสิทธิภาพในการใช้หน่วยความจำที่เหนือกว่า โดยเฉพาะกับชุดข้อมูลขนาดใหญ่ ด้วยเทคนิค Histogram-based algorithm และการจัดการ Categorical Features ที่ดีกว่า
- การปรับแต่ง Loss Function และ Feature: ทั้งสองอัลกอริทึมมีวิธีการเฉพาะในการคำนวณ Gradient และ Hessian เพื่อปรับ Loss และเกณฑ์ในการเลือก Feature ที่ดีที่สุดสำหรับแต่ละโหนดของต้นไม้ รวมถึงการรองรับ Custom Loss Functions
หัวใจหลัก: Gradient Boosting Framework
ทั้ง XGBoost และ LightGBM สร้างขึ้นบนหลักการของ Gradient Boosting ซึ่งเป็นกระบวนการสร้างโมเดルแบบวนซ้ำ โดยแต่ละต้นไม้ใหม่ที่เพิ่มเข้ามาจะพยายามแก้ไขข้อผิดพลาด (Residuals) ที่เหลือจากต้นไม้ชุดก่อนหน้า เป้าหมายคือการลดค่า Loss Function โดยรวมของโมเดลลงเรื่อยๆ
ในการทำเช่นนี้ อัลกอริทึมจะคำนวณ Gradient (อนุพันธ์อันดับหนึ่ง) และ Hessian (อนุพันธ์อันดับสอง) ของ Loss Function เทียบกับผลการทำนายปัจจุบัน ข้อมูล Gradient และ Hessian นี้จะถูกนำไปใช้ในการตัดสินใจว่าจะสร้าง Split (การแบ่งโหนด) อย่างไรในต้นไม้ถัดไป เพื่อให้การลด Loss เป็นไปอย่างมีประสิทธิภาพสูงสุด
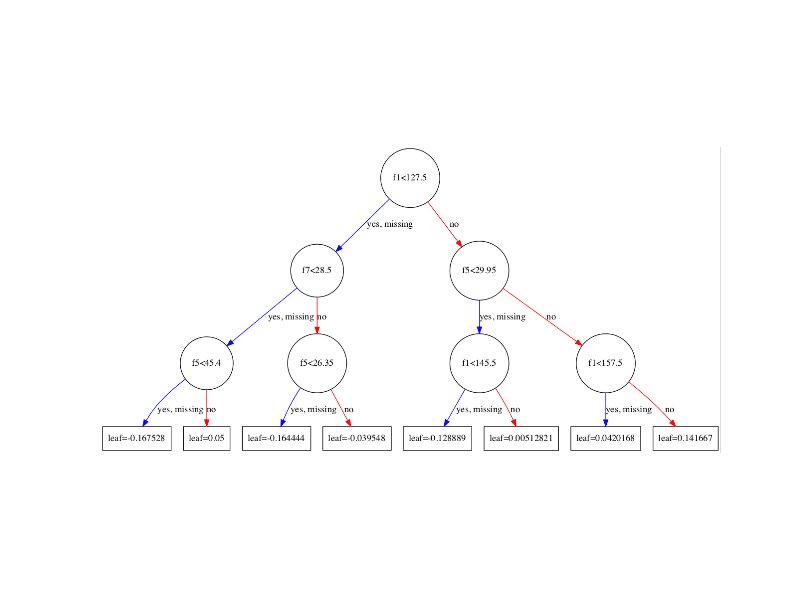
ภาพแสดงโครงสร้างของต้นไม้ตัดสินใจ (Decision Tree) ซึ่งเป็นองค์ประกอบพื้นฐานใน XGBoost และ LightGBM
การปรับ Loss Function: เกณฑ์และวิธีการ
Loss Function คือฟังก์ชันที่วัดความแตกต่างระหว่างค่าที่โมเดลทำนายกับค่าจริง การปรับ Loss Function ให้เหมาะสมเป็นกุญแจสำคัญในการสร้างโมเดลที่มีความแม่นยำ
XGBoost กับการปรับ Loss
การ Regularization เพื่อป้องกัน Overfitting
XGBoost ให้ความสำคัญกับการป้องกัน Overfitting (การที่โมเดลทำงานได้ดีกับข้อมูลที่ใช้ฝึก แต่ทำงานได้ไม่ดีกับข้อมูลใหม่) อย่างมาก โดยใช้เทคนิค Regularization ทั้ง L1 (Lasso) และ L2 (Ridge) กับน้ำหนักของโหนดใบ (Leaf nodes) นอกจากนี้ยังมีการใช้ Shrinkage (หรือ eta ซึ่งเป็น learning rate) เพื่อลดขนาดของการอัปเดตในแต่ละขั้นตอน และ Column Subsampling (การสุ่มเลือก Feature บางส่วนมาใช้ในการสร้างแต่ละต้นไม้) เพื่อเพิ่มความทนทานของโมเดล
การรองรับ Custom Loss Function
XGBoost รองรับ Loss Function มาตรฐานหลากหลายประเภท (เช่น Mean Squared Error สำหรับ Regression, Log Loss สำหรับ Classification) และยังอนุญาตให้ผู้ใช้กำหนด Loss Function เองได้ (Custom Loss Function) โดยผู้ใช้จะต้องระบุ Gradient และ Hessian ของ Loss Function นั้นๆ เพื่อให้ XGBoost สามารถทำการ Optimization ได้อย่างถูกต้อง
LightGBM กับการปรับ Loss
เน้นความเร็วและประสิทธิภาพ
LightGBM ก็รองรับ Loss Function มาตรฐานและ Custom Loss Function เช่นกัน โดยผู้ใช้ต้องคำนวณและส่งค่า Gradient และ Hessian ของ Loss Function ที่กำหนดเอง จุดเด่นของ LightGBM คือการเน้นความเร็วและประสิทธิภาพในการคำนวณ Gradient และ Hessian โดยอาศัยเทคนิค Histogram-based Algorithm ซึ่งจะกล่าวถึงในภายหลัง ทำให้การปรับ Loss ใน LightGBM มักจะรวดเร็วกว่า
Gradient-based One-Side Sampling (GOSS)
LightGBM ยังใช้เทคนิค GOSS ซึ่งจะเก็บข้อมูลที่มี Gradient ขนาดใหญ่ (ข้อมูลที่โมเดลยังทำนายผิดพลาดมาก) ไว้ทั้งหมด และสุ่มตัวอย่างข้อมูลที่มี Gradient ขนาดเล็ก วิธีนี้ช่วยให้โมเดลโฟกัสไปที่ข้อมูลที่ยากต่อการเรียนรู้ โดยไม่สูญเสียความแม่นยำมากนัก แต่ช่วยลดปริมาณข้อมูลที่ต้องพิจารณาในการสร้าง Split ได้อย่างมาก
การสร้างต้นไม้และการเลือก Feature: ความแตกต่างที่สำคัญ
วิธีการสร้างต้นไม้และการเลือก Feature ที่จะใช้ในการแบ่งโหนด (Split) เป็นจุดที่ XGBoost และ LightGBM มีความแตกต่างกันอย่างชัดเจนXGBoost: Level-wise Growth และการจัดการ Feature
การเติบโตของต้นไม้แบบ Level-wise
โดยทั่วไป XGBoost ใช้กลยุทธ์การเติบโตของต้นไม้แบบ Level-wise (หรือ Depth-wise) หมายความว่าอัลกอริทึมจะทำการ Split ทุกโหนดที่อยู่ในระดับความลึก (Level) เดียวกันพร้อมกัน ก่อนที่จะไปยังระดับถัดไป วิธีนี้มักจะสร้างต้นไม้ที่มีความสมดุล (Balanced Tree) และอาจช่วยลดโอกาส Overfitting ในบางสถานการณ์ แต่ก็อาจใช้เวลานานกว่าในการสร้างต้นไม้ที่ลึกมากๆ
การเลือก Split Point และ Categorical Features
ในการเลือก Split Point สำหรับ Feature แต่ละตัว XGBoost แบบดั้งเดิมจะทำการเรียงลำดับค่าของ Feature นั้นๆ เพื่อหาจุดแบ่งที่ดีที่สุด ซึ่งอาจใช้เวลานานสำหรับชุดข้อมูลขนาดใหญ่และ Feature ที่มีค่าที่เป็นไปได้หลากหลาย อย่างไรก็ตาม XGBoost ก็มีทางเลือกในการใช้ Histogram-based Algorithm เพื่อเพิ่มประสิทธิภาพในการเลือก Split Point ได้เช่นกัน สำหรับ Categorical Features (ข้อมูลเชิงกลุ่ม) XGBoost ต้องการให้ผู้ใช้ทำการแปลงข้อมูลเหล่านี้ให้อยู่ในรูปแบบตัวเลขก่อน (เช่น One-Hot Encoding หรือ Label Encoding)
Stochastic Gradient Boosting
XGBoost มักใช้ Stochastic Gradient Boosting โดยการทำ sub-sampling ทั้งข้อมูล (rows) และ features (columns) ในแต่ละรอบการสร้างต้นไม้ เพื่อลดความซับซ้อนในการคำนวณและช่วยป้องกัน overfitting
LightGBM: Leaf-wise Growth และนวัตกรรมเพื่อความเร็ว
การเติบโตของต้นไม้แบบ Leaf-wise
LightGBM ใช้กลยุทธ์การเติบโตของต้นไม้แบบ Leaf-wise (หรือ Best-first) แทนที่จะขยายต้นไม้ทีละระดับ LightGBM จะเลือก Split โหนดใบ (Leaf node) ที่คาดว่าจะให้การลด Loss (Loss Reduction) มากที่สุด โดยไม่คำนึงว่าโหนดนั้นจะอยู่ที่ระดับความลึกใด วิธีนี้สามารถนำไปสู่การสร้างต้นไม้ที่มีรูปร่างไม่สมดุล (Asymmetric Tree) แต่โดยทั่วไปแล้วจะเติบโตได้เร็วกว่าและอาจให้ประสิทธิภาพที่ดีกว่า Level-wise ในหลายกรณี อย่างไรก็ตาม Leaf-wise มีแนวโน้มที่จะ Overfit ได้ง่ายกว่าหากไม่มีการควบคุมพารามิเตอร์ที่เหมาะสม (เช่น num_leaves, max_depth)
Histogram-based Algorithm และ Categorical Features
LightGBM ใช้ Histogram-based Algorithm เป็นหลักในการหา Split Point เทคนิคนี้จะทำการจัดกลุ่มค่าของ Feature (ทั้ง Continuous และ Categorical) ลงใน Bin (ถังข้อมูล) ต่างๆ ก่อนที่จะทำการค้นหา Split Point ที่ดีที่สุด การทำเช่นนี้ช่วยลดเวลาในการค้นหา Split Point และลดการใช้หน่วยความจำลงได้อย่างมาก ทำให้ LightGBM ทำงานได้เร็วกว่า XGBoost โดยเฉพาะอย่างยิ่งกับชุดข้อมูลขนาดใหญ่ นอกจากนี้ LightGBM ยังมีการจัดการกับ Categorical Features โดยตรงได้อย่างมีประสิทธิภาพ โดยไม่จำเป็นต้องทำการ One-Hot Encoding เสมอไป ซึ่งช่วยลดมิติของข้อมูลและเพิ่มความเร็วในการฝึกได้อีกด้วย
Exclusive Feature Bundling (EFB)
สำหรับข้อมูลที่มีความ разреженная (Sparse) สูง LightGBM ใช้เทคนิค EFB เพื่อรวม Feature ที่ไม่ค่อยเกิดพร้อมกัน (Mutually Exclusive Features) เข้าด้วยกันเป็น Feature ใหม่ ซึ่งช่วยลดจำนวน Feature ที่ต้องพิจารณาลงได้โดยไม่สูญเสียข้อมูลมากนัก
การเลือก Feature สำหรับโมเดลโดยรวม (Feature Importance)
ทั้ง XGBoost และ LightGBM มีกลไกในการให้คะแนนความสำคัญของ Feature (Feature Importance Scores) ซึ่งบ่งชี้ว่าแต่ละ Feature มีส่วนช่วยในการลด Loss และปรับปรุงประสิทธิภาพของโมเดลมากน้อยเพียงใด คะแนนเหล่านี้มักคำนวณจากจำนวนครั้งที่ Feature นั้นถูกใช้ในการ Split โหนดภายในต้นไม้ หรือจากการลด Loss สะสมที่เกิดขึ้นจากการ Split ด้วย Feature นั้นๆ
เราสามารถใช้คะแนนความสำคัญของ Feature เหล่านี้ในการเลือก Feature ที่มีคะแนนสูงที่สุดจำนวนหนึ่งเพื่อนำไปสร้างโมเดลใหม่ ซึ่งสามารถช่วยลดมิติของข้อมูล (Dimensionality Reduction) ปรับปรุงประสิทธิภาพของโมเดล ลดเวลาในการฝึกฝน และเพิ่มความสามารถในการตีความโมเดลได้ เทคนิคต่างๆ เช่น Recursive Feature Elimination (RFE) หรือการใช้คลาส SelectFromModel ใน scikit-learn สามารถนำมาประยุกต์ใช้ร่วมกับ Feature Importance ที่ได้จากทั้งสองอัลกอริทึม
ตารางเปรียบเทียบ XGBoost และ LightGBM โดยสรุป
ตารางนี้สรุปความแตกต่างที่สำคัญระหว่าง XGBoost และ LightGBM ในประเด็นต่างๆ เพื่อให้เห็นภาพรวมได้ชัดเจนยิ่งขึ้น:
| คุณลักษณะ | XGBoost | LightGBM |
|---|---|---|
| วิธีการสร้างต้นไม้ (Tree Growth) | Level-wise (เติบโตตามระดับชั้น ทำให้ต้นไม้มีแนวโน้มสมดุล) | Leaf-wise (เติบโตโดยเลือกใบที่ลด Loss ได้มากที่สุด ทำให้เร็วกว่าแต่อาจไม่สมดุล) |
| การจัดการ Categorical Features | ต้องทำการแปลงเป็นตัวเลขก่อน (เช่น One-Hot Encoding, Label Encoding) | รองรับโดยตรงและมีประสิทธิภาพ (ลดขั้นตอน Preprocessing และมักให้ผลดีกว่า) |
| ความเร็วในการฝึก (Training Speed) | ปานกลางถึงสูง (อาจช้ากว่า LightGBM ในชุดข้อมูลขนาดใหญ่มาก) | สูงมาก (โดยเฉพาะกับชุดข้อมูลขนาดใหญ่และมี Feature จำนวนมาก) |
| การใช้หน่วยความจำ (Memory Usage) | ค่อนข้างสูง โดยเฉพาะกับข้อมูลที่มี Feature จำนวนมาก | ต่ำกว่า XGBoost อย่างมีนัยสำคัญ เนื่องจาก Histogram-based Algorithm |
| กลไกหลักในการเพิ่มความเร็ว | Histogram-based (เป็นทางเลือก), Parallel Processing, Regularization | Histogram-based (เป็นหลัก), Leaf-wise Growth, GOSS, EFB |
| การ Regularization | แข็งแกร่งและหลากหลาย (L1, L2, Gamma, Min Child Weight) | มี Regularization (เช่น L1, L2, Min Data in Leaf) แต่ XGBoost อาจมีตัวเลือกที่ละเอียดกว่าในบางแง่มุม |
| ความเสี่ยง Overfitting | น้อยกว่า (เมื่อเทียบกับ Leaf-wise ที่ไม่มีการควบคุมที่ดี) เนื่องจาก Level-wise growth | อาจสูงกว่าหากไม่ควบคุมพารามิเตอร์ เช่น num_leaves, max_depth อย่างระมัดระวัง |
การปรับแต่งพารามิเตอร์ (Hyperparameter Tuning)
การปรับแต่ง Hyperparameters เป็นขั้นตอนสำคัญเพื่อให้ได้ประสิทธิภาพสูงสุดจากทั้ง XGBoost และ LightGBM แม้ว่าทั้งสองจะมีพารามิเตอร์หลายตัวที่คล้ายกัน แต่ก็มีบางตัวที่เฉพาะเจาะจงและส่งผลต่อการทำงานแตกต่างกัน
พารามิเตอร์สำคัญใน XGBoost
eta(หรือlearning_rate): อัตราการเรียนรู้ ควบคุมขนาดของการปรับปรุงโมเดลในแต่ละขั้นตอนmax_depth: ความลึกสูงสุดของแต่ละต้นไม้ ใช้ควบคุมความซับซ้อนของโมเดลและป้องกัน Overfittingmin_child_weight: ผลรวมขั้นต่ำของ Instance weight (Hessian) ที่จำเป็นในโหนดลูก หากการแบ่งโหนดส่งผลให้โหนดลูกมีค่านี้น้อยกว่าที่กำหนด การแบ่งนั้นจะไม่เกิดขึ้นgamma(หรือmin_split_loss): ค่า Loss Reduction ขั้นต่ำที่จำเป็นในการทำการแบ่งโหนดเพิ่มเติมsubsample: อัตราส่วนของ Training instances ที่จะถูกสุ่มเลือกมาใช้ในการสร้างแต่ละต้นไม้colsample_bytree: อัตราส่วนของ Features ที่จะถูกสุ่มเลือกมาใช้ในการสร้างแต่ละต้นไม้reg_alpha(L1 regularization): ค่า Penalty สำหรับ L1 Regularization บนน้ำหนักของใบreg_lambda(L2 regularization): ค่า Penalty สำหรับ L2 Regularization บนน้ำหนักของใบ
พารามิเตอร์สำคัญใน LightGBM
learning_rate: เช่นเดียวกับ XGBoost คืออัตราการเรียนรู้num_leaves: จำนวนใบสูงสุดในหนึ่งต้นไม้ เป็นพารามิเตอร์สำคัญในการควบคุมความซับซ้อนของโมเดลใน LightGBM (เนื่องจากใช้ Leaf-wise growth) ค่าที่สูงขึ้นอาจทำให้ Overfitmax_depth: ความลึกสูงสุดของต้นไม้ แม้จะใช้ Leaf-wise แต่ก็ยังสามารถจำกัดความลึกได้min_data_in_leaf(หรือmin_child_samples): จำนวนข้อมูลขั้นต่ำที่ต้องมีในแต่ละใบfeature_fraction(หรือcolsample_bytree): อัตราส่วนของ Features ที่จะถูกสุ่มเลือกในแต่ละรอบการสร้างต้นไม้ (คล้ายกับcolsample_bytreeใน XGBoost)bagging_fraction(หรือsubsample): อัตราส่วนของข้อมูลที่จะถูกสุ่มเลือก (โดยไม่แทนที่) ในแต่ละรอบการทำ Baggingbagging_freq: ความถี่ในการทำ Bagging (ทุกๆ k iterations)lambda_l1และlambda_l2: ค่า L1 และ L2 Regularization
การปรับแต่งพารามิเตอร์เหล่านี้มักทำผ่านเทคนิคต่างๆ เช่น Grid Search, Random Search หรือ Bayesian Optimization โดยใช้ Cross-Validation เพื่อประเมินประสิทธิภาพของชุดพารามิเตอร์ต่างๆ
ภาพรวมโครงสร้างและความสัมพันธ์
Mindmap นี้แสดงให้เห็นภาพรวมของอัลกอริทึม Gradient Boosting และความสัมพันธ์ระหว่าง XGBoost และ LightGBM รวมถึงองค์ประกอบหลักในการปรับ Loss Function, การสร้างต้นไม้ และการเลือก Feature:
การเปรียบเทียบเชิงคุณลักษณะผ่าน Radar Chart
Radar chart นี้แสดงการเปรียบเทียบระหว่าง XGBoost และ LightGBM ในมิติต่างๆ เพื่อให้เห็นภาพจุดแข็งและจุดที่อาจต้องพิจารณาของแต่ละอัลกอริทึม ค่าที่แสดงเป็นค่าเปรียบเทียบเชิงคุณภาพ ไม่ได้มาจากข้อมูลเชิงปริมาณที่ตายตัว และอาจเปลี่ยนแปลงได้ขึ้นอยู่กับชุดข้อมูลและปัญหาเฉพาะ:
จาก Radar chart จะเห็นได้ว่า LightGBM มักจะโดดเด่นในด้านความเร็วในการฝึกและการใช้หน่วยความจำ รวมถึงการจัดการ Categorical Features ในขณะที่ XGBoost อาจมีภาษีดีกว่าในด้านการควบคุม Overfitting และความยืดหยุ่นในการปรับแต่งบางอย่าง อย่างไรก็ตาม ทั้งสองอัลกอริทึมมีความสามารถในการให้ความแม่นยำสูงใกล้เคียงกัน
การสร้าง Custom Loss Function ใน LightGBM
ทั้ง XGBoost และ LightGBM อนุญาตให้ผู้ใช้กำหนด Loss Function เองได้ ซึ่งมีประโยชน์อย่างยิ่งในกรณีที่ Loss Function มาตรฐานไม่เหมาะสมกับปัญหา เช่น กรณีข้อมูลมีความไม่สมดุลสูง หรือต้องการให้น้ำหนักกับความผิดพลาดบางประเภทเป็นพิเศษ วิดีโอด้านล่างนี้จะอธิบายและสาธิตวิธีการสร้าง Custom Loss Function ใน LightGBM ซึ่งเกี่ยวข้องกับการคำนวณ Gradient และ Hessian ของ Loss Function ที่คุณออกแบบเอง การทำความเข้าใจหลักการนี้จะช่วยให้คุณสามารถปรับแต่งโมเดลให้ตอบโจทย์ปัญหาเฉพาะทางได้ดียิ่งขึ้น
ในวิดีโอจะแสดงตัวอย่างโค้ดและการตั้งค่าที่จำเป็นสำหรับการนำ Custom Loss Function ไปใช้ในการฝึกโมเดล LightGBM โดยทั่วไปแล้ว ผู้ใช้จะต้องสร้างฟังก์ชันที่รับค่าทำนาย (predictions) และค่าจริง (true labels) เป็นอินพุต และส่งคืนค่า Gradient และ Hessian ที่คำนวณได้ออกมา
คำถามที่พบบ่อย (FAQ)
1. XGBoost กับ LightGBM ตัวไหนดีกว่ากัน? ▼
ไม่มีคำตอบที่ตายตัวว่าอัลกอริทึมใด "ดีกว่า" ในทุกสถานการณ์ การเลือกขึ้นอยู่กับปัจจัยหลายอย่าง เช่น ขนาดของชุดข้อมูล, ลักษณะของ Feature, ข้อจำกัดด้านเวลาและทรัพยากร, และเป้าหมายของโมเดล
- LightGBM มักจะเร็วกว่าและใช้หน่วยความจำน้อยกว่า เหมาะสำหรับชุดข้อมูลขนาดใหญ่ และมีการจัดการ Categorical Features ที่ดีเยี่ยม
- XGBoost มีชื่อเสียงด้านความทนทาน (Robustness) และมีเครื่องมือ Regularization ที่หลากหลาย ทำให้ควบคุม Overfitting ได้ดี และมักให้ผลลัพธ์ที่แม่นยำสูง
แนะนำให้ทดลองทั้งสองอัลกอริทึมกับปัญหาของคุณและเปรียบเทียบผลลัพธ์
2. ควรเลือกใช้ XGBoost หรือ LightGBM เมื่อใด? ▼
เลือก LightGBM เมื่อ:
- ชุดข้อมูลมีขนาดใหญ่มาก (ทั้งจำนวนแถวและคอลัมน์)
- ต้องการความเร็วในการฝึกโมเดลสูง
- มี Categorical Features จำนวนมาก และต้องการจัดการอย่างมีประสิทธิภาพ
- ข้อจำกัดด้านหน่วยความจำ (RAM) เป็นปัจจัยสำคัญ
เลือก XGBoost เมื่อ:
- ชุดข้อมูลมีขนาดเล็กถึงปานกลาง
- ต้องการความแม่นยำสูงสุดและมีเวลาในการปรับแต่งพารามิเตอร์
- ต้องการใช้ประโยชน์จาก Regularization ที่หลากหลายเพื่อป้องกัน Overfitting อย่างเข้มงวด
- ต้องการความเสถียรของโมเดลที่สูง
อย่างไรก็ตาม บ่อยครั้งที่ประสิทธิภาพของทั้งสองอัลกอริทึมจะใกล้เคียงกันมากเมื่อได้รับการปรับแต่งอย่างเหมาะสม
3. การสร้าง Custom Loss Function ใน XGBoost และ LightGBM ทำอย่างไร? ▼
ทั้ง XGBoost และ LightGBM รองรับการใช้ Custom Loss Function โดยผู้ใช้จะต้องนิยามฟังก์ชันที่คำนวณ Gradient (อนุพันธ์อันดับหนึ่ง) และ Hessian (อนุพันธ์อันดับสอง) ของ Loss Function ที่ต้องการเทียบกับค่าทำนายปัจจุบัน
- ใน LightGBM: คุณจะต้องสร้างฟังก์ชัน Python ที่รับ `preds` (ค่าทำนาย) และ `train_data` (ซึ่งมี `true_labels`) เป็นอาร์กิวเมนต์ และส่งคืน `grad` และ `hess` ออกมา จากนั้นจึงส่งฟังก์ชันนี้ให้กับพารามิเตอร์ `fobj` ตอนเรียก `lgb.train()`
- ใน XGBoost: กระบวนการคล้ายกัน คุณจะต้องสร้างฟังก์ชันที่รับ `preds` และ `dtrain` (ซึ่งเป็น `DMatrix` ที่มี `true_labels`) และส่งคืน `grad` และ `hess` จากนั้นจึงส่งฟังก์ชันนี้ให้กับพารามิเตอร์ `obj` ตอนเรียก `xgb.train()`
การทำความเข้าใจคณิตศาสตร์เบื้องหลัง Gradient และ Hessian ของ Loss Function ที่คุณต้องการเป็นสิ่งสำคัญเพื่อให้สามารถสร้าง Custom Loss Function ได้อย่างถูกต้อง
4. Histogram-based Algorithm คืออะไร และมีประโยชน์อย่างไรในการสร้างต้นไม้? ▼
Histogram-based Algorithm เป็นเทคนิคที่ใช้ในการหา Split Point ที่ดีที่สุดในต้นไม้ตัดสินใจได้อย่างรวดเร็ว แทนที่จะพิจารณาค่าที่เป็นไปได้ทั้งหมดของ Feature (ซึ่งอาจมีจำนวนมากและใช้เวลานานในการคำนวณ) อัลกอริทึมนี้จะทำการแบ่งค่าของ Feature ออกเป็นช่วงๆ หรือ "ถัง" (Bins) ที่ไม่ต่อเนื่องกันจำนวนหนึ่ง (สร้างเป็น Histogram) จากนั้นจึงคำนวณสถิติ (เช่น ผลรวมของ Gradient และ Hessian) สำหรับแต่ละ Bin และใช้ข้อมูลนี้ในการหา Split Point ที่ดีที่สุดระหว่าง Bin ต่างๆ
ประโยชน์ของ Histogram-based Algorithm:
- ลดเวลาในการคำนวณ: การหา Split Point ทำได้เร็วกว่ามาก เพราะไม่ต้องพิจารณาค่าที่เป็นไปได้ทั้งหมด
- ลดการใช้หน่วยความจำ: แทนที่จะเก็บค่า Feature ทั้งหมด จะเก็บเพียง Histogram ซึ่งใช้หน่วยความจำน้อยกว่า
- รองรับข้อมูลขนาดใหญ่ได้ดี: ทำให้สามารถฝึกโมเดลกับชุดข้อมูลขนาดใหญ่ได้อย่างมีประสิทธิภาพ
LightGBM ใช้เทคนิคนี้เป็นหลัก ในขณะที่ XGBoost ก็มีตัวเลือกให้ใช้เช่นกัน
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
- เทคนิคการทำ Hyperparameter Tuning สำหรับ XGBoost และ LightGBM มีอะไรบ้าง?
- เปรียบเทียบประสิทธิภาพ XGBoost, LightGBM และ CatBoost ในงานประเภทต่างๆ
- การจัดการกับข้อมูลที่ไม่สมดุล (Imbalanced Data) ด้วย XGBoost และ LightGBM
- อธิบาย SHAP values และการนำมาใช้เพื่อตีความโมเดล XGBoost และ LightGBM
แหล่งอ้างอิง
Last updated May 14, 2025