
Débloquez des Prédictions de Puissance Futures avec XGBoost : Votre Guide Minute par Minute
Exploitez la puissance de l'apprentissage automatique pour prévoir avec précision les valeurs de puissance, en intégrant des caractéristiques temporelles et de décalage.
La prévision des valeurs de puissance est cruciale pour la gestion de l'énergie, l'optimisation des ressources et la planification. Utiliser des modèles d'apprentissage automatique avancés comme XGBoost peut fournir des prédictions très précises, même à une granularité minute par minute. Ce guide vous expliquera comment mettre en œuvre une solution de prévision XGBoost pour vos données de séries temporelles de puissance, couvrant la préparation des données, l'ingénierie des caractéristiques, la formation du modèle et les stratégies pour garantir la fiabilité des prédictions.
Points Clés de la Prévision avec XGBoost
- Ingénierie des Caractéristiques Détaillée : La création de lag features (valeurs passées) et de caractéristiques temporelles (heure, jour, mois) est essentielle pour que XGBoost comprenne les motifs séquentiels et la saisonnalité.
- Approche de Prédiction Itérative : Pour prévoir plusieurs pas de temps futurs (par exemple, chaque minute pour une semaine), une stratégie itérative où chaque nouvelle prédiction est utilisée pour générer des caractéristiques pour le pas suivant est souvent la plus efficace.
- Validation et Robustesse des Prédictions : Des techniques telles que le plafonnement des valeurs prédites dans des plages logiques et le lissage peuvent améliorer la fiabilité des prévisions du modèle.
Préparation des Données et Ingénierie des Caractéristiques
La base de tout modèle de prévision performant réside dans la qualité et la pertinence des données d'entrée. Pour les séries temporelles, cela implique un nettoyage minutieux et la création de caractéristiques qui capturent la dynamique temporelle sous-jacente.
Chargement et Nettoyage Initials des Données
Commencez par charger vos données de séries temporelles. Assurez-vous que la colonne de timestamp est correctement formatée en tant qu'objet datetime et définie comme index du DataFrame. Il est crucial de trier les données chronologiquement. Les valeurs manquantes, si présentes, doivent être traitées, par exemple par interpolation temporelle ou par remplissage progressif/rétroactif, en fonction de la nature des données.
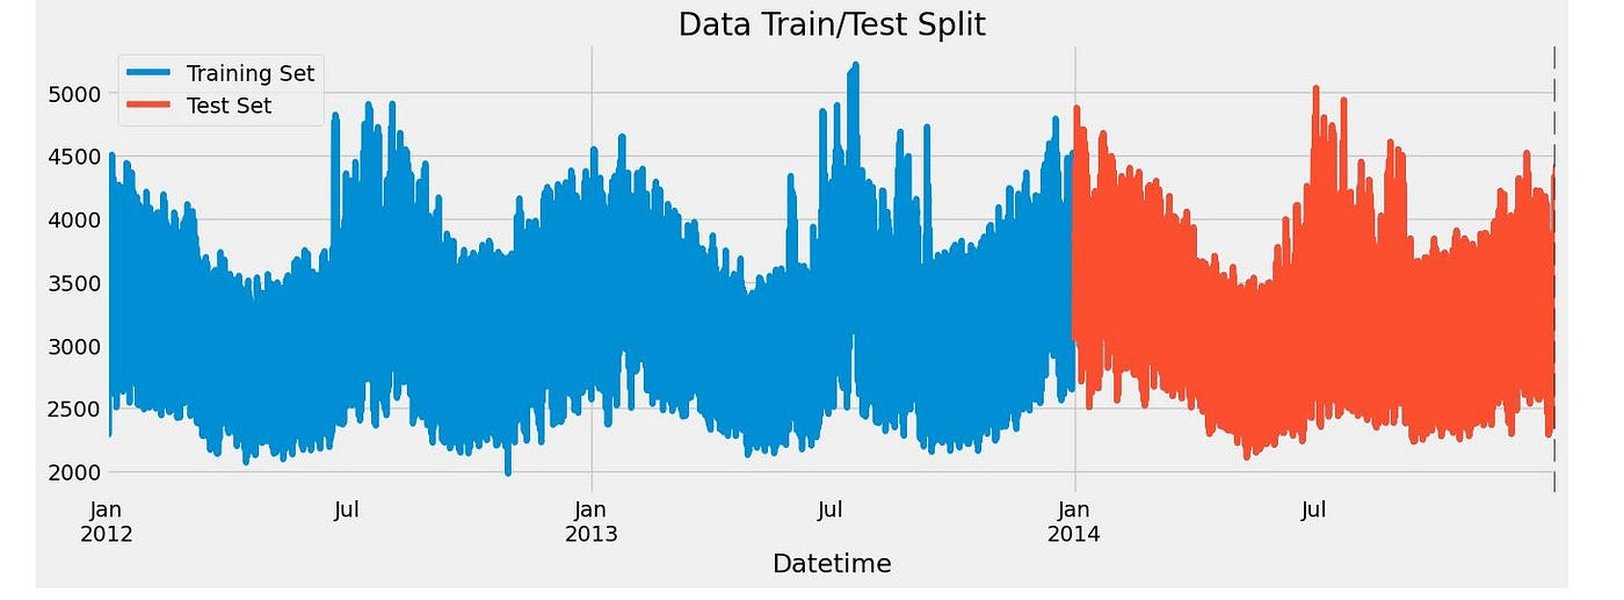
Illustration de données de séries temporelles typiques de consommation d'énergie.
Création de Caractéristiques Temporelles et de Décalage (Lag Features)
Pour que XGBoost, un modèle basé sur des arbres, puisse "voir" les motifs temporels, nous devons explicitement créer des caractéristiques qui encodent ces informations.
Caractéristiques Temporelles
Ce sont des caractéristiques dérivées directement du timestamp :
- Minute de l'heure
- Heure de la journée
- Jour de la semaine
- Jour du mois
- Jour de l'année
- Semaine de l'année
- Mois
- Année
- Trimestre
Pour les caractéristiques cycliques comme l'heure, le jour de la semaine ou le mois, il est souvent bénéfique d'utiliser des transformations sinus et cosinus pour aider le modèle à comprendre leur nature continue (par exemple, l'heure 23 est proche de l'heure 0).
# Exemple de création de caractéristiques temporelles
df['hour'] = df.index.hour
df['minute'] = df.index.minute
df['dayofweek'] = df.index.dayofweek
df['month'] = df.index.month
# ... autres caractéristiques ...

# Transformations Sin/Cos pour l'heure
df['hour_sin'] = np.sin(2 * np.pi * df['hour'] / 24)
df['hour_cos'] = np.cos(2 * np.pi * df['hour'] / 24)
Lag Features (Caractéristiques de Décalage)
Les lag features sont les valeurs passées de la série temporelle (dans ce cas, power_value). Elles sont cruciales car la valeur actuelle est souvent fortement corrélée avec ses valeurs récentes. Des exemples de lags utiles pourraient être :
- 1 minute avant
- 5 minutes avant
- 15 minutes avant
- 1 heure avant (60 minutes)
- 1 jour avant (1440 minutes)
- 1 semaine avant (10080 minutes)
# Exemple de création de lag features
lags = [1, 5, 15, 60, 1440, 10080]
for lag in lags:
    df[f'power_lag_{lag}'] = df['power_value'].shift(lag)
Statistiques Roulantes
Les statistiques calculées sur des fenêtres glissantes (par exemple, moyenne mobile, écart-type mobile) peuvent également fournir des informations utiles sur les tendances et la volatilité récentes.
# Exemple de statistiques roulantes
df['rolling_mean_15min'] = df['power_value'].rolling(window=15).mean()
df['rolling_std_15min'] = df['power_value'].rolling(window=15).std()
Après la création des caractéristiques, les lignes contenant des valeurs NaN (généralement au début de la série en raison des opérations de décalage et de roulement) doivent être supprimées.
Division des Données et Entraînement du Modèle
Division Temporelle des Données
Pour les séries temporelles, il est impératif de diviser les données en ensembles d'entraînement et de test (ou de validation) de manière chronologique. Les données passées sont utilisées pour l'entraînement, et les données futures pour le test. Un brassage aléatoire des données détruirait la structure temporelle.
Pour votre cas :
- Ensemble d'entraînement : Données de Janvier 2023 au 31 Octobre 2023.
- Ensemble de prédiction : La semaine du 1er Novembre 2023 au 7 Novembre 2023.
Il est également recommandé de réserver une partie des données d'entraînement les plus récentes comme ensemble de validation pour l'optimisation des hyperparamètres et l'arrêt anticipé (early stopping) pendant l'entraînement.
Entraînement du Modèle XGBoost
XGBoost (Extreme Gradient Boosting) est un algorithme puissant qui fonctionne bien sur les données tabulaires structurées créées à partir de l'ingénierie des caractéristiques. Nous utiliserons XGBRegressor pour cette tâche de régression.
# Définir les caractéristiques (X) et la cible (y)
features = [col for col in train_data.columns if col not in ['power_value']]
target = 'power_value'

X_train = train_data[features]
y_train = train_data[target]

# Initialiser et entraîner le modèle
model = xgb.XGBRegressor(
    objective='reg:squarederror',
    n_estimators=1000,          # Nombre d'arbres (à régler)
    learning_rate=0.05,         # Taux d'apprentissage
    max_depth=7,                # Profondeur maximale des arbres
    subsample=0.8,              # Fraction des échantillons par arbre
    colsample_bytree=0.8,       # Fraction des caractéristiques par arbre
    random_state=42,
    n_jobs=-1,                  # Utiliser tous les cœurs disponibles
    early_stopping_rounds=50    # Pour l'arrêt anticipé
)

# Entraîner avec un ensemble d'évaluation pour l'arrêt anticipé
# X_val, y_val seraient votre ensemble de validation
# model.fit(X_train, y_train, eval_set=[(X_val, y_val)], verbose=False)
# Si pas d'ensemble de validation distinct pour l'arrêt anticipé lors de l'entraînement final :
model.fit(X_train, y_train, verbose=False)
Génération et Gestion des Prédictions Futures
Prédire une semaine entière minute par minute nécessite une approche itérative, car les lag features pour chaque pas de temps futur dépendront des valeurs prédites aux pas précédents.
Stratégie de Prédiction Itérative
1. Initialisez le DataFrame futur avec les timestamps pour la semaine de prédiction (1er au 7 Nov 2023, chaque minute).
2. Créez les caractéristiques temporelles pour ces timestamps futurs.
3. Pour la première prédiction, les lag features devront être construites à partir des dernières valeurs connues de l'ensemble d'entraînement.
4. Prédisez la valeur pour le premier pas de temps.
5. Ajoutez cette valeur prédite à votre historique de données.
6. Utilisez cet historique mis à jour pour construire les lag features pour le pas de temps suivant.
7. Répétez les étapes 4-6 pour chaque minute de la semaine de prédiction.
Gestion des Prédictions Incorrectes ou Illogiques
Les modèles peuvent parfois produire des prédictions qui n'ont pas de sens dans le contexte du problème (par exemple, une valeur de puissance négative).
- Plafonnement (Clipping) : Appliquez des contraintes basées sur la connaissance du domaine. Par exemple, si la puissance ne peut pas être négative, toute prédiction inférieure à zéro peut être définie à zéro. De même, des limites supérieures peuvent exister.
predictions = np.clip(predictions, a_min=0, a_max=None) # Plafonne à 0 minimum - Lissage : Une moyenne mobile sur les prédictions brutes peut aider à lisser les fluctuations irréalistes à court terme.
- Détection d'Anomalies : Mettez en place des règles pour signaler les prédictions qui s'écartent considérablement des tendances historiques ou des limites attendues.
- Ré-entraînement Fréquent : Les dynamiques des séries temporelles peuvent changer. Ré-entraîner régulièrement le modèle avec des données fraîches aide à maintenir sa précision.
Concernant la haute précision de vos données (nombreux chiffres après la virgule), XGBoost gère nativement les nombres à virgule flottante. La sensibilité du modèle à ces petites variations dépendra de la qualité des caractéristiques et de la capacité du modèle à apprendre des motifs subtils plutôt que du bruit. Si ces variations après la virgule sont significatives et porteuses d'information, un modèle bien entraîné devrait les capturer dans une certaine mesure.
Implémentation Python Complète
Voici un exemple de code Python consolidé qui met en œuvre les étapes décrites. Ce code utilise des données synthétiques à des fins d'illustration ; vous devrez le remplacer par votre propre chargement de données.
import pandas as pd
import numpy as np
import xgboost as xgb
from sklearn.metrics import mean_squared_error
import matplotlib.pyplot as plt

# ----- 0. Génération de Données Synthétiques (À remplacer par vos données réelles) -----
np.random.seed(42)
# Données d'entraînement : Jan 2023 - Oct 2023
train_dates_rng = pd.date_range(start='2023-01-01', end='2023-10-31 23:59', freq='T')
data_train = pd.DataFrame(train_dates_rng, columns=['timestamp'])
data_train['power_value'] = np.sin(np.arange(len(train_dates_rng)) / (60*24) * 2 * np.pi) * 100 + \
                            np.sin(np.arange(len(train_dates_rng)) / (60*24*7) * 2 * np.pi) * 50 + \
                            np.random.randn(len(train_dates_rng)) * 15 + 500
data_train = data_train.set_index('timestamp')

# ----- 1. Ingénierie des Caractéristiques -----
def create_features(df_input, target_col_name=None):
    df = df_input.copy()
    df['hour'] = df.index.hour
    df['minute'] = df.index.minute
    df['dayofweek'] = df.index.dayofweek # Monday=0, Sunday=6
    df['dayofmonth'] = df.index.day
    df['dayofyear'] = df.index.dayofyear
    df['weekofyear'] = df.index.isocalendar().week.astype(int)
    df['month'] = df.index.month
    df['quarter'] = df.index.quarter
    df['year'] = df.index.year

    # Caractéristiques cycliques
    df['hour_sin'] = np.sin(2 * np.pi * df['hour'] / 24)
    df['hour_cos'] = np.cos(2 * np.pi * df['hour'] / 24)
    df['minute_sin'] = np.sin(2 * np.pi * df['minute'] / 60) # Peut être moins utile si agrégé
    df['minute_cos'] = np.cos(2 * np.pi * df['minute'] / 60)
    df['dayofweek_sin'] = np.sin(2 * np.pi * df['dayofweek'] / 7)
    df['dayofweek_cos'] = np.cos(2 * np.pi * df['dayofweek'] / 7)
    df['month_sin'] = np.sin(2 * np.pi * df['month'] / 12)
    df['month_cos'] = np.cos(2 * np.pi * df['month'] / 12)

    if target_col_name: # Uniquement si la colonne cible est présente (pour lags, rolling)
        lags = [1, 5, 15, 60, 60*24, 60*24*7] # 1m, 5m, 15m, 1h, 1d, 1w
        for lag in lags:
            df[f'{target_col_name}_lag_{lag}'] = df[target_col_name].shift(lag)

        windows = [15, 60] # fenêtres de 15min, 1h
        for window in windows:
            df[f'{target_col_name}_roll_mean_{window}'] = df[target_col_name].rolling(window=window).mean()
            df[f'{target_col_name}_roll_std_{window}'] = df[target_col_name].rolling(window=window).std()

    return df

data_train_featured = create_features(data_train, target_col_name='power_value')
data_train_featured = data_train_featured.dropna() # Supprimer les NaNs dus aux lags/rolling

# ----- 2. Division des Données -----
# Pour cet exemple, tout data_train_featured est utilisé pour l'entraînement final
# Dans un cas réel, vous pourriez avoir un X_train, y_train, X_val, y_val
features_cols = [col for col in data_train_featured.columns if col != 'power_value']
target_col = 'power_value'

X_train_final = data_train_featured[features_cols]
y_train_final = data_train_featured[target_col]

# ----- 3. Entraînement du Modèle XGBoost -----
model = xgb.XGBRegressor(
    objective='reg:squarederror',
    n_estimators=500, # Réduit pour un exemple plus rapide, à régler
    learning_rate=0.05,
    max_depth=7,
    subsample=0.8,
    colsample_bytree=0.8,
    random_state=42,
    n_jobs=-1
    # early_stopping_rounds=50 # À utiliser avec eval_set
)

print("Début de l'entraînement du modèle...")
# model.fit(X_train_final, y_train_final, eval_set=[(X_val, y_val)], verbose=50)
model.fit(X_train_final, y_train_final, verbose=False) # Entraînement sans validation pour cet exemple
print("Modèle entraîné.")

# ----- 4. Préparation pour la Prédiction Future Itérative -----
prediction_start_date = '2023-11-01 00:00:00'
prediction_end_date = '2023-11-07 23:59:00'
future_daterange = pd.date_range(start=prediction_start_date, end=prediction_end_date, freq='T')

# Historique initial requis pour les lags et rolling features des premières prédictions
# Prendre les dernières données de l'ensemble d'entraînement, au moins la taille du plus grand lag/window
max_lag_or_window = max([10080, 60]) # 10080 min = 1 semaine
history_for_lags = data_train.iloc[-max_lag_or_window:].copy()

future_predictions_list = []

print("Début de la prédiction itérative...")
for current_timestamp in future_daterange:
    # 1. Créer le DataFrame pour le pas de temps actuel
    current_step_df = pd.DataFrame(index=[current_timestamp])

    # 2. Ajouter ce pas de temps à l'historique pour créer les caractéristiques
    #    Temporairement, on ajoute une valeur fictive pour 'power_value' si elle est utilisée par create_features
    #    mais elle ne sera pas utilisée comme cible.
    temp_history_for_features = history_for_lags.copy()
    if 'power_value' not in temp_history_for_features.columns: # S'assurer que la colonne existe
         temp_history_for_features['power_value'] = np.nan # ou une autre valeur placeholder

    # Concaténer le pas de temps actuel (sans valeur de puissance réelle) pour le calcul des caractéristiques
    # Note: Pour les features de lag/rolling, elles seront basées sur history_for_lags
    # Pour les features temporelles (heure, jour), elles seront basées sur current_timestamp

    # Créer les caractéristiques pour le pas de temps actuel en utilisant l'historique
    # On a besoin des valeurs de 'power_value' dans 'history_for_lags' pour calculer lags/rolling
    # Pour 'current_step_df', les features temporelles sont calculées, les lags/rolling le seront à partir de 'history_for_lags'

    # Préparer le vecteur de caractéristiques pour la prédiction
    # D'abord, les caractéristiques temporelles pour current_timestamp
    features_for_current_step = create_features(pd.DataFrame(index=[current_timestamp]))

    # Ensuite, ajouter les caractéristiques de lag et rolling à partir de history_for_lags
    # Pour chaque lag X: prendre la valeur de power_value à (current_timestamp - X) de history_for_lags
    # Exemple simplifié: ici, nous allons recréer toutes les caractéristiques en utilisant l'historique étendu
    # puis prendre la dernière ligne qui correspondra à notre 'current_timestamp' avec les lags corrects.

    # Concaténer le timestamp actuel à l'historique (sans valeur de puissance)
    # pour que create_features puisse générer les features temporelles pour ce timestamp
    # et les features de lag/rolling à partir des valeurs précédentes dans l'historique.
    temp_df_for_feature_creation = pd.concat([history_for_lags, pd.DataFrame(index=[current_timestamp])])
    all_features_generated = create_features(temp_df_for_feature_creation, target_col_name='power_value')

    # Isoler les caractéristiques pour le pas de temps actuel (la dernière ligne)
    input_features_for_prediction = all_features_generated[features_cols].iloc[-1:]

    # Gérer les NaNs si des lags ne peuvent pas être remplis (ne devrait pas arriver si history_for_lags est assez long)
    # input_features_for_prediction = input_features_for_prediction.fillna(method='ffill').fillna(method='bfill') # Stratégie de remplissage simple

    # 3. Faire la prédiction
    predicted_value = model.predict(input_features_for_prediction)[0]

    # 4. Gérer les prédictions illogiques (exemple : plafonnement)
    predicted_value = max(0, predicted_value) # La puissance ne peut pas être négative

    future_predictions_list.append(predicted_value)

    # 5. Mettre à jour l'historique avec la nouvelle valeur prédite
    new_row = pd.DataFrame({'power_value': [predicted_value]}, index=[current_timestamp])
    history_for_lags = pd.concat([history_for_lags, new_row])
    # Optionnel: garder la taille de l'historique fixe pour éviter une consommation mémoire excessive
    if len(history_for_lags) > max_lag_or_window * 2 : # Garder un peu plus que nécessaire
         history_for_lags = history_for_lags.iloc[-max_lag_or_window:]

    if (len(future_predictions_list) % 1440 == 0) : # Log tous les jours
        print(f"Prédit pour {len(future_predictions_list) / 1440} jours...")

print("Prédiction itérative terminée.")

# ----- 5. Résultats -----
predictions_df = pd.DataFrame({'timestamp': future_daterange, 'predicted_power': future_predictions_list})
predictions_df = predictions_df.set_index('timestamp')

print("\nAperçu des prédictions:")
print(predictions_df.head())

# Visualisation
plt.figure(figsize=(15, 7))
plt.plot(data_train['power_value'].iloc[-2*24*60:], label='Données d\'entraînement récentes (2 derniers jours)') # 2 derniers jours d'entraînement
plt.plot(predictions_df['predicted_power'], label='Prédictions Futures (1 semaine)', color='red')
plt.title('Prédiction de la Valeur de Puissance avec XGBoost')
plt.xlabel('Temps')
plt.ylabel('Valeur de Puissance')
plt.legend()
plt.show()

# Évaluation (si vous aviez des valeurs réelles pour la semaine de prédiction)
# real_values_for_prediction_week = ...
# mse = mean_squared_error(real_values_for_prediction_week, predictions_df['predicted_power'])
# print(f"MSE sur la semaine de prédiction : {mse}")
Note Importante sur le Code de Prédiction Itérative : La section de prédiction itérative ci-dessus est une illustration conceptuelle. La création correcte et efficace des lag features et des caractéristiques roulantes à chaque pas de temps dans la boucle est cruciale et peut devenir complexe. Assurez-vous que input_features_for_prediction contient toutes les caractéristiques attendues par le modèle, calculées sur la base de history_for_lags qui inclut les prédictions précédentes.
Importance Relative des Caractéristiques
Comprendre quelles caractéristiques influencent le plus les prédictions de votre modèle XGBoost peut offrir des informations précieuses. Bien que l'importance des caractéristiques puisse être extraite directement du modèle XGBoost entraîné, un graphique radar peut visualiser de manière conceptuelle l'impact attendu de différentes catégories de caractéristiques sur la prévision de la puissance.
Ce graphique radar illustre l'impact potentiel et la complexité d'implémentation de diverses catégories de caractéristiques. Les "Lags à Court Terme" et l'"Heure de la Journée" ont souvent un impact élevé pour les prévisions de puissance à haute fréquence, tandis que les "Événements Spéciaux/Externes" (comme les jours fériés ou les données météorologiques) peuvent être très influents mais plus complexes à intégrer.
Visualisation du Flux de Travail de Prévision
Un diagramme mental peut aider à visualiser l'ensemble du processus, de l'entrée des données à la sortie des prédictions.
(heure, jour, mois, cycliques sin/cos)"] id3b["Lag Features
(valeurs passées de puissance)"] id3c["Statistiques Roulantes
(moyenne, std sur fenêtres)"] id4["Division des Données"] id4a["Ensemble d'Entraînement
(jusqu'au 31 Oct 2023)"] id4b["(Optionnel) Ensemble de Validation"] id4c["Période de Prédiction Cible
(1-7 Nov 2023)"] id5["Entraînement du Modèle"] id5a["XGBoost Regressor"] id5b["Optimisation des Hyperparamètres (optionnel)"] id5c["Early Stopping (avec validation)"] id6["Prédiction Future"] id6a["Approche Itérative (minute par minute)"] id6b["Mise à jour des Lags avec Prédictions"] id7["Post-traitement des Prédictions"] id7a["Plafonnement (valeurs min/max logiques)"] id7b["Lissage (moyenne mobile)"] id7c["Analyse des Erreurs"] id8["Sortie"] id8a["Prédictions de Puissance (1-7 Nov 2023)"] id8b["Visualisations"] id8c["Métriques d'Évaluation (si données réelles disponibles)"]
Ce diagramme mental présente les étapes clés du projet, depuis la collecte des données initiales jusqu'à la génération et l'évaluation des prédictions finales.
Hyperparamètres Clés de XGBoost pour les Séries Temporelles
Le réglage fin des hyperparamètres de XGBoost est crucial pour obtenir des performances optimales. Voici quelques-uns des hyperparamètres les plus importants et leur rôle :
| Hyperparamètre | Description | Considérations pour les Séries Temporelles |
|---|---|---|
n_estimators |
Nombre d'arbres de décision à entraîner. | Une valeur plus élevée peut améliorer les performances mais augmente le temps d'entraînement et le risque de surapprentissage. Souvent déterminé avec l'arrêt anticipé. |
learning_rate (ou eta) |
Taux d'apprentissage, réduit la contribution de chaque arbre. | Des valeurs plus faibles (par exemple, 0.01-0.1) nécessitent généralement plus d'arbres (n_estimators) mais peuvent conduire à une meilleure généralisation. |
max_depth |
Profondeur maximale de chaque arbre. | Contrôle la complexité du modèle. Des valeurs plus élevées peuvent capturer des interactions plus complexes mais augmentent le risque de surapprentissage. Typiquement 3-10. |
subsample |
Fraction des échantillons de l'ensemble d'entraînement utilisée pour entraîner chaque arbre. | Aide à prévenir le surapprentissage. Des valeurs typiques sont 0.5-1.0. |
colsample_bytree |
Fraction des caractéristiques (colonnes) utilisée pour entraîner chaque arbre. | Aide également à prévenir le surapprentissage. Des valeurs typiques sont 0.5-1.0. |
objective |
Fonction objectif à optimiser. | Pour la régression des valeurs de puissance, reg:squarederror (erreur quadratique moyenne) est couramment utilisé. |
early_stopping_rounds |
Nombre de tours consécutifs sans amélioration sur l'ensemble de validation avant d'arrêter l'entraînement. | Essentiel pour éviter le surapprentissage et trouver un bon nombre d'estimateurs. Nécessite un ensemble de validation. |
L'optimisation de ces hyperparamètres, souvent réalisée à l'aide de techniques comme la recherche par grille (Grid Search) ou la recherche aléatoire (Random Search) avec validation croisée temporelle, est une étape importante pour maximiser la précision des prédictions.
Approfondir avec des Tutoriels Vidéo
Pour une compréhension plus visuelle et des démonstrations pratiques de l'utilisation de XGBoost pour la prévision de séries temporelles, cette vidéo (en anglais) offre un excellent point de départ :
Ce tutoriel, "Time Series Forecasting with XGBoost - Use python and ...", guide à travers un exemple de prévision de séries temporelles en utilisant XGBoost pour prédire la consommation d'énergie, ce qui est très pertinent pour votre cas d'utilisation de prévision de valeurs de puissance. Il couvre des concepts clés qui complètent les explications et le code fournis ici.
FAQ : Prévision de Puissance avec XGBoost
Pourquoi utiliser XGBoost pour la prévision de séries temporelles ?
XGBoost est un algorithme de gradient boosting très performant, connu pour sa vitesse et sa précision. Bien qu'il ne soit pas intrinsèquement un modèle de séries temporelles (comme ARIMA ou les RNN), il peut être très efficace lorsqu'on lui fournit des caractéristiques bien conçues qui capturent les dépendances temporelles, telles que les lag features et les caractéristiques temporelles. Il excelle dans la modélisation de relations non linéaires complexes et peut gérer de grands ensembles de données.
Comment les lag features aident-elles dans la prévision de séries temporelles ?
Les lag features sont les valeurs passées de la variable cible. Elles sont cruciales car de nombreuses séries temporelles présentent une autocorrélation, ce qui signifie que les valeurs futures dépendent des valeurs passées. En incluant les lags comme caractéristiques, on permet au modèle XGBoost d'apprendre ces dépendances temporelles directes. Par exemple, la puissance consommée à 9h00 est susceptible d'être similaire à celle consommée à 8h59 ou même à 9h00 la veille.
Quelles sont les caractéristiques temporelles courantes et pourquoi sont-elles importantes ?
Les caractéristiques temporelles sont extraites du timestamp lui-même. Les plus courantes incluent :
- Heure de la journée
- Jour de la semaine
- Jour du mois
- Mois de l'année
- Semaine de l'année
- Trimestre
Elles sont importantes car elles aident le modèle à capturer la saisonnalité et les cycles. Par exemple, la consommation d'énergie suit souvent des schémas journaliers (plus élevée pendant la journée), hebdomadaires (différences entre jours de semaine et week-ends) et annuels (plus élevée en hiver ou en été pour le chauffage/climatisation).
Comment puis-je améliorer la précision de mes prédictions de valeur de puissance ?
Plusieurs stratégies peuvent améliorer la précision :
- Ingénierie des Caractéristiques Avancée : Explorez plus de lags, des interactions entre caractéristiques, ou des statistiques roulantes plus complexes. Incorporez des données externes si disponibles (par exemple, données météorologiques, jours fériés, événements spéciaux).
- Optimisation des Hyperparamètres : Utilisez des techniques comme la recherche par grille ou la recherche bayésienne pour trouver la meilleure combinaison d'hyperparamètres pour XGBoost.
- Validation Croisée Robuste : Utilisez une validation croisée spécifique aux séries temporelles (par exemple, avec fenêtres glissantes) pour évaluer les performances du modèle de manière plus fiable.
- Modèles d'Ensemble : Combinez les prédictions de XGBoost avec d'autres modèles (par exemple, ARIMA, Prophet, ou des réseaux neuronaux) pour potentiellement obtenir de meilleurs résultats.
- Gestion des Outliers : Identifiez et traitez correctement les valeurs aberrantes dans vos données d'entraînement.
- Ré-entraînement Fréquent : Mettez à jour votre modèle avec les données les plus récentes pour qu'il s'adapte aux changements de motifs.
Lectures Recommandées
- Comment optimiser les hyperparamètres de XGBoost pour la prévision de séries temporelles ?
- Quelles sont les techniques de validation croisée pour les données de séries temporelles ?
- Comment intégrer des données externes comme la météo dans un modèle de prévision de puissance XGBoost ?
- Comparaison entre XGBoost et d'autres modèles (ARIMA, Prophet, LSTM) pour la prévision de séries temporelles.
Références
Last updated May 12, 2025