
Prédire la Production d'Énergie Future avec XGBoost : Éviter les Prédictions Constantes
Un guide détaillé avec code Python pour la prévision de séries temporelles sur 24 heures, en utilisant des caractéristiques temporelles et des lags.
Bonjour ! Je suis Ithy, votre assistant IA. Vous cherchez à utiliser XGBoost pour prédire la puissance générée pour les prochaines 24 heures (1er novembre 2023) à partir de données à la minute allant jusqu'au 31 octobre 2023. Vous avez rencontré des difficultés avec des prédictions quasi constantes, ce qui est un problème fréquent lorsque l'on applique des modèles basés sur des arbres comme XGBoost à des séries temporelles sans une ingénierie de caractéristiques adéquate.
Ce guide vous fournira une explication détaillée et un code Python complet intégrant les meilleures pratiques pour surmonter ce défi, notamment la création de caractéristiques temporelles et de décalage (lags), ainsi qu'une stratégie de prédiction itérative.
Points Clés à Retenir
- Ingénierie des caractéristiques (Feature Engineering) : La clé pour permettre à XGBoost de modéliser des séries temporelles est de créer des caractéristiques pertinentes, notamment des variables temporelles (heure, jour, mois...) et des variables de décalage (lags) qui représentent les valeurs passées de la puissance.
- Prédiction Itérative : Pour prédire sur un horizon de plusieurs étapes (ici, 1440 minutes), une approche itérative est souvent nécessaire. Le modèle prédit une minute à la fois, et cette prédiction est utilisée pour calculer les lags de la minute suivante.
- Éviter les Prédictions Constantes : Des caractéristiques riches et une stratégie de prédiction adaptée (comme l'approche itérative) aident le modèle à capturer la dynamique et les cycles de la série temporelle, évitant ainsi les prédictions plates.
Comprendre XGBoost et les Séries Temporelles
Pourquoi une Ingénierie de Caractéristiques Spécifique est Nécessaire
XGBoost (Extreme Gradient Boosting) est un algorithme d'apprentissage automatique extrêmement puissant pour les données tabulaires. Cependant, il n'est pas intrinsèquement conçu pour comprendre la séquence temporelle des données comme le font des modèles tels que ARIMA ou les réseaux neuronaux récurrents (LSTM). Pour utiliser XGBoost efficacement pour la prévision de séries temporelles, nous devons transformer la série temporelle en un problème de régression supervisée tabulaire. Cela se fait principalement par l'ingénierie des caractéristiques.
Caractéristiques Temporelles
Ces caractéristiques aident le modèle à comprendre où se situe un point de données dans le temps et à capturer les cycles saisonniers, hebdomadaires ou journaliers. Sans elles, le modèle ne sait pas si une prédiction concerne le milieu de la nuit (faible production attendue) ou le milieu de la journée (production potentiellement élevée).
- Heure de la journée
- Minute de l'heure
- Jour de la semaine
- Jour du mois
- Mois de l'année
- Jour de l'année
- Semaine de l'année
- Indicateurs de weekend ou de jours fériés
- Transformations cycliques (sin/cos) pour les caractéristiques comme l'heure ou le jour de l'année, afin de représenter leur nature cyclique (ex: 23h est proche de 0h).
Caractéristiques de Décalage (Lags)
Les lags sont simplement les valeurs de la variable cible (la puissance générée) à des moments antérieurs. Par exemple, `lag_1` est la valeur de la puissance à la minute précédente, `lag_60` est la valeur il y a une heure, et `lag_1440` est la valeur il y a 24 heures. Ces caractéristiques sont vitales car elles fournissent au modèle des informations directes sur l'état récent et les tendances passées de la série. Un manque de lags pertinents est une cause majeure des prédictions constantes.
Statistiques Roulantes (Optionnel mais utile)
On peut également créer des caractéristiques basées sur des statistiques calculées sur des fenêtres temporelles glissantes (par exemple, la moyenne ou l'écart-type de la puissance sur les 60 dernières minutes). Cela peut aider à capturer des tendances locales.
La Stratégie de Prédiction Itérative
Lorsque l'on prédit plusieurs pas dans le futur (ici, 1440 minutes), les caractéristiques de décalage pour les pas futurs ne sont pas connues. Par exemple, pour prédire la puissance à 00:05 le 1er novembre, nous avons besoin du `lag_1` (la puissance à 00:04), qui n'est pas encore connue si nous prédisons tout en une seule fois.
L'approche itérative résout ce problème :
- Prédire la valeur pour le premier pas futur (00:00 le 1er nov).
- Utiliser cette valeur prédite pour calculer les lags nécessaires à la prédiction du deuxième pas (00:01 le 1er nov).
- Prédire la valeur pour le deuxième pas.
- Répéter ce processus pour les 1440 minutes.
Cette méthode, bien que plus complexe à implémenter, est souvent plus précise pour les prévisions multi-étapes car elle utilise les informations les plus récentes (même si prédites) à chaque étape.
Code Python Détaillé pour la Prédiction de Puissance
Mise en œuvre avec XGBoost, Lags et Prédiction Itérative
Le code suivant charge vos données, effectue l'ingénierie des caractéristiques, entraîne un modèle XGBoost et réalise les prédictions pour les 24 heures du 1er novembre 2023 en utilisant l'approche itérative.
import pandas as pd
import numpy as np
import xgboost as xgb
from sklearn.metrics import mean_squared_error
import matplotlib.pyplot as plt
from datetime import timedelta

# --- 1. Chargement et Préparation Initiale des Données ---
print("Chargement des données...")
# Assurez-vous que le chemin vers votre fichier est correct
# Le fichier doit contenir au moins 'timestamp' et 'power'
try:
    # Remplacez 'votre_fichier_donnees.csv' par le nom de votre fichier
    df = pd.read_csv('votre_fichier_donnees.csv', parse_dates=['timestamp'])
    df = df.rename(columns={'power': 'puissance'}) # Renommer si nécessaire
except FileNotFoundError:
    print("Erreur: Fichier non trouvé. Vérifiez le chemin.")
    exit()
except KeyError:
     print("Erreur: Assurez-vous d'avoir les colonnes 'timestamp' et 'puissance' (ou 'power').")
     exit()

# Assurer le tri chronologique et définir le timestamp comme index
df = df.sort_values('timestamp').set_index('timestamp')

# Vérifier la fréquence des données (devrait être à la minute)
# Optionnel: Ré-échantillonner si nécessaire, mais ici on suppose que c'est déjà à la minute
# df = df.asfreq('min') # Force la fréquence à la minute, gère les manques si besoin

# Filtrer les données jusqu'à la fin d'octobre 2023 pour l'entraînement
df_train_full = df.loc[df.index <= '2023-10-31 23:59:00'].copy()
print(f"Données d'entraînement chargées: {len(df_train_full)} points jusqu'au 2023-10-31 23:59:00")

# --- 2. Ingénierie des Caractéristiques ---
print("Création des caractéristiques temporelles et de décalage...")

def create_features(dataframe):
    """Crée les caractéristiques temporelles et cycliques."""
    df_copy = dataframe.copy()
    df_copy['hour'] = df_copy.index.hour
    df_copy['minute'] = df_copy.index.minute
    df_copy['dayofweek'] = df_copy.index.dayofweek # Lundi=0, Dimanche=6
    df_copy['dayofyear'] = df_copy.index.dayofyear
    df_copy['month'] = df_copy.index.month
    df_copy['year'] = df_copy.index.year
    df_copy['weekofyear'] = df_copy.index.isocalendar().week.astype(int)
    df_copy['quarter'] = df_copy.index.quarter

    # Caractéristiques cycliques (important pour les modèles basés sur les arbres)
    df_copy['hour_sin'] = np.sin(2 * np.pi * df_copy['hour'] / 24)
    df_copy['hour_cos'] = np.cos(2 * np.pi * df_copy['hour'] / 24)
    df_copy['dayofyear_sin'] = np.sin(2 * np.pi * df_copy['dayofyear'] / 365.25)
    df_copy['dayofyear_cos'] = np.cos(2 * np.pi * df_copy['dayofyear'] / 365.25)
    df_copy['minute_sin'] = np.sin(2 * np.pi * df_copy['minute'] / 60) # Peut être utile à la minute
    df_copy['minute_cos'] = np.cos(2 * np.pi * df_copy['minute'] / 60)

    return df_copy

df_train_full = create_features(df_train_full)

# Lags à créer (en minutes) - choisir des lags pertinents
# Courts termes (minutes récentes), horaires, journaliers
lag_list = [1, 2, 3, 5, 10, 15, 30, 60, 120, 180, 60*6, 60*12, 1440, 1440*2, 1440*7] # Ex: 1min, 2min... 1h, 2h, 6h, 12h, 1j, 2j, 7j

def create_lags(dataframe, lags):
    """Crée les caractéristiques de décalage."""
    df_copy = dataframe.copy()
    for lag in lags:
        # Shift ne fonctionne pas bien avec des index Datetime potentiellement non contigus si des trous existent
        # Il est plus sûr d'utiliser une approche de reindexation/map si l'index n'est pas garanti complet
        # Mais si df.asfreq('min') a été utilisé ou si les données sont complètes, shift est ok.
        df_copy[f'lag_{lag}'] = df_copy['puissance'].shift(lag)
    return df_copy

df_train_full = create_lags(df_train_full, lag_list)

# Supprimer les lignes avec NaN introduites par les lags (surtout le lag le plus long)
print(f"Nombre de lignes avant suppression des NaNs dus aux lags: {len(df_train_full)}")
df_train_full.dropna(inplace=True)
print(f"Nombre de lignes après suppression des NaNs: {len(df_train_full)}")


# --- 3. Préparation pour l'Entraînement ---
features = [col for col in df_train_full.columns if col != 'puissance']
target = 'puissance'

X_train = df_train_full[features]
y_train = df_train_full[target]

print(f"Caractéristiques utilisées pour l'entraînement: {features}")
print(f"Dimensions de X_train: {X_train.shape}, y_train: {y_train.shape}")

# --- 4. Entraînement du Modèle XGBoost ---
print("Entraînement du modèle XGBoost...")
model = xgb.XGBRegressor(
    objective='reg:squarederror',
    n_estimators=1000,          # Nombre d'arbres (peut nécessiter un ajustement)
    learning_rate=0.05,         # Taux d'apprentissage (petit pour plus de robustesse)
    max_depth=7,                # Profondeur max des arbres (contrôle la complexité)
    subsample=0.8,              # Fraction d'échantillons par arbre
    colsample_bytree=0.8,       # Fraction de caractéristiques par arbre
    random_state=42,
    n_jobs=-1,                  # Utiliser tous les coeurs CPU
    # Paramètres pour potentiellement améliorer la gestion des séries temporelles
    # tree_method='hist',       # Méthode de construction d'arbre rapide
    # enable_categorical=True,  # Si vous avez des caractéristiques catégorielles explicites
    early_stopping_rounds=50    # Arrêter l'entraînement si la performance ne s'améliore pas
)

# Utiliser un set d'évaluation pour early stopping (optionnel mais recommandé)
# Ici on utilise les dernières données d'entraînement comme validation simple
eval_set = [(X_train, y_train)] # Idéalement, avoir un set de validation séparé

model.fit(X_train, y_train,
          eval_set=eval_set,
          verbose=100) # Afficher la progression tous les 100 arbres

print("Entraînement terminé.")

# --- 5. Prédiction Itérative pour les 24 prochaines heures ---
print("Début de la prédiction itérative pour les 1440 prochaines minutes...")

# Définir la plage de temps pour la prédiction
future_start_date = df_train_full.index.max() + timedelta(minutes=1)
future_end_date = future_start_date + timedelta(minutes=1440 - 1) # 1440 minutes au total
future_timestamps = pd.date_range(start=future_start_date, end=future_end_date, freq='min')

# Créer un DataFrame pour stocker les prédictions futures
future_predictions = pd.DataFrame(index=future_timestamps)
future_predictions['puissance_predite'] = np.nan

# Combiner les données historiques (pour les lags) et le DataFrame futur
# Nous aurons besoin d'au moins max(lag_list) points de données historiques
max_lag = max(lag_list)
history_for_lags = df_train_full['puissance'].iloc[-max_lag:].copy() # Dernières valeurs connues

# Boucle de prédiction itérative
for timestamp in future_timestamps:
    # 1. Créer les caractéristiques temporelles pour le timestamp actuel
    current_features_df = pd.DataFrame(index=[timestamp])
    current_features_df = create_features(current_features_df)

    # 2. Calculer les caractéristiques de décalage (lags) pour le timestamp actuel
    # Utiliser les valeurs de 'history_for_lags' qui contient les données réelles + les prédictions précédentes
    for lag in lag_list:
        lag_timestamp = timestamp - timedelta(minutes=lag)
        try:
            # Chercher la valeur dans l'historique combiné
            lag_value = history_for_lags.loc[lag_timestamp]
            current_features_df[f'lag_{lag}'] = lag_value
        except KeyError:
            # Si la valeur pour le lag n'est pas trouvée (trop loin dans le passé avant le début de history_for_lags)
            current_features_df[f'lag_{lag}'] = np.nan # Ou une autre imputation si nécessaire

    # S'assurer que les colonnes sont dans le même ordre que X_train
    current_features_input = current_features_df[features]

    # Gérer les NaNs restants potentiels dans les lags (si l'historique n'était pas assez long)
    # Une stratégie simple est de remplir avec la moyenne ou 0, mais cela peut introduire des biais.
    # Idéalement, s'assurer que history_for_lags remonte assez loin.
    if current_features_input.isnull().values.any():
        print(f"Attention: NaN trouvé dans les caractéristiques pour {timestamp}. Imputation simple (0).")
        current_features_input.fillna(0, inplace=True) # Remplacer NaN par 0 (ou autre stratégie)


    # 3. Faire la prédiction pour le timestamp actuel
    prediction = model.predict(current_features_input)[0]

    # Empêcher les prédictions négatives si la puissance ne peut pas être négative
    if prediction < 0:
        prediction = 0

    # 4. Stocker la prédiction
    future_predictions.loc[timestamp, 'puissance_predite'] = prediction

    # 5. Mettre à jour l'historique avec la nouvelle prédiction pour le calcul des lags futurs
    history_for_lags.loc[timestamp] = prediction

print("Prédiction itérative terminée.")

# --- 6. Afficher ou Sauvegarder les Résultats ---
print("\nAperçu des prédictions pour le 01/11/2023:")
print(future_predictions.head())
print(future_predictions.tail())

# Optionnel: Sauvegarder les prédictions
# future_predictions.to_csv('predictions_puissance_01_nov_2023.csv')

# Optionnel: Visualiser les résultats
print("Visualisation des résultats...")
plt.figure(figsize=(18, 7))

# Afficher les dernières 48h de données réelles pour le contexte
plt.plot(df_train_full.index[-1440*2:], df_train_full['puissance'][-1440*2:], label='Données réelles (48h précédentes)', color='blue', alpha=0.7)

# Afficher les prédictions
plt.plot(future_predictions.index, future_predictions['puissance_predite'], label='Prédictions XGBoost (Prochaines 24h)', color='red')

plt.title('Prédiction de la Puissance Générée (XGBoost Itératif)')
plt.xlabel('Timestamp')
plt.ylabel('Puissance Générée')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()

print("Terminé.")
Explication du Code
Décomposition des Étapes Clés
- Chargement et Préparation : Charge les données depuis un fichier CSV, s'assure que la colonne `timestamp` est au format datetime et définie comme index, puis filtre les données pour ne garder que celles jusqu'au 31 octobre 2023.
- Ingénierie des Caractéristiques (`create_features`, `create_lags`) :
- `create_features` : Extrait des caractéristiques temporelles standards (heure, jour, mois...) et des transformations cycliques (sin/cos) pour aider le modèle à mieux interpréter les cycles.
- `create_lags` : Crée de nombreuses caractéristiques de décalage (lags) en utilisant la méthode `shift()`. Une liste variée de lags (minutes récentes, heures, jours) est utilisée pour capturer différentes dynamiques temporelles.
- Les lignes contenant des `NaN` (créées par les lags au début de la série) sont supprimées avant l'entraînement.
- Préparation pour l'Entraînement : Sépare les caractéristiques (`X_train`) de la cible (`y_train`).
- Entraînement du Modèle : Initialise et entraîne un `XGBRegressor`. Des hyperparamètres raisonnables sont fournis, mais pourraient être optimisés (par ex., via validation croisée). `early_stopping_rounds` est utilisé pour éviter le surapprentissage en arrêtant l'entraînement si les performances sur un set d'évaluation ne s'améliorent plus pendant 50 tours.
- Prédiction Itérative :
- Définit la plage de temps future (les 1440 minutes du 1er novembre 2023).
- Initialise un DataFrame `future_predictions` pour stocker les résultats.
- Crée `history_for_lags`, une série contenant les dernières valeurs réelles connues, qui sera mise à jour avec les prédictions.
- Itère sur chaque `timestamp` futur :
- Crée les caractéristiques temporelles pour ce timestamp.
- Calcule les lags en se basant sur les valeurs dans `history_for_lags`.
- Fait la prédiction avec le modèle entraîné.
- Stocke la prédiction.
- Ajoute la prédiction à `history_for_lags` pour qu'elle puisse être utilisée pour les lags des timestamps suivants.
- Affichage/Sauvegarde : Affiche les premières et dernières prédictions et trace un graphique comparant les données historiques récentes aux prédictions futures.
Visualisation des Facteurs de Qualité
Évaluation des Composantes Clés pour une Bonne Prédiction
La qualité de votre prédiction de série temporelle avec XGBoost dépend de plusieurs facteurs interdépendants. Le graphique radar ci-dessous illustre l'importance relative de certains de ces facteurs pour obtenir des prédictions précises et dynamiques.
Ce graphique souligne que, bien que tous les facteurs soient importants, une sélection judicieuse des lags et une richesse des caractéristiques temporelles sont particulièrement cruciales pour permettre à XGBoost de modéliser la dynamique temporelle et d'éviter les prédictions plates.
Représentation du Flux de Travail
Mindmap du Processus de Prédiction
Le diagramme ci-dessous résume les étapes clés du processus de prédiction de séries temporelles avec XGBoost, tel que décrit dans ce guide.
Ce flux de travail montre comment les données brutes sont transformées et utilisées pour entraîner un modèle, qui est ensuite employé dans une boucle itérative pour générer les prédictions futures.
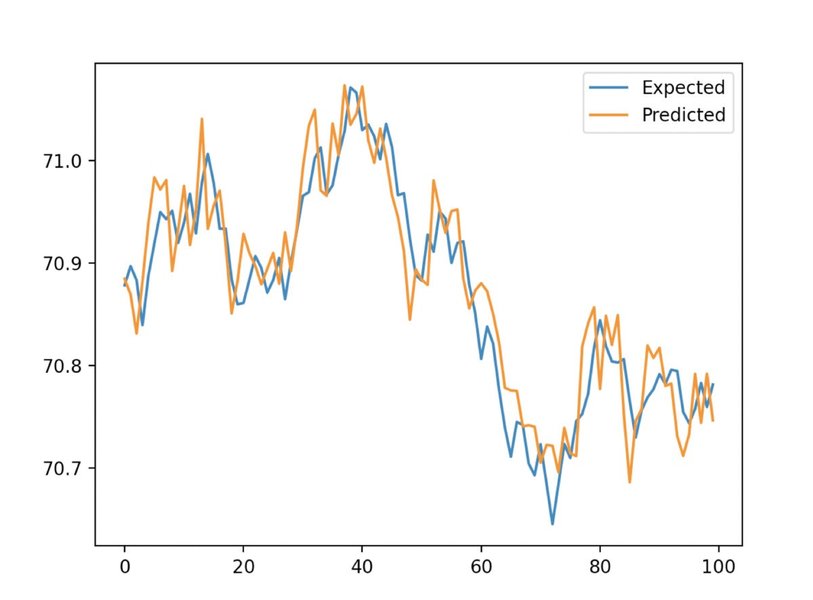
Visualisation conceptuelle liée à la prévision de séries temporelles.
Table Récapitulative des Caractéristiques Créées
Exemples et Utilité
Le tableau suivant résume certaines des caractéristiques clés créées dans le code et leur rôle dans l'amélioration des prédictions.
| Type de Caractéristique | Exemple(s) | Objectif Principal |
|---|---|---|
| Temporelle Basique | `hour`, `dayofweek`, `month` | Capturer les cycles journaliers, hebdomadaires, annuels. |
| Temporelle Cyclique | `hour_sin`, `hour_cos`, `dayofyear_sin` | Représenter correctement la nature cyclique du temps pour le modèle (ex: proximité entre 23h et 0h). |
| Décalage (Lag) Court Terme | `lag_1`, `lag_5`, `lag_10` | Informer le modèle sur la dynamique très récente de la puissance. Forte influence sur la prédiction immédiate. |
| Décalage (Lag) Moyen Terme | `lag_60`, `lag_120`, `lag_360` | Capturer les dépendances sur quelques heures (ex: patterns intra-journaliers). |
| Décalage (Lag) Long Terme | `lag_1440`, `lag_1440*7` | Informer le modèle sur la valeur à la même heure le jour précédent ou la semaine précédente. Crucial pour la saisonnalité journalière/hebdomadaire. |
La combinaison de ces différents types de caractéristiques donne à XGBoost les informations nécessaires pour modéliser les complexités de la série temporelle de production d'énergie.
Apprendre Davantage sur XGBoost pour les Séries Temporelles
Tutoriel Vidéo Pertinent
Pour approfondir votre compréhension de l'utilisation de XGBoost pour la prévision de séries temporelles, y compris l'ingénierie des caractéristiques, la vidéo ci-dessous (en anglais) offre d'excellentes explications et exemples pratiques.
Cette vidéo, "Time Series Forecasting with XGBoost" par Rob Mulla, couvre des concepts similaires à ceux abordés ici, notamment la création de caractéristiques temporelles et de lags, et l'entraînement d'un modèle XGBoost pour la prédiction. Elle peut vous fournir des perspectives supplémentaires et renforcer votre compréhension.
Questions Fréquemment Posées (FAQ)
Pourquoi mes prédictions XGBoost étaient-elles constantes ?
Les prédictions constantes ou plates avec XGBoost pour les séries temporelles surviennent généralement lorsque le modèle ne dispose pas d'informations suffisantes pour capturer la dynamique temporelle. Les causes courantes sont :
- Manque de caractéristiques de décalage (lags) : Sans savoir ce qui s'est passé récemment (dernière minute, dernière heure, dernier jour), le modèle ne peut pas extrapoler les tendances ou les cycles. Il peut alors se rabattre sur la prédiction de la valeur moyenne ou la plus fréquente.
- Manque de caractéristiques temporelles : Si le modèle ne sait pas s'il prédit pour 3h du matin ou 14h de l'après-midi, il ne peut pas tenir compte des cycles journaliers typiques de la production d'énergie.
- Modèle trop simple ou sous-entraîné : Des hyperparamètres mal réglés (par ex., `max_depth` trop faible, `n_estimators` insuffisant) peuvent empêcher le modèle d'apprendre des motifs complexes.
- Horizon de prédiction trop long sans stratégie adaptée : Tenter de prédire 1440 pas d'un coup sans approche itérative peut entraîner une dégradation rapide de la qualité et des prédictions plates.
L'approche décrite dans ce guide (features riches + prédiction itérative) vise à pallier ces problèmes.
Quels lags choisir et combien ?
Le choix des lags dépend de la nature de votre série temporelle et de l'horizon de prédiction. Pour une série de production d'énergie à la minute avec un horizon de 24h, une bonne stratégie est d'inclure :
- Lags très courts : 1, 2, 3, 5, 10, 15 minutes. Capture l'autocorrélation immédiate.
- Lags horaires : 60, 120, 180 minutes (1h, 2h, 3h). Capture les dépendances sur quelques heures.
- Lags semi-journaliers/journaliers : 6*60, 12*60, 24*60=1440 minutes. Essentiels pour capturer les cycles journaliers (comparaison avec la même heure la veille).
- Lags hebdomadaires (optionnel) : 1440 * 7 minutes. Utile si des cycles hebdomadaires sont présents.
Il n'y a pas de règle absolue. Expérimentez et utilisez l'importance des caractéristiques (`feature_importances_` de XGBoost après entraînement) pour voir quels lags sont les plus utiles pour votre modèle. Trop de lags peuvent augmenter la complexité et le temps de calcul.
Comment puis-je encore améliorer la précision des prédictions ?
Plusieurs pistes peuvent être explorées :
- Optimisation des hyperparamètres : Utiliser des techniques comme `GridSearchCV` ou `RandomizedSearchCV` (de scikit-learn) ou des bibliothèques comme Optuna pour trouver les meilleurs hyperparamètres pour XGBoost (
n_estimators,learning_rate,max_depth, etc.). - Ajout de caractéristiques externes : Si disponibles, intégrer des données météorologiques (température, ensoleillement/irradiation, vitesse du vent, couverture nuageuse) qui influencent fortement la production d'énergie (solaire, éolienne). Ces données devront également être prédites ou connues pour la période de prévision.
- Ajout de statistiques roulantes : Créer des features comme la moyenne mobile, l'écart-type mobile, min/max mobiles sur différentes fenêtres de temps passées.
- Gestion plus fine des valeurs manquantes : Si vos données contiennent des trous, des méthodes d'imputation plus sophistiquées que le simple `dropna()` ou `fillna(0)` pourraient aider.
- Modèles hybrides : Combiner XGBoost avec d'autres modèles (par ex., un modèle de tendance de base comme ARIMA, ou même des LSTMs) pour capturer différents aspects de la série.
- Validation croisée temporelle : Utiliser des schémas de validation croisée spécifiques aux séries temporelles (comme `TimeSeriesSplit` de scikit-learn) pour une évaluation plus robuste des performances et de l'optimisation des hyperparamètres.
Références
Ressources Utiles
Voici quelques ressources pertinentes qui approfondissent l'utilisation de XGBoost pour la prévision de séries temporelles :
- How to Use XGBoost for Time Series Forecasting - MachineLearningMastery.com
- Use XGBoost for Time-Series Forecasting - Analytics Vidhya
- Tutorial: Time Series Forecasting with XGBoost - Kaggle
- How to use XGBoost for accurate time series forecasting? - Medium
- Time Series Forecasting with XGBoost - GitHub Project Example
- Time Series Forecasting with XGBoost - YouTube Tutorial (Rob Mulla)
Recherches Recommandées
Explorez Plus Loin
Last updated April 19, 2025