
Comment la Validation Croisée Révolutionne la Comparaison de Modèles en Machine Learning ?
Découvrez les techniques et les étapes clés pour évaluer et sélectionner objectivement les modèles prédictifs les plus performants.
La comparaison de modèles via la validation croisée (ou *cross-validation*) est une pierre angulaire de l'apprentissage automatique. Elle offre une méthode statistique robuste pour évaluer la capacité d'un modèle à généraliser ses prédictions sur de nouvelles données, c'est-à-dire des données qu'il n'a pas rencontrées lors de sa phase d'entraînement. Cette approche est cruciale pour choisir le modèle le plus adapté à une tâche spécifique, en minimisant les risques de surapprentissage et en assurant une évaluation équitable des performances.
Les Essentiels de la Comparaison de Modèles par Validation Croisée
- Évaluation Fiable : La validation croisée fournit une estimation plus stable et moins biaisée de la performance d'un modèle sur des données inconnues par rapport à une simple division entraînement/test.
- Prévention du Surapprentissage : En testant le modèle sur plusieurs sous-ensembles de données distincts, elle aide à identifier si un modèle mémorise les données d'entraînement (surapprentissage) plutôt que d'apprendre à généraliser.
- Comparaison Objective : Elle permet de comparer différents algorithmes ou configurations d'hyperparamètres sur une base d'évaluation rigoureuse et identique pour tous les modèles, facilitant un choix éclairé.
Comprendre la Validation Croisée et son Rôle dans la Comparaison des Modèles
Qu'est-ce que la Validation Croisée ?
La validation croisée est une technique de rééchantillonnage qui consiste à partitionner l'ensemble de données initial en plusieurs sous-ensembles, appelés "plis" (ou *folds*). Le processus d'entraînement et de validation du modèle est ensuite répété plusieurs fois. À chaque itération, un pli différent est utilisé comme ensemble de validation (pour tester le modèle), tandis que les plis restants sont utilisés pour entraîner le modèle. Les résultats de performance (par exemple, l'exactitude, l'erreur quadratique moyenne) de chaque itération sont ensuite moyennés pour obtenir une estimation globale de la performance du modèle.
Pourquoi Utiliser la Validation Croisée pour Comparer des Modèles ?
L'utilisation de la validation croisée pour la comparaison de modèles présente plusieurs avantages significatifs :
- Réduction de la Variance de l'Évaluation : Contrairement à une unique division entraînement/validation, dont les résultats peuvent fortement dépendre de la composition aléatoire de ces ensembles, la validation croisée utilise l'intégralité (ou presque) des données pour l'entraînement et la validation à travers les différentes itérations. Cela conduit à une estimation plus robuste et moins sensible au partitionnement initial des données.
- Détection du Surapprentissage (Overfitting) : Le surapprentissage survient lorsqu'un modèle excelle sur les données d'entraînement mais échoue à généraliser sur de nouvelles données. La validation croisée aide à détecter ce phénomène en évaluant le modèle sur des données qu'il n'a pas vues pendant l'entraînement à chaque pli. Une grande différence de performance entre les scores d'entraînement et les scores de validation moyens peut indiquer un surapprentissage.
- Utilisation Efficace des Données : Surtout avec des ensembles de données de taille limitée, la validation croisée permet d'utiliser chaque point de données à la fois pour l'entraînement et pour la validation, maximisant ainsi l'information extraite des données disponibles.
- Comparaison Équitable des Modèles : Pour comparer différents algorithmes (par exemple, une régression logistique vs. une forêt aléatoire) ou différentes configurations d'hyperparamètres pour un même algorithme, il est crucial d'utiliser la même procédure de validation croisée et les mêmes plis pour chaque modèle. Cela garantit que les différences de performance observées sont dues aux modèles eux-mêmes et non à des variations dans les données de validation.
- Optimisation des Hyperparamètres : La validation croisée est couramment utilisée dans les procédures de recherche d'hyperparamètres (comme la recherche par grille ou la recherche aléatoire) pour évaluer la performance de chaque combinaison d'hyperparamètres et sélectionner la meilleure.
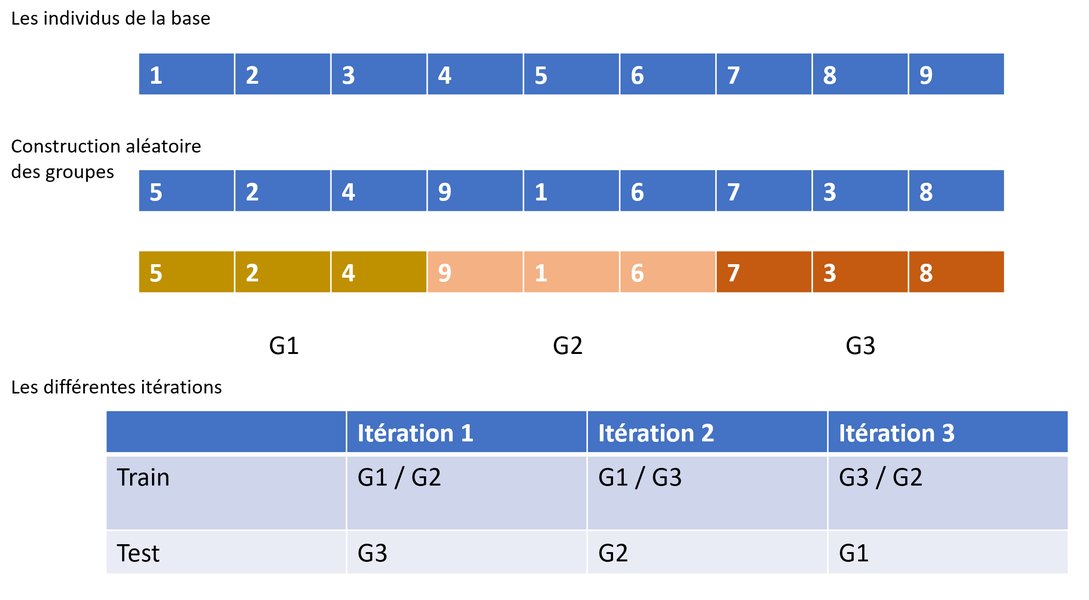
Illustration schématique de la validation croisée K-Fold, montrant la division des données en K plis et l'itération du processus d'entraînement/validation.
Principales Techniques de Validation Croisée pour la Comparaison de Modèles
Plusieurs méthodes de validation croisée existent, chacune avec ses spécificités, ses avantages et ses inconvénients. Le choix de la technique dépend souvent de la taille de l'ensemble de données, de la nature du problème (classification, régression) et des ressources computationnelles disponibles.
Validation Croisée K-Fold (K-Fold Cross-Validation)
C'est la technique la plus répandue et souvent considérée comme un bon compromis entre robustesse de l'évaluation et coût computationnel.
Fonctionnement
L'ensemble de données original est divisé aléatoirement en K sous-ensembles (ou "plis") de taille approximativement égale. Le processus se déroule ensuite en K itérations :
- À chaque itération i (de 1 à K), le i-ème pli est utilisé comme ensemble de validation.
- Les K-1 plis restants sont utilisés comme ensemble d'entraînement.
- Le modèle est entraîné sur l'ensemble d'entraînement et évalué sur l'ensemble de validation. La métrique de performance est enregistrée.
Après les K itérations, la performance globale du modèle est généralement estimée par la moyenne des K métriques de performance obtenues. Les valeurs courantes pour K sont 5 ou 10. Un K plus élevé réduit le biais de l'estimation de la performance mais augmente la variance et le temps de calcul.
Validation Croisée Leave-One-Out (LOOCV)
La LOOCV est un cas extrême de la validation croisée K-Fold où le nombre de plis K est égal au nombre total N d'échantillons dans l'ensemble de données.
Fonctionnement
À chaque itération, un seul échantillon est utilisé comme ensemble de validation, et les N-1 échantillons restants sont utilisés pour entraîner le modèle. Ce processus est répété N fois.
La LOOCV fournit une estimation de la performance qui est généralement peu biaisée, car presque toutes les données sont utilisées pour l'entraînement à chaque étape. Cependant, elle peut être très coûteuse en termes de calcul, surtout pour les grands ensembles de données. Elle peut également présenter une variance élevée pour l'estimation de l'erreur de prédiction.
Validation Croisée Stratifiée K-Fold (Stratified K-Fold Cross-Validation)
Cette variante de la K-Fold est particulièrement utile pour les problèmes de classification, surtout lorsque les classes sont déséquilibrées (c'est-à-dire que certaines classes sont beaucoup moins représentées que d'autres).
Fonctionnement
La stratification garantit que chaque pli conserve approximativement la même proportion d'échantillons de chaque classe que l'ensemble de données original. Cela permet d'obtenir une estimation plus fiable et plus réaliste de la performance du modèle, en évitant que certains plis ne contiennent que peu ou pas d'échantillons d'une classe minoritaire.
Méthode Hold-Out (Division simple Entraînement/Test)
Bien que techniquement ce ne soit pas une méthode de validation *croisée* au sens strict (car il n'y a pas de "croisement" ou d'itération multiple avec des ensembles de validation différents), elle est souvent mentionnée comme la forme la plus simple d'évaluation de modèle.
Fonctionnement
L'ensemble de données est divisé une seule fois en deux sous-ensembles : un ensemble d'entraînement (généralement plus grand, par exemple 70-80% des données) et un ensemble de test (ou de validation, le reste des données). Le modèle est entraîné sur l'ensemble d'entraînement et sa performance est évaluée sur l'ensemble de test.
L'inconvénient majeur de cette méthode est que l'estimation de la performance dépend fortement de la manière dont la division a été effectuée. Si, par hasard, l'ensemble de test contient des échantillons particulièrement faciles ou difficiles à prédire, l'évaluation sera respectivement trop optimiste ou pessimiste.
Le tableau suivant résume ces techniques :
| Technique de Validation | Description | Avantages | Inconvénients | Cas d'Usage Typiques |
|---|---|---|---|---|
| Hold-Out | Division unique des données en ensembles d'entraînement et de test. | Simple et rapide à mettre en œuvre. | Forte dépendance à la division aléatoire ; estimation de performance potentiellement instable. | Grands ensembles de données où la rapidité est primordiale ; évaluation initiale rapide. |
| K-Fold | Division en K plis ; K itérations où chaque pli sert une fois de validation. | Bon compromis entre robustesse et coût de calcul ; utilise toutes les données pour l'entraînement et la validation. | Peut être coûteux pour K élevé ou des modèles complexes. | Méthode standard pour l'évaluation et la comparaison de modèles ; optimisation d'hyperparamètres. |
| Leave-One-Out (LOOCV) | Cas particulier de K-Fold où K = nombre d'échantillons (N). Chaque échantillon sert de validation. | Estimation de performance peu biaisée ; utilise au maximum les données d'entraînement. | Très coûteux en calcul pour N grand ; variance de l'estimation parfois élevée. | Petits ensembles de données où chaque point de données est précieux. |
| Stratifiée K-Fold | K-Fold où chaque pli maintient la proportion des classes de l'ensemble original. | Robuste pour les données déséquilibrées ; estimations plus fiables en classification. | Mêmes inconvénients que K-Fold en termes de coût. | Problèmes de classification avec des classes déséquilibrées. |
Étapes Pratiques pour Comparer des Modèles avec la Validation Croisée
Comparer efficacement des modèles à l'aide de la validation croisée implique un processus structuré. Voici une vue d'ensemble de ce processus, illustrée par un schéma conceptuel, suivie d'une description détaillée des étapes.
Le schéma suivant illustre les interactions clés dans le processus de comparaison de modèles utilisant la validation croisée :
Ce schéma mental décompose le processus en étapes logiques, depuis la préparation initiale des données jusqu'à la sélection finale du modèle le plus performant.
Étapes Détaillées du Processus de Comparaison
1. Préparation des Données
Avant toute modélisation, les données doivent être soigneusement préparées. Cela inclut :
- Nettoyage des données : Traitement des valeurs manquantes, des outliers, correction des erreurs.
- Prétraitement : Normalisation ou standardisation des variables numériques, encodage des variables catégorielles, ingénierie de fonctionnalités (feature engineering).
- Division initiale (optionnelle mais recommandée) : Il est souvent judicieux de mettre de côté un ensemble de test final complètement indépendant avant de commencer la validation croisée. Cet ensemble ne sera utilisé qu'une seule fois, à la toute fin, pour évaluer la performance du modèle final sélectionné. La validation croisée sera alors appliquée sur le reste des données (l'ensemble d'entraînement/validation).
- Attention aux fuites de données (data leakage) : Toutes les étapes de prétraitement qui dépendent des données (comme le calcul de la moyenne et de l'écart-type pour la standardisation, ou l'apprentissage d'un encodeur) doivent être effectuées *à l'intérieur* de chaque pli de la validation croisée. C'est-à-dire, apprenez les transformateurs uniquement sur l'ensemble d'entraînement du pli courant, puis appliquez-les à l'ensemble d'entraînement et de validation de ce pli.
2. Sélection des Modèles Candidats
Choisissez les algorithmes ou les configurations de modèles que vous souhaitez comparer. Il peut s'agir de types de modèles complètement différents (par exemple, SVM vs. Arbre de Décision) ou de variations d'un même type de modèle avec différents hyperparamètres.
3. Définition et Exécution de la Validation Croisée
- Choisir la méthode de validation croisée : K-Fold, Stratified K-Fold, LOOCV, etc., en fonction de la nature de vos données et de votre problème.
- Définir K (pour K-Fold) : Généralement 5 ou 10.
- Choisir la ou les métriques d'évaluation : Par exemple, exactitude (accuracy), précision, rappel, score F1 pour la classification ; Erreur Quadratique Moyenne (RMSE), Erreur Absolue Moyenne (MAE) pour la régression.
- Exécuter la validation croisée : Pour chaque modèle candidat, appliquez la procédure de validation croisée choisie. Il est crucial d'utiliser les mêmes plis (les mêmes divisions de données) pour tous les modèles comparés afin d'assurer une comparaison équitable. La plupart des bibliothèques de machine learning permettent de fixer une graine aléatoire (random seed) pour la division des plis, garantissant ainsi leur reproductibilité.
- Collecter les scores : Pour chaque modèle et pour chaque pli, enregistrez la ou les métriques de performance obtenues sur l'ensemble de validation du pli.
4. Analyse des Résultats et Comparaison des Modèles
Après avoir exécuté la validation croisée pour tous les modèles candidats, vous disposerez d'un ensemble de scores de performance pour chaque modèle (par exemple, K scores si vous avez utilisé la K-Fold).
- Calculer les statistiques agrégées : Pour chaque modèle, calculez la moyenne et l'écart-type (ou une autre mesure de dispersion) des scores de performance obtenus sur les plis. La moyenne donne une estimation de la performance attendue du modèle, tandis que l'écart-type indique la stabilité de cette performance.
- Tests statistiques (optionnel) : Si les performances moyennes de deux modèles sont proches, des tests statistiques (comme un test t apparié sur les scores des plis) peuvent aider à déterminer si la différence est statistiquement significative.
- Visualisation : Des diagrammes en boîte (box plots) des scores de validation croisée pour chaque modèle peuvent être très utiles pour visualiser et comparer leurs distributions de performance.
5. Sélection du Meilleur Modèle
Sur la base des performances moyennes, de la variabilité des performances, et potentiellement d'autres critères (complexité du modèle, temps d'inférence, interprétabilité, exigences métier), sélectionnez le modèle qui semble le plus prometteur.
6. Validation Finale (Optionnelle mais Recommandée)
Si vous aviez mis de côté un ensemble de test final à l'étape 1, c'est maintenant le moment de l'utiliser. Entraînez le modèle sélectionné (avec les hyperparamètres optimisés, le cas échéant) sur l'intégralité de l'ensemble d'entraînement/validation (c'est-à-dire toutes les données sauf l'ensemble de test final). Ensuite, évaluez sa performance sur l'ensemble de test final. Ce score vous donnera une estimation finale et impartiale de la capacité de généralisation de votre modèle choisi sur des données entièrement nouvelles.
Visualisation Comparative des Performances de Modèles Hypothétiques
Pour illustrer comment les résultats de la validation croisée peuvent être utilisés pour comparer des modèles, considérons le graphique radar suivant. Il présente les performances hypothétiques de trois modèles (Modèle Alpha, Modèle Bêta, Modèle Gamma) évalués selon plusieurs métriques clés issues d'une procédure de validation croisée. Les métriques incluent l'Exactitude, la Précision, le Rappel (Recall), le Score F1, une faible Erreur (inverse de RMSE, par exemple), et une faible Consommation de Ressources (inverse du temps d'entraînement/inférence). Des scores plus élevés sont meilleurs pour toutes ces dimensions.
Dans cet exemple, le Modèle Bêta semble globalement le plus performant, avec des scores élevés sur la plupart des métriques. Le Modèle Alpha est compétitif, tandis que le Modèle Gamma, bien que performant en Précision, est moins efficace en termes de coût computationnel et de Rappel. Ce type de visualisation aide à prendre une décision éclairée, en considérant les compromis entre les différentes facettes de la performance.
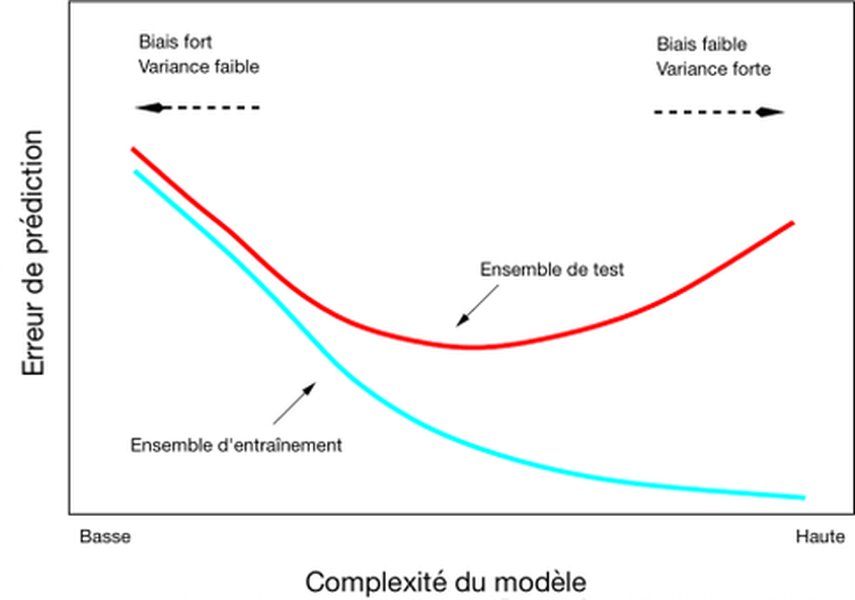
Le compromis biais-variance est un concept central lié à la performance des modèles. La validation croisée aide à trouver un modèle qui équilibre bien ces deux aspects pour une meilleure généralisation.
Avantages et Limitations de la Comparaison via Validation Croisée
Principaux Avantages
- Estimation Robuste de la Performance : Fournit une évaluation plus fiable de la capacité de généralisation du modèle que la simple division entraînement/test.
- Utilisation Optimale des Données : Chaque point de données est utilisé à la fois pour l'entraînement et la validation, ce qui est particulièrement utile pour les ensembles de données de petite taille.
- Détection du Surapprentissage : Aide à identifier les modèles qui mémorisent les données d'entraînement au lieu d'apprendre des motifs généralisables.
- Comparaison Objective entre Modèles : En utilisant les mêmes plis pour tous les modèles, elle permet une comparaison équitable de leurs performances.
- Aide à la Sélection d'Hyperparamètres : Indispensable pour régler les hyperparamètres d'un modèle de manière systématique.
Limitations et Précautions à Prendre
- Coût Computationnel : Répéter l'entraînement et l'évaluation K fois (pour K-Fold) peut être très coûteux en temps de calcul, surtout avec de grands ensembles de données, des modèles complexes ou un K élevé. La LOOCV est la plus coûteuse.
- Fuites de Données (Data Leakage) : Si le prétraitement des données (par exemple, la normalisation, la sélection de caractéristiques) n'est pas effectué correctement à l'intérieur de chaque boucle de validation croisée (c'est-à-dire en l'apprenant uniquement sur l'ensemble d'entraînement du pli courant), des informations de l'ensemble de validation peuvent "fuir" dans le processus d'entraînement, conduisant à des estimations de performance trop optimistes.
- Choix de K : Le choix du nombre de plis (K) peut influencer l'estimation de la performance. Un K trop petit peut donner une estimation à variance élevée. Un K trop grand augmente le coût et peut aussi augmenter la variance de l'estimateur de performance (LOOCV a souvent une variance élevée). K=5 ou K=10 sont des choix courants offrant un bon compromis.
- Dépendance entre les Données : Pour les données avec une structure de dépendance (par exemple, séries temporelles, données spatiales), la validation croisée K-Fold standard peut ne pas être appropriée car elle ne respecte pas ces dépendances. Des variantes spécifiques comme la validation croisée pour séries temporelles (Time Series Cross-Validation) ou la validation croisée spatiale sont nécessaires.
Vidéo Explicative sur la Validation Croisée
Pour approfondir votre compréhension de la validation croisée et de son application pour évaluer l'efficacité des modèles en machine learning, la vidéo suivante offre une excellente introduction visuelle et conceptuelle. Elle explique les principes fondamentaux de la validation croisée K-Fold, une technique incontournable.
Cette vidéo présente la technique de la validation croisée (K-fold cross-validation), essentielle en machine learning pour évaluer les modèles.
Questions Fréquemment Posées (FAQ)
Qu'est-ce que le surapprentissage (overfitting) et comment la validation croisée aide-t-elle à le gérer ?
Le surapprentissage se produit lorsqu'un modèle apprend "par cœur" les données d'entraînement, y compris le bruit et les particularités spécifiques à cet ensemble, au lieu d'apprendre les tendances générales. En conséquence, le modèle performe très bien sur les données d'entraînement mais mal sur de nouvelles données invisibles.
La validation croisée aide à détecter et à atténuer le surapprentissage en évaluant le modèle sur plusieurs ensembles de validation distincts tirés des données d'origine. Si un modèle montre une performance significativement meilleure sur les ensembles d'entraînement des plis que sur les ensembles de validation correspondants, c'est un signe de surapprentissage. Cela permet de choisir des modèles ou des hyperparamètres qui généralisent mieux.
Combien de "plis" (K) devrais-je utiliser dans la validation croisée K-Fold ?
Le choix de K dans la validation croisée K-Fold est un compromis. Les valeurs couramment utilisées sont K=5 ou K=10.
- Un K plus petit (ex: K=3) réduit le temps de calcul mais peut conduire à une estimation de la performance avec un biais plus élevé et une variance plus importante, car les ensembles d'entraînement sont plus petits et les ensembles de validation plus grands.
- Un K plus grand (ex: K=N, ce qui correspond à la LOOCV) utilise plus de données pour l'entraînement à chaque pli, réduisant le biais de l'estimation. Cependant, cela augmente considérablement le temps de calcul et peut augmenter la variance de l'estimateur de performance car les ensembles d'entraînement des différents plis sont très similaires.
K=10 est souvent recommandé comme un bon équilibre. Pour les très grands ensembles de données, un K plus petit comme K=3 ou K=5 peut être suffisant et plus rapide.
La validation croisée garantit-elle que je choisirai le meilleur modèle possible ?
La validation croisée est un outil puissant pour estimer la performance de généralisation d'un modèle et pour comparer des modèles de manière plus robuste. Elle aide à prendre une décision plus éclairée, mais elle ne garantit pas de trouver le "meilleur" modèle absolu pour plusieurs raisons :
- L'estimation de la performance reste une estimation, sujette à une certaine variabilité.
- La "meilleure" performance selon une métrique donnée (par exemple, l'exactitude) ne signifie pas toujours que le modèle est le meilleur pour l'application métier spécifique, qui peut avoir d'autres contraintes (interprétabilité, coût de déploiement, temps d'inférence).
- La qualité des données initiales et la pertinence des caractéristiques (features) ont un impact majeur sur la performance, que la validation croisée ne peut compenser si elles sont médiocres.
Cependant, elle augmente considérablement les chances de sélectionner un modèle robuste et performant par rapport à des méthodes d'évaluation plus simples.
Quelle est la différence entre un ensemble de validation et un ensemble de test ?
Bien que les termes soient parfois utilisés de manière interchangeable, ils ont des rôles distincts dans un processus de modélisation rigoureux :
- L'ensemble de validation est utilisé pendant le processus de développement du modèle. Dans la validation croisée, les données sont divisées en plis, et chaque pli sert tour à tour d'ensemble de validation pour évaluer le modèle entraîné sur les autres plis. Il est utilisé pour régler les hyperparamètres du modèle et pour la sélection de modèles (comparer différentes architectures ou algorithmes).
- L'ensemble de test (ou *hold-out set*) est un sous-ensemble de données qui n'est jamais utilisé pendant l'entraînement ou le réglage des hyperparamètres. Il est mis de côté et utilisé une seule fois, à la toute fin, pour obtenir une estimation finale et impartiale de la performance du modèle sélectionné et finalisé. Il simule la performance du modèle sur des données réelles, nouvelles et invisibles.
L'utilisation d'un ensemble de test distinct est cruciale pour éviter une évaluation trop optimiste de la performance, car le modèle a pu indirectement "apprendre" des informations de l'ensemble de validation lors du processus d'optimisation des hyperparamètres.
Requêtes Recommandées pour Approfondir
- Comment implémenter la validation croisée K-Fold en Python avec Scikit-learn pour comparer des classifieurs ?
- Quelles sont les meilleures métriques pour comparer des modèles de régression en utilisant la validation croisée ?
- Comment gérer les fuites de données (data leakage) lors de l'utilisation de la validation croisée avec des étapes de prétraitement ?
- Validation croisée pour les séries temporelles : quelles sont les approches spécifiques et pourquoi sont-elles nécessaires ?
Références
 docs.aws.amazon.com
Last updated May 6, 2025