
Décoder la Performance : Analyser et Interpréter vos Modèles d'Apprentissage Automatique et Profond
Un guide structuré pour présenter les résultats de vos modèles, des autoencodeurs aux approches combinées et TabNet, avec clarté et perspicacité.
Comprendre et communiquer efficacement les résultats de multiples modèles d'apprentissage automatique (Machine Learning, ML) et d'apprentissage profond (Deep Learning, DL) est crucial pour tout projet axé sur les données. Cette section de votre rapport, "Résultats et Discussion", doit non seulement présenter les performances quantitatives, mais aussi offrir une interprétation éclairée, justifier les choix de modélisation, et visualiser les prédictions de manière intuitive. Ce guide vous aidera à structurer cette section de manière exhaustive, en mettant l'accent sur la clarté de l'implémentation des modèles individuels (autoencodeur seul, MLP seul), des approches combinées (Random Forest + autoencodeur, MLP + autoencodeur), et des architectures avancées comme TabNet.
Points Clés à Retenir
- Comparaison Systématique : Évaluez rigoureusement chaque modèle (ML, DL, hybride) en utilisant des métriques cohérentes et des visualisations claires comme les courbes d'apprentissage et les matrices de confusion.
- Justification Transparente : Expliquez en détail le choix du meilleur modèle, les avantages des combinaisons, et les raisons de l'utilisation spécifique de techniques de DL ou de ML.
- Analyse Approfondie : Allez au-delà des chiffres en discutant des limites, des biais potentiels, et en offrant des interprétations qualitatives des résultats et des visualisations de prédictions.
4. Résultats et Discussion
Cette section cruciale de votre rapport a pour objectif de présenter, d'analyser et d'interpréter les performances des différents modèles que vous avez développés et testés. Elle doit permettre au lecteur de comprendre non seulement *quels* modèles ont été les plus performants, mais aussi *pourquoi*, et comment les différentes approches (ML traditionnel, DL, combinaisons hybrides) se comparent.
4.1 Performances des Modèles
L'objectif ici est de présenter de manière quantitative et comparative les résultats obtenus par chaque architecture de modèle. Une attention particulière sera portée à la distinction entre les modèles de Machine Learning (ML), de Deep Learning (DL) et les approches hybrides qui combinent les deux.
Tableau Comparatif Exhaustif des Modèles
Un tableau synthétique est essentiel pour offrir une vue d'ensemble des performances. Ce tableau doit regrouper les métriques clés pour chaque modèle évalué, en distinguant clairement leur nature (ML, DL, Hybride).
Ce tableau comparatif permet d'évaluer rapidement les forces et faiblesses relatives de chaque approche. La colonne "Type" aide à contextualiser les performances en fonction de la nature du modèle (ML, DL, ou une synergie des deux). Les métriques choisies doivent être pertinentes pour votre tâche spécifique (classification, régression, etc.) et définies précédemment dans votre rapport. La colonne "Commentaire/Justification" offre un aperçu rapide du rôle ou d'une particularité du modèle.
| Modèle | Type | Métrique Principale (ex: Exactitude/RMSE) | Métrique Secondaire (ex: F1-Score/MAE) | Temps d'Entraînement Relatif | Commentaire / Justification Clé |
|---|---|---|---|---|---|
| Autoencodeur (seul) | DL | Erreur de Reconstruction (ex: MSE) | N/A (si utilisé pour pré-traitement) | Moyen | Principalement pour extraction de caractéristiques non supervisée ou réduction de dimension. Évalué sur sa capacité à reconstruire les données. |
| MLP (seul) | DL | Valeur (ex: 88%) | Valeur (ex: 0.87) | Moyen à Élevé | Performance de base d'un réseau de neurones profond standard. |
| Random Forest + Autoencodeur | Hybride (DL+ML) | Valeur (ex: 90%) | Valeur (ex: 0.89) | Moyen | Utilise les caractéristiques extraites par l'autoencodeur comme entrée pour le Random Forest. Combine l'apprentissage de représentation du DL avec la robustesse du ML. |
| MLP + Autoencodeur | Hybride (DL+DL) | Valeur (ex: 92%) | Valeur (ex: 0.91) | Élevé | Le MLP est entraîné sur les caractéristiques latentes apprises par l'autoencodeur, potentiellement améliorant la performance par rapport au MLP seul. |
| TabNet | DL | Valeur (ex: 93%) | Valeur (ex: 0.92) | Élevé | Modèle DL spécialisé pour données tabulaires, utilisant des mécanismes d'attention pour la sélection de caractéristiques et une certaine interprétabilité. |
| Autre Modèle DL 1 | DL | Valeur | Valeur | Variable | (À spécifier selon votre projet) |
Note : Les "Valeurs" dans le tableau sont des exemples et doivent être remplacées par vos résultats réels. Les métriques spécifiques (Exactitude, RMSE, F1-Score, MAE, etc.) dépendront de la nature de votre problème (classification ou régression).
Courbes d'Apprentissage (Learning Curves)
Pour les modèles impliquant un apprentissage itératif, notamment ceux basés sur le deep learning (Autoencodeur, MLP, TabNet, et leurs combinaisons), les courbes d'apprentissage sont indispensables. Elles tracent l'évolution d'une métrique de performance (par exemple, la perte ou l'exactitude) sur les ensembles d'entraînement et de validation en fonction des époques ou des itérations.
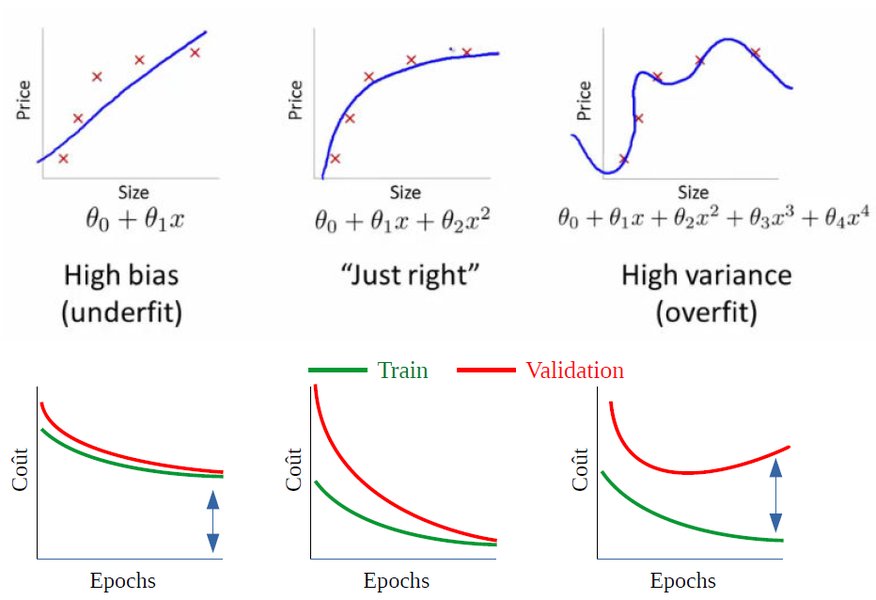
Exemple de courbes d'apprentissage illustrant les phénomènes de sur-apprentissage (overfitting) et de sous-apprentissage (underfitting).
L'analyse de ces courbes permet de :
- Détecter le sur-apprentissage (overfitting) : la performance sur l'ensemble d'entraînement continue de s'améliorer tandis que celle sur l'ensemble de validation stagne ou se dégrade.
- Identifier le sous-apprentissage (underfitting) : les performances sont faibles à la fois sur l'ensemble d'entraînement et de validation, suggérant un modèle trop simple ou un entraînement insuffisant.
- Évaluer la convergence du modèle et la pertinence des hyperparamètres (comme le nombre d'époques, le taux d'apprentissage).
Présentez et discutez les courbes pour vos principaux modèles, en soulignant les observations pertinentes pour chacun.
Matrices de Confusion (pour la Classification)
Si votre projet concerne une tâche de classification, les matrices de confusion sont un outil visuel puissant pour évaluer en détail la performance de vos classificateurs. Elles décomposent les prédictions correctes et incorrectes pour chaque classe.
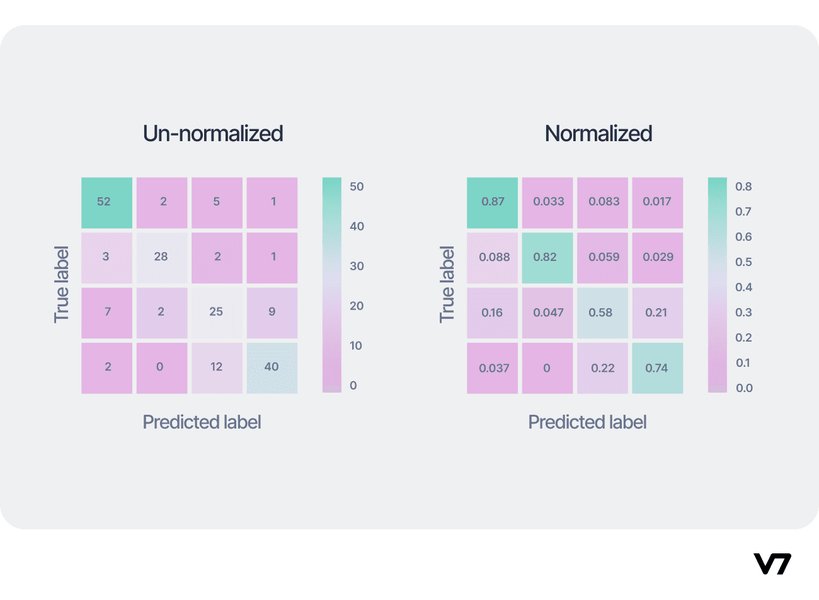
Structure typique d'une matrice de confusion, indiquant les Vrais Positifs (TP), Faux Positifs (FP), Vrais Négatifs (TN), et Faux Négatifs (FN).
Pour chaque modèle de classification pertinent (MLP seul, Random Forest + Autoencodeur, TabNet, etc.) :
- Présentez la matrice de confusion obtenue sur l'ensemble de test.
- Analysez les types d'erreurs : quelles classes sont fréquemment confondues ? Y a-t-il un déséquilibre dans la capacité du modèle à prédire certaines classes ?
- Comparez les matrices entre les modèles pour identifier des forces ou faiblesses spécifiques de chaque approche dans la distinction des classes.
4.2 Interprétation des Résultats
Après avoir présenté les performances brutes, cette sous-section se concentre sur leur signification, le choix du modèle final, et une discussion critique des limites.
Sélection et Justification du Meilleur Modèle
Sur la base des résultats quantitatifs (tableau comparatif, courbes, matrices) et d'autres considérations (complexité, temps d'inférence, interprétabilité), identifiez le modèle (ou les modèles) que vous considérez comme le(s) "meilleur(s)" pour votre problème.
Votre justification doit être détaillée et s'appuyer sur des preuves concrètes :
- Performance pure : Lequel a obtenu les meilleurs scores sur les métriques clés ?
- Robustesse et Généralisation : Comment se sont comportés les modèles face au sur-apprentissage ? Lequel semble le mieux généraliser aux données non vues ?
- Impact des combinaisons : Expliquez explicitement la valeur ajoutée (ou l'absence de valeur ajoutée) des combinaisons :
- Random Forest + Autoencodeur / MLP + Autoencodeur : L'extraction de caractéristiques par l'autoencodeur a-t-elle amélioré les performances du Random Forest ou du MLP par rapport à leurs versions "seules" ? Comment ? L'autoencodeur a-t-il réussi à capturer une représentation pertinente de l'information ? Le pipeline d'implémentation (entraînement de l'AE, puis utilisation de son encodeur pour transformer les données avant de les fournir au modèle suivant) doit être rappelé ici.
- TabNet : Comment ses performances se comparent-elles aux autres approches, en particulier sur des données tabulaires ? Son mécanisme d'attention a-t-il offert des avantages en termes de performance ou d'indices d'interprétabilité ?
- Adéquation au problème : Le modèle répond-il aux contraintes spécifiques de votre projet (par exemple, besoin d'interprétabilité, contraintes de temps de calcul) ?
Analyse Comparative des Architectures de Modèles
Le graphique radar ci-dessous offre une visualisation comparative de différents modèles utilisés dans votre projet, évalués selon plusieurs critères clés. Ces évaluations sont qualitatives et visent à illustrer les compromis typiques entre différentes architectures.
Comparaison radar des modèles selon divers critères de performance et de complexité.
Ce type de graphique aide à visualiser rapidement les forces et faiblesses relatives. Par exemple, un modèle comme TabNet pourrait exceller en 'Performance Globale' sur des données tabulaires et offrir une certaine 'Interprétabilité', tandis qu'un MLP simple pourrait être moins interprétable mais potentiellement plus rapide à entraîner que des architectures plus complexes. Les modèles hybrides comme 'Random Forest + AE' cherchent un équilibre, exploitant la réduction de dimension de l'AE et la capacité de classification du RF.
Limites et Biais Potentiels
Une analyse critique est essentielle. Aucun modèle n'est parfait. Discutez honnêtement :
- Limites des modèles : Manque d'interprétabilité (surtout pour les modèles DL "boîte noire"), sensibilité aux hyperparamètres, complexité de mise en œuvre.
- Limites liées aux données : Taille de l'ensemble de données, qualité des données, présence de biais (par exemple, déséquilibre des classes) et comment cela a pu affecter les performances. Certaines classes sont-elles systématiquement moins bien prédites ?
- Limites de l'implémentation : Contraintes de temps, ressources computationnelles, choix d'hyperparamètres qui pourraient ne pas être optimaux.
- Distinction ML vs DL : Soulignez les différences observées. Par exemple, les modèles DL ont-ils nécessité beaucoup plus de données ou de temps d'entraînement ? Leur complexité a-t-elle apporté un gain de performance justifiant le coût ? Les modèles ML traditionnels, même en combinaison, étaient-ils plus faciles à régler ou à interpréter ?
4.3 Visualisation des Prédictions
Cette section vise à donner une intuition plus concrète de la manière dont votre meilleur(s) modèle(s) effectue(nt) des prédictions, en comparant les sorties du modèle aux valeurs réelles.
Graphiques Comparant Valeurs Réelles et Prédites
Le type de graphique dépendra de la nature de votre tâche :
- Pour la régression :
- Un graphique de dispersion (scatter plot) avec les valeurs réelles sur l'axe X et les valeurs prédites sur l'axe Y. Idéalement, les points devraient s'aligner le long de la droite y=x.
- Un graphique des résidus (différence entre valeurs réelles et prédites) pour identifier d'éventuels patterns dans les erreurs.
- Pour la classification :
- Des graphiques à barres montrant la distribution des probabilités prédites pour des exemples spécifiques, comparées à la classe réelle.
- Si pertinent et que le nombre de classes est faible, une visualisation des frontières de décision (pour des problèmes à 2D/3D après réduction de dimension).
Accompagnez chaque graphique d'une explication claire de ce qu'il représente et des conclusions que l'on peut en tirer sur la qualité des prédictions du modèle.
Comprendre l'Implémentation et la Synergie des Modèles
Pour que le lecteur saisisse bien comment les modèles, notamment les combinaisons, ont été implémentés et pourquoi, il est utile de visualiser leur interconnexion. Le diagramme ci-dessous illustre les relations conceptuelles entre les différentes stratégies de modélisation que vous avez explorées.
Réduction de dimension
Apprentissage non supervisé"] id1.2["MLP (Multilayer Perceptron)"] id1.2.1["Apprentissage de relations
non-linéaires complexes
Modèle DL de base"] id2["Modèles Combinés (Hybrides)"] id2.1["Random Forest + Autoencodeur"] id2.1.1["Pipeline : AE pour features, RF pour classif./régression"] id2.1.2["Synergie : Représentations DL + robustesse ML"] id2.1.3["Implémentation :
1. Entraîner AE
2. Encoder les données
3. Entraîner RF sur données encodées"] id2.2["MLP + Autoencodeur"] id2.2.1["Pipeline : AE pour features, MLP final pour tâche"] id2.2.2["Potentiel d'amélioration via features pré-apprises"] id2.2.3["Implémentation : Similaire à RF+AE, mais avec MLP en aval"] id3["Modèles Deep Learning Avancés"] id3.1["TabNet"] id3.1.1["Spécialisé pour données tabulaires"] id3.1.2["Mécanisme d'attention séquentielle pour sélection de features"] id3.1.3["Interprétabilité locale grâce aux masques d'attention"] id3.2["Autres Modèles DL"] id3.2.1["(Ex: CNN pour images, RNN pour séquences,
selon la nature du projet)"]
Diagramme illustrant les relations et pipelines entre les différents modèles et approches combinées.
Ce diagramme aide à clarifier le rôle de chaque composant. Par exemple, dans une combinaison "MLP + Autoencodeur", l'autoencodeur agit comme un extracteur de caractéristiques sophistiqué, transformant les données brutes en une représentation plus compacte et potentiellement plus informative, sur laquelle le MLP peut ensuite opérer plus efficacement. Pour TabNet, son architecture intrinsèque avec des mécanismes d'attention le distingue des approches séquentielles de combinaison. Référez-vous à votre section "Méthodologie" pour les détails techniques de l'implémentation, mais rappelez ici la logique pour faciliter la compréhension des résultats.
Vidéo discutant des contextes où choisir des modèles de Machine Learning par rapport au Deep Learning, et vice-versa.
La vidéo ci-dessus offre une perspective complémentaire sur les critères de choix entre les approches de Machine Learning et de Deep Learning, ce qui est pertinent lors de l'interprétation de la performance relative des différents modèles que vous avez utilisés. Elle peut aider à comprendre pourquoi, dans certains contextes, un modèle DL plus complexe est justifié, tandis que dans d'autres, une approche ML, potentiellement combinée, peut être préférable.
Foire Aux Questions (FAQ)
Comment la combinaison de modèles (ex: Autoencodeur + Random Forest) améliore-t-elle typiquement les résultats ?
La combinaison de modèles, ou "ensembling" et "pipelining", peut améliorer les résultats de plusieurs manières :
- Extraction de Caractéristiques Améliorée : Un autoencodeur (DL) peut apprendre des représentations latentes (caractéristiques) complexes et pertinentes des données brutes. Ces caractéristiques, souvent plus informatives et de dimension réduite, peuvent ensuite être utilisées par un modèle ML plus traditionnel comme Random Forest, qui pourrait mieux performer sur ces caractéristiques transformées que sur les données originales.
- Réduction du Bruit : L'autoencodeur peut aider à débruiter les données ou à capturer l'essence de l'information, ce qui facilite la tâche du modèle en aval.
- Synergie des Forces : On combine la capacité d'apprentissage de représentations du Deep Learning avec la robustesse, l'interprétabilité (relative) ou l'efficacité sur des données structurées de certains modèles de Machine Learning.
Quelles sont les principales différences à considérer en présentant les performances de modèles ML vs DL ?
Lors de la présentation, considérez :
- Complexité vs. Performance : Les modèles DL sont souvent plus complexes et peuvent atteindre des performances supérieures, mais cela peut se faire au détriment de l'interprétabilité et avec des besoins en données et calcul plus importants.
- Interprétabilité : Les modèles ML (ex: arbres de décision, régression linéaire) sont généralement plus faciles à interpréter que les modèles DL (ex: réseaux de neurones profonds), bien que des techniques d'interprétabilité pour DL (comme SHAP, LIME, ou les mécanismes d'attention de TabNet) existent.
- Ingénierie des Caractéristiques : Les modèles DL peuvent apprendre automatiquement les caractéristiques pertinentes (apprentissage de représentation), tandis que les modèles ML traditionnels nécessitent souvent une ingénierie des caractéristiques plus manuelle (sauf si combinés avec des extracteurs comme les autoencodeurs).
- Courbes d'Apprentissage : Les modèles DL sont plus sujets au sur-apprentissage si les données sont limitées ou si l'architecture est trop complexe ; leurs courbes d'apprentissage nécessitent une attention particulière.
- Temps d'Entraînement : Les modèles DL tendent à avoir des temps d'entraînement plus longs.
Comment justifier l'utilisation de TabNet par rapport à d'autres approches ?
TabNet est spécifiquement conçu pour les données tabulaires, un domaine où les modèles basés sur les arbres (comme Random Forest ou XGBoost) sont souvent très performants. La justification de l'utilisation de TabNet peut reposer sur :
- Performance Compétitive : S'il surpasse ou égale les performances des modèles ML traditionnels sur votre jeu de données tabulaires.
- Apprentissage de Représentation : Comme d'autres modèles DL, il apprend des représentations des données, ce qui peut être bénéfique pour des relations complexes.
- Mécanisme d'Attention Séquentielle : TabNet utilise une forme d'attention pour sélectionner les caractéristiques les plus pertinentes à chaque étape de décision, ce qui peut améliorer la performance et offrir une forme d'interprétabilité locale (en visualisant quelles caractéristiques ont été importantes pour une prédiction donnée).
- Traitement de bout en bout : Moins besoin d'ingénierie de caractéristiques manuelle par rapport à certains pipelines ML.
Cependant, il faut aussi considérer sa complexité et son coût computationnel par rapport aux alternatives plus simples.
Lectures Recommandées
Pour approfondir votre compréhension des sujets abordés, voici quelques pistes de recherche :
- Comment interpréter en détail les courbes d'apprentissage pour diagnostiquer les problèmes de modèles de deep learning ?
- Quelles sont les techniques avancées de visualisation des prédictions pour les modèles de classification multi-classes ?
- Comment évaluer l'apport spécifique d'un autoencodeur dans un pipeline de modélisation hybride ?
- Quelles sont les meilleures pratiques pour comparer l'interprétabilité des modèles TabNet par rapport aux modèles Random Forest ?
Références

Last updated May 9, 2025