
Structurer vos Résultats et Discussions : Une Analyse Détaillée pour la Prédiction du MOS avec des Modèles Combinés
Un guide complet pour présenter vos découvertes en comparant Autoencodeurs, MLP, Random Forest, TabNet et leurs combinaisons dans la prédiction du Mean Opinion Score.
Faits Saillants Essentiels
- Clarté Méthodologique : Comprendre comment chaque modèle (Autoencodeur, MLP, Random Forest, TabNet) est implémenté individuellement et le rôle crucial des Autoencodeurs comme extracteurs de caractéristiques pour les modèles Random Forest et MLP.
- Évaluation Rigoureuse : Utiliser des métriques adaptées à la prédiction du MOS (typiquement une tâche de régression comme RMSE, MAE, R²) et visualiser les performances via des courbes d'apprentissage et des graphiques de prédictions réelles vs. prédites.
- Interprétation Nuancée : Justifier le choix du meilleur modèle en se basant sur les performances quantitatives, tout en reconnaissant les limites, les biais potentiels et la complexité inhérente aux combinaisons de modèles ML et DL.
La section "Résultats et Discussion" est pivotale dans tout rapport de projet, particulièrement lorsqu'il s'agit d'évaluer et de comparer des approches complexes de Machine Learning (ML) et de Deep Learning (DL) pour une tâche spécifique comme la prédiction du Mean Opinion Score (MOS). Le MOS étant une mesure subjective de la qualité perçue (par exemple, pour l'audio ou la vidéo), sa prédiction nécessite des modèles robustes et bien évalués. Ce guide vous aidera à structurer cette section de manière claire et pédagogique, en mettant l'accent sur l'implémentation, la combinaison et l'évaluation de modèles tels que les autoencodeurs (AE), les Perceptrons Multi-Couches (MLP), les Random Forests (RF), TabNet, ainsi que leurs hybridations.
Nous aborderons comment présenter les performances, interpréter les résultats et visualiser les prédictions, en s'assurant que le lecteur comprenne la logique derrière chaque étape, même sans une expertise approfondie en intelligence artificielle. Votre connaissance est à jour au vendredi 9 mai 2025.
Comprendre l'Approche : Implémentation et Combinaison des Modèles pour la Prédiction du MOS
Avant de plonger dans les résultats, il est crucial d'expliquer au lecteur la méthodologie employée pour chaque modèle et leurs combinaisons. Cela pose les bases pour une compréhension approfondie des performances observées.
Principes des Modèles Utilisés
Autoencodeurs (AE) : Extraction de Caractéristiques
Les autoencodeurs sont des réseaux de neurones utilisés principalement pour l'apprentissage non supervisé de représentations de données (encodages), souvent dans un but de réduction de dimensionnalité ou d'extraction de caractéristiques pertinentes. Dans votre projet de prédiction du MOS, un AE peut être entraîné à reconstruire les données d'entrée (par exemple, des caractéristiques extraites de signaux audio/vidéo). La partie "encodeur" de l'AE apprend à compresser les données en une représentation latente de plus faible dimension, qui capture l'essence des données. Cette représentation peut ensuite être utilisée comme entrée pour d'autres modèles superviseurs.
Perceptron Multi-Couches (MLP) : Apprentissage Supervisé Direct
Le MLP est un type de réseau de neurones artificiels à anticipation (feedforward) composé d'au moins trois couches de nœuds : une couche d'entrée, une ou plusieurs couches cachées et une couche de sortie. Chaque nœud, à l'exception des nœuds d'entrée, est un neurone avec une fonction d'activation non linéaire. Les MLP sont adaptés aux tâches de classification et de régression. Dans votre cas, un MLP seul peut être entraîné directement sur les caractéristiques d'entrée pour prédire la valeur du MOS.
Random Forest (RF) : Robustesse et Ensemblisme
Le Random Forest est un algorithme d'apprentissage supervisé basé sur l'apprentissage ensembliste. Il construit une multitude d'arbres de décision lors de l'entraînement et produit la classe qui est le mode des classes (classification) ou la prédiction moyenne (régression) des arbres individuels. Les RF sont réputés pour leur robustesse face au surapprentissage, surtout avec des données complexes, et leur capacité à gérer un grand nombre de caractéristiques.
TabNet : Deep Learning pour Données Tabulaires
TabNet est une architecture de Deep Learning spécifiquement conçue pour les données tabulaires. Elle utilise une forme d'attention séquentielle pour choisir quelles caractéristiques raisonner à chaque étape de décision, permettant une interprétabilité (en identifiant les caractéristiques importantes) et des performances souvent supérieures aux modèles traditionnels sur des ensembles de données tabulaires complexes. Pour la prédiction du MOS, si vos données d'entrée sont structurées sous forme de tableau, TabNet est un candidat pertinent.
Autres Modèles de Deep Learning
Cette catégorie peut inclure d'autres architectures DL pertinentes pour vos données, comme les réseaux de neurones convolutifs (CNN) si vous traitez des spectrogrammes audio ou des images, ou des réseaux de neurones récurrents (RNN) pour des données séquentielles.
Stratégies de Combinaison des Modèles
La combinaison de modèles vise à exploiter les forces de différentes approches.
Autoencodeur + Random Forest (AE+RF)
Dans cette approche hybride, l'autoencodeur est d'abord entraîné pour apprendre des représentations compactes et informatives des données d'entrée. Ces représentations latentes (la sortie de la couche d'encodage de l'AE) sont ensuite utilisées comme nouvelles caractéristiques d'entrée pour entraîner un modèle Random Forest. L'idée est que l'AE effectue une ingénierie des caractéristiques non linéaire et automatique, potentiellement améliorant la performance du RF.
Autoencodeur + MLP (AE+MLP)
Similaire à la combinaison AE+RF, l'AE est utilisé pour générer des caractéristiques latentes. Celles-ci alimentent ensuite un MLP pour la tâche de prédiction du MOS. Cette combinaison peut être vue comme une forme de "deep learning" où l'AE apprend la structure des données et le MLP se concentre sur la tâche de prédiction supervisée à partir de cette structure apprise.
Distinguer Machine Learning (ML) et Deep Learning (DL) dans le Projet
Il est utile de clarifier ces termes pour le lecteur :
- Machine Learning (ML) : Un domaine de l'IA qui permet aux systèmes d'apprendre à partir de données sans être explicitement programmés. Random Forest est un exemple de modèle ML.
- Deep Learning (DL) : Un sous-domaine du ML basé sur des réseaux de neurones artificiels avec de multiples couches (profondes). Les autoencodeurs, MLP et TabNet sont des exemples de modèles DL. Les combinaisons AE+MLP ou AE+RF peuvent être considérées comme des approches hybrides tirant parti des deux.
Expliquer cette distinction aide à contextualiser les choix de modèles et leurs performances comparatives.
Performances Détaillées des Modèles (Section 4.1 de votre rapport)
Cette section doit présenter de manière objective et quantitative les résultats de l'évaluation de chaque modèle et combinaison.
Tableau Comparatif Exhaustif des Performances
Un tableau récapitulatif est essentiel pour comparer directement les modèles. Il devrait inclure les métriques d'évaluation clés pour la prédiction du MOS. Puisque le MOS est une valeur continue, les métriques de régression sont généralement les plus appropriées :
- Erreur Quadratique Moyenne (RMSE) : Mesure la racine carrée de la moyenne des carrés des erreurs. Sensible aux grandes erreurs.
- Erreur Absolue Moyenne (MAE) : Mesure la moyenne des valeurs absolues des erreurs. Plus robuste aux outliers que le RMSE.
- Coefficient de Détermination (R²) : Indique la proportion de la variance de la variable dépendante qui est prévisible à partir des variables indépendantes. Une valeur proche de 1 indique un bon ajustement.
Voici un exemple de structure pour votre tableau comparatif :
| Modèle / Combinaison | Type (ML/DL/Hybride) | RMSE | MAE | R² | Temps d'Entraînement (Relatif) | Complexité (Relative) | Remarques |
|---|---|---|---|---|---|---|---|
| Autoencodeur seul (pour reconstruction) | DL (Non Supervisé) | N/A (pour prédiction MOS directe) | N/A | N/A | Moyen | Moyenne | Évalué sur l'erreur de reconstruction. |
| MLP seul | DL (Supervisé) | valeur | valeur | valeur | Moyen | Moyenne | |
| Random Forest + Autoencodeur | Hybride (DL+ML) | valeur | valeur | valeur | Élevé | Élevée | AE pour extraction de features. |
| MLP + Autoencodeur | Hybride (DL+DL) | valeur | valeur | valeur | Élevé | Élevée | AE pour extraction de features. |
| TabNet | DL (Supervisé) | valeur | valeur | valeur | Moyen à Élevé | Élevée | Spécifique aux données tabulaires. |
| Autres modèles DL | DL (Supervisé) | valeur | valeur | valeur | variable | variable |
Tableau 1 : Comparaison des performances des modèles pour la prédiction du MOS. (Remplacez "valeur" par vos résultats réels).
Analyse des Courbes d'Apprentissage (Learning Curves)
Les courbes d'apprentissage tracent la performance du modèle (par exemple, RMSE ou MAE pour la régression ; perte pour l'entraînement) sur les ensembles d'entraînement et de validation en fonction du nombre d'époques ou de la taille de l'ensemble d'entraînement. Elles sont cruciales pour diagnostiquer des problèmes comme :
- Surapprentissage (Overfitting) : Le modèle performe très bien sur les données d'entraînement mais mal sur les données de validation (écart important entre les deux courbes).
- Sous-apprentissage (Underfitting) : Le modèle performe mal sur les deux ensembles, indiquant qu'il n'a pas capturé la structure sous-jacente des données.
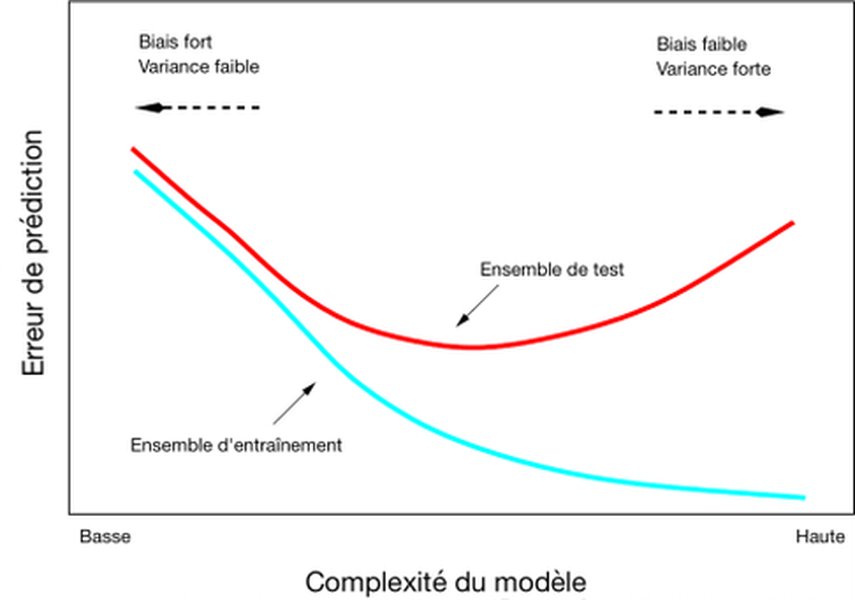
Illustration du concept de compromis biais-variance, souvent analysé à l'aide de courbes d'apprentissage. Des courbes d'apprentissage montrant l'erreur d'entraînement et de validation peuvent aider à identifier si un modèle souffre d'un biais élevé (sous-apprentissage) ou d'une variance élevée (surapprentissage).
Évaluation des Erreurs : Au-delà des Matrices de Confusion pour la Régression du MOS
Les matrices de confusion sont spécifiques aux tâches de classification. Si votre prédiction du MOS est formulée comme une tâche de régression (prédire une valeur continue), les matrices de confusion ne s'appliquent pas directement. Cependant, si vous avez discrétisé le MOS en classes (par exemple, "faible", "moyen", "élevé"), alors une matrice de confusion par modèle de classification serait pertinente. Elle visualiserait les prédictions correctes et incorrectes pour chaque classe de MOS.

Exemple d'une matrice de confusion pour un problème de classification binaire. Si le MOS est classifié, une telle matrice peut révéler quels types de scores sont bien prédits et où se situent les confusions.
Pour une tâche de régression du MOS, l'analyse des erreurs peut inclure :
- Histogrammes des résidus (erreurs de prédiction) : Pour visualiser la distribution des erreurs. Idéalement, les erreurs devraient être centrées autour de zéro et avoir une distribution normale.
- Graphiques des résidus vs. valeurs prédites : Pour identifier des motifs dans les erreurs (par exemple, si le modèle prédit systématiquement mieux pour certaines plages de valeurs MOS).
Cartographie des Modèles et de Leurs Interactions
Pour offrir une vue d'ensemble des différentes approches testées et de leurs interrelations, un diagramme mental peut être très utile. Il peut illustrer comment les modèles de base (AE, MLP, RF, TabNet) sont utilisés seuls ou combinés, et leur place dans le spectre du Machine Learning et du Deep Learning pour la prédiction du MOS.
Apprentissage de représentation"] id1_2["MLP seul"] id1_2_1["Rôle: Prédiction directe du MOS"] id1_3["Random Forest (RF) seul"] id1_3_1["Rôle: Prédiction directe du MOS (si appliqué sans AE)"] id1_4["TabNet"] id1_4_1["Rôle: Prédiction directe du MOS (DL pour tabulaire)"] id1_5["Autres Modèles DL"] id2["Modèles Combinés (Hybrides)"] id2_1["AE + Random Forest"] id2_1_1["AE: Extraction de features latentes"] id2_1_2["RF: Prédiction du MOS sur features latentes"] id2_2["AE + MLP"] id2_2_1["AE: Extraction de features latentes"] id2_2_2["MLP: Prédiction du MOS sur features latentes"] id3["Types d'Approches"] id3_1["Machine Learning (ML)"] id3_1_1["Ex: Random Forest"] id3_2["Deep Learning (DL)"] id3_2_1["Ex: Autoencodeur, MLP, TabNet"] id4["Évaluation des Performances"] id4_1["Métriques de Régression"] id4_1_1["RMSE, MAE, R²"] id4_2["Visualisations"] id4_2_1["Courbes d'apprentissage"] id4_2_2["Réel vs. Prédit"] id4_2_3["Analyse des résidus"] id4_3["Métriques de Classification (si applicable)"] id4_3_1["Accuracy, Précision, Rappel, F1-Score"] id4_3_2["Matrice de confusion"]
Diagramme mental illustrant l'organisation des modèles, leurs combinaisons, et les aspects d'évaluation pour le projet de prédiction du MOS.
Interprétation Approfondie des Résultats (Section 4.2 de votre rapport)
Cette sous-section est dédiée à l'analyse critique des performances quantitatives présentées précédemment.
Sélection du Modèle Optimal et Justifications Détaillées
Sur la base des métriques du tableau comparatif et de l'analyse des courbes d'apprentissage, identifiez le(s) modèle(s) ayant obtenu les meilleures performances globales pour la prédiction du MOS. La justification doit être claire et s'appuyer sur les données :
- Référez-vous aux métriques clés (par exemple, le plus bas RMSE/MAE, le plus haut R²).
- Discutez de la stabilité du modèle (observée via les courbes d'apprentissage).
- Expliquez pourquoi ce modèle ou cette combinaison est le plus adapté. Par exemple, si "MLP + Autoencodeur" est le meilleur, discutez de comment la représentation apprise par l'AE a pu améliorer la capacité prédictive du MLP par rapport à un MLP seul.
- Considérez d'autres facteurs comme la complexité du modèle, le temps d'inférence (si pertinent pour une application en temps réel), et l'interprétabilité. Par exemple, TabNet offre une certaine interprétabilité en identifiant les features importantes.
Identification des Limites et Biais Potentiels
Une analyse honnête des limites de votre approche et des biais potentiels est essentielle :
- Limites des données : Taille de l'ensemble de données, qualité, représentativité. Le MOS étant subjectif, les données d'étiquetage peuvent contenir du bruit ou des incohérences.
- Limites des modèles :
- Complexité : Les modèles DL profonds peuvent nécessiter beaucoup de données et de temps d'entraînement.
- Surapprentissage : Même avec des techniques de régularisation, le risque existe.
- Interprétabilité : Les "boîtes noires" comme certains réseaux de neurones profonds peuvent être difficiles à interpréter, bien que des modèles comme TabNet ou des techniques comme SHAP/LIME puissent aider.
- Biais algorithmiques : Les modèles peuvent hériter ou amplifier des biais présents dans les données.
- Biais potentiels dans l'évaluation : Choix des métriques, division des données (entraînement/validation/test).
Comparaison Multidimensionnelle des Modèles Clés
Un diagramme radar peut offrir une comparaison visuelle synthétique de plusieurs modèles sur différents critères d'évaluation. Cela permet de voir rapidement les forces et faiblesses relatives de chaque approche.
Diagramme radar comparant différents modèles (MLP seul, RF+AE, TabNet) sur plusieurs critères qualitatifs et quantitatifs (valeurs illustratives, à remplacer par vos évaluations). Notez que 'Inversé' signifie qu'une valeur plus élevée sur l'axe est meilleure (par exemple, un temps d'entraînement plus court est meilleur, donc on inverse l'échelle ou on utilise 1/temps).
Ce type de graphique aide à équilibrer les différentes facettes de la performance d'un modèle au-delà d'une simple métrique unique. Par exemple, un modèle peut avoir une excellente précision mais un temps d'entraînement prohibitif ou une faible interprétabilité.
Visualisation Clairvoyante des Prédictions du MOS (Section 4.3 de votre rapport)
La visualisation des prédictions aide à comprendre qualitativement la performance des modèles.
Confrontation des Valeurs Réelles et Prédites
Pour une tâche de régression comme la prédiction du MOS, un graphique de dispersion (scatter plot) comparant les valeurs réelles du MOS (axe X) aux valeurs prédites par le modèle (axe Y) est très informatif.
- Idéalement, les points devraient s'aligner le long de la diagonale (y=x), indiquant une prédiction parfaite.
- La dispersion des points autour de cette ligne donne une idée de l'ampleur des erreurs.
- Vous pouvez superposer les prédictions de plusieurs modèles sur le même graphique (en utilisant des couleurs différentes) pour une comparaison directe.
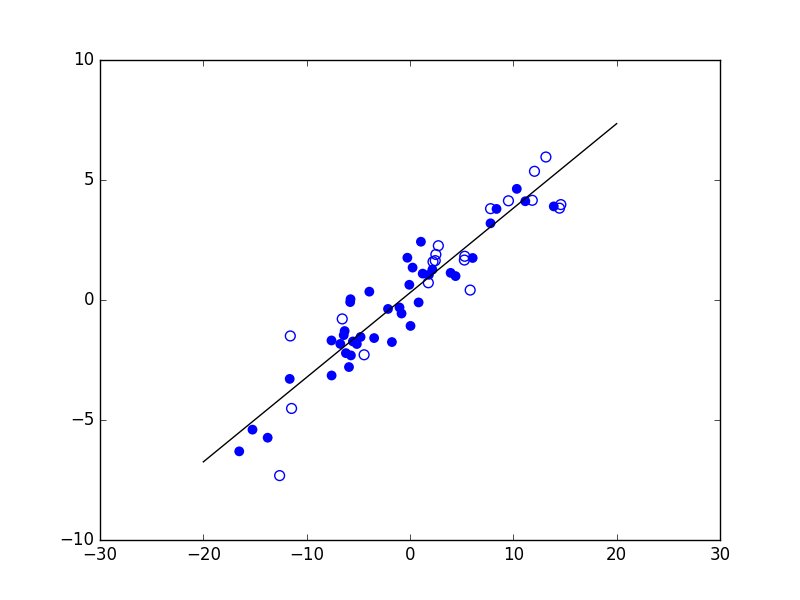
Exemple de graphique de dispersion montrant les valeurs prédites en fonction des valeurs réelles pour une tâche de régression. La ligne pointillée représente une prédiction parfaite (y=x).
Analyse Qualitative des Erreurs de Prédiction
Au-delà des graphiques globaux, présenter des exemples concrets de prédictions peut être très éclairant :
- Montrez des cas où les modèles ont bien prédit le MOS, et des cas où ils se sont trompés significativement.
- Analysez le contexte de ces erreurs : Sont-elles liées à des types spécifiques de données d'entrée ? Certains modèles commettent-ils des types d'erreurs différents ?
- Si vous utilisez des autoencodeurs pour l'extraction de caractéristiques, il peut être pertinent (bien que plus avancé) de visualiser l'espace latent (par exemple, avec t-SNE ou UMAP) pour voir comment les différentes instances de données sont regroupées. Cela peut parfois aider à comprendre pourquoi certains échantillons sont difficiles à prédire.
Éclairage sur les Concepts : IA, ML, et DL
Pour les lecteurs qui ne sont pas familiers avec les distinctions entre Intelligence Artificielle (IA), Machine Learning (ML), et Deep Learning (DL), une brève vidéo explicative peut grandement faciliter la compréhension du contexte de votre projet.
Cette vidéo (en anglais) offre une introduction claire aux concepts d'IA, ML, et DL, et à leurs relations, ce qui peut aider à situer les techniques que vous avez employées dans votre projet de prédiction du MOS.
Comprendre que le ML est un moyen d'atteindre l'IA et que le DL est une technique spécifique de ML utilisant des réseaux de neurones profonds permet de mieux apprécier la sophistication des modèles comme les autoencodeurs, MLP, et TabNet, ainsi que l'intérêt de les combiner avec des approches ML plus classiques comme Random Forest.
Questions Fréquemment Posées (FAQ)
Pourquoi combiner un autoencodeur avec Random Forest ou MLP ?
La combinaison d'un autoencodeur (AE) avec des modèles comme Random Forest (RF) ou MLP vise à exploiter les forces des deux. L'AE, en tant que modèle d'apprentissage non supervisé, est excellent pour apprendre des représentations compressées et significatives des données (features latentes), potentiellement en débruitant et en capturant des structures complexes. Ces features latentes, souvent de dimension réduite, peuvent ensuite être utilisées comme entrées pour un modèle supervisé comme RF ou MLP. Cela peut améliorer la performance du modèle superviseur en lui fournissant des entrées plus informatives et moins bruitées, et peut également réduire le risque de surapprentissage si la dimensionnalité est bien gérée.
Quelle est la différence principale entre les approches ML et DL pour la prédiction du MOS ?
Les modèles de Machine Learning (ML) traditionnels (comme Random Forest) nécessitent souvent une étape d'ingénierie des caractéristiques (feature engineering) manuelle ou semi-automatique pour bien performer. Les modèles de Deep Learning (DL) (comme les MLP profonds, les autoencodeurs, TabNet) ont la capacité d'apprendre automatiquement les caractéristiques pertinentes directement à partir des données brutes ou quasi-brutes, grâce à leurs multiples couches de traitement. Pour la prédiction du MOS, cela signifie que les modèles DL pourraient découvrir des patterns complexes que les approches ML traditionnelles, avec une ingénierie des caractéristiques limitée, pourraient manquer. Cependant, les modèles DL requièrent généralement plus de données et de puissance de calcul, et peuvent être plus difficiles à interpréter.
Comment choisir la métrique la plus appropriée pour évaluer la prédiction du MOS ?
Le choix de la métrique dépend de la nature exacte de la tâche de prédiction du MOS et des propriétés souhaitées de l'évaluation. Si le MOS est une valeur continue (régression) :
- RMSE (Root Mean Squared Error) : Pénalise fortement les grosses erreurs. Utile si les grandes déviations sont particulièrement indésirables.
- MAE (Mean Absolute Error) : Donne une idée de l'erreur moyenne sans surpondérer les outliers. Plus interprétable en termes d'erreur moyenne.
- R² (Coefficient de Détermination) : Indique quelle part de la variance du MOS est expliquée par le modèle. Utile pour comprendre la force de la relation.
TabNet est-il toujours meilleur que les modèles ML traditionnels pour les données tabulaires ?
TabNet est une architecture de Deep Learning prometteuse pour les données tabulaires, et il a montré des performances compétitives, voire supérieures, à des modèles ML traditionnels comme les Gradient Boosting Machines (XGBoost, LightGBM) ou Random Forest sur certains benchmarks. Ses avantages incluent l'apprentissage de bout en bout et une certaine interprétabilité grâce à ses masques d'attention. Cependant, il n'est pas garanti qu'il soit toujours meilleur. Sa performance dépend de la nature spécifique des données, de la taille de l'ensemble de données, du réglage des hyperparamètres, et des ressources de calcul disponibles. Les modèles ML traditionnels sont souvent plus rapides à entraîner et plus simples à mettre en œuvre, et peuvent être très performants, surtout sur des ensembles de données de petite à moyenne taille ou lorsque l'ingénierie des caractéristiques est bien faite.
Pistes de Recherche Recommandées
Pour approfondir votre compréhension et explorer davantage le domaine, voici quelques requêtes de recherche suggérées :
- Comment optimiser les hyperparamètres pour les modèles combinés autoencodeur-MLP dans le contexte de la prédiction du MOS ?
- Quelles sont les techniques d'interprétabilité spécifiques aux modèles TabNet et comment peuvent-elles être appliquées à l'évaluation de la qualité perçue ?
- Quel est l'impact de la qualité et de la quantité des données d'entrée sur la performance des prédicteurs de MOS basés sur le deep learning ?
- Comment les approches d'apprentissage par transfert peuvent-elles être utilisées pour améliorer la prédiction du MOS, en particulier avec des ensembles de données limités ?
Références

Last updated May 9, 2025