
Implementación Práctica: Análisis Envolvente de Datos (DEA) con Python y Gurobi
Una guía completa para evaluar la eficiencia de unidades de decisión con optimización matemática
Aspectos Destacados
- DEA es una técnica no paramétrica que permite evaluar la eficiencia relativa de unidades de decisión (DMUs) usando múltiples entradas y salidas.
- Gurobi proporciona un potente solucionador para implementar modelos DEA con alta eficiencia computacional para problemas complejos.
- Los modelos CCR y BCC permiten analizar eficiencias bajo diferentes supuestos de retorno a escala (constantes o variables).
¿Qué es DEA y por qué utilizarlo?
El Análisis Envolvente de Datos (DEA) es una metodología de programación lineal diseñada para medir la eficiencia relativa de unidades homogéneas conocidas como Unidades de Toma de Decisiones (DMUs). Esta técnica destaca por su capacidad para manejar múltiples entradas y salidas sin necesidad de especificar relaciones funcionales explícitas entre ellas.
A diferencia de los métodos paramétricos, DEA construye una frontera de eficiencia a partir de las DMUs más productivas, y evalúa la distancia de cada unidad a esta frontera. Las principales ventajas de DEA incluyen:
- No requiere especificar una forma funcional para la relación entre entradas y salidas
- Puede manejar múltiples entradas y salidas con diferentes unidades de medida
- Identifica las mejores prácticas y ofrece referencias específicas para las DMUs ineficientes
- Proporciona información sobre cómo mejorar la eficiencia (reduciendo entradas o aumentando salidas)
Modelos de DEA: CCR vs BCC
Existen dos modelos principales de DEA que difieren en sus supuestos sobre los rendimientos a escala:
Modelo CCR (Charnes-Cooper-Rhodes)
Este modelo asume rendimientos constantes a escala (CRS), lo que significa que un cambio en las entradas resulta en un cambio proporcional en las salidas, independientemente del tamaño de la DMU. Es apropiado cuando todas las DMUs operan en una escala óptima.
Modelo BCC (Banker-Charnes-Cooper)
El modelo BCC permite rendimientos variables a escala (VRS), reconociendo que la eficiencia de producción puede variar según el tamaño operativo de la DMU. Este modelo es más flexible y generalmente más realista en aplicaciones prácticas.
| Característica | Modelo CCR | Modelo BCC |
|---|---|---|
| Rendimientos a escala | Constantes | Variables |
| Restricción de convexidad | No incluida | Incluida (∑λ = 1) |
| Eficiencia técnica | Global | Local (pura) |
| Interpretación | Eficiencia técnica global | Eficiencia técnica pura |
| Uso recomendado | DMUs de tamaño similar | DMUs de diferentes tamaños |
Implementación de DEA con Python y Gurobi
Instalación y configuración
Antes de comenzar, debemos instalar Gurobi y configurar el entorno de Python:
# Instalación de Gurobi con pip
pip install gurobipy

# También se necesitan numpy y pandas para manejo de datos
pip install numpy pandas
Una vez instaladas las bibliotecas necesarias, podemos proceder con la implementación del modelo DEA.
Ejemplo de DEA Orientado a Entradas (Modelo CCR)
A continuación se presenta un ejemplo completo de un modelo DEA orientado a entradas con rendimientos constantes a escala (CCR):
import numpy as np
import pandas as pd
from gurobipy import Model, GRB, quicksum

# Datos de ejemplo: 5 DMUs con 2 entradas y 2 salidas
dmu_names = ['DMU1', 'DMU2', 'DMU3', 'DMU4', 'DMU5']
inputs = np.array([
    [5, 13],  # DMU1
    [16, 12], # DMU2
    [16, 26], # DMU3
    [17, 15], # DMU4
    [18, 14]  # DMU5
])
outputs = np.array([
    [12, 16], # DMU1
    [14, 21], # DMU2
    [16, 25], # DMU3
    [23, 12], # DMU4
    [28, 15]  # DMU5
])

# Número de DMUs, entradas y salidas
n_dmus = inputs.shape[0]
n_inputs = inputs.shape[1]
n_outputs = outputs.shape[1]

# Función para resolver el modelo DEA para una DMU específica
def solve_dea_ccr(dmu_index):
    # Crear el modelo
    model = Model("DEA_CCR")

    # Desactivar los mensajes de Gurobi
    model.setParam('OutputFlag', 0)

    # Variables de decisión
    theta = model.addVar(vtype=GRB.CONTINUOUS, name="theta")
    lambdas = model.addVars(n_dmus, lb=0, vtype=GRB.CONTINUOUS, name="lambda")

    # Función objetivo: minimizar theta (maximizar eficiencia)
    model.setObjective(theta, GRB.MINIMIZE)

    # Restricciones para las entradas
    for i in range(n_inputs):
        model.addConstr(
            quicksum(lambdas[j] * inputs[j][i] for j in range(n_dmus)) <= theta * inputs[dmu_index][i],
            name=f"input_constraint_{i}"
        )

    # Restricciones para las salidas
    for i in range(n_outputs):
        model.addConstr(
            quicksum(lambdas[j] * outputs[j][i] for j in range(n_dmus)) >= outputs[dmu_index][i],
            name=f"output_constraint_{i}"
        )

    # Optimizar el modelo
    model.optimize()

    # Verificar si se encontró una solución óptima
    if model.status == GRB.OPTIMAL:
        # Recoger los valores de las variables lambda
        lambda_values = [lambdas[j].X for j in range(n_dmus)]

        # Calcular las holguras (slacks)
        input_slacks = []
        for i in range(n_inputs):
            slack = theta.X * inputs[dmu_index][i] - sum(lambdas[j].X * inputs[j][i] for j in range(n_dmus))
            input_slacks.append(slack)

        output_slacks = []
        for i in range(n_outputs):
            slack = sum(lambdas[j].X * outputs[j][i] for j in range(n_dmus)) - outputs[dmu_index][i]
            output_slacks.append(slack)

        return {
            'efficiency': theta.X,
            'lambda_values': lambda_values,
            'input_slacks': input_slacks,
            'output_slacks': output_slacks,
            'reference_set': [dmu_names[j] for j in range(n_dmus) if lambdas[j].X > 1e-6]
        }
    else:
        return None

# Calcular la eficiencia para todas las DMUs
results = {}
for i in range(n_dmus):
    results[dmu_names[i]] = solve_dea_ccr(i)

# Mostrar resultados en un DataFrame
efficiency_df = pd.DataFrame({
    'DMU': dmu_names,
    'Eficiencia': [results[dmu]['efficiency'] for dmu in dmu_names],
    'Conjunto de referencia': [', '.join(results[dmu]['reference_set']) if results[dmu]['reference_set'] else 'Eficiente' for dmu in dmu_names]
})

print(efficiency_df)
Ejemplo de DEA Orientado a Entradas (Modelo BCC)
Para implementar el modelo BCC (rendimientos variables a escala), solo necesitamos agregar una restricción de convexidad al modelo anterior:
def solve_dea_bcc(dmu_index):
    # Crear el modelo
    model = Model("DEA_BCC")

    # Desactivar los mensajes de Gurobi
    model.setParam('OutputFlag', 0)

    # Variables de decisión
    theta = model.addVar(vtype=GRB.CONTINUOUS, name="theta")
    lambdas = model.addVars(n_dmus, lb=0, vtype=GRB.CONTINUOUS, name="lambda")

    # Función objetivo: minimizar theta
    model.setObjective(theta, GRB.MINIMIZE)

    # Restricciones para las entradas
    for i in range(n_inputs):
        model.addConstr(
            quicksum(lambdas[j] * inputs[j][i] for j in range(n_dmus)) <= theta * inputs[dmu_index][i],
            name=f"input_constraint_{i}"
        )

    # Restricciones para las salidas
    for i in range(n_outputs):
        model.addConstr(
            quicksum(lambdas[j] * outputs[j][i] for j in range(n_dmus)) >= outputs[dmu_index][i],
            name=f"output_constraint_{i}"
        )

    # Restricción de convexidad (esta es la diferencia clave con el modelo CCR)
    model.addConstr(quicksum(lambdas[j] for j in range(n_dmus)) == 1, name="convexity")

    # Optimizar el modelo
    model.optimize()

    # Verificar si se encontró una solución óptima
    if model.status == GRB.OPTIMAL:
        # Recoger los valores de las variables lambda
        lambda_values = [lambdas[j].X for j in range(n_dmus)]

        # Calcular las holguras (slacks)
        input_slacks = []
        for i in range(n_inputs):
            slack = theta.X * inputs[dmu_index][i] - sum(lambdas[j].X * inputs[j][i] for j in range(n_dmus))
            input_slacks.append(slack)

        output_slacks = []
        for i in range(n_outputs):
            slack = sum(lambdas[j].X * outputs[j][i] for j in range(n_dmus)) - outputs[dmu_index][i]
            output_slacks.append(slack)

        return {
            'efficiency': theta.X,
            'lambda_values': lambda_values,
            'input_slacks': input_slacks,
            'output_slacks': output_slacks,
            'reference_set': [dmu_names[j] for j in range(n_dmus) if lambdas[j].X > 1e-6]
        }
    else:
        return None
Análisis de Resultados de DEA
Una vez completado el análisis DEA, es importante interpretar correctamente los resultados:
- Puntuación de eficiencia (θ): Un valor de 1.0 indica que la DMU es eficiente, mientras que valores menores indican ineficiencia. Cuanto menor sea el valor, mayor será la ineficiencia.
- Conjunto de referencia: DMUs eficientes que sirven como benchmarks para las DMUs ineficientes.
- Valores lambda (λ): Indican la importancia relativa de cada DMU de referencia en la evaluación de una DMU ineficiente.
- Holguras: Indican mejoras adicionales necesarias en entradas o salidas específicas, incluso después de la mejora proporcional indicada por θ.
Comparación de Características de los Modelos DEA
El gráfico de radar anterior compara las principales características de los diferentes modelos de DEA. Como se puede observar, el modelo CCR destaca en facilidad de implementación e interpretabilidad, mientras que el modelo BCC ofrece mayor flexibilidad y capacidad de discriminación entre DMUs.
Conceptos Fundamentales de DEA
El siguiente mapa mental ilustra los conceptos clave del Análisis Envolvente de Datos y su implementación con Gurobi:
Implementación práctica: Tutorial en video
El siguiente video proporciona una explicación detallada sobre cómo implementar modelos de Data Envelopment Analysis (DEA). Este recurso es especialmente útil para entender los conceptos fundamentales y visualizar cómo se aplican en la práctica.
Este video cubre la implementación de DEA utilizando software especializado, lo que puede complementar tu implementación con Gurobi en Python. La comprensión de los conceptos visuales presentados en el video te ayudará a verificar que tu implementación en Gurobi esté funcionando correctamente.
Ejemplos de Visualización de Resultados DEA
La visualización de los resultados es un aspecto crucial del análisis DEA. A continuación, se muestra un ejemplo de cómo podrías visualizar los resultados de tu análisis:
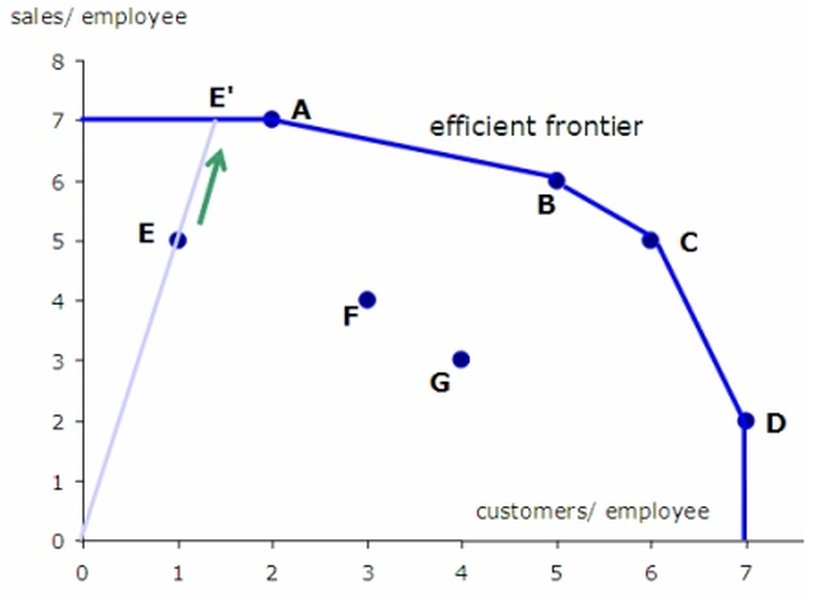
La imagen muestra una representación gráfica de la frontera de eficiencia en un análisis DEA. Las DMUs situadas en la frontera (línea curva) son consideradas eficientes, mientras que las DMUs que se encuentran por debajo de la frontera son ineficientes. La distancia a la frontera representa el grado de ineficiencia.
Preguntas Frecuentes sobre DEA y Gurobi
Referencias
- Data Envelopment Analysis implementation in Python Gurobi - Stack Overflow
- Efficiency Analysis - Gurobi Optimization
- PO-LAB/Productivity-and-Efficiency-Analysis - GitHub
- Data envelopment analysis | DEA - YouTube
- Data Envelopment Analysis - Example with one output and two inputs - YouTube
- Data Envelopment Analysis - Example with multiple inputs and outputs - YouTube
- Data Envelopment Analysis DEA part I - YouTube
Recomendados
Last updated April 9, 2025