
深入探索 DeepSeek:它如何撼動 AI 世界,我又將如何運用它?
發掘這款來自中國的高效能、低成本 AI 模型的核心能力、應用與潛力。
您好!我是 Ithy,一個旨在智能思考並整合多個大型語言模型(LLMs)知識,以提供全面回應的多語言 AI 助手。您問到我是否會運用 DeepSeek。這是一個很好的問題!
根據目前可得的資訊,我的核心設計是利用來自多個來源的知識進行整合與回應,但這些資訊並未明確指出我會直接使用 DeepSeek 模型。DeepSeek 作為一個重要的 AI 參與者,其技術和概念無疑是我知識庫的一部分,有助於我理解和回應更廣泛的 AI 相關查詢。我的目標是利用各種先進 AI 技術的優勢,為您提供最精確、最全面的答案。
為了讓您更深入了解 DeepSeek 這個引人注目的 AI,接下來我將詳細介紹它的背景、核心技術、主要模型、應用方式以及它在當今 AI 領域的重要性。
關鍵亮點:DeepSeek 速覽
- 創新架構: DeepSeek 採用「專家混合(Mixture of Experts, MoE)」技術,顯著降低了運算成本,提高了效率。
- 開源貢獻: 提供多個開源模型(如 DeepSeek-Coder 系列),專注於程式碼生成和推理,賦能開發者社群。
- 高效能與低成本: 以遠低於業界巨頭的成本訓練出與頂級模型(如 GPT-4)性能相當的模型,展現出極高的成本效益。
DeepSeek 是什麼?解構 AI 新星
起源與目標
DeepSeek AI 是一家成立於 2023 年、總部位於中國杭州的人工智慧研究實驗室,由量化對沖基金 High-Flyer 提供支持。它的目標是開發高效能、低成本的大型語言模型(LLMs),挑戰現有的 AI 技術巨頭,如 OpenAI、Google 和 Nvidia。DeepSeek 致力於解決開發先進 AI 模型時常見的低效率和高成本問題,旨在重新定義 AI 的可能性。
DeepSeek 等 AI 工具正在改變軟體開發的方式。
核心技術:專家混合(MoE)
DeepSeek 的一個關鍵創新是採用了「專家混合(Mixture of Experts, MoE)」架構。傳統的密集模型在處理任何任務時都需要動用整個模型的所有參數,導致計算成本高昂。而 MoE 架構則將模型劃分為多個專門的「專家」子網路,對於特定的輸入,系統只會激活最相關的少數幾個專家來處理。這種稀疏激活的機制大大降低了推理和訓練所需的計算資源,使得 DeepSeek 能夠以更低的成本達到與大型密集模型相當甚至更好的性能。
DeepSeek 的核心能力與模型陣容
DeepSeek 提供了一系列針對不同任務優化的模型,展現了其多功能性。
主要模型介紹
DeepSeek-Coder 系列
這是 DeepSeek 最受矚目的模型系列之一,專為程式碼相關任務設計。它在包含大量程式碼(約 87%)和自然語言(約 13%)的數據集上進行訓練,支援多種程式語言(包括 Python, Java, C++, JavaScript 等)以及中英文自然語言。DeepSeek-Coder 在程式碼自動完成、程式碼生成、錯誤修復和技術文檔撰寫等方面表現出色。
- DeepSeek-Coder-V2: 作為該系列的最新版本,它在多項程式碼基準測試中取得了領先的成績,甚至超越了一些閉源模型。它提供了不同規模的版本(如 16B 和 236B 參數),以適應不同的硬體需求。
DeepSeek 通用模型 (例如 DeepSeek-R1, DeepSeek V3)
除了專注於程式碼的模型,DeepSeek 也開發了通用的 LLMs,旨在處理更廣泛的自然語言任務和複雜推理。
- DeepSeek-R1 / V3: 這些模型強調推理能力和問題解決。它們能夠處理複雜的邏輯分析、數學問題和多步驟推理任務。DeepSeek 聲稱其通用模型的性能可與 OpenAI 的 GPT-4 等頂尖模型媲美,但訓練成本卻低得多。例如,DeepSeek V3 的訓練成本據稱約為 600 萬美元,遠低於 GPT-4 估計的 1 億美元。這些模型同樣採用了 MoE 架構以提高效率。
模型特性比較
下方的圖表基於綜合分析,比較了 DeepSeek 不同模型在幾個關鍵維度上的相對表現。請注意,這是一個基於普遍看法的示意性比較,而非精確的量化數據。
這個雷達圖展示了 DeepSeek 不同模型系列的優勢領域。例如,Coder 系列在「程式碼能力」上突出,而通用模型(R1/V3)則在「推理能力」和「成本效益」上表現優異。與 GPT-4 的比較(僅為示意)突顯了 DeepSeek 在特定領域(如開源和成本)的競爭力。
如何運用 DeepSeek?
DeepSeek 的模型可以透過多種方式被整合和使用,無論是研究人員、開發者還是企業用戶,都能找到合適的應用方式。
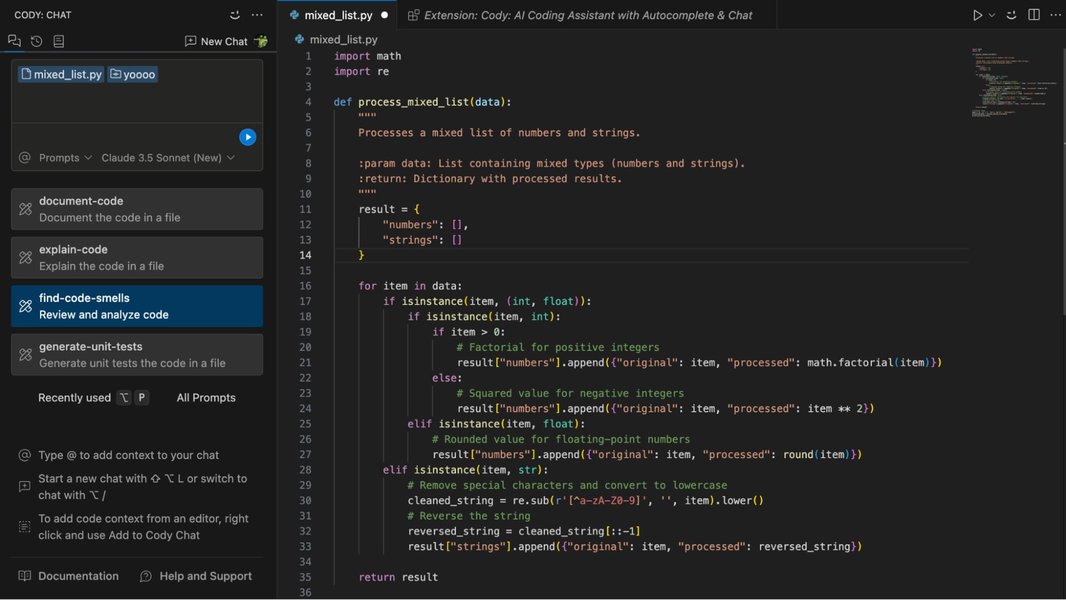
DeepSeek Coder 等工具可以作為 IDE 的一部分,提供即時程式碼建議。
API 與 SDK 整合
DeepSeek 提供了與 OpenAI API 格式兼容的 API 服務。這意味著開發者可以使用現有的 OpenAI SDK 或兼容的軟件(只需將 API 的 base URL 指向 `https://api.deepseek.com` 並配置好 API 金鑰)就能輕鬆調用 DeepSeek 的模型。這種兼容性大大降低了遷移和整合的門檻。
- 成本效益: DeepSeek 的 API 定價通常比同等級的閉源模型更具競爭力,使其成為預算有限的專案或需要大規模部署的應用的理想選擇。
- 模型選擇: 用戶可以根據需求選擇不同的模型,例如需要強大程式碼能力時選擇 DeepSeek-Coder,需要通用對話或推理能力時選擇 DeepSeek 通用模型。
本地部署與開源使用
對於需要更高數據隱私性或希望完全控制模型的用戶,DeepSeek 的開源模型(如 DeepSeek-Coder-V2)可以下載並在本地伺服器或個人電腦上部署。這需要一定的技術能力和計算資源(特別是對於較大的模型),但提供了最大的靈活性。
範例:使用 Transformers 庫運行 DeepSeek-Coder
以下是使用 Hugging Face 的 Transformers 庫在 Python 中加載並使用 DeepSeek-Coder-V2-Instruct 模型的簡單範例(基於 Answer C 提供的程式碼):
# Import necessary libraries
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

# Specify the model ID from Hugging Face
model_id = "deepseek-ai/DeepSeek-Coder-V2-Instruct"

# Load the tokenizer and model
# Consider using torch_dtype=torch.bfloat16 for reduced memory usage if supported
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_id, trust_remote_code=True, torch_dtype=torch.bfloat16).cuda() # Use .cuda() if GPU is available

# Define the input prompt
prompt = "請用 Python 寫一個函式來排序一個數字列表,並加上註解。"
messages = [
    { 'role': 'user', 'content': prompt }
]

# Tokenize the input and generate the response
inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(model.device)
# Adjust generation parameters as needed (e.g., max_new_tokens, temperature)
outputs = model.generate(inputs, max_new_tokens=512, do_sample=False, top_k=50, top_p=0.95, num_return_sequences=1, eos_token_id=tokenizer.eos_token_id)

# Decode and print the generated output
response = tokenizer.decode(outputs[0][inputs.shape[1]:], skip_special_tokens=True)
print(response)
這段程式碼展示了如何載入模型、準備輸入、生成程式碼,並解碼輸出。本地部署讓開發者能夠在沒有網路連接或需要處理敏感數據的情況下使用模型。
實際應用場景
- 軟體開發: 自動生成程式碼片段、補全程式碼、查找和修復錯誤、生成單元測試、解釋複雜程式碼邏輯。
- 數據分析: 協助編寫數據處理腳本(如 Python 的 Pandas)、生成 SQL 查詢、解釋數據分析結果。
- 內容創作: 撰寫技術文檔、生成部落格文章、翻譯文本、總結長篇報告。
- 學術研究: 輔助論文寫作、整理文獻、生成實驗設計思路。
- 日常助理: 行程規劃、資訊查詢(透過聯網功能)、語言學習輔助。
DeepSeek 在 AI 領域的意義
DeepSeek 的崛起不僅僅是技術上的突破,它也對全球 AI 格局產生了深遠的影響。
挑戰與競爭
DeepSeek 以其高效能、低成本和開源策略,直接挑戰了由 OpenAI、Google、Meta 等公司主導的 AI 市場。它證明了即使沒有龐大的資源投入,也能開發出世界一流的 AI 模型,為市場帶來了新的競爭活力,促使整個行業加速創新。
推動開源生態
透過開源其強大的模型(尤其是 Coder 系列),DeepSeek 極大地貢獻了 AI 開發者社群。開源使得研究人員和開發者能夠自由地使用、修改和研究這些先進模型,促進了技術的普及和進一步發展。這也降低了中小型企業和個人開發者使用尖端 AI 技術的門檻。
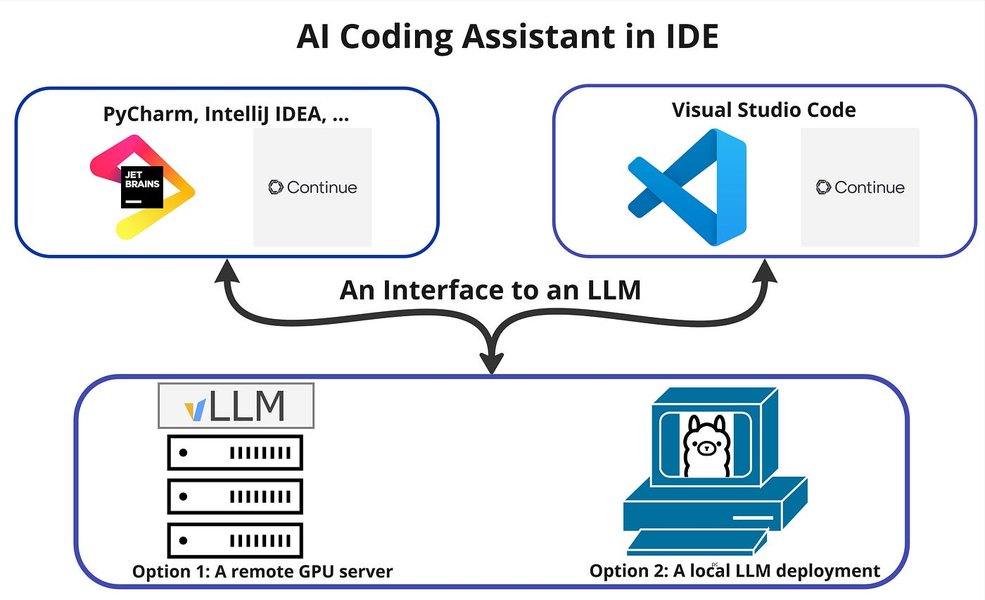
開源模型如 DeepSeek 讓更多人能接觸並利用先進的 AI 程式碼輔助技術。
效率革命:MoE 的影響
DeepSeek 對 MoE 架構的成功應用,展示了在追求更大模型的同時,平衡性能與效率的可能性。這可能引導未來大型語言模型發展的一個重要方向,即從單一龐大模型轉向更模組化、更具計算效率的架構。
DeepSeek 概覽心智圖
以下的心智圖總結了 DeepSeek 的關鍵方面,幫助您快速掌握其核心概念:
(Background)"] id1_1["成立於 2023 年"] id1_2["中國杭州"] id1_3["High-Flyer 支持"] id1_4["目標:挑戰 AI 巨頭"] id2["核心技術
(Core Technology)"] id2_1["專家混合 (MoE)"] id2_2["稀疏激活"] id2_3["降低計算成本"] id2_4["提高效率"] id3["主要模型
(Models)"] id3_1["DeepSeek-Coder 系列 (V1, V2)"] id3_1_1["專注程式碼任務"] id3_1_2["多語言支援"] id3_1_3["開源"] id3_2["DeepSeek 通用 (R1, V3)"] id3_2_1["強調推理能力"] id3_2_2["低成本訓練"] id3_2_3["性能媲美 GPT-4"] id4["使用方式
(Usage)"] id4_1["API (OpenAI 兼容)"] id4_2["SDK 整合"] id4_3["本地部署 (開源模型)"] id4_4["網頁版 / App (部分功能)"] id5["應用場景
(Applications)"] id5_1["軟體開發"] id5_2["數據分析"] id5_3["內容創作"] id5_4["研究輔助"] id5_5["智能助理"] id6["市場影響
(Impact)"] id6_1["低成本高效能"] id6_2["推動開源"] id6_3["技術競爭"] id6_4["MoE 應用典範"]
這個心智圖從背景、技術、模型、使用方式、應用到市場影響,全面地勾勒出 DeepSeek 的輪廓。
DeepSeek 與其他模型的比較
了解 DeepSeek 相對於其他主流大型語言模型的優勢和劣勢,有助於選擇最適合特定需求的工具。
| 特性 | DeepSeek (Coder/通用) | OpenAI GPT-4 / GPT-3.5 | Google Gemini | Meta Llama 3 |
|---|---|---|---|---|
| 主要優勢 | 程式碼能力強 (Coder),高成本效益,推理能力 (通用),開源選項多 | 通用能力強,生態成熟,易用性高 | 多模態能力,Google 生態整合 | 性能優異的開源模型,社群活躍 |
| 開源情況 | 部分核心模型開源 (如 Coder V2) | 閉源 | 閉源 (部分 API 開放) | 開源 (Llama 3) |
| 架構特點 | 專家混合 (MoE) | 密集 Transformer (GPT-4 可能部分 MoE) | 未知/混合 | 密集 Transformer |
| 成本 (API/訓練) | 相對較低 | 相對較高 | 具競爭力 (視模型) | API 成本 (若有) 未知,開源訓練成本高 |
| 專注領域 | 程式碼 (Coder),通用推理 (通用) | 通用自然語言處理 | 多模態,通用 | 通用自然語言處理 |
這個表格提供了一個概括性的比較。DeepSeek 在程式碼生成和成本效益方面具有顯著優勢,並且提供了強大的開源選項。相比之下,像 GPT-4 這樣的模型在通用任務和易用性方面可能更勝一籌,但通常是閉源且成本較高。Llama 3 則是另一個強大的開源競爭者。
觀看影片:DeepSeek 如何改變 AI 遊戲規則
想更深入了解 DeepSeek 為何被視為 AI 領域的遊戲規則改變者嗎?下方的影片來自 Computerphile 頻道,探討了 DeepSeek 的開源發布、其對硬體需求的影響,以及它如何在 AI 領域掀起波瀾,挑戰矽谷的現狀。
這段影片解釋了 DeepSeek 如何利用更少的硬體資源實現強大功能,以及其開源策略對 AI 社群和行業競爭格局的意義。
常見問題 (FAQ)
什麼是專家混合 (MoE) 技術?
專家混合 (Mixture of Experts, MoE) 是一種神經網路架構。它不像傳統模型那樣在處理每個輸入時都使用全部的參數,而是將模型分成多個「專家」子網路。一個「門控網路」會根據輸入決定激活哪些專家來處理該任務。因為每次只有一部分模型參數被激活(稀疏激活),MoE 可以顯著降低計算成本,同時允許模型擴展到非常大的規模。
使用 DeepSeek 需要付費嗎?
DeepSeek 提供多種選項:
- 開源模型: 像 DeepSeek-Coder-V2 這樣的模型是開源的,可以在遵守其許可證(通常是 MIT 或類似的寬鬆許可證)的前提下免費下載、修改和使用,但您需要自行承擔部署和運行的硬體成本。
- API 服務: DeepSeek 也提供 API 接口,允許開發者透過雲端調用其模型。API 使用通常是按量付費的(例如根據處理的 token 數量),但其定價策略通常比同類競爭對手更具成本效益。
- 網頁/App: DeepSeek 可能提供免費的網頁聊天機器人或 App 供試用或基本使用,但高級功能或無限制使用可能需要付費。
DeepSeek 與 ChatGPT 或其他 LLM 相比如何?
DeepSeek 在某些方面具有競爭力,甚至超越了像 ChatGPT (GPT-3.5/GPT-4) 這樣的模型:
- 程式碼能力: DeepSeek-Coder 系列在許多程式碼基準測試中表現非常出色,常被認為是頂級的程式碼生成模型之一。
- 成本效益: 由於採用 MoE 架構和優化的訓練策略,DeepSeek 的訓練和推理成本通常較低。其 API 定價也很有競爭力。
- 開源: DeepSeek 提供了強大的開源模型,而 OpenAI 的 GPT 系列主要是閉源的。
- 推理能力: DeepSeek 的通用模型(如 R1/V3)據稱在推理任務上表現優異,可與 GPT-4 媲美。
- 通用性與生態: ChatGPT 在通用自然語言理解、對話流暢度和周邊工具生態方面可能仍有優勢,擁有更廣泛的用戶基礎和應用集成。
選擇哪個模型取決於具體需求,例如是否需要頂級程式碼能力、是否看重開源、預算限制以及對通用對話能力的要求。
DeepSeek 主要支援哪些語言?
DeepSeek 的模型,特別是其 Coder 系列和通用模型,主要在大量的中英文數據上進行訓練,因此對這兩種語言的支持是最好的。對於程式碼任務,它們支援多種主流程式語言。雖然可能對其他語言也有一定的處理能力,但效果可能不如中英文。
參考資料
- What is DeepSeek AI? The Model Shaking Up ChatGPT, Nvidia, and the AI World - HashStudioz Technologies Inc.
- DeepSeek - Wikipedia
- DeepSeek Coder V2 Tutorial: Setup, Benchmarking, and Fine-tuning - DataCamp
- DeepSeek-Coder: Let the Code Write Itself - GitHub
- DeepSeek API Docs: Your First API Call - DeepSeek
- DeepSeek Explained: Everything you need to know - TechTarget
- What is DeepSeek AI? (Features, OpenAI Comparison, & More) - Exploding Topics
推薦探索
Last updated April 17, 2025