
Оптимальные Аппаратные Решения для Локального Запуска LLM в 2025 году
Глубокий анализ аппаратных платформ и инструментов для эффективной работы с большими языковыми моделями на вашем устройстве
Ключевые Аспекты Локального Запуска LLM
- Расширение Доступности ИИ: Развитие аппаратных решений и программных инструментов делает локальный запуск больших языковых моделей (LLM) все более доступным для широкого круга пользователей, от энтузиастов до профессионалов.
- Приватность и Эффективность: Локальный запуск LLM обеспечивает беспрецедентный уровень конфиденциальности данных, снижает задержки и позволяет работать офлайн, что является значительным преимуществом перед облачными решениями.
- Инновации в Железе и ПО: В 2025 году наблюдается значительный прогресс в специализированных ИИ-чипах, таких как NVIDIA Grace Blackwell Superchip (используемый в Project DIGITS), а также в оптимизированных программных платформах, вроде Ollama и LM Studio, упрощающих развертывание LLM.
Стремительное развитие больших языковых моделей (LLM) открывает новые горизонты для их локального применения, предоставляя пользователям контроль над данными, снижение задержек и возможность работы в автономном режиме. В 2025 году мы видим появление всё более мощных и компактных аппаратных решений, а также усовершенствованных программных инструментов, которые делают локальный запуск LLM не только возможным, но и весьма эффективным.
Преимущества Локального Запуска LLM
Локальное развертывание LLM предлагает ряд существенных преимуществ по сравнению с облачными сервисами, такими как ChatGPT или Microsoft Copilot. Эти преимущества становятся всё более значимыми по мере того, как LLM становятся более мощными и требовательными к ресурсам:
- Конфиденциальность Данных: Ваши данные остаются на вашем устройстве, что исключает риски утечек или несанкционированного доступа со стороны третьих сторон. Это критически важно для чувствительной информации и корпоративных приложений.
- Отсутствие Затрат на Использование: После покупки оборудования и загрузки модели, использование LLM становится бесплатным, в отличие от платных облачных API.
- Низкая Задержка и Офлайн-Режим: LLM работает непосредственно на вашем оборудовании, обеспечивая мгновенные ответы без зависимости от интернет-соединения. Это особенно полезно в условиях ограниченного доступа к сети или для задач, требующих высокой скорости обработки.
- Полный Контроль и Настройка: Пользователи имеют возможность тонко настраивать модели, экспериментировать с различными параметрами и интегрировать LLM в собственные приложения без ограничений, накладываемых облачными провайдерами.
- Отсутствие Привязки к Поставщику: Вы не зависите от политик, цен или доступности конкретного облачного сервиса.
Несмотря на то, что требования к оборудованию могут быть высокими, современные оптимизированные LLM позволяют запускать их даже на ноутбуках с 16 ГБ оперативной памяти. Развитие технологий делает локальные ИИ-решения доступными для каждого, кто хочет использовать мощь ИИ без зависимости от облачных сервисов.
Специализированные Аппаратные Решения для LLM
NVIDIA Project DIGITS: Персональный ИИ-Суперкомпьютер
Одним из самых значимых анонсов в области локального ИИ в 2025 году стал NVIDIA Project DIGITS, теперь официально известный как NVIDIA DGX Spark. Это компактное устройство, размером примерно с Mac Mini, позиционируется как персональный ИИ-суперкомпьютер.
Представляем NVIDIA Project DIGITS: персональный ИИ-суперкомпьютер Grace Blackwell AI.
NVIDIA Project DIGITS, или DGX Spark, является прорывным решением, которое призвано демократизировать доступ к высокопроизводительным ИИ-вычислениям. Его основная идея заключается в предоставлении разработчикам, исследователям и студентам возможности прототипировать, донастраивать и запускать большие ИИ-модели прямо на своем рабочем столе. Это устройство, оснащенное инновационным чипом NVIDIA GB10 Grace Blackwell Superchip, способно обрабатывать модели с до 200 миллиардов параметров (или до 400 миллиардов при использовании двух устройств, объединенных в сеть через NVIDIA ConnectX). GB10 Superchip обеспечивает производительность в 1 петафлоп (PFLOPS) в формате FP4, что является внушительной мощностью для персонального устройства.
Project DIGITS поставляется с 128 ГБ унифицированной памяти LPDDR5X и до 4 ТБ NVMe SSD-накопителя, что критически важно для работы с большими объемами данных и быстрой инференции LLM. Устройство работает под управлением Linux-подобной операционной системы Nvidia DGX OS и поставляется с предустановленным комплексным программным стеком Nvidia AI Enterprise, включая все необходимые инструменты и фреймворки для разработки ИИ. Целевая аудитория Project DIGITS — это в первую очередь разработчики и исследователи ИИ, которым требуется мощное, но доступное локальное решение для полного жизненного цикла моделей генеративного ИИ, от инференции до тонкой настройки и разработки агентов. Начальная цена в $3000 делает его относительно доступным по сравнению с традиционными серверными решениями, способными предоставить аналогичную мощность.
Решения от AMD: Проект Gaia и Ryzen AI
AMD также активно участвует в развитии локального ИИ, представляя свой проект Gaia – платформу с открытым исходным кодом для запуска локальных LLM на любой машине с Windows. Gaia не только позволяет запускать различные модели LLM, но и "векторизует внешний контент" (например, с GitHub, YouTube, текстовые файлы), сохраняя его в локальном векторном индексе. Это улучшает запросы пользователей до обработки LLM, повышая точность и релевантность ответов.
AMD Gaia – новейшее приложение от AMD для запуска локальных LLM на любом ПК.
Особое внимание уделяется оптимизации производительности для машин, оснащенных процессорами Ryzen AI. Линейка процессоров AMD Ryzen AI 300, выпуск которой запланирован на июль 2025 года, будет включать специализированные NPU (нейронные процессорные блоки) для ускорения ИИ-операций. Это делает AMD серьёзным игроком на рынке локальных LLM, предлагая конкурентоспособные решения как для центральных, так и для графических процессоров.
Прочие Аппаратные Опции
Для локального запуска LLM помимо специализированных устройств, таких как Project DIGITS, подойдут и другие аппаратные конфигурации. Ключевым фактором является наличие достаточного объема видеопамяти (VRAM), так как для быстрой работы LLM это критически важно. Чем больше VRAM, тем больше и сложнее модель можно запустить.
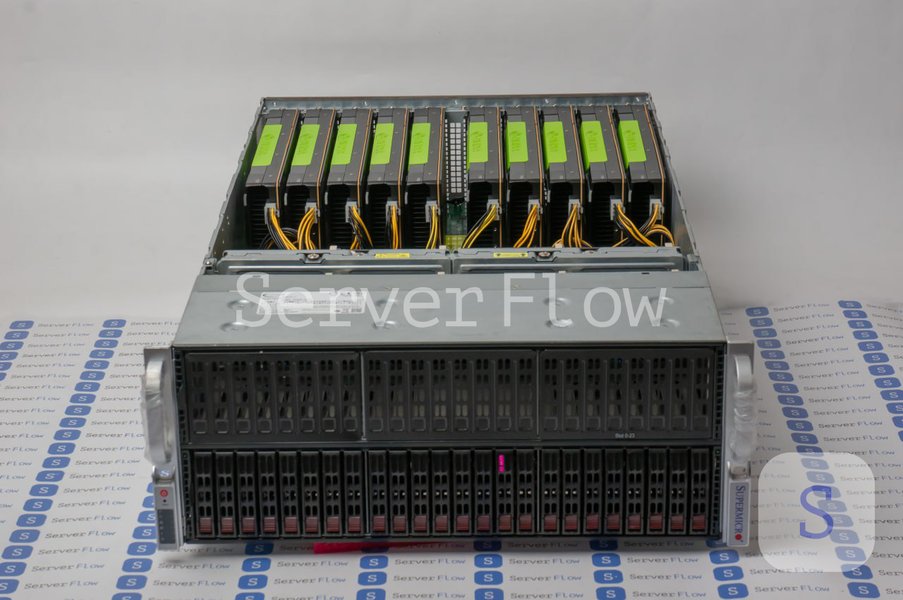
Пример сервера, оптимизированного для рабочих нагрузок искусственного интеллекта.
- Высокопроизводительные Видеокарты (GPU):
- NVIDIA: Карты серий RTX (например, 3080, 5090) с большим объемом VRAM являются одним из наиболее популярных выборов. NVIDIA Tesla V100 (16 ГБ) также упоминаются как подходящие для серверных конфигураций. Важно отметить, что NVIDIA TensorRT для RTX через Windows ML ускоряет ИИ в приложениях.
- AMD: С улучшенной поддержкой ROCm на Linux, AMD GPU становятся всё более привлекательной альтернативой.
- Mac Mini: Для пользователей Apple, Mac Mini с чипами Apple Silicon, которые имеют объединенную память, могут эффективно запускать небольшие LLM.
- Серверные Решения: Для более крупных моделей или для развертывания в корпоративной среде, могут потребоваться серверы с несколькими GPU, мощными CPU (например, Intel Xeon Gold 5118) и большим объемом оперативной памяти (256 ГБ DDR4).
- Компактные ИИ-серверы: Появляются компактные серверы, такие как Beelink AI Mini с AMD Ryzen AI Max+, которые предлагают баланс производительности и форм-фактора.
Программное Обеспечение и Фреймворки
Для эффективного использования аппаратных решений необходимы подходящие программные инструменты. В 2025 году существуют несколько ключевых фреймворков и приложений, упрощающих локальный запуск LLM:
- Ollama: Легковесная система для локального запуска LLM, поддерживающая различные модели и API. Она легко устанавливается на Mac, Linux и Windows и позволяет использовать модели, такие как Llama-3 8B, через чат-интерфейсы (например, PrivateGPT) или для обработки документов. Ollama также предоставляет удобный API для программного взаимодействия с моделями.
- LM Studio: Десктопное приложение с графическим интерфейсом, которое позволяет загружать и запускать LLM (например, Llama 3.2) в несколько кликов. Поддерживает Mac, Windows и Linux, используя llama.cpp.
- llama.cpp: Проект, написанный на C++, который позволяет запускать LLM, VLM (Vision-Language Models), MMLM (Multi-Modal Language Models) на CUDA, AMD, NPU, Metal. Он лежит в основе многих популярных реализаций, включая Ollama и LM Studio.
- MLC: Фреймворк для развертывания LLM на WebGPU, предлагающий одну из самых быстрых реализаций LLM на этой технологии.
- MLX: Еще один фреймворк, ориентированный на оптимизированные вычисления.
- LocalAI: Проект, позволяющий запускать языковые модели в локальном окружении с минимальной настройкой, сохраняя контроль над данными.
Анализ Производительности и Оптимизации
Производительность локальных LLM зависит от многих факторов, включая размер модели, объем VRAM, скорость памяти, пропускную способность шины и оптимизацию программного обеспечения. Важно понимать, что для достижения оптимальной производительности зачастую требуется баланс между этими параметрами.
Влияние VRAM
Объем VRAM является критически важным показателем для скорости работы LLM. Если модель не помещается полностью в VRAM, она начинает использовать системную RAM или даже медленный диск, что приводит к значительному замедлению инференции.
Методы Оптимизации
- Квантование: Снижение точности вычислений (например, с FP16 до FP4 или FP8) позволяет уменьшить объем памяти, необходимый для модели, и ускорить ее работу.
- DeepSpeed: Технология от Microsoft, которая может увеличить производительность в 3-4 раза.
- Low VRAM режим: Некоторые инструменты предлагают специальные режимы для систем с ограниченным объемом VRAM.
- Новые Архитектуры: Разработки, такие как MiniMax-01 с архитектурой Lightning Attention, NVIDIA Star-Attention (ускорение работы с длинным контекстом в 11 раз) и Microsoft YOCO (You Only Cache Once), направлены на повышение эффективности и снижение требований к памяти.
Для домашнего использования на средних компьютерах пользователи могут запускать нейросети размером до 15 миллиардов параметров, но более крупные модели требуют более мощного оборудования.
Сравнение LLM-решений для локального запуска
Эта таблица суммирует ключевые аспекты аппаратных и программных решений для локального запуска LLM, помогая выбрать оптимальную конфигурацию.
| Категория | Характеристика | Решения / Технологии | Преимущества | Недостатки / Ограничения |
|---|---|---|---|---|
| Специализированные Устройства | Компактные, "все-в-одном" ИИ-суперкомпьютеры | NVIDIA Project DIGITS (DGX Spark) | Высокая производительность (1 PFLOPS FP4), 128ГБ унифицированной памяти, предустановленный ИИ-стек, простота использования. | Высокая начальная стоимость ($3000+), узкая специализация (не для игр), пока ограниченная доступность. |
| GPU для ПК/Рабочих Станций | NVIDIA Consumer/Workstation GPUs | RTX 3080, RTX 5090, Tesla V100 (для серверов) | Широкая доступность, большая VRAM (критично для LLM), мощная экосистема CUDA, TensorRT. | Высокие требования к энергопотреблению и охлаждению, стоимость топовых карт. |
| AMD Consumer/Workstation GPUs | Совместимые с ROCm | Открытая экосистема ROCm (на Linux), конкурентоспособная производительность, проект Gaia для Windows. | Менее развитая экосистема на Windows по сравнению с CUDA. | |
| CPU/APU с AI-ускорением | Процессоры со встроенными NPU | AMD Ryzen AI, Intel Core Ultra (Lunar Lake) | Энергоэффективность, возможность запуска небольших моделей без дискретной GPU, интеграция в ноутбуки. | Ограниченная производительность для больших LLM, не заменяет мощные GPU. |
| Mac Silicon | Чипы Apple с объединенной памятью | Mac Mini, MacBook Pro (M-серии) | Высокая энергоэффективность, унифицированная память, оптимально для небольших и средних LLM. | Ограниченный объем памяти по сравнению с дискретными GPU, закрытая экосистема. |
| Программные Фреймворки | Инструменты для развертывания и управления LLM | Ollama, LM Studio, llama.cpp, MLC, LocalAI | Упрощение установки и запуска моделей, поддержка различных ОС, API для интеграции, графический интерфейс. | Требуют базовых знаний для настройки, производительность зависит от аппаратного обеспечения. |
Прогнозы и Тенденции на 2025 год
2025 год обещает стать ключевым для локального ИИ. Мы ожидаем дальнейшего роста специализированных ИИ, которые будут заточены под решение конкретных задач в медицине, финансах, производстве и образовании. Доступность инструментов разработки будет расти, что позволит большему числу компаний и специалистов создавать собственные решения без глубоких знаний программирования.
Сравнительный анализ аппаратных платформ для локального запуска LLM.
Радар-график выше визуализирует относительную производительность и характеристики различных аппаратных решений для локального запуска LLM. Каждая ось представляет собой важный параметр, а удаленность точки от центра указывает на более высокую оценку по этому параметру. Например, NVIDIA RTX 4090 демонстрирует максимальные показатели по производительности и объему VRAM, что делает её идеальным выбором для самых требовательных LLM. В то же время, Mac Mini на чипах M-серии выделяется высокой энергоэффективностью и простотой использования. NVIDIA Project DIGITS (DGX Spark) занимает промежуточное положение, предлагая сбалансированное решение для ИИ-разработки.
Часто Задаваемые Вопросы (FAQ)
Какие основные преимущества локального запуска LLM?
Что такое NVIDIA Project DIGITS и для кого он предназначен?
Какие минимальные требования к оборудованию для запуска LLM?
Какие программные инструменты помогут запустить LLM локально?
Заключение
2025 год знаменует собой переход к более доступному и мощному локальному ИИ. Появление специализированных аппаратных решений, таких как NVIDIA Project DIGITS, и дальнейшее развитие потребительских GPU от NVIDIA и AMD, наряду с оптимизированными программными фреймворками, такими как Ollama и LM Studio, делают локальный запуск LLM реалистичным и выгодным вариантом для широкого круга пользователей. Эти тенденции способствуют децентрализации ИИ-вычислений, повышая конфиденциальность, снижая затраты и предоставляя пользователям беспрецедентный контроль над их ИИ-моделями.
Рекомендуемые Запросы для Дальнейшего Исследования
- Какие лучшие открытые LLM для локального запуска в 2025 году?
- Сравнение Ollama и LM Studio для локального запуска LLM.
- Как объем VRAM влияет на производительность LLM?
- Будущее ИИ-чипов и NPU для персональных компьютеров.