
Разблокируйте Потенциал Кодирования: Лучшие LLM для Вашей RTX 3090
Оптимальный выбор моделей для быстрой и качественной генерации кода на локальном оборудовании.
Ключевые Выводы для Вашей Конфигурации
- RTX 3090 с 24 ГБ VRAM является отличным выбором для локального запуска LLM, позволяя размещать в памяти GPU модели до 30-32 миллиардов параметров при эффективном квантовании.
- Квантование моделей (например, Q4_K_M, Q5_K_M) критически важно для максимального использования VRAM, увеличения скорости инференса и обработки больших контекстов (до 8K-16K токенов).
- Для задач кодирования наиболее рекомендованы специализированные модели, такие как DeepSeek R1, Code Llama, и адаптированные версии Llama 3 и Qwen 2.5, которые обеспечивают высокую скорость и качество генерируемого кода.
Ваша конфигурация, состоящая из видеокарты NVIDIA GeForce RTX 3090 (24 ГБ VRAM), процессора AMD Ryzen 3500X и 16 ГБ оперативной памяти, является весьма мощной для запуска локальных больших языковых моделей (LLM), особенно с акцентом на задачи кодирования. Видеокарта RTX 3090, благодаря своим 24 ГБ VRAM, считается одним из лучших вариантов на вторичном рынке по соотношению цена/производительность для локального инференса LLM. Она позволяет загружать в память GPU достаточно сложные модели, минимизируя зависимость от системной памяти. Хотя ваш процессор Ryzen 3500X и 16 ГБ оперативной памяти являются достаточными для базового запуска, оптимизация моделей под использование GPU и выбор правильных версий помогут достичь максимальной производительности, скорости и качества кода, а также поддерживать максимально возможную длину контекста.
Оценка Вашего Оборудования для Локальных LLM
Прежде чем углубляться в конкретные модели, давайте разберем, как каждый компонент вашей системы влияет на запуск LLM, особенно в LM Studio.
NVIDIA RTX 3090 (24 ГБ VRAM): Король Локального Инференса
RTX 3090 — это выдающийся графический процессор для запуска LLM. Его 24 ГБ GDDR6X VRAM позволяют полностью размещать квантованные модели в диапазоне 30-32 миллиардов параметров. Это означает, что модель будет работать преимущественно на GPU, что значительно увеличивает скорость инференса и снижает задержки. Для достижения максимальной производительности иногда рекомендуется использовать интегрированный графический процессор (если доступен) для вывода изображения или работать в безголовом режиме, чтобы высвободить всю VRAM RTX 3090 для вычислений.
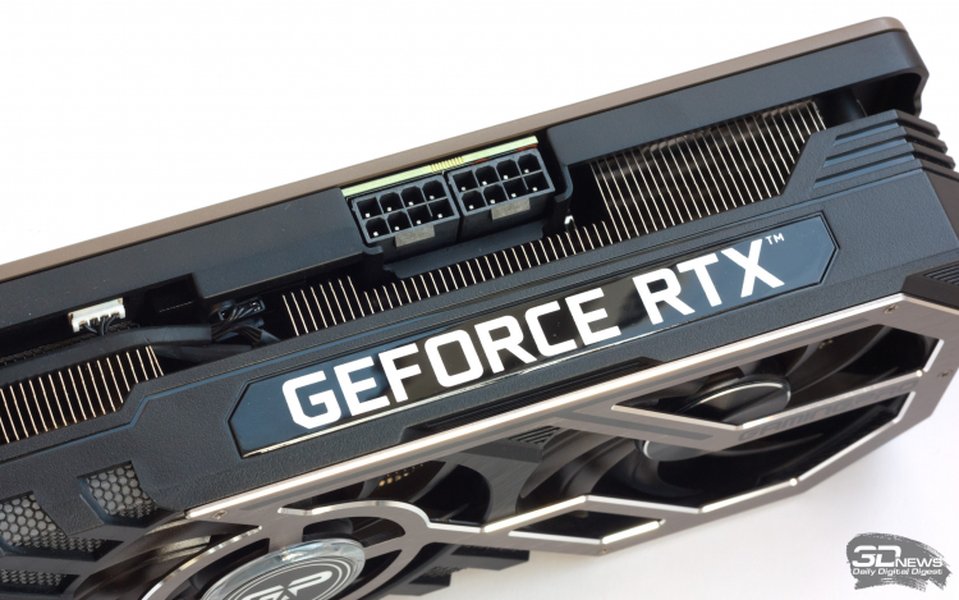
Видеокарта NVIDIA GeForce RTX 3090, мощное решение для локального инференса LLM.
AMD Ryzen 3500X и 16 ГБ Оперативной Памяти: Управление Ресурсами
Ваш процессор Ryzen 3500X с 6 ядрами способен справляться с задачами инференса, но для очень больших моделей, которые не полностью помещаются в VRAM и требуют офлоадинга в системную память (хотя с 24 ГБ VRAM это будет редко), более производительный CPU мог бы быть полезен. 16 ГБ оперативной памяти достаточно для базового запуска, но для моделей с очень большим контекстом (более 8-16 тысяч токенов) или при запуске нескольких приложений одновременно, это может стать узким местом. Квантование моделей помогает значительно снизить требования к системной RAM.
Оптимальные LLM для Кодирования на Вашей Системе
Для вашей конфигурации и предпочтений (максимальное количество токенов, быстрая работа, высокое качество кода), я рекомендую следующие модели LLM, ориентированные на кодирование:
1. DeepSeek R1 (7B или 8B версии)
DeepSeek R1 является одним из лучших выборов для задач кодирования. Эта модель специально обучена на огромных объемах кода, что обеспечивает высокое качество генерации, отладки и логического рассуждения. На RTX 3090 вы можете запускать её в квантованных версиях (например, Q4_K_M), что позволит работать с контекстом до 8-16 тысяч токенов. В LM Studio скорость инференса для 8B версии при квантовании ожидается в районе 10-15 токенов в секунду (t/s).
2. Llama 3 (7B, 13B или квантованные 70B версии)
Llama 3 от Meta — это мощная и универсальная модель. Версии с 7B и 13B параметрами отлично работают на RTX 3090 при 4-8-битном квантовании. Некоторые пользователи успешно запускают даже сильно квантованные версии Llama 3 70B (например, IQ2_S или _XS) на одной RTX 3090, хотя скорость может быть ниже (около 1.5 t/s для контекста 3076). Для задач кодирования Llama 3 показывает хорошие результаты, особенно если она была дообучена на кодовых датасетах. В LM Studio Llama 3 легко доступна, и вы сможете настроить параметры для контекста до 8K-16K токенов с оптимизацией.
3. Code Llama (13B версия)
Code Llama — это специализированная версия Llama, разработанная Meta специально для кодирования. Она обучена на обширных кодовых базах, что делает её исключительно эффективной для генерации, анализа и дополнения кода. 13B версия с 4-битным квантованием является оптимальным выбором для RTX 3090, предлагая хороший баланс между качеством, скоростью и потреблением VRAM. Контекст обычно составляет около 4K токенов, что достаточно для большинства задач программирования.
4. Qwen 2.5 (7B или 14B версии)
Qwen 2.5 от Alibaba — это мультимодальная модель с сильным акцентом на кодирование и логические рассуждения. Она обучена на многоязычных данных, включая код, и показывает отличное качество в генерации кода с минимальными ошибками. Для вашего оборудования подойдут 7B или 14B версии в квантованном формате, позволяя работать с контекстом до 8-16 тысяч токенов. В LM Studio на RTX 3090 ожидается скорость 5-10 t/s, что делает её быстрой для интерактивного кодирования.
5. Vicuna (13B версии)
Vicuna является ещё одним отличным вариантом для чат-бота и может быть адаптирована для кодирования. Она хорошо работает на RTX 3090, особенно версии с инструкциями (instruction-tuned). Максимальный контекст обычно составляет до 4K токенов. Её легко найти и настроить в LM Studio, используя 4-битное квантование для повышения скорости и снижения потребления памяти.
6. StarCoder / StarCoderPlus / CodeGen (7B или 12B версии)
Эти модели специально разработаны для генерации кода на различных языках программирования. 7B или 12B версии могут быть успешно запущены на RTX 3090 с квантованием, обеспечивая хороший баланс между VRAM и скоростью. Они предлагают одно из лучших качеств кода среди открытых моделей, с контекстом до 4K токенов.
7. Mistral 7B
Mistral 7B — это очень эффективная и быстрая модель. Хотя она не является специализированной для кодирования, её базовые возможности по генерации текста делают её пригодной для многих задач, связанных с кодом, особенно при использовании 4-битного квантования и больших контекстных окон.
Таблица Сравнения Рекомендованных LLM для Кодирования
Ниже представлена сравнительная таблица рекомендованных LLM, учитывающая их характеристики и пригодность для вашей системы:
| Модель LLM | Оптимальный Размер Параметров (квантованный) | Рекомендуемое Квантование | Примерная Скорость на RTX 3090 (токенов/с) | Максимальный Контекст (токенов) | Качество Кода | Особенности для Кодирования |
|---|---|---|---|---|---|---|
| DeepSeek R1 | 7B / 8B | Q4_K_M, Q5_K_M | 10-15 | 8K-16K | Высокое | Специализирована на коде, рассуждениях, отладке. |
| Llama 3 | 7B, 13B (или Q4/Q5 70B) | Q4_K_M, Q5_K_M, IQ2_S/_XS | 7B: 15-20, 13B: 10-15, 70B: 2-5 | 8K-16K | Очень высокое (при дообучении) | Универсальная, есть версии для кодирования. |
| Code Llama | 13B | Q4_K_M, Q5_K_M | 10-15 | 4K-8K | Высокое | Специализированная на коде, отличная для генерации. |
| Qwen 2.5 | 7B / 14B | Q4_K_M, Q5_K_M | 5-10 | 8K-16K | Высокое | Мультиязычная, сильный акцент на кодировании. |
| Vicuna | 13B | Q4_K_M | 10-15 | 4K | Хорошее | Chat-бот, хорошо адаптируется под кодинг. |
| StarCoder / CodeGen | 7B / 12B | Q4_K_M | 8-12 | 4K | Очень высокое | Специализированные модели для различных языков программирования. |
| Mistral 7B | 7B | Q4_K_M | 15-20 | 8K-16K | Хорошее | Очень эффективная, быстрая, можно использовать для базовых задач кодирования. |
Оптимизация Производительности в LM Studio
Для того чтобы максимально эффективно использовать ваше оборудование в LM Studio, следуйте этим рекомендациям:
Квантование: Ключ к Эффективности
Всегда используйте квантованные версии моделей (например, Q4_K_M, Q5_K_M) в LM Studio. Это значительно снижает потребление VRAM и системной памяти, что позволяет запускать более крупные модели с большим контекстом и повышает скорость инференса. Например, RTX 3090 может обеспечить до 101.74 токенов в секунду для 8B модели в 4-битном квантовании.
Настройка Контекстного Окна
В LM Studio вы можете настроить длину контекста для модели (например, 4096, 8192, 16384 токенов). RTX 3090 позволяет работать с большим контекстом, но мониторьте использование системной RAM – если она превышает 12 ГБ, возможно, потребуется уменьшить контекст или использовать более легкие версии моделей.
Использование Ускоренных Движков
Хотя LM Studio является удобным инструментом, для максимальной производительности рассмотрите интеграцию с более быстрыми движками, такими как vLLM или TensorRT-LLM, если они поддерживаются или если вы захотите выйти за рамки LM Studio. Например, TensorRT-LLM может быть до 70% быстрее, чем llama.cpp на настольных GPU, таких как 3090, при этом используя меньше RAM и CPU.
Оптимизация Системных Ресурсов
- Выделение VRAM: Убедитесь, что LM Studio использует всю доступную VRAM на вашей RTX 3090. Если возможно, избегайте запуска графического интерфейса на этой же карте, используя интегрированную графику вашего процессора (при наличии) или работайте в безголовом режиме.
- Оперативная память: Хотя 16 ГБ RAM достаточно, для очень больших контекстов или при работе с несколькими задачами, 32 ГБ DDR4 RAM может быть полезным. Избегайте одновременного запуска тяжелых приложений, чтобы минимизировать использование системной памяти.
- Охлаждение: RTX 3090 может сильно нагреваться при интенсивной нагрузке LLM. Убедитесь в адекватном охлаждении вашей системы.
Визуализация Производительности LLM на Вашей Системе
Для наглядного представления, как различные аспекты моделей влияют на производительность и качество на вашей конфигурации, я подготовил радар-график. Он отражает моё мнение о балансе между качеством кода, скоростью инференса, максимальной длиной контекста, доступностью в LM Studio и требованиями к системным ресурсам для рекомендованных моделей.
На этом графике вы можете увидеть, что DeepSeek R1 предлагает отличный баланс между качеством кода, скоростью и контекстом, а также относительно низкие требования к системной RAM, что делает его идеальным выбором для вашей системы. Llama 3 (в квантованной 70B версии) демонстрирует самое высокое качество, но компромиссирует скорость. Mistral 7B выделяется скоростью и низкими требованиями к RAM, но имеет немного меньшее качество кода для специализированных задач.
LM Studio: Ваше Окно в Локальные LLM
LM Studio — это удобный инструмент, который позволяет легко загружать и запускать различные модели LLM на вашем ПК. Он предоставляет простой графический интерфейс для управления моделями, настройки параметров и взаимодействия с ними через OpenAI-совместимый API-сервер. Использование LM Studio обеспечивает полную приватность, так как все данные остаются на вашей машине и не отправляются в облако.
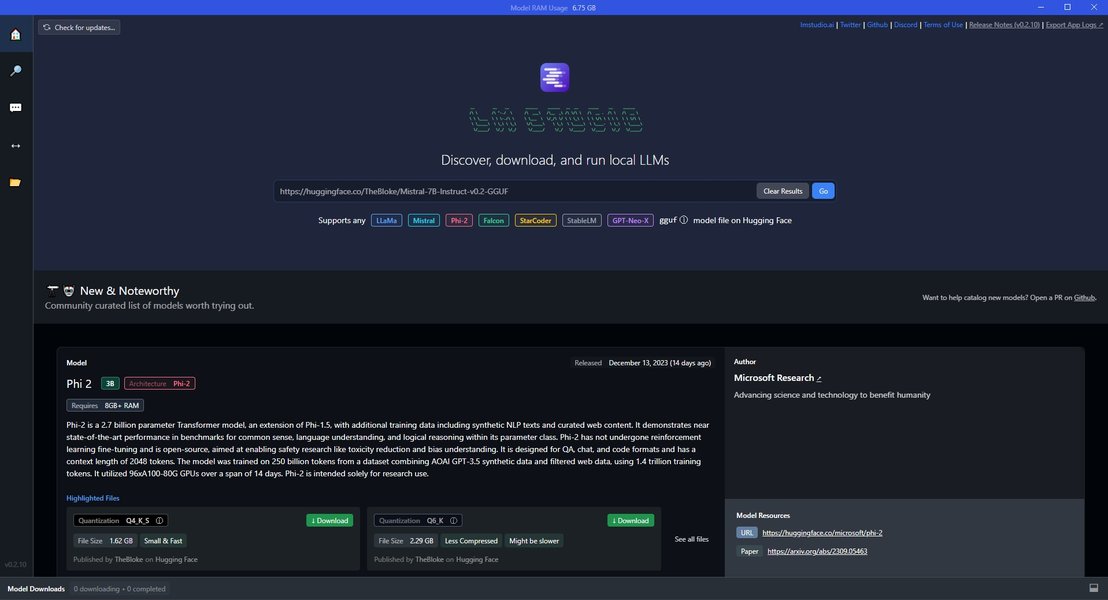
Пользовательский интерфейс LM Studio, упрощающий управление локальными LLM.
Как LM Studio Помогает с Кодированием
LM Studio позволяет легко переключаться между моделями, экспериментировать с различными параметрами квантования и длины контекста, что особенно полезно при поиске идеального баланса для задач кодирования. Вы можете загружать модели непосредственно из Hugging Face, и многие из них уже оптимизированы для использования в LM Studio. Помните, что регулярное обновление LM Studio до последней версии (например, 0.3.16 или выше) обеспечит поддержку новых функций и оптимизаций.
Видеообзор LM Studio, демонстрирующий процесс запуска локальных LLM и их возможности.
Это видео демонстрирует, как использовать LM Studio для запуска локальных LLM, в том числе Llama 3.1 8b Hermes. Оно пошагово объясняет процесс установки, загрузки моделей и настройки, что крайне полезно для пользователей, начинающих свой путь с локальными ИИ-ассистентами для кодирования.
Меняющаяся Ландшафт LLM и Будущие Тенденции
Мир LLM постоянно развивается, и новые модели и оптимизации появляются регулярно. На сегодняшний день, 4 июня 2025 года, RTX 3090 остается одним из наиболее экономически эффективных решений для запуска LLM с высоким объемом VRAM на вторичном рынке. Однако, если вы планируете масштабировать свои возможности или работать с еще более крупными моделями, стоит рассмотреть более мощные GPU или многокарточные конфигурации.
Диаграмма Взаимосвязей в Экосистеме Локальных LLM
Для лучшего понимания того, как различные компоненты и концепции взаимосвязаны в контексте локального запуска LLM для кодирования, представлена следующая ментальная карта:
(7B/8B)"] id_deepseek_code["Оптимизирована для кода"] id_deepseek_ctx["8K-16K контекст"] id_llama3["Llama 3
(7B/13B/квантованная 70B)"] id_llama3_vers["Различные версии"] id_llama3_code["Хороша для кода (дообученная)"] id_code_llama["Code Llama
(13B)"] id_code_llama_spec["Специализированная на коде"] id_qwen["Qwen 2.5
(7B/14B)"] id_qwen_multi["Мультиязычность, код"] id_vicuna["Vicuna
(13B)"] id_vicuna_chat["Хороша для чата, адаптируется"] id_starcoder["StarCoder/
CodeGen
(7B/12B)"] id_starcoder_quality["Высокое качество кода"] id_mistral["Mistral 7B"] id_mistral_fast["Быстрая, эффективная"] id_optim["Оптимизация"] id_quant["Квантование
(Q4_K_M, Q5_K_M)"] id_vram_save["Экономия VRAM"] id_speed_up["Увеличение скорости"] id_context["Настройка Контекста"] id_large_ctx["Поддержка больших контекстов"] id_cooling["Охлаждение"] id_temp["Управление температурой"] id_drivers["Обновление Драйверов"] id_cuda["NVIDIA CUDA"]
Эта ментальная карта наглядно демонстрирует, как все элементы вашей системы и выбранные модели взаимосвязаны, влияя на общую производительность и качество генерации кода.
Часто Задаваемые Вопросы (FAQ)
Какие модели LLM лучше всего подходят для кодирования на моей RTX 3090?
Как квантование влияет на производительность и качество LLM?
Сможет ли мой Ryzen 3500X справиться с этими моделями?
Что такое "контекст" в LLM и почему он важен для кодирования?
Заключение
Ваша система с RTX 3090 (24 ГБ VRAM), Ryzen 3500X и 16 ГБ оперативной памяти является отличной платформой для запуска локальных LLM, ориентированных на кодирование, особенно с использованием LM Studio. Выбирая квантованные версии моделей, таких как DeepSeek R1, Code Llama, или адаптированные Llama 3 и Qwen 2.5, вы сможете добиться высокой скорости инференса, отличного качества генерируемого кода и поддержки большого контекста. Постоянная оптимизация настроек в LM Studio и внимание к системным ресурсам позволят вам максимально раскрыть потенциал вашего оборудования для продуктивной работы с ИИ-ассистентами в области программирования.
Рекомендованные Запросы для Дальнейшего Изучения
- Как оптимизировать LM Studio для максимальной производительности LLM на RTX 3090
- Сравнение качества кода LLM: DeepSeek R1 vs Code Llama vs Llama 3
- Использование нескольких RTX 3090 для ускорения LLM инференса
- Преимущества локального запуска LLM для конфиденциальности кода