
Разблокируйте Потенциал Кодинга: Идеальные LLM для Вашей RTX 2060
Оптимизация языковых моделей для программирования на вашем локальном ПК с ограниченными ресурсами.
Ключевые Выводы для Вашей Системы
- Llama 3 (8B параметров) и Mistral 7B являются лучшими кандидатами для высококачественного кодирования на вашей RTX 2060 6GB, особенно при использовании квантования.
- Phi-3.5 Mini/Small и DeepSeek 3B предлагают превосходную скорость и эффективность, идеально подходящие для ограниченной VRAM.
- Использование квантования (GGUF, 4-бит) и функции GPU Offloading в LM Studio критически важно для максимизации производительности и контекстного окна.
Для эффективной работы с большими языковыми моделями (LLM), особенно оптимизированными для кодирования, на вашей конфигурации NVIDIA RTX 2060 6GB VRAM, AMD Ryzen 3500X и 16GB RAM, крайне важно выбирать модели с учетом аппаратных ограничений. Ваша RTX 2060 с 6GB видеопамяти является основным ограничивающим фактором для запуска крупных моделей, однако с правильными оптимизациями и выбором моделей можно добиться отличных результатов в LM Studio.
Понимание Аппаратных Ограничений и Возможностей
Ваша система представляет собой мощный, но сбалансированный набор компонентов для повседневных задач и некоторых требовательных приложений. Однако для LLM, особенно для моделей с большим количеством параметров, существуют определенные нюансы.
Видеопамять (VRAM) — Ключевой Фактор
Объем видеопамяти (VRAM) на вашей RTX 2060 (6GB) является самым критическим фактором. Большинство современных LLM, особенно предназначенных для кодирования, могут быть очень требовательны к VRAM. Для справки:
- Модели размером 12B параметров могут требовать до 24GB VRAM.
- Модели размером 6.9B параметров — около 17GB VRAM.
- Модели размером 2.8B параметров — около 7GB VRAM.
Это означает, что полностью загрузить в GPU модели с количеством параметров выше 6-7 миллиардов будет сложно без серьезных компромиссов. Основные стратегии для преодоления этого ограничения включают использование квантованных моделей и GPU offloading.
Оперативная Память (RAM) и CPU
Ваши 16GB оперативной памяти достаточны для поддержки моделей, которые могут быть частично выгружены из VRAM (GPU offloading) или полностью запущены на CPU, если GPU не справляется. Однако запуск LLM только на CPU значительно замедлит процесс (в 10-100 раз медленнее, чем на GPU). Ryzen 3500X — это достаточно мощный процессор, который обеспечит хорошую поддержку, но основная нагрузка для ускорения работы должна ложиться на GPU.
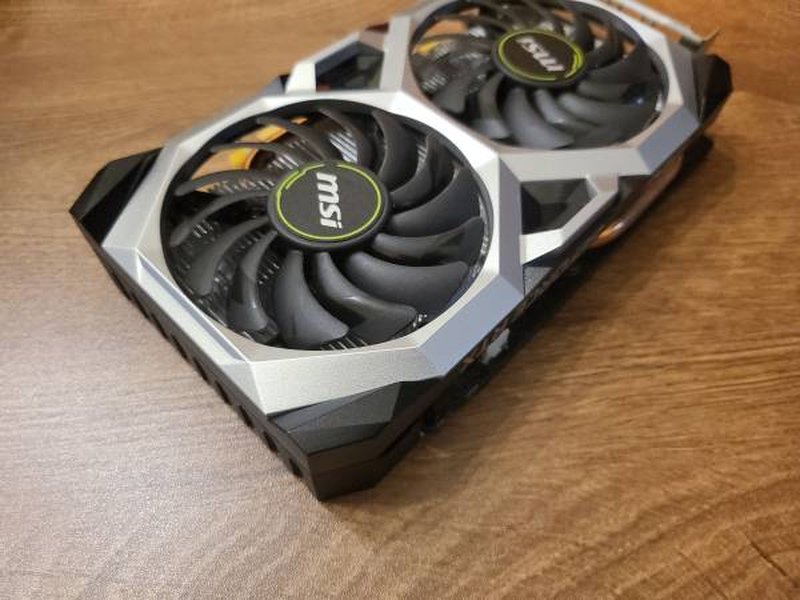
Изображение графического процессора NVIDIA GeForce RTX 2060.
Оптимальные LLM для Кодирования на Вашей Системе
Для вашей конфигурации, вам следует ориентироваться на модели с меньшим количеством параметров (3B-8B), обязательно в квантованном формате (например, GGUF), что значительно снижает требования к памяти без существенной потери качества.
Лучшие Модели по Соотношению Качества и Скорости
На основе анализа, следующие модели идеально подходят для кодирования на вашей RTX 2060:
Llama 3 (8B параметров)
Llama 3 является одной из самых мощных открытых моделей на 2025 год. Она обучена на значительно большем объеме данных, включая в 4 раза больше кода, что делает её отличным выбором для генерации и понимания кода. Версия 8B параметров может работать на вашей RTX 2060 6GB при использовании оптимизаций, таких как 4-битное квантование. Она предлагает высокое качество, производительность и поддерживает большой контекст.
Mistral 7B
Mistral 7B — это компактная, но очень мощная LLM (7.3 миллиарда параметров), которая часто превосходит по производительности более крупные модели, такие как Llama 2 13B, в определенных задачах. При квантовании до 4-5 бит, она может быть успешно запущена на вашей системе с 6GB VRAM, возможно, с частичной выгрузкой на RAM. Она зарекомендовала себя как отличный выбор для задач программирования и генерации кода.
Phi-3.5 Mini/Small (3-4B параметров)
Модели серии Phi-3, такие как Mini и Small, хорошо работают на системах с 6GB VRAM. Они могут обрабатывать запросы достаточно быстро, хотя их качество для кодирования может быть немного ниже по сравнению с более крупными моделями. Phi-3.5 демонстрирует хорошие результаты в задачах кодирования, с меньшим количеством ошибок и поддержкой популярных языков программирования (Python, Java, C++).
DeepSeek (3B или 7B версии)
DeepSeek — отличный выбор для кодирования, так как она специально оптимизирована для задач, связанных с кодом. 3B версия показала очень высокую скорость (5-7 токенов/с) на RTX 2060 и полностью помещается в 6GB VRAM. 7B версия также может быть использована с квантованием, обеспечивая при этом хорошее качество. DeepSeek отлично справляется со сложными задачами, такими как оптимизация кода и генерация функций.
Qwen 2.5 (7B параметров)
Qwen 2.5 7B может работать на 6GB VRAM при квантовании, обеспечивая хорошую скорость (4-5 токенов/с) и поддержку до 4096 токенов. Она эффективна в кодировании и демонстрирует сильные возможности в обработке нескольких языков программирования и оптимизации кода.
Представленные модели показывают высокую производительность и качество, а также являются открытыми, что даёт возможность для их дальнейшей настройки и использования. Для вашего удобства, ниже приведена таблица с подробным сравнением рекомендованных LLM для кодирования:
| Модель | Параметры | Особенности кодирования | Подходит для RTX 2060 6GB (с оптимизациями) | Ориентировочная скорость (токен/с) | Макс. контекст (токены) |
|---|---|---|---|---|---|
| Llama 3 | 8B | Высокое качество, обучена на большом объеме кода | Да | 4-6 | Большой (до 8192+) |
| Mistral 7B | 7B | Мощная, превосходит Llama 2 13B в некоторых задачах | Да | 4-5 | 2048-4096 |
| Phi-3.5 Mini/Small | 3-4B | Быстрая, эффективна для кодирования | Да | 4-6 | 2048-4096 |
| DeepSeek | 3B/7B | Оптимизирована для кода, высокая точность | Да | 5-7 | 4096 |
| Qwen 2.5 | 7B | Эффективна в кодировании, мультиязычность | Да | 4-5 | 4096 |
Оптимизация в LM Studio для Максимальной Эффективности
LM Studio предоставляет отличные инструменты для работы с LLM на локальном уровне. Чтобы выжать максимум из вашей системы, обратите внимание на следующие настройки:
Квантование и Форматы Моделей
Используйте модели в формате GGUF (General Graph Universal Format) с квантованием (например, q4_k_m или q5_k_m). Квантование уменьшает размер модели и требования к VRAM, сохраняя при этом приемлемое качество. Например, 4-битное или 5-битное квантование может значительно сократить потребление памяти.
GPU Offloading
Эта функция позволяет переносить слои модели на GPU для ускорения, даже если вся модель не помещается в VRAM. Вы можете настроить максимальный уровень выгрузки на GPU. LM Studio автоматически использует системную RAM, если модель не помещается полностью в VRAM. Это позволяет запускать более крупные модели, но может замедлить их работу.
Настройки Производительности
- "Keep entire model in RAM" (Держать всю модель в RAM): Отключение этой опции может уменьшить использование системной RAM, но может быть необходимо для запуска очень больших моделей, которые не помещаются ни в VRAM, ни в доступную RAM.
- Flash Attention (FA): Активируйте эту опцию, если она доступна. Flash Attention — это метод оптимизации, который может значительно ускорить инференс, особенно для моделей с большим контекстным окном.
- Мониторинг Токенов/с: LM Studio отображает метрику "токен/с" (tokens per second), которая поможет вам оценить скорость работы выбранной модели и настроек. Для вашей конфигурации ожидайте скорость 4-7 токенов в секунду для рекомендованных моделей.
Влияние Размера Контекста на Производительность
Максимальное количество токенов, которое модель может обрабатывать одновременно (контекстное окно), напрямую влияет на требования к памяти. Для задач кодирования, где часто требуется большой контекст (например, для анализа целых файлов или проектов), чем больше токенов, тем лучше. Однако это увеличивает нагрузку на VRAM и RAM. Модели, поддерживающие 2048-4096 токенов, будут вполне достаточны для большинства задач кодирования на вашей системе.
Визуализация контекстного окна LLM и её взаимодействие с токенами.
Сравнительный Анализ Производительности LLM
Чтобы наглядно оценить производительность и возможности различных моделей на вашей системе, можно представить их характеристики в виде радарной диаграммы. Эта диаграмма основана на синтетических оценках, учитывающих качество кодирования, скорость инференса, эффективность использования VRAM и поддержку контекста.
На этой диаграмме видно, что Llama 3 и Mistral 7B являются наиболее сбалансированными моделями, предлагая высокое качество кодирования и хорошую производительность. DeepSeek выделяется скоростью и эффективностью VRAM, а Phi-3.5 — максимальной эффективностью VRAM, что делает её отличным выбором для систем с жесткими ограничениями.
Глубокий Взгляд на Выбор и Настройку LLM
При выборе и настройке LLM для вашей системы важно учитывать несколько факторов, которые влияют на общую производительность и удобство использования.
Процесс Выбора Модели
Ваш процесс выбора начинается с понимания того, как объем VRAM и RAM влияют на размер модели и её эффективность. 6GB VRAM на RTX 2060 позволяет использовать только сильно квантованные версии моделей с 7B-8B параметрами. Модели типа Llama 3 и Mistral, хотя и являются более крупными, имеют оптимизированные версии (GGUF, 4-бит), которые могут работать на вашей системе. Более мелкие модели, такие как Phi-3.5 Mini/Small и DeepSeek 3B, идеально подходят для полной загрузки в VRAM, обеспечивая максимальную скорость.
Настройка LM Studio для Оптимальной Работы
В LM Studio вы найдете удобный интерфейс для управления моделями. После загрузки желаемой модели, экспериментируйте с настройками GPU offloading. Попробуйте установить максимальный уровень выгрузки на GPU. Если вы столкнетесь с замедлением, уменьшите количество слоев, выгружаемых на GPU, или попробуйте более агрессивные настройки квантования. Постоянно отслеживайте показатель "токен/с", чтобы найти золотую середину между качеством и скоростью.
Освоение Локальных LLM: Путь к Успеху в Кодировании
Использование локальных LLM для кодирования открывает огромные возможности для разработчиков, предлагая приватность, контроль и отсутствие зависимости от облачных сервисов. Для вашей системы, путь к успешной работе с LLM можно представить в виде интеллектуальной карты:
Эта карта демонстрирует взаимосвязи между вашим оборудованием, используемым программным обеспечением и ключевыми аспектами выбора моделей, помогая вам принимать обоснованные решения для достижения наилучших результатов в кодировании.
Сетевые Модели LLM: Понимание Ограничений
Хотя ваш акцент делается на локальных LLM, важно понимать, что для некоторых задач, требующих огромного контекстного окна или сверхвысокой производительности, могут потребоваться облачные решения или более мощное аппаратное обеспечение. Например, для контекстных окон в 100K токенов необходимы GPU с 80GB VRAM, такие как NVIDIA A100. Ваша система, хотя и весьма способна для локальной работы с разумными моделями, имеет свои пределы.
Видео демонстрирует попытку запустить большую 70B LLM на MacBook Pro, подчеркивая вызовы, связанные с ограниченными ресурсами. Это видео актуально, так как оно показывает, что даже мощные потребительские устройства могут быть недостаточными для очень больших моделей, что дополнительно подчеркивает важность оптимизации для вашей системы.
Часто Задаваемые Вопросы (FAQ)
Какие модели лучше всего подходят для кодирования на моей RTX 2060?
Как я могу максимизировать количество токенов в LM Studio?
Какая ожидаемая скорость работы LLM на моей системе?
Нужно ли мне увеличивать объем RAM?
Заключение
Ваша система с RTX 2060 6GB, Ryzen 3500X и 16GB RAM обладает достаточной мощностью для эффективной работы с локальными языковыми моделями, ориентированными на кодирование, особенно при использовании LM Studio. Ключ к успеху заключается в тщательном выборе моделей с меньшим количеством параметров и активном применении оптимизаций, таких как квантование и GPU offloading. Llama 3 (8B) и Mistral 7B предлагают превосходное качество кода, в то время как Phi-3.5 Mini/Small и DeepSeek 3B обеспечивают высокую скорость и максимальную эффективность использования VRAM. Экспериментируя с настройками в LM Studio, вы сможете найти оптимальный баланс между скоростью, качеством и максимальным размером контекста, что позволит вам значительно повысить продуктивность в задачах кодирования.
Рекомендуемые Запросы для Дальнейшего Изучения
- Как выбрать лучшие параметры квантования для LLM в LM Studio?
- Сравнение производительности LLM для кодирования: Llama 3 против DeepSeek.
- Влияние размера контекста LLM на качество генерируемого кода.
- Оптимизация LM Studio для низкопрофильных GPU.
Ссылки на Релевантные Источники
 aws.amazon.com