
LaBSE กับภาษาไทย: ไขความลับการฝึกฝนโมเดลด้วยข้อมูลภาษาของเรา!
เจาะลึกว่า sentence-transformers/LaBSE ได้รับการฝึกฝนด้วยข้อมูลภาษาไทยหรือไม่ และความสามารถที่น่าทึ่งสำหรับนักพัฒนาไทย
โมเดล LaBSE (Language-agnostic BERT Sentence Embedding) เป็นหนึ่งในเครื่องมือประมวลผลภาษาธรรมชาติ (NLP) ที่ทรงพลัง ซึ่งพัฒนาโดย Google AI โดยมีเป้าหมายเพื่อสร้าง Sentence Embeddings หรือเวกเตอร์แทนความหมายของประโยคที่ไม่ขึ้นกับภาษาใดภาษาหนึ่งโดยเฉพาะ ทำให้สามารถเปรียบเทียบความหมายของประโยคจากภาษาต่างๆ ได้อย่างมีประสิทธิภาพ คำถามสำคัญที่หลายคนสงสัยคือ โมเดลนี้ได้รับการฝึกฝนด้วยข้อมูลภาษาไทยหรือไม่? คำตอบคือ ใช่ LaBSE ได้รับการฝึกฝนและรองรับภาษาไทยอย่างเป็นทางการ
ประเด็นสำคัญที่คุณควรรู้
- การรองรับหลายภาษาที่ครอบคลุม: LaBSE ได้รับการออกแบบมาเพื่อรองรับมากถึง 109 ภาษาทั่วโลก และภาษาไทย (รหัส 'th' หรือ 'tha') เป็นหนึ่งในภาษาเหล่านั้นอย่างชัดเจน
- การฝึกฝนด้วยข้อมูลภาษาไทย: โมเดลนี้ผ่านการฝึกฝนด้วยชุดข้อมูลขนาดใหญ่ที่มีภาษาไทยรวมอยู่ด้วย ผ่านเทคนิค Masked Language Modeling (MLM) และ Translation Language Modeling (TLM) ทำให้เข้าใจโครงสร้างและความหมายของภาษาไทยได้
- ศักยภาพในการใช้งานข้ามภาษา: ด้วยการที่ภาษาไทยถูกรวมอยู่ในการฝึกฝน LaBSE จึงสามารถสร้างเวกเตอร์ความหมายของประโยคภาษาไทยที่อยู่ในปริภูมิเวกเตอร์ (vector space) เดียวกันกับภาษาอื่นๆ เอื้อประโยชน์ต่องาน NLP ข้ามภาษา เช่น การค้นหาความหมายที่คล้ายกัน การจัดกลุ่มข้อความ หรือแม้กระทั่งการสนับสนุนการแปล
LaBSE คืออะไร และเหตุใดจึงสำคัญกับภาษาไทย?
LaBSE ย่อมาจาก Language-agnostic BERT Sentence Embedding เป็นโมเดลที่พัฒนาต่อยอดมาจากสถาปัตยกรรม BERT (Bidirectional Encoder Representations from Transformers) อันโด่งดัง เป้าหมายหลักของ LaBSE คือการสร้าง "sentence embeddings" ที่มีความหมายสอดคล้องกันข้ามภาษา นั่นหมายความว่า ประโยคที่มีความหมายเหมือนหรือคล้ายกันในภาษาที่แตกต่างกัน (เช่น ไทยกับอังกฤษ) จะถูกแปลงเป็นเวกเตอร์ที่อยู่ใกล้กันในปริภูมิเวกเตอร์ ทำให้สามารถนำไปประยุกต์ใช้งานด้านความเข้าใจภาษาในระดับนานาชาติได้อย่างกว้างขวาง
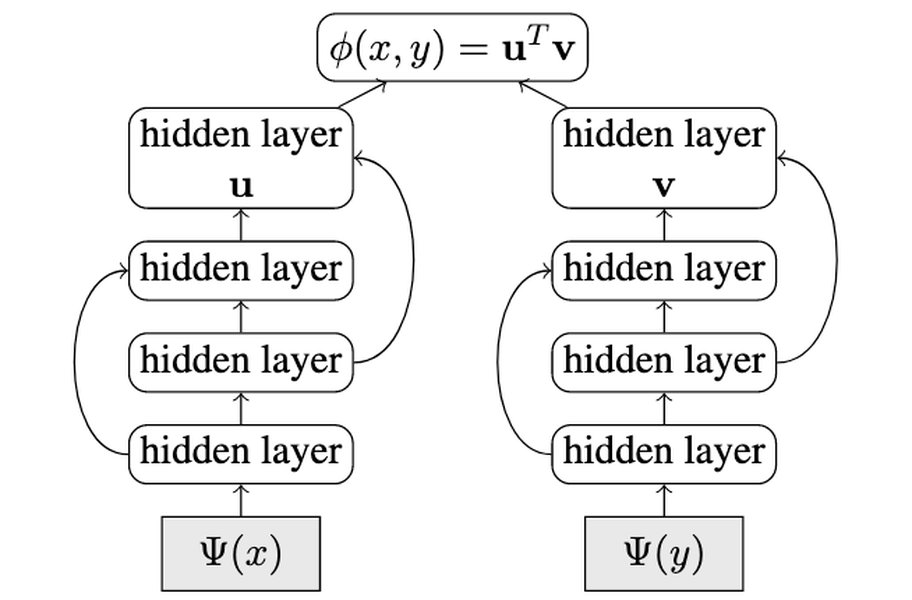
ภาพประกอบแนวคิดของ LaBSE จากบทความบน Medium ที่อธิบายการทำงานของโมเดล
การที่ LaBSE รองรับภาษาไทยนั้นมีความสำคัญอย่างยิ่ง เพราะเป็นการเปิดประตูสู่การนำเทคโนโลยี NLP ขั้นสูงมาประยุกต์ใช้กับเนื้อหาภาษาไทยได้โดยตรงและมีประสิทธิภาพมากขึ้น ไม่ว่าจะเป็นการพัฒนาระบบค้นหาข้อมูลภาษาไทยให้ฉลาดขึ้น การวิเคราะห์ความคิดเห็นของลูกค้าที่เป็นภาษาไทย หรือการสร้างแชทบอทที่เข้าใจภาษาไทยได้อย่างลึกซึ้ง
กระบวนการฝึกฝน LaBSE และการรวมภาษาไทย
LaBSE ได้รับการฝึกฝน (pre-trained) ด้วยข้อมูลจำนวนมหาศาลจากหลากหลายภาษา ซึ่งรวมถึงภาษาไทยด้วย โดยใช้เทคนิคการเรียนรู้ที่สำคัญสองประการคือ:
- Masked Language Modeling (MLM): โมเดลจะเรียนรู้บริบทและความสัมพันธ์ของคำต่างๆ ในประโยคโดยการ "ปิดบัง" คำบางคำในประโยค แล้วให้โมเดลทายว่าคำที่ถูกปิดบังนั้นคืออะไร การฝึกฝนด้วยข้อมูลภาษาไทยในส่วนนี้ช่วยให้โมเดลเข้าใจโครงสร้างไวยากรณ์และคำศัพท์ภาษาไทย
- Translation Language Modeling (TLM): เทคนิคนี้ใช้คู่ประโยคที่เป็นคำแปลของกันและกัน (เช่น ประโยคภาษาไทยและคำแปลภาษาอังกฤษ) เพื่อสอนให้โมเดลสร้าง embeddings ที่ใกล้เคียงกันสำหรับประโยคที่มีความหมายเดียวกันแม้จะอยู่คนละภาษา ข้อมูลที่ใช้ในการฝึกฝนส่วนนี้มาจากแหล่งต่างๆ เช่น CommonCrawl และชุดข้อมูลคู่ขนาน (Parallel Corpora) อื่นๆ ซึ่งมีข้อมูลภาษาไทยรวมอยู่ด้วย
แหล่งข้อมูลหลายแห่ง เช่น เอกสารจาก Hugging Face, TensorFlow Hub, และงานวิจัยต้นฉบับ (arXiv:2007.01852) ยืนยันว่าภาษาไทย (ระบุด้วยรหัส 'th' หรือ 'tha') เป็นหนึ่งใน 109 ภาษาที่โมเดลนี้รองรับอย่างเป็นทางการ ซึ่งหมายความว่าข้อมูลภาษาไทยได้ถูกนำไปใช้ในกระบวนการฝึกฝนจริง
ผลลัพธ์ที่ได้: Embeddings ที่เข้าใจภาษาไทย
ผลจากการฝึกฝนดังกล่าว ทำให้ LaBSE สามารถสร้าง sentence embeddings สำหรับประโยคภาษาไทยที่มีคุณภาพสูง เวกเตอร์เหล่านี้จับความหมายและนัยยะของประโยคภาษาไทยได้ดี และที่สำคัญคือ เวกเตอร์ของประโยคภาษาไทยจะอยู่ในปริภูมิเดียวกับภาษาอื่นๆ อีก 108 ภาษา ทำให้สามารถเปรียบเทียบความหมายข้ามภาษาได้อย่างแม่นยำ เช่น การค้นหาเอกสารภาษาอังกฤษที่เกี่ยวข้องกับคำค้นภาษาไทย
ศักยภาพของ LaBSE ในการประมวลผลภาษาไทย
การที่ LaBSE ได้รับการฝึกฝนด้วยข้อมูลภาษาไทย ทำให้โมเดลนี้มีศักยภาพสูงในการนำไปประยุกต์ใช้งานด้าน NLP ที่เกี่ยวข้องกับภาษาไทยหลายด้าน ตารางด้านล่างนี้สรุปคุณสมบัติหลักและความสามารถที่เกี่ยวข้องกับการสนับสนุนภาษาไทย:
| คุณสมบัติ | รายละเอียด | ความเกี่ยวข้องกับภาษาไทย |
|---|---|---|
| จำนวนภาษาที่รองรับ | 109 ภาษา | ภาษาไทย (th/tha) เป็นหนึ่งในภาษาที่รองรับอย่างเป็นทางการ |
| เทคนิคการฝึกฝนหลัก | Masked Language Modeling (MLM), Translation Language Modeling (TLM) | ข้อมูลภาษาไทยถูกใช้ในกระบวนการฝึกฝนด้วยเทคนิคเหล่านี้ ทำให้โมเดลเข้าใจโครงสร้างและความหมายของภาษาไทย |
| ประเภท Embedding | Language-agnostic Sentence Embeddings | สร้างเวกเตอร์แทนความหมายประโยคภาษาไทยที่สามารถเปรียบเทียบกับภาษาอื่นได้ในปริภูมิเวกเตอร์เดียวกัน |
| ความสามารถหลัก | การเปรียบเทียบความหมายประโยค, การค้นหาข้ามภาษา, การจัดกลุ่มข้อความ | สามารถใช้กับงาน เช่น ค้นหาเอกสารภาษาไทยที่มีความหมายคล้ายกัน, จัดกลุ่มบทความภาษาไทยตามเนื้อหา, หรือค้นหาข้อมูลข้ามภาษาไทย-อังกฤษ |
| การเข้าถึงโมเดล | ผ่านไลบรารี เช่น `sentence-transformers` (PyTorch), TensorFlow Hub | นักพัฒนาสามารถนำ LaBSE ไปใช้งานกับข้อมูลภาษาไทยได้ง่ายผ่านเครื่องมือยอดนิยมเหล่านี้ |
| ประสิทธิภาพ | แสดงประสิทธิภาพที่ดีในการดึงข้อมูลแบบ bi-text retrieval ข้ามภาษา รวมถึงภาษาไทย | มีความแม่นยำสูงในการจับคู่ประโยคภาษาไทยกับคำแปลในภาษาอื่น หรือค้นหาประโยคที่มีความหมายใกล้เคียงกัน |
ด้วยคุณสมบัติเหล่านี้ LaBSE จึงเป็นเครื่องมือที่มีคุณค่าสำหรับนักพัฒนาและนักวิจัยที่ทำงานกับข้อมูลภาษาไทย ช่วยยกระดับความสามารถในการวิเคราะห์และทำความเข้าใจข้อความภาษาไทยในบริบทที่หลากหลายและเชื่อมโยงกับภาษาอื่นๆ ทั่วโลก
การประเมินคุณลักษณะของ LaBSE สำหรับภาษาไทย
เพื่อให้เห็นภาพรวมของความสามารถของ LaBSE ที่เกี่ยวข้องกับภาษาไทยได้ชัดเจนยิ่งขึ้น ลองพิจารณาการประเมินคุณลักษณะต่างๆ ในรูปแบบแผนภูมิเรดาร์ด้านล่างนี้ แผนภูมินี้แสดงการประเมินเชิงคุณภาพโดยอิงตามข้อมูลที่ทราบเกี่ยวกับโมเดลและการฝึกฝน (คะแนนเต็ม 10 โดย 1 คือต่ำสุด และ 10 คือสูงสุด):
จากแผนภูมิ จะเห็นได้ว่า LaBSE มีจุดแข็งในด้านความเข้าใจโครงสร้างภาษาไทยพื้นฐาน การสร้าง embedding ที่ไม่ขึ้นกับภาษา และประสิทธิภาพในการทำงานข้ามภาษา อย่างไรก็ตาม การรองรับความหลากหลายทางภาษาถิ่นของไทยอาจมีข้อจำกัด เนื่องจากโมเดลหลักมักถูกฝึกด้วยภาษาไทยมาตรฐานเป็นหลัก
โครงสร้างแนวคิดของ LaBSE และการรองรับภาษาไทย
เพื่อให้เข้าใจภาพรวมของ LaBSE และการสนับสนุนภาษาไทยได้ง่ายขึ้น แผนผังความคิด (Mindmap) ด้านล่างนี้จะสรุปองค์ประกอบหลักและความเชื่อมโยงต่างๆ:
(เช่น จาก CommonCrawl, Tatoeba)"] id3["ผลลัพธ์: Sentence Embeddings"] id3_1["ไม่ขึ้นกับภาษา (Language-agnostic)"] id3_2["ปริภูมิเวกเตอร์ร่วม (Shared Vector Space)"] id3_2_1["ประโยคไทยและภาษาอื่นอยู่ร่วมกัน"] id4["ความสามารถและการประยุกต์ใช้ (สำหรับภาษาไทย)"] id4_1["การค้นหาความหมายเหมือน (Semantic Search)"] id4_2["การเปรียบเทียบความคล้ายคลึงของประโยค"] id4_3["การจัดกลุ่มข้อความ (Text Clustering)"] id4_4["การค้นคืนข้อมูลข้ามภาษา (Cross-lingual Retrieval)"] id4_5["การสนับสนุนการแปล"] id5["การใช้งานผ่านไลบรารี"] id5_1["Sentence Transformers (PyTorch)"] id5_2["TensorFlow Hub"]
แผนผังนี้แสดงให้เห็นว่าการสนับสนุนภาษาไทยเป็นส่วนหนึ่งของสถาปัตยกรรมและการฝึกฝนหลักของ LaBSE ซึ่งนำไปสู่ความสามารถในการประมวลผลภาษาไทยในบริบทที่หลากหลายและเชื่อมโยงกับภาษาอื่นๆ
เรียนรู้เพิ่มเติมเกี่ยวกับ Sentence Transformers
Nils Reimers ผู้สร้างไลบรารี Sentence Transformers ได้อธิบายเกี่ยวกับ Sentence Transformers และการประเมิน Embedding ในวิดีโอนี้ ซึ่งให้ความรู้พื้นฐานที่เป็นประโยชน์อย่างยิ่งต่อการทำความเข้าใจวิธีการทำงานและการนำโมเดลเช่น LaBSE ไปใช้งานจริง วิดีโอนี้จะให้ภาพรวมว่า Sentence Transformers ช่วยให้การสร้างและใช้งาน sentence embeddings ง่ายขึ้นอย่างไร รวมถึงแนวทางการประเมินคุณภาพของ embeddings ที่ได้
การทำความเข้าใจหลักการของ Sentence Transformers จะช่วยให้เห็นภาพชัดเจนขึ้นว่า LaBSE สามารถถูกนำมาประยุกต์ใช้ในการสร้าง embeddings สำหรับประโยคภาษาไทย และนำไปใช้ในงานต่างๆ เช่น การค้นหาความหมายที่คล้ายกัน การจัดกลุ่ม หรือการวิเคราะห์ความรู้สึก ได้อย่างมีประสิทธิภาพผ่านไลบรารีนี้
คำถามที่พบบ่อย (FAQ)
โมเดล sentence-transformers/LaBSE รองรับภาษาไทยจริงหรือไม่?
ใช่ครับ/ค่ะ LaBSE ได้รับการออกแบบและฝึกฝนมาเพื่อรองรับภาษามากถึง 109 ภาษาทั่วโลก และ "ภาษาไทย" (ซึ่งมักระบุด้วยรหัส 'th' หรือ 'tha') เป็นหนึ่งในภาษาเหล่านั้นอย่างเป็นทางการ มีการยืนยันจากเอกสารประกอบของโมเดลและแหล่งข้อมูลต่างๆ เช่น Hugging Face และงานวิจัยต้นฉบับ ว่าภาษาไทยถูกรวมอยู่ในการฝึกฝน
LaBSE เรียนรู้และเข้าใจภาษาไทยได้อย่างไร?
LaBSE เรียนรู้ภาษาไทยผ่านกระบวนการ pre-training ที่ซับซ้อน โดยใช้เทคนิคหลักๆ คือ:
- Masked Language Modeling (MLM): โมเดลเรียนรู้บริบทและความสัมพันธ์ของคำในประโยคภาษาไทยโดยการทายคำที่ถูกปิดบังไว้
- Translation Language Modeling (TLM): โมเดลเรียนรู้จากการจับคู่ประโยคภาษาไทยกับคำแปลในภาษาอื่น (เช่น อังกฤษ) ทำให้เข้าใจว่าประโยคที่มีความหมายเดียวกันในภาษาต่างๆ ควรมี representation ที่ใกล้เคียงกัน
การฝึกฝนด้วยชุดข้อมูลขนาดใหญ่ที่มีภาษาไทยเป็นส่วนประกอบสำคัญ ทำให้ LaBSE สามารถสร้าง sentence embeddings ที่จับความหมายของประโยคภาษาไทยได้ดี
อะไรคือประโยชน์หลักของการที่ LaBSE รองรับภาษาไทย?
ประโยชน์หลักคือ LaBSE ช่วยให้สามารถทำงานด้านการประมวลผลภาษาธรรมชาติ (NLP) ที่เกี่ยวข้องกับภาษาไทยในระดับข้ามภาษา (cross-lingual) ได้อย่างมีประสิทธิภาพ ตัวอย่างเช่น:
- การค้นหาความหมายที่คล้ายกัน (Semantic Similarity): เปรียบเทียบว่าประโยคภาษาไทยสองประโยคมีความหมายใกล้เคียงกันเพียงใด หรือประโยคภาษาไทยกับประโยคภาษาอื่นมีความหมายสอดคล้องกันหรือไม่
- การค้นคืนข้อมูลข้ามภาษา (Cross-lingual Information Retrieval): ใช้คำค้นภาษาไทยเพื่อค้นหาเอกสารที่เกี่ยวข้องในภาษาอื่น หรือในทางกลับกัน
- การจัดกลุ่มข้อความ (Text Clustering): จัดกลุ่มเอกสารภาษาไทยตามหัวข้อหรือความหมาย แม้จะมีเอกสารภาษาอื่นปะปนอยู่ด้วย
- Zero-shot or Few-shot Learning: สามารถนำความรู้ที่ได้จากภาษาที่มีข้อมูลมาก (เช่น อังกฤษ) มาปรับใช้กับภาษาไทยได้ในระดับหนึ่ง แม้ข้อมูลฝึกฝนเฉพาะทางสำหรับงานนั้นๆ ในภาษาไทยจะมีน้อย
LaBSE เหมาะสมกับงานประเภทใดบ้างที่เกี่ยวข้องกับภาษาไทย?
LaBSE เหมาะสำหรับงาน NLP หลากหลายประเภทที่ต้องการความเข้าใจในระดับความหมายของประโยคภาษาไทย โดยเฉพาะงานที่ต้องการความสามารถข้ามภาษา ตัวอย่างเช่น:
- ระบบแนะนำเนื้อหาที่เข้าใจความสนใจของผู้ใช้จากข้อความภาษาไทย
- การวิเคราะห์ความคิดเห็นของลูกค้าที่เป็นภาษาไทยเพื่อจำแนกความรู้สึก (sentiment analysis) ในเบื้องต้น
- การสร้างระบบถาม-ตอบ (Question Answering) ที่สามารถดึงคำตอบจากเอกสารภาษาไทย
- การปรับปรุงคุณภาพการแปลภาษาโดยใช้ embeddings เป็นตัวแทนความหมาย
- การตรวจจับเนื้อหาที่ซ้ำซ้อนกันในชุดเอกสารภาษาไทย
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
- เรียนรู้วิธีการใช้งาน LaBSE กับภาษาไทยผ่านไลบรารี sentence-transformers
- ค้นหาการเปรียบเทียบประสิทธิภาพของ LaBSE กับโมเดล embedding อื่นๆ เมื่อใช้กับภาษาไทย
- สำรวจตัวอย่างโปรเจกต์ NLP ที่ประสบความสำเร็จในการใช้ LaBSE ประมวลผลข้อมูลภาษาไทย
- ศึกษาข้อจำกัดและความท้าทายเมื่อนำ LaBSE มาใช้กับภาษาไทยที่มีลักษณะเฉพาะถิ่นหรือคำสแลง
แหล่งอ้างอิง
Last updated May 15, 2025