
Curso Introdutório sobre Large Language Models
Descubra a base, estrutura e funcionamento dos LLMs
Destaques Essenciais do Curso
- Conceitos Fundamentais: Introdução às redes neurais, transformadores e a lógica dos LLMs.
- Arquitetura e Funcionamento: Compreensão profunda da estrutura, mecanismos de atenção e componentes principais.
- Aplicações e Questões Éticas: Exemplos práticos e os desafios associados ao uso de LLMs.
Agenda da Apresentação
- Introdução aos Large Language Models (LLMs)
- Redes Neurais e a Base dos LLMs
- Arquitetura dos Transformadores
- Estrutura e Funcionamento dos LLMs
- Comparação com Abordagens Tradicionais
- Principais Aplicações
- Considerações Éticas e Limitações
- Discussão Interativa e Perguntas
1. Introdução aos Large Language Models (LLMs)
O que são LLMs?
Os Large Language Models (LLMs) são sistemas avançados de inteligência artificial baseados em redes neurais, especialmente projetados para o processamento de linguagem natural. Estes modelos são treinados em vastas quantidades de dados textuais, permitindo-lhes compreender, gerar e transformar texto de maneira coerente e humana.
Principais Características
- Treinamento com grandes volumes de dados textuais.
- Capacidade de gerar texto natural e relevante.
- Aplicação em diversas tarefas como tradução, sumarização, e análise de sentimentos.
2. Redes Neurais: O Coração dos LLMs
Entendendo as Redes Neurais
Redes neurais são sistemas computacionais inspirados em como o cérebro humano processa informações. Constituídas por unidades chamadas "neurônios artificiais", essas redes se organizam em múltiplas camadas para capturar padrões e relações complexas presentes nos dados.
Arquiteturas Clássicas e Modernas
- Redes Neurais Feedforward: Estruturas simples utilizadas para funções de reconhecimento e classificação.
- Redes Neurais Convolucionais (CNNs): Excelentes para o processamento de dados visuais.
- Redes Neurais Recorrentes (RNNs) e LSTMs: Projetadas para sequências temporais, mas com limitações na captura de dependências de longo alcance.
Com o avanço da tecnologia, especialmente na área de processamento de linguagem natural, as redes neurais foram aprimoradas para incorporar mecanismos que conseguem tratar a linguagem de forma mais paralela e eficiente, culminando no desenvolvimento dos transformadores.
3. Arquitetura dos Transformadores
De RNNs aos Transformadores
Em 2017, o artigo “Attention is All You Need” revolucionou o campo de processamento de linguagem natural ao apresentar a arquitetura Transformer, que substituiu as redes neurais recorrentes para várias tarefas, graças à sua capacidade de processar dados de forma paralela e capturar relações de longo alcance.
Componentes Principais do Transformer
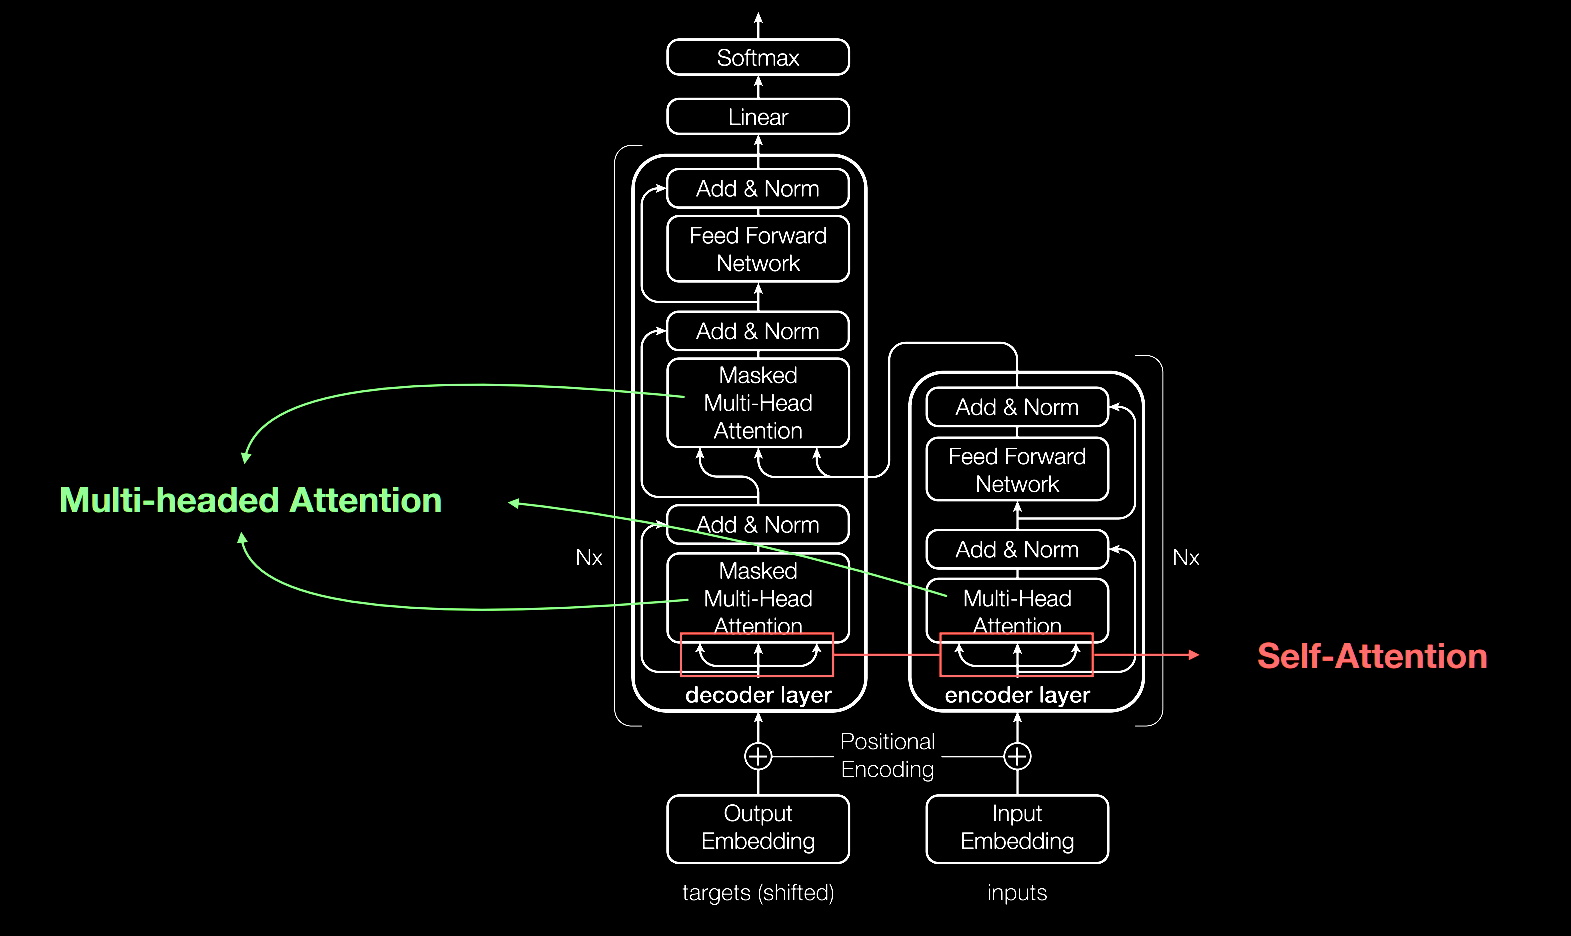
- Encoder: Responsável por processar a entrada de texto e convertê-la em representações vetoriais. Cada camada do encoder utiliza mecanismos de autoatenção para entender o contexto.
- Decoder: Gera a sequência de saída com base na representação codificada pelo encoder. Durante a geração do texto, utiliza mais uma vez a atenção para focar em partes relevantes da entrada.
- Mecanismo de Atenção: No centro do Transformer, este mecanismo calcula “queries”, “keys” e “values” para avaliar a importância de cada palavra no contexto global da frase.
- Embedding e Positional Encoding: Os tokens de entrada são convertidos em vetores contínuos de alta dimensão. O Positional Encoding adiciona informações sequenciais para preservar a ordem dos tokens.
Tabela Comparativa: RNN vs. Transformer
| Característica | RNN/LSTM | Transformer |
|---|---|---|
| Processamento | Sequencial | Paralelo |
| Captação de Dependências | Dificuldade com dependências longas | Eficiente com autoatenção |
| Velocidade de Treinamento | Mais lento | Mais rápido com paralelismo |
| Escalabilidade | Limitada | Altamente escalável |
4. Estrutura e Funcionamento dos LLMs
Construindo um LLM
A estrutura de um Large Language Model é composta por várias camadas de transformadores empilhados, permitindo que o modelo aprenda representações cada vez mais abstratas da linguagem. A seguir, destacamos os principais componentes:
Componentes Estruturais
- Camada de Entrada: Converte o texto em vetores utilizando técnicas de embedding e adiciona o Positional Encoding para reconhecer a posição dos tokens.
- Camadas de Encoder: Processam a entrada utilizando o mecanismo de autoatenção. Cada camada refina a representação textual, identificando relações contextuais relevantes.
- Camadas de Decoder: São utilizadas principalmente em modelos geradores de texto. Cada camada do decoder foca na geração do próximo token com base no contexto fornecido pelo encoder.
- Camada de Saída: Transforma a representação final em uma distribuição de probabilidade sobre o vocabulário, permitindo escolher a palavra seguinte.
Fases do Funcionamento dos LLMs
1. Pré-Treinamento
Nesta fase, o modelo é exposto a enormes conjuntos de dados textuais. Utilizando algoritmos como a redução de perda de entropia cruzada, o modelo aprende os padrões linguísticos e relações semânticas do idioma. Essa etapa prepara o modelo para uma vasta gama de tarefas.
2. Ajuste Fino (Fine-Tuning)
Após o pré-treinamento, o LLM passa pelo ajuste fino, onde é treinado em tarefas específicas, como tradução, sumarização ou análise de sentimentos. Este processo personaliza o modelo para contextos e aplicações particulares, aumentando sua precisão em tarefas especializadas.
3. Geração e Inferência
Uma vez treinado, o LLM pode ser implementado para gerar texto ou executar outras tarefas de processamento da linguagem. Durante a inferência, o modelo recebe uma entrada textual, processa essa informação e gera saídas que podem variar desde respostas a perguntas até resumos de documentos.
5. Principais Aplicações dos LLMs
Casos de Uso e Exemplos Práticos
A versatilidade dos Large Language Models se reflete em diversas aplicações que impactam tanto o uso cotidiano quanto indústrias específicas. Algumas aplicações notáveis incluem:
- Geração de Texto: Ferramentas como ChatGPT geram respostas e conteúdos literários com fluidez comparável à escrita humana.
- Tradução Automática: Modelos como T5 e outros utilizam a estrutura do Transformer para traduzir textos com alta precisão.
- Resumo de Documentos: Algoritmos capazes de condensar vastos conteúdos informativos em resumos objetivos.
- Análise de Sentimentos: Extraem a essência emocional de textos, identificando se o conteúdo é positivo, negativo ou neutro.
- Chatbots e Assistentes Virtuais: Aplicações que proporcionam interação natural e intuitiva com usuários, melhorando a experiência no atendimento digital.
6. Considerações Éticas e Limitações
Responsabilidade no Uso dos LLMs
Apesar de seu potencial revolucionário, os LLMs apresentam desafios e limitações que precisam ser considerados:
- Vieses nos Dados: Como os modelos são treinados com grandes volumes de dados da internet, podem refletir e até amplificar vieses existentes, exigindo supervisão rigorosa na sua aplicação.
- Questões de Privacidade: A utilização de dados pessoais requer políticas de privacidade e conformidade com regulações como o GDPR.
- Uso Responsável: O risco de disseminação de informações incorretas ou prejudiciais aumenta, sendo essencial o monitoramento ético e a implementação de salvaguardas.
- Demanda Computacional: O treinamento e a inferência dos LLMs exigem alto poder computacional, o que pode limitar sua acessibilidade e impacto ambiental.
7. Ferramentas de Ensino e Materiais de Apoio
Uso de Diagramas e Exemplos Visuais
Para facilitar a compreensão dos conceitos abordados, recomenda-se o uso de diagramas e esquemas ilustrativos. A seguir, um exemplo de tabela que organiza os principais componentes do Transformer e suas funções:
Tabela: Componentes do Transformer
| Componente | Função |
|---|---|
| Embedding | Converte tokens em vetores numéricos |
| Positional Encoding | Adiciona informações de posição aos vetores |
| Multi-Head Attention | Avalia a importância de cada token dentro de um contexto global |
| Feed Forward | Aplica transformações não lineares para refinar as representações |
8. Discussão e Interação
Perguntas e Respostas
Ao final da apresentação, abra espaço para perguntas para garantir que os alunos assimilem os conceitos abordados. Incentive discussões sobre:
- Comparação entre arquiteturas tradicionais e modernas.
- Desafios éticos e implicações sociais do uso de LLMs.
- A evolução dos LLMs e as tendências para o futuro.
Referências
- Introdução aos LLMs – Cloud Skills Boost
- Curso Introdutório sobre LLMs – Codecademy
- Recursos sobre LLMs – Google Developers
- Glossário LLMs – NVIDIA
- O que são LLMs – Elastic
Recomendações
 aws.amazon.com
Last updated March 20, 2025