
Подробная инструкция по настройке среды для тренировки LLM на PyTorch
Практическое руководство к установке, настройке и оптимизации
Основные моменты
- Установка и конфигурация PyTorch – подготовка правильной версии с поддержкой CUDA и DirectML.
- Настройка виртуального окружения – использование Miniconda или среды Python для изоляции зависимостей.
- Тонкая настройка и оптимизация – применение методов оптимизации, таких как LoRA, QLoRA, квантизация и распределенное обучение.
Введение
В эпоху стремительного развития больших языковых моделей (LLM), настройка оптимальной среды для их обучения и дообучения стала одной из приоритетных задач для исследователей и разработчиков. Эта инструкция предназначена для создания полноценного окружения, которое позволяет эффективно тренировать LLM с использованием PyTorch. Мы подробно рассмотрим установку необходимых инструментов, поддержку CUDA или DirectML (для Windows), подготовку данных, настройку модели и методы оптимизации, направленные на снижение потребления памяти при обучении. Руководство актуально на февраль 2025 года и рассчитано на пользователей, работающих как на системах Linux (Ubuntu), так и на платформах типа WSL-Ubuntu и Windows.
Шаг 1. Подготовка системы
Выбор оборудования и ОС
Для тренировки LLM требуется мощное вычислительное оборудование и корректно настроенная операционная система. Рекомендуется:
- ОС: Linux (например, Ubuntu 20.04 или новее) или Windows с использованием WSL-Ubuntu для гибкости работы с командной строкой.
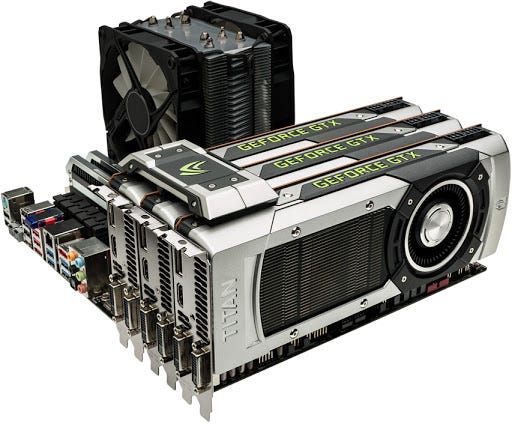
- GPU: CUDA-совместимый графический процессор. Для высокопроизводительных вычислений отлично подходят GPU типа Tesla A100, NVIDIA RTX серии или аналогичные.
- Память: Объём оперативной памяти не менее 16 Гб, хотя для больших моделей рекомендуется 32 Гб и более.
- Хранение данных: Быстрые SSD накопители для хранения и быстрого доступа к данным.
Установка драйверов и библиотек для GPU
Прежде чем приступить к установке PyTorch, убедитесь, что у вас установлены соответствующие драйверы для GPU, а также программное обеспечение CUDA и cuDNN. Для пользователей Windows можно воспользоваться DirectML совместно с PyTorch для оптимальной поддержки аппаратного ускорения. На Linux рекомендуется напрямую использовать CUDA.
Проверьте установку драйверов следующим образом:
# Проверка наличия GPU и версии CUDA
nvidia-smi
Шаг 2. Установка и настройка виртуального окружения
Использование Miniconda
Для изоляции зависимостей и обеспечения стабильности работы проекта рекомендуется создать виртуальное окружение с использованием Miniconda. Это позволит избежать конфликтов между пакетами и упрощает дальнейшее обновление или повторную установку необходимых библиотек.
Установка Miniconda
Для Linux выполните следующие команды:
# Скачивание установочного скрипта Miniconda
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh
# Запуск инсталляционного скрипта
bash Miniconda3-latest-Linux-x86_64.sh
Для Windows скачайте установочный файл с официального сайта Miniconda и следуйте инструкциям мастера установки.
Создание виртуального окружения
После установки Miniconda создайте и активируйте виртуальное окружение:
# Создание виртуального окружения с Python 3.11
conda create -n llm_env python=3.11 -y
# Активация окружения (Linux/Mac)
conda activate llm_env
# На Windows команда:
llm_env\Scripts\activate
Шаг 3. Установка PyTorch и основных библиотек
Установка PyTorch
PyTorch является основой для тренировки LLM. Важно выбрать версию, совместимую с вашим оборудованием и версией CUDA. На момент 2025 года актуальная версия – 2.2.0. Вы можете установить PyTorch через conda или pip в зависимости от ваших предпочтений.
Установка для Linux через conda
Если у вас CUDA 12.1:
# Для CUDA 12.1
conda install pytorch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
Если используется CUDA 11.8:
# Для CUDA 11.8
conda install pytorch torchvision torchaudio pytorch-cuda=11.8 -c pytorch -c nvidia
Установка для Windows через PyPi (с DirectML при необходимости)
Для Windows можно установить PyTorch с поддержкой DirectML. Выполните команду:
pip install torch --no-cache-dir
pip install torch-directml  # для DirectML если необходимо
Установка дополнительных библиотек
Помимо PyTorch вам понадобится ряд библиотек для работы с языковыми моделями, оптимизацией и оценки качества модели. Ниже приведены основные библиотеки:
| Библиотека | Назначение | Команда установки |
|---|---|---|
| transformers | Работа с предобученными языковыми моделями | pip install transformers |
| datasets | Загрузка и управление датасетами | pip install datasets |
| evaluate | Метрики и оценка моделей | pip install evaluate |
| torchtext | Работа с текстовыми данными | pip install torchtext |
| torchtune | Оптимизация обучения и памяти | pip install torchtune |
| torchao | Квантизация и оптимизация | pip install torchao |
| accelerate | Ускорение распределенного обучения | pip install accelerate |
| trl | Обучение с подкреплением для LLM | pip install trl |
Выполните соответстующие команды установки в вашем виртуальном окружении после активации:
pip install transformers datasets evaluate torchtext torchtune torchao accelerate trl
Шаг 4. Подготовка данных для обучения
Сбор и предварительная обработка данных
Для успешного обучения LLM необходимо подготовить большой и качественный корпус данных. Обычно для этого используются датасеты с платформ Hugging Face, специализированные коллекции текстов или текстовые корпуса, собранные из интернета. Обратите внимание, что качество и разнообразие данных напрямую влияет на итоговую производительность модели.
Пример загрузки датасета из репозитория Hugging Face:
from datasets import load_dataset

# Загрузка стандартного корпуса данных
dataset = load_dataset("wikitext", "wikitext-103-raw-v1")
Процесс токенизации данных с использованием токенизатора из библиотеки transformers выглядит следующим образом:
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Salesforce/xgen-7b-8k-base")
def tokenize_function(examples):
    return tokenizer(examples["text"], truncation=True, padding="max_length", max_length=512)

tokenized_dataset = dataset.map(tokenize_function, batched=True)
Форматирование и организация данных
Кроме предобработки, данные должны быть систематизированы для корректного обучения. Датасеты делятся на тренировочные, валидационные и тестовые выборки. Это позволяет проводить оценку модели на контролируемых данных и корректировать гиперпараметры.
Рекомендуется использовать файл requirements.txt для фиксации версий пакетов, что обеспечивает воспроизводимость экспериментов.
Шаг 5. Настройка и загрузка модели
Выбор предобученной модели
Hugging Face предоставляет множество предобученных языковых моделей, которые можно дообучать под конкретные задачи. Пример загрузки модели:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Salesforce/xgen-7b-8k-base"
model = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)
При выборе модели следует учитывать как размер, так и архитектурные особенности, особенно если вы планируете дообучение или тонкую настройку (fine-tuning).
Настройка методов оптимизации
Оптимизация гиперпараметров
Эффективное дообучение модели требует подбора правильных гиперпараметров. Основные параметры включают:
- Скорость обучения (learning rate): Обычно стартует в районе 5e-5 и корректируется в зависимости от ответа модели.
- Размер батча (batch size): В зависимости от доступной памяти GPU, обычно от 4 до 16 для тренировочных процессов.
- Количество эпох: Обычно 3-5 эпох достаточно для качественного дообучения, однако итоговое число зависит от сложности задачи.
- Warmup steps: Параметр, помогающий смягчить начальное обучение модели.
- Weight decay: Регуляризатор для борьбы с переобучением.
Тонкая настройка (Fine-Tuning) с использованием LoRA и QLoRA
Для экономии аппаратных ресурсов и упрощения процесса адаптации модели можно воспользоваться методами динамической настройки:
- LoRA (Low-Rank Adaptation): Позволяет обновлять лишь небольшую часть параметров модели, тем самым снижая затраты памяти.
- QLoRA (Quantized LoRA): Позволяет проводить дообучение с использованием квантизации, снижая точность до 8 бит или даже ниже, что уменьшает нагрузку на GPU.
Эти методы позволяют тренировать большие модели на оборудовании с ограниченными ресурсами.
Шаг 6. Обучение модели
Настройка аргументов тренировки
Используя библиотеку transformers и класс Trainer, можно настроить процесс обучения с нужными гиперпараметрами. Пример конфигурации:
from transformers import TrainingArguments, Trainer

training_args = TrainingArguments(
    output_dir="./results",
    num_train_epochs=3,
    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,
    warmup_steps=500,
    weight_decay=0.01,
    logging_dir='./logs',
    logging_steps=10,
    evaluation_strategy="epoch",
    save_total_limit=2,
    learning_rate=5e-5,
)
Эти аргументы можно дополнить и настроить в зависимости от специфики вашего проекта.
Запуск тренировки
После подготовки данных и настройки модели можно приступить к тренировке. Пример использования класса Trainer:
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["validation"],
    # Функция для вычисления метрики, например, точности
    compute_metrics=lambda pred: {"accuracy": (pred.predictions.argmax(-1) == pred.label_ids).mean()}
)

trainer.train()
Шаг 7. Распределенное обучение и оптимизация
Использование распределенного обучения (DDP)
При наличии нескольких GPU можно ускорить обучение, используя механизмы распределенного обучения.
Настройка DDP в PyTorch
Для инициализации распределенного обучения выполните:
import torch.distributed as dist

# Инициализация группы процессов с использованием NCCL (для Linux)
dist.init_process_group("nccl", init_method="env://")
# Оборачиваем модель в DistributedDataParallel (DDP)
from torch.nn.parallel import DistributedDataParallel
model = DistributedDataParallel(model)
После завершения тренировки обязательно разрушьте созданную группу:
dist.destroy_process_group()
Оптимизация памяти
Для уменьшения потребления памяти существуют несколько методов, позволяющих эффективно оптимизировать процесс тренировки:
- Использование квантизации (снижение точности весов с 16 бит до 8, 4 или 2 бит) – снижает потребляемую память и ускоряет вывод модели.
- Применение оптимизаторов, таких как FusedAdam или FusedLAMB, для ускорения и стабилизации обучения.
- Использование библиотек типа torchtune и torchao для динамического управления использованием памяти.
Шаг 8. Тестирование и сохранение обученной модели
Проведение тестирования
После завершения обучения необходимо проверить работоспособность и оценить качество модели. Используйте следующий пример для генерации текста:
input_text = "Пример запроса для генерации текста."
inputs = tokenizer(input_text, return_tensors="pt")
outputs = model.generate(**inputs)
generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated_text)
Это позволит удостовериться, что модель корректно обучена и готова к использованию.
Сохранение модели
Для дальнейшего использования модели необходимо сохранить веса и конфигурации:
model.save_pretrained("./my_trained_model")
tokenizer.save_pretrained("./my_trained_model")
Сохранённая модель может быть загружена позже для инференса или дальнейшей дообучения.
Шаг 9. Дополнительные рекомендации и техники оптимизации
Использование PyTorch Lightning
Для упрощения процесса тренировки можно использовать PyTorch Lightning – высокоуровневый фреймворк, который упрощает процедуру обучения, валидации и тестирования модели. Этот инструмент позволяет абстрагироваться от рутинных задач и сосредоточиться на настройке гиперпараметров и архитектурных решениях.
Сбор и анализ метрик
Регулярный мониторинг метрик, таких как точность, потери и время обучения, позволяет обнаружить проблемы на ранней стадии. Для этого можно настроить логирование с использованием библиотеки logging в Python или специализированных инструментов визуализации, таких как TensorBoard.
Автоматизация процессов
Организация обучения с помощью скриптов и планировщиков задач позволяет автоматизировать повторяющиеся процессы, такие как обновление модели или запуск тренировки на новой выборке данных. Используйте файлы настроек (requirements.txt и config.json) для интеграции в CI/CD пайплайны, что помогает обеспечить воспроизводимость экспериментов.
Таблица сравнения установки PyTorch для разных платформ
| Платформа | Установка | Поддерживаемые версии CUDA/DirectML |
|---|---|---|
| Linux (Ubuntu) |
|
11.8, 12.1 |
| WSL-Ubuntu |
|
11.8, 12.1 |
| Windows (DirectML) |
|
DirectML (альтернатива CUDA) |
Заключение
Настройка среды для тренировки больших языковых моделей на PyTorch требует комплексного подхода, охватывающего подготовку оборудования, создание виртуального окружения, установку основного и вспомогательного программного обеспечения, а также оптимизацию процесса обучения и тонкую настройку модели. В этой инструкции описаны все важные шаги, начиная от установки Miniconda и PyTorch, до настройки распределенного обучения с использованием DDP, методами оптимизации памяти, тонкой настройки с применением LoRA/QLoRA и использования специализированных инструментов для мониторинга метрик.
Благодаря выполнению этих шагов вы получите надежное и масштабируемое окружение для проведения исследований и тренировки LLM. Такой подход позволяет сократить время на настройку инфраструктуры и сосредоточиться на разработке алгоритмов, экспериментировании с гиперпараметрами, а также на интеграции результатов в реальные приложения.
Итоговая система не только обеспечивает эффективное использование ресурсов, но и предоставляет гибкость для проведения дальнейших экспериментов, что особенно важно в быстро меняющемся мире искусственного интеллекта. Обязательно проверяйте совместимость версий используемых библиотек и обновляйте настройки в соответствии с последними рекомендациями из официальной документации, поскольку разработки в области LLM продолжают активно развиваться.
Рекомендации для дальнейшего изучения
Помимо базовой установки и тренировки модели, будет полезно изучить дополнительные методы и технологии, которые могут повысить производительность и точность языковых моделей:
- Углублённое изучение оптимизации модели: Рассмотрите возможность интеграции таких методов, как смешанное обучение (mixed precision training) и распределённая валидация.
- Рассмотрение альтернативных фреймворков: Изучите PyTorch Lightning для упрощения процесса разработки и управления экспериментами.
- Тестирование и валидизация в продакшен-среде: Изучите практики интеграции обученной модели в системы реального времени с использованием API и серверных решений.
Заключительные мысли
Руководство представляет собой полный цикл, начиная с подготовки оборудования и завершения сохранением обученной модели. Важно понимать, что каждая стадия процесса, от подбора гиперпараметров до использования распределенного обучения, влияет на конечное качество языковой модели. Благодаря данному пошаговому подходу вы сможете не только настроить оптимальную среду для исследования и разработки, но и существенно ускорить процесс эксперимента за счёт эффективного использования ресурсов.
Успешное выполнение всех этапов поможет обеспечить стабильную работу и высокую производительность, а также откроет возможности для последующих доработок и интеграции модели в прикладные решения. Регулярно следите за обновлениями в официальной документации и профильных ресурсах, чтобы оставаться в курсе новейших достижений в области тренировки LLM.
Заключение и финальные мысли
В данной инструкции были рассмотрены ключевые аспекты настройки среды для тренировки больших языковых моделей на PyTorch. Мы подробно разобрали подготовку аппаратного и программного обеспечения, создание виртуального окружения, установку базовых и вспомогательных библиотек, а также методы оптимизации, такие как подбор гиперпараметров, тонкая настройка с использованием LoRA/QLoRA и распределенное обучение. Такой системный подход позволяет обеспечить высокую эффективность тренировочного процесса, минимизируя затраты ресурсов и улучшая качества обученной модели.
Рекомендуется регулярно обновлять используемые инструменты и библиотеки, придерживаясь актуальной информации из официальной документации. Такой подход позволит сохранить актуальность и конкурентоспособность разработанной модели, что особенно важно в условиях быстрого развития технологий искусственного интеллекта.
Ссылки на источники
- Как обучить ML-модель на PyTorch - Tproger
- LLM PyTorch Installation Guide - GregPauloski
- PyTorch с DirectML в Windows - Microsoft
- Настройка окружения в WSL-Ubuntu - Obnimorda
- Руководства по установке LLM - Cloud.ru
- Оптимизация вывода LLM - PyTorch Blog
- Обучение LLM с PyTorch - DataCamp
-
Тонкая настройка LLM для 2025 года - Zephyrnet
Рекомендации для дальнейших запросов
Last updated February 22, 2025