
解鎖文件智慧:探索最適合OCR的開源視覺語言模型 (VLLM)
深入剖析頂尖開源VLLM,助您高效完成文件光學字元辨識任務。
在數位化浪潮席捲全球的今天,如何從各式文件中精準、高效地提取資訊,已成為企業與個人不可或缺的能力。視覺語言模型(Vision Language Models, VLM),特別是與高效推理框架(如 vLLM)結合時,為文件光學字元辨識(OCR)帶來了革命性的進展。這些模型不僅能辨識文字,更能理解圖像內容與文件結構,提供遠超傳統OCR的深層次文件理解能力。本文將為您詳細介紹當前最適合文件OCR的開源VLLM。
核心亮點
- 頂尖性能模型:以 Qwen-2.5 系列為代表的高性能模型,在處理複雜文件和結構化數據方面表現卓越。
- 高效部署框架:vLLM 框架的應用顯著提升了VLLM在OCR任務中的推理效率和吞吐量,使得本地部署和規模化應用成為可能。
- 多元選擇應對不同需求:從追求極致精準度的大型模型到兼顧資源效益的輕量級模型,開源社群提供了豐富選擇,滿足不同場景下的OCR需求。
VLLM在文件OCR中的革命性角色
不僅是文字辨識,更是深層理解
傳統OCR技術主要集中於從圖像中提取文字字串,但在理解文件佈局、表格結構、手寫內容以及圖文混合的複雜場景時,往往力有未逮。VLLM的出現彌補了這些不足。它們融合了電腦視覺的圖像理解能力和自然語言處理的文本分析能力,能夠:
- 上下文理解:VLLM能理解文字在文件中的空間位置和語義關聯,例如辨識標題、段落、列表和註腳。
- 結構化資訊擷取:對於發票、表單、報告等文件,VLLM能更準確地識別欄位名稱和對應值,實現結構化數據提取。
- 處理複雜版面:面對多欄排版、圖文混排、手寫筆記等複雜情況,VLLM展現出更強的適應性和魯棒性。
- 端到端文件理解:部分VLLM不僅提取文字,還能進行摘要、問答、分類等後續處理,實現真正的端到端文件智能。
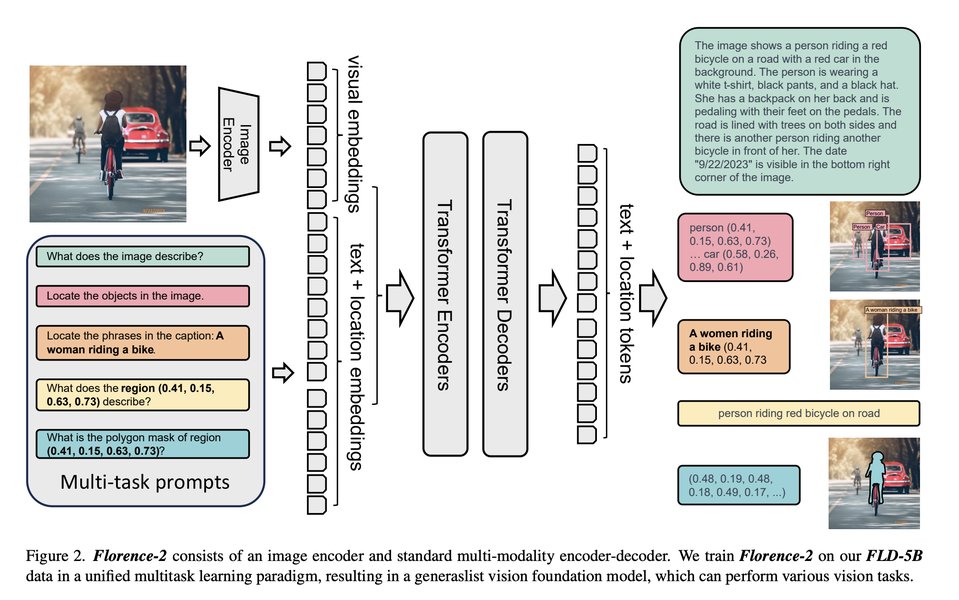
視覺語言模型結合圖像與文字處理能力
領先的開源VLLM模型推薦
針對文件OCR任務,以下幾款開源VLLM模型因其卓越的性能和活躍的社群支持而備受關注:
1. Qwen-2.5 系列 (通義千問視覺語言模型)
高性能的OCR首選
阿里巴巴開發的Qwen-2.5系列,特別是其視覺語言版本(如Qwen-2.5-VL, Qwen-VL-7B-Instruct)及其更大參數量的模型(如Qwen-2.5-72B-Chat-VL),在多項OCR基準測試中名列前茅。它們具備以下優勢:
- 高解析度圖像處理:能夠處理高畫質的掃描文件和圖片。
- 多語言支援:支援超過30種語言的文字辨識。
- 結構化數據理解:在辨識表格、表單等結構化內容方面表現突出,幻覺率低。
- 工具整合:衍生出如 olmOCR 和 RolmOCR 等專為PDF和圖片設計的OCR工具,這些工具基於Qwen模型,簡化了部署流程,並能保留文件原有格式。RolmOCR更強調低記憶體佔用和處理速度。
考量:大型模型(如72B版本)對硬體資源(尤其是GPU記憶體,可能需要48GB VRAM以上)要求較高,但其性能回報也相對豐厚。
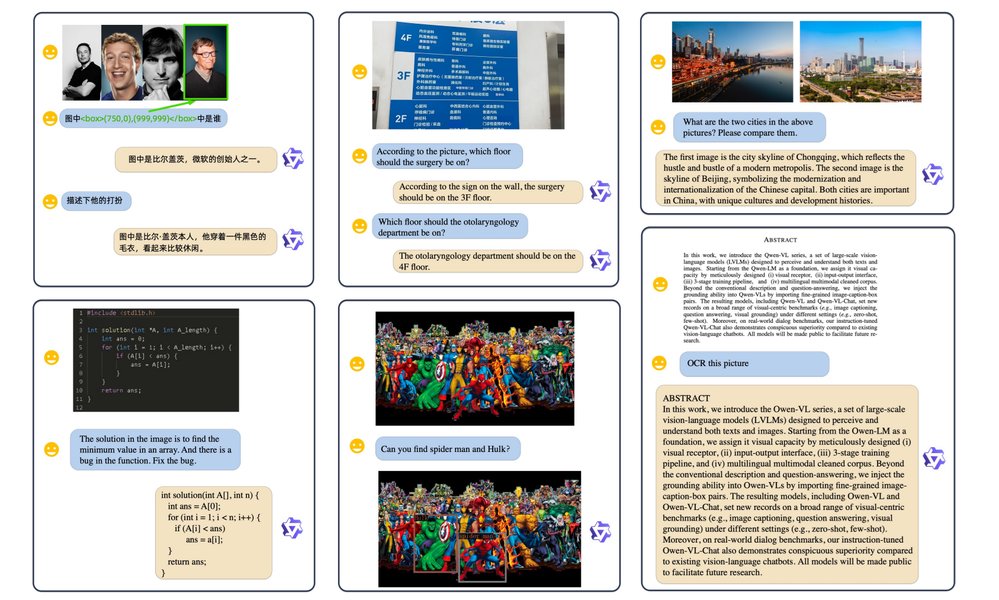
Qwen-VL模型進行視覺問答與OCR的示例
2. Llama 3 Vision 系列 (Meta)
強大的多模態指令遵循能力
Meta推出的Llama 3系列視覺指令模型(如 Llama-3.2-11B Vision-Instruct 和 Llama-3.2-90B Vision-Instruct)是另一強勁的開源選擇。它們的特點包括:
- 多模態任務處理:不僅限於OCR,還能進行視覺問答、圖像描述等。
- 指令遵循:能根據用戶指令精準執行OCR及後續的語義處理任務。
- vLLM整合:易於與vLLM框架結合,實現高效推理和批量文件處理。
- 泛化能力:在處理多樣化的文件類型和語言時表現出良好的泛化性。
考量:大型版本同樣需要較高的硬體配置,但較小版本(如11B)在資源消耗和性能間取得了良好平衡。
3. Mistral OCR
專為OCR優化的新星
Mistral AI開發的Mistral OCR模型,專為光學字元辨識進行了優化,並在近期基準測試中展現了優異性能:
- 結構化輸出:特別擅長將提取的文字以JSON等結構化格式輸出,方便後續數據處理。
- 高效整合:與vLLM等推理框架能良好整合,實現快速文件處理。
- 易用性:對於初學者和資源相對有限的用戶而言,是一個友好的選擇。
考量:雖然在多語言支援上可能不如Qwen全面,但對於英文等主流語言的文件OCR任務,效率很高。
4. Florence-2 (Microsoft)
輕量級且精準的選擇
微軟開源的Florence-2是一個輕量級的視覺語言模型,其設計使其在保持較高OCR準確率的同時,對資源需求相對較低:
- 輕量化設計:適合部署於資源受限的環境,如邊緣計算設備。
- 高準確性:在多項OCR任務中展現了良好的文字辨識準確率。
考量:在處理極其複雜或高度結構化的文件時,可能不如大型模型全面,但其平衡性使其成為一個有吸引力的選項。
5. 其他值得關注的模型
- Moondream2:在準確性方面表現良好,常被視為Qwen系列的有力競爭者。
- Idefics2:一款被廣泛提及可用於OCR任務的開源VLM。
- PaliGemma / Gemma-3:Google開發的Gemma系列模型,其中PaliGemma定位輕量級,Gemma-3 (如27B版本) 在多模態文件數據抽取方面表現穩健。
- DeepSeek-VL:在多模態OCR和語義搜索方面被認為是優秀的解決方案。
- Docling / SmolDocling:Docling支持多種大型模型進行PDF解析和OCR,而SmolDocling則是其超小型版本,專為高效文件轉換設計。
關鍵模型特性比較雷達圖
為了更直觀地比較幾款主流開源VLLM在文件OCR任務中的特性,我們製作了以下雷達圖。評估維度包括準確性、速度、資源友好度(越高表示資源需求越低)、多語言能力、結構化數據處理能力以及易用性。這些評分是基於綜合分析得出的相對比較,實際表現可能因具體應用場景和部署方式而異。
輔助工具與框架:提升VLLM OCR效率
選擇合適的模型固然重要,但高效的部署和推理框架同樣關鍵。在這方面,vLLM 扮演了核心角色。
vLLM:高效能LLM/VLM推理服務框架
vLLM 是一個開源函式庫,專為大型語言模型和視覺語言模型的推理提供加速。其主要優勢包括:
- PagedAttention機制:有效管理GPU記憶體,減少浪費,提高批次處理能力。
- 持續批次處理(Continuous Batching):優化請求調度,顯著提升吞吐量。
- 低延遲:即使在高負載情況下也能保持較低的響應延遲。
- 模型兼容性:支援眾多主流的開源LLM和VLM,包括Qwen、Llama等。
許多教程和項目(如olmOCR和RolmOCR)都展示瞭如何利用vLLM來部署VLM以進行OCR任務,從而實現高性能、低成本的本地化解決方案。
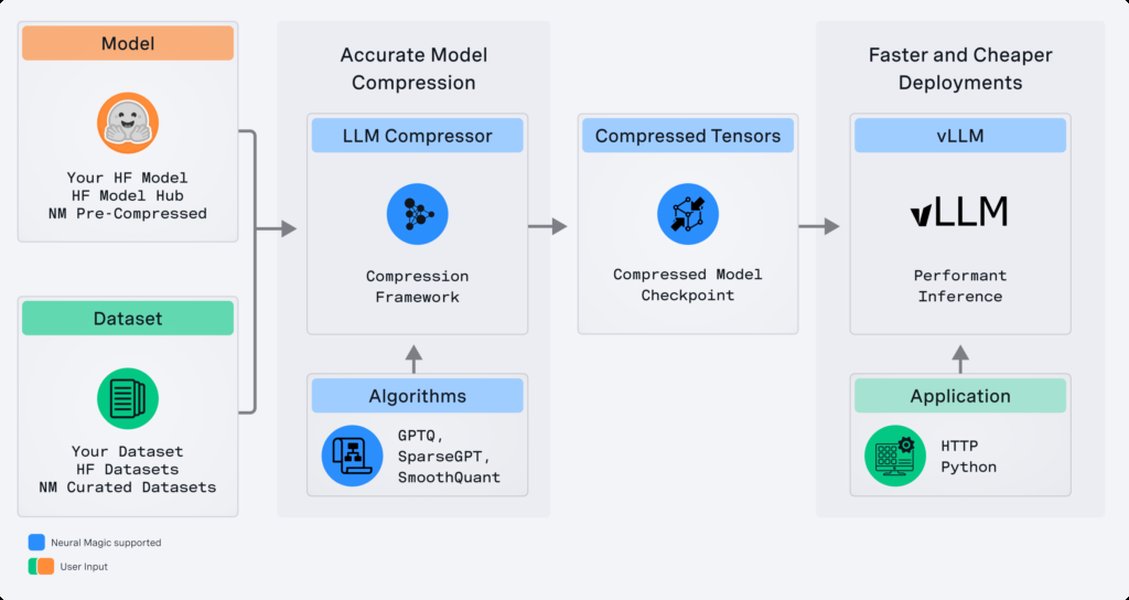
vLLM等框架透過記憶體優化等技術提升模型推理效率 (示意圖)
其他相關工具
- OCRInsight:一個模組化框架,允許整合多種開源OCR引擎(如Tesseract, EasyOCR, PaddleOCR)和LLM/VLM,以提升結構化文字解析能力。
- Hugging Face Transformers:提供了大量預訓練模型和便捷的API,是獲取和初步測試VLM的常用平台。
- Gradio / Streamlit:用於快速搭建具有圖形用戶界面(GUI)的OCR VLLM演示應用,方便互動測試和成果展示。
主要開源VLLM模型特性總覽表
下表總結了幾款主流開源VLLM在文件OCR應用中的關鍵特性,幫助您根據具體需求進行選擇:
| 模型名稱 | 主要特性 | OCR強項 | 典型用途 | 資源考量 |
|---|---|---|---|---|
| Qwen-2.5 系列 (如 72B-VL) | 高解析度、多語言、低幻覺 | 複雜文件、表格、結構化數據提取 | 商業文件、學術論文、多語言文件處理 | 高 (需強力GPU, >48GB VRAM) |
| Qwen-VL (如 7B) / olmOCR / RolmOCR | 基於Qwen,優化PDF/圖像處理,RolmOCR更輕量 | 保留格式、手寫筆記、多欄佈局 | 日常文件掃描、筆記數位化 | 中等 (RolmOCR相對較低) |
| Llama 3 Vision 系列 (如 90B/11B) | 多模態指令遵循、良好泛化性 | 圖像文字提取、與vLLM高效整合 | PDF/圖像文字提取、批量處理 | 高 (90B) / 中 (11B) |
| Mistral OCR | 專為OCR優化、擅長結構化輸出 (JSON) | 文件解析、向量資料庫輸入 | 需要結構化輸出的應用、快速原型開發 | 中等 (可在48GB VRAM運行) |
| Florence-2 | 輕量級設計、高準確性 | 通用文字辨識、速度與準確性平衡 | 資源受限環境、邊緣計算OCR | 低 |
| Gemma-3 (27B) / PaliGemma | Gemma-3性能穩健,PaliGemma輕量可攜 | 多模態文件數據抽取 (Gemma-3) | 中等複雜度文件 (Gemma-3)、快速部署 (PaliGemma) | 中 (Gemma-3) / 低 (PaliGemma) |
VLLM OCR生態系統心智圖
下圖展示了圍繞開源VLLM進行文件OCR的相關技術、模型和考量因素,幫助您建立一個整體的認知框架:
(Qwen-2.5-72B, Qwen-VL)"] id2["Llama 3 Vision 系列"] id3["Mistral OCR"] id4["Florence-2"] id5["其他 (Moondream2, PaliGemma, DeepSeek-VL, Docling)"] sub2["核心優勢"] id6["上下文理解與語義推理"] id7["端到端文件處理能力"] id8["精準的結構化資料提取"] id9["處理複雜版面與多語言"] sub3["輔助工具與框架"] id10["vLLM (高效推理服務)"] id11["OCRInsight (多引擎整合)"] id12["Hugging Face (模型庫與API)"] id13["Gradio/Streamlit (快速GUI搭建)"] sub4["關鍵考量因素"] id14["硬體資源 (GPU記憶體與算力)"] id15["特定任務的準確性需求"] id16["模型部署與維護的複雜度"] id17["文件類型與質量 (掃描清晰度、手寫等)"] id18["成本效益分析 (開源 vs. 商業API)"]
實戰演示:Qwen2-VL 模型OCR與視覺問答
Qwen2-VL 是 Qwen 系列中一個強大的視覺語言模型,非常適合OCR和視覺問答 (VQA) 任務。以下影片將演示如何使用 Qwen2-VL 進行光學字元辨識、視覺問答等操作。透過這個演示,您可以更直觀地了解這類模型在實際應用中的能力,以及它們如何處理圖像中的文字資訊並根據視覺內容回答問題。這對於理解VLLM在文件處理上的潛力非常有幫助。
影片演示:使用Qwen2-VL進行OCR和視覺問答
常見問題 (FAQ)
什麼是VLLM在文件OCR中的角色?
VLLM(視覺語言大型模型)在文件OCR中不僅僅是辨識文字。它們結合了電腦視覺的圖像理解能力和自然語言處理的文本分析能力,能夠理解文件佈局、表格結構、圖文關係,並進行語義推理。這使得VLLM能夠更準確地從複雜文件中提取資訊,處理手寫內容,並進行結構化數據提取,超越了傳統OCR僅限於文字轉換的功能。
選擇開源VLLM模型進行OCR時應考慮哪些因素?
選擇VLLM模型時應綜合考慮以下因素:
- 準確性:模型在您的特定文件類型和語言上的辨識準確率。
- 速度:模型的推理速度,尤其是在批量處理大量文件時。
- 硬體資源:模型對GPU記憶體和計算能力的要求,以及您的可用資源。
- 多語言支援:如果需要處理多種語言的文件,模型的語言覆蓋範圍很重要。
- 結構化數據處理能力:對於表格、表單等文件,模型提取結構化資訊的能力。
- 易用性與社群支援:模型的部署難度、API友好性以及是否有活躍的社群提供支持。
- 成本:雖然是開源模型,但運行大型模型可能帶來較高的硬體和維護成本。
vLLM庫如何幫助進行OCR任務?
vLLM是一個專為大型語言模型(包括視覺語言模型)設計的高效推理和服務函式庫。它透過以下方式幫助OCR任務:
- 提升吞吐量:採用PagedAttention和持續批次處理等技術,顯著提高單位時間內處理文件的數量。
- 降低延遲:優化推理過程,減少單個文件的處理時間。
- 高效記憶體管理:減少GPU記憶體的浪費,使得在有限資源下運行更大的模型或處理更多請求成為可能。
- 簡化部署:為多種流行的VLM提供支援,方便開發者將這些模型應用於OCR系統。
總之,vLLM使得基於VLM的OCR解決方案在性能和效率上更具競爭力,尤其適合需要大規模部署的場景。
開源VLLM與傳統OCR工具有何不同?
主要區別在於理解的深度和處理複雜性的能力:
- 傳統OCR工具 (如Tesseract):主要側重於將圖像中的像素轉換為文字字元。它們在處理標準印刷體、佈局簡單的文件時效果較好,但對於手寫體、低質量圖像、複雜佈局或需要理解上下文的場景,準確性會下降。
- 開源VLLM:結合了視覺理解和語言理解。它們不僅辨識文字,還能理解文字的含義、文件結構(如表格、列表)、圖像內容以及圖文之間的關係。這使得VLLM能處理更複雜的文件,提取更豐富的資訊,並能執行如視覺問答、文件摘要等超越純文字提取的任務。
雖然傳統OCR在某些簡單場景下可能更快、更輕量,但VLLM在處理複雜文件和需要深度理解的OCR任務時,展現出明顯的優勢。
推薦探索
- 如何使用vLLM部署Qwen-VL模型進行PDF文件OCR?
- 比較不同開源VLLM在處理手寫文件OCR任務上的性能如何?
- 開源VLLM在發票和收據等結構化文件提取中的應用案例有哪些?
- 本地部署輕量級VLLM進行OCR的硬體需求與設定指南是什麼?
參考資料
Last updated May 18, 2025