
Révolutionner l'IA : Comment les Pipelines Transformers et l'Apprentissage par Transfert Démocratisent l'Intelligence Artificielle
Découvrez comment ces technologies synergiques accélèrent le développement et améliorent les performances des modèles d'IA.
L'intelligence artificielle (IA) a fait des progrès spectaculaires ces dernières années, en grande partie grâce à des approches innovantes comme l'apprentissage par transfert et à des outils puissants tels que les pipelines Transformers. Ces deux concepts, bien que distincts, travaillent souvent de concert pour rendre l'IA plus accessible, plus rapide à développer et plus performante, même avec des ressources limitées. Plongeons dans l'univers de ces technologies transformatrices.
Points Clés à Retenir
- Efficacité Accrue : L'apprentissage par transfert permet de réutiliser des modèles d'IA pré-entraînés sur de vastes ensembles de données, réduisant considérablement le temps de développement, les besoins en données et les coûts de calcul pour de nouvelles tâches.
- Accessibilité Simplifiée : Les pipelines Transformers, notamment ceux proposés par Hugging Face, offrent une interface conviviale pour utiliser ces modèles pré-entraînés pour une multitude de tâches (NLP, vision, audio) avec seulement quelques lignes de code, masquant la complexité sous-jacente.
- Performances Optimisées : En combinant l'apprentissage par transfert et les pipelines Transformers, les développeurs peuvent atteindre des performances de pointe sur des tâches spécifiques plus rapidement, même sans disposer d'énormes jeux de données ou d'une expertise approfondie en IA.
Comprendre l'Apprentissage par Transfert (Transfer Learning)
L'apprentissage par transfert est une technique d'intelligence artificielle (IA) et d'apprentissage automatique (machine learning) qui consiste à exploiter les connaissances acquises par un modèle lors de la résolution d'une tâche pour améliorer ses performances ou accélérer son apprentissage sur une tâche différente mais connexe. Au lieu d'entraîner un modèle à partir de zéro (ce qui peut nécessiter d'énormes quantités de données et de puissance de calcul), on réutilise un modèle déjà entraîné, souvent sur un très grand jeu de données généraliste.
Schéma illustrant le principe de l'apprentissage par transfert, où un modèle pré-entraîné sur une tâche source est adapté pour une nouvelle tâche cible.
Principes Fondamentaux et Fonctionnement
L'idée centrale est que les caractéristiques et les représentations apprises par un modèle sur une tâche source (par exemple, la reconnaissance d'objets courants dans des millions d'images) peuvent être utiles pour une nouvelle tâche cible (par exemple, l'identification de types spécifiques de fleurs avec un petit ensemble d'images).
Étapes typiques de l'apprentissage par transfert :
- Sélection d'un modèle pré-entraîné : On choisit un modèle performant, entraîné sur un vaste ensemble de données (par exemple, ImageNet pour la vision, ou de grands corpus de texte pour le NLP).
- Adaptation du modèle :
- Extraction de caractéristiques (Feature Extraction) : On utilise les premières couches du modèle pré-entraîné comme un extracteur de caractéristiques fixes. Seules les dernières couches, spécifiques à la nouvelle tâche, sont entraînées.
- Ajustement fin (Fine-tuning) : On ré-entraîne l'ensemble du modèle pré-entraîné (ou une partie de ses couches supérieures) sur le nouvel ensemble de données, mais avec un taux d'apprentissage généralement plus faible pour ne pas "oublier" les connaissances précieuses acquises précédemment. Certaines couches initiales peuvent être "gelées" pour préserver les caractéristiques génériques apprises.
Avantages et Applications
L'apprentissage par transfert offre plusieurs avantages significatifs :
- Réduction du temps d'entraînement : Partir d'un modèle pré-entraîné est beaucoup plus rapide que de commencer de zéro.
- Moins de données requises : Il permet d'obtenir de bons résultats même avec des ensembles de données limités pour la tâche cible, car le modèle a déjà appris des patrons généraux.
- Amélioration des performances : Les modèles pré-entraînés ont souvent appris des représentations robustes et généralisables qui peuvent améliorer la précision sur la nouvelle tâche.
- Réduction des ressources de calcul : Moins d'entraînement signifie moins de consommation d'énergie et de temps de calcul.
Cette technique est largement utilisée dans divers domaines de l'IA, notamment :
- Vision par ordinateur : Classification d'images, détection d'objets, segmentation sémantique.
- Traitement du Langage Naturel (NLP) : Analyse de sentiment, classification de texte, traduction automatique, réponse aux questions.
- Reconnaissance vocale : Adaptation de modèles de reconnaissance vocale à des accents ou des domaines spécifiques.
Andrew Ng, une figure influente de l'IA, a souligné que l'apprentissage par transfert serait l'un des prochains moteurs du succès commercial de l'apprentissage automatique.
Limites
L'efficacité de l'apprentissage par transfert dépend de la similarité entre la tâche source et la tâche cible. Si les tâches sont trop dissemblables, le transfert de connaissances peut être moins efficace, voire contre-productif (transfert négatif). Le choix judicieux du modèle pré-entraîné est donc crucial.
Les Pipelines Transformers : Simplifier l'Usage des Modèles d'IA
Les "Transformers" désignent une architecture de réseau de neurones profond qui a révolutionné de nombreux domaines de l'IA, en particulier le NLP. Des modèles comme BERT, GPT, et T5 sont basés sur cette architecture. La bibliothèque transformers de Hugging Face est devenue une ressource incontournable, donnant accès à des milliers de modèles Transformers pré-entraînés.
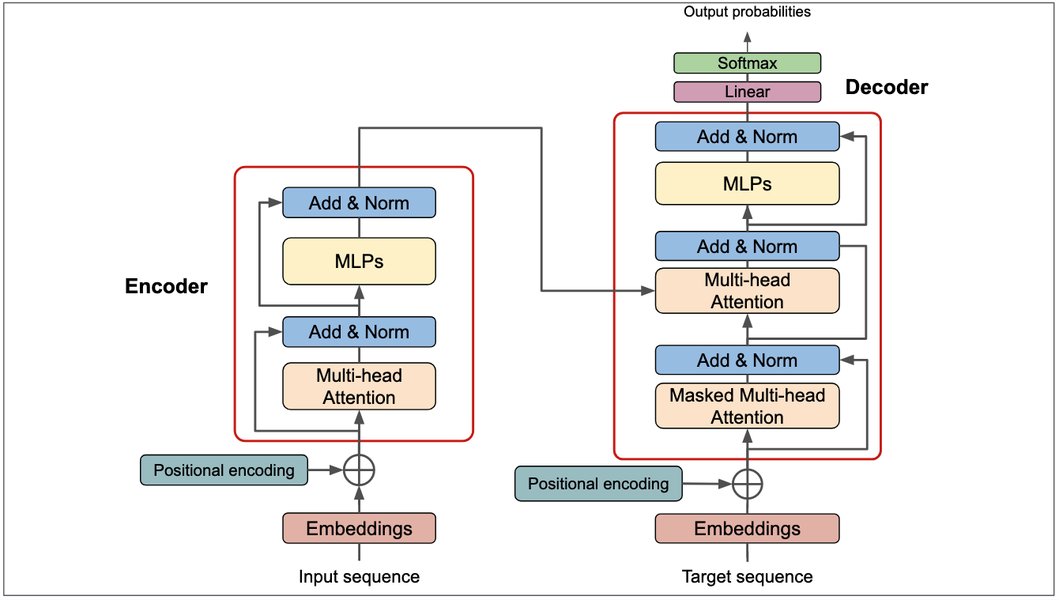
Diagramme illustrant l'architecture d'un modèle Transformer, montrant les mécanismes d'attention.
Les pipelines Transformers, proposés par Hugging Face, sont une interface de haut niveau qui simplifie énormément l'utilisation de ces modèles pré-entraînés pour l'inférence (c'est-à-dire faire des prédictions sur de nouvelles données). Ils encapsulent toutes les étapes complexes :
- Prétraitement des données : Tokenisation du texte, formatage des images, etc.
- Passage des données dans le modèle : Exécution du modèle pré-entraîné.
- Post-traitement des résultats : Conversion des sorties brutes du modèle en un format compréhensible et utilisable (par exemple, labels de classification, texte généré).
Fonctionnement et Flexibilité
Utiliser un pipeline est souvent aussi simple qu'une ou deux lignes de code. Par exemple, pour une analyse de sentiment :
# Exemple Python (conceptuel)
from transformers import pipeline

# Charger un pipeline pour l'analyse de sentiment
classifier = pipeline("sentiment-analysis")

# Utiliser le pipeline pour prédire
results = classifier("J'adore utiliser les pipelines Transformers !")
print(results) # [{'label': 'POSITIVE', 'score': 0.999...}]
Les pipelines sélectionnent automatiquement un modèle pré-entraîné par défaut adapté à la tâche spécifiée. Cependant, ils offrent également la flexibilité de choisir un modèle spécifique parmi les milliers disponibles sur le Hub Hugging Face, y compris des modèles qui ont été fine-tunés pour des langues ou des domaines particuliers.
Tâches courantes supportées par les pipelines :
- Analyse de sentiment
- Classification de texte (zero-shot, few-shot)
- Génération de texte
- Réponse aux questions
- Résumé de texte
- Traduction automatique
- Reconnaissance d'entités nommées (NER)
- Masquage de mots (Mask filling)
- Classification d'images
- Détection d'objets
- Et bien d'autres, y compris pour l'audio et la multimodalité.
Avantages des Pipelines
- Facilité d'utilisation : Abstraction de la complexité, rendant les modèles puissants accessibles même aux non-experts.
- Rapidité de prototypage : Permet de tester et d'intégrer rapidement des fonctionnalités d'IA.
- Accès à des modèles de pointe : Utilisation immédiate de modèles pré-entraînés performants.
- Optimisation : Prise en charge du traitement par lots (batching) pour une inférence plus efficace, et compatibilité avec GPU et autres accélérateurs.
La Synergie : Apprentissage par Transfert et Pipelines Transformers
L'apprentissage par transfert est le fondement même qui rend les pipelines Transformers si puissants et pratiques. La grande majorité des modèles accessibles via les pipelines sont des modèles pré-entraînés. En utilisant un pipeline, on applique donc intrinsèquement les principes de l'apprentissage par transfert.
Voici comment ils se combinent :
- Modèles Pré-entraînés (Apprentissage par Transfert) : Des modèles comme BERT, CamemBERT (pour le français), GPT-2, etc., ont été entraînés sur d'immenses corpus de données, acquérant ainsi une compréhension générale du langage (ou des images, etc.). C'est la connaissance "transférable".
- Fine-tuning (Apprentissage par Transfert) : Ces modèles pré-entraînés sont ensuite souvent fine-tunés sur des ensembles de données plus spécifiques pour des tâches particulières (par exemple, un BERT pré-entraîné est fine-tuné sur un jeu de données d'analyse de sentiment). Ce modèle fine-tuné conserve les connaissances générales et se spécialise.
- Pipelines Transformers (Utilisation Simplifiée) : Les pipelines permettent de charger et d'utiliser ces modèles pré-entraînés et fine-tunés sans se soucier des détails de leur chargement, du prétraitement des données spécifique au modèle, ou du post-traitement des sorties.
Par exemple, si vous utilisez un pipeline `sentiment-analysis` pour du texte en français, il pourrait charger un modèle comme CamemBERT qui a été préalablement fine-tuné sur des données de sentiment en français. Vous bénéficiez ainsi de l'apprentissage par transfert sans avoir à gérer vous-même le processus de fine-tuning ou l'architecture complexe du modèle.
Visualisation de la Relation
Le diagramme suivant illustre les concepts clés et leurs interconnexions, depuis l'IA générale jusqu'à l'application pratique via les pipelines Transformers, en passant par l'apprentissage par transfert et les modèles Transformers spécifiques.
Ce mindmap montre comment l'apprentissage par transfert est une technique clé au sein de l'apprentissage automatique, permettant l'utilisation efficace de modèles d'architecture Transformer. Les pipelines Transformers, fournis par des bibliothèques comme Hugging Face, simplifient ensuite l'accès et l'utilisation de ces modèles pour des applications pratiques.
Comparaison : Entraînement à partir de Zéro vs. Apprentissage par Transfert avec Pipelines
Pour mieux saisir les avantages de l'utilisation de l'apprentissage par transfert via les pipelines Transformers, comparons cette approche à l'entraînement d'un modèle d'IA à partir de zéro. Le graphique radar ci-dessous illustre les différences sur plusieurs aspects clés. Les scores sont donnés à titre indicatif sur une échelle de 1 (très faible/peu) à 10 (très élevé/beaucoup).
Ce graphique illustre clairement que l'approche combinant l'apprentissage par transfert et les pipelines Transformers est généralement plus avantageuse en termes de temps de développement, de volume de données nécessaires, et d'expertise requise, tout en offrant de meilleures performances sur des ensembles de données de taille réduite. Le coût de calcul est également inférieur à celui d'un entraînement complet à partir de zéro, bien qu'il ne soit pas négligeable pour le pré-entraînement initial des grands modèles.
Exemples de Tâches NLP avec les Pipelines Transformers
Les pipelines Transformers excellent dans une vaste gamme de tâches de Traitement du Langage Naturel (NLP). Le tableau ci-dessous présente quelques exemples courants, la description de la tâche, et un exemple de type de modèle (ou un modèle spécifique) qui pourrait être utilisé via un pipeline Hugging Face.
| Tâche NLP | Description | Modèle Exemple (utilisable via Pipeline) |
|---|---|---|
| Analyse de Sentiment | Déterminer la polarité émotionnelle (positive, négative, neutre) d'un texte. | distilbert-base-uncased-finetuned-sst-2-english (pour l'anglais), ou un modèle CamemBERT fine-tuné pour le sentiment en français. |
| Réponse aux Questions (Question Answering) | Extraire une réponse à une question à partir d'un texte de contexte donné. | bert-large-uncased-whole-word-masking-finetuned-squad |
| Traduction Automatique | Traduire du texte d'une langue source vers une langue cible. | Helsinki-NLP/opus-mt-[source_lang]-[target_lang] (ex: Helsinki-NLP/opus-mt-fr-en pour français vers anglais) |
| Génération de Texte | Créer du texte cohérent et pertinent, par exemple pour compléter une phrase ou écrire une histoire. | gpt2, EleutherAI/gpt-neo-1.3B |
| Classification Zéro-Shot (Zero-Shot Classification) | Classifier du texte selon des étiquettes candidates fournies à la volée, sans que le modèle ait été entraîné spécifiquement sur ces étiquettes. | facebook/bart-large-mnli |
| Reconnaissance d'Entités Nommées (NER) | Identifier et catégoriser des entités nommées dans un texte (personnes, lieux, organisations, dates, etc.). | dbmdz/bert-large-cased-finetuned-conll03-english (pour l'anglais), modèles spécifiques pour d'autres langues. |
| Résumé de Texte | Générer une version concise d'un texte plus long tout en préservant les informations essentielles. | facebook/bart-large-cnn |
Ces exemples ne sont qu'un aperçu des capacités offertes. La flexibilité des pipelines permet d'adapter ces tâches à de nombreux cas d'usage spécifiques.
Plongez Plus Profond : Vidéo Explicative
Pour une compréhension plus approfondie de l'écosystème Hugging Face, des modèles Transformers et de l'utilisation des pipelines, la vidéo suivante offre une excellente introduction. Elle couvre les concepts fondamentaux et montre comment ces outils peuvent être mis en œuvre.
Vidéo "What is Hugging Face? | Hugging Face Models | Transformers ..." expliquant l'écosystème Hugging Face, les modèles Transformers, et leur utilisation, y compris les pipelines et le fine-tuning.
Cette vidéo explore comment Hugging Face met à disposition des ressources pour l'entraînement d'IA, l'ajustement fin de modèles, et l'inférence, soulignant le rôle central des Transformers et la facilité d'utilisation apportée par les pipelines. Elle est pertinente car elle connecte directement les concepts d'apprentissage par transfert (via le fine-tuning de modèles pré-entraînés) et l'utilisation pratique des pipelines pour des tâches d'IA.
FAQ : Questions Fréquemment Posées
Qu'est-ce que l'apprentissage par transfert concrètement ?
L'apprentissage par transfert est une technique où un modèle d'IA, déjà entraîné sur une grande quantité de données pour une tâche A (par exemple, reconnaître des millions d'images d'objets), est réutilisé comme point de départ pour une nouvelle tâche B (par exemple, classifier des types spécifiques de voitures avec un petit jeu de données). Au lieu de repartir de zéro, on transfère les "connaissances" (les poids et les caractéristiques apprises) du modèle A vers le modèle B, ce qui accélère l'entraînement et améliore souvent les performances, surtout quand les données pour la tâche B sont limitées.
À quoi servent les pipelines Transformers de Hugging Face ?
Les pipelines Transformers de Hugging Face sont des outils logiciels qui simplifient énormément l'utilisation de modèles d'IA pré-entraînés (souvent des Transformers) pour des tâches spécifiques. Ils gèrent automatiquement les étapes complexes comme le chargement du bon modèle, le prétraitement des données d'entrée (texte, image, etc.), l'exécution du modèle (inférence), et le post-traitement des résultats pour les rendre compréhensibles. Cela permet aux développeurs d'intégrer facilement des fonctionnalités d'IA avancées dans leurs applications avec très peu de code.
Dois-je être un expert en IA pour utiliser les pipelines Transformers ?
Non, pas nécessairement pour une utilisation de base. L'un des grands avantages des pipelines Transformers est d'abstraire une grande partie de la complexité. Vous pouvez effectuer des tâches comme l'analyse de sentiment ou la traduction avec quelques lignes de code sans comprendre tous les détails internes du modèle. Cependant, pour des personnalisations avancées, du fine-tuning, ou pour optimiser les performances, une compréhension plus approfondie des modèles et de l'apprentissage automatique devient utile.
L'apprentissage par transfert fonctionne-t-il pour toutes les tâches ?
L'apprentissage par transfert est plus efficace lorsque la tâche source (sur laquelle le modèle a été pré-entraîné) et la tâche cible (la nouvelle tâche) sont liées ou partagent des caractéristiques sous-jacentes. Par exemple, un modèle entraîné à comprendre le langage général sera utile pour la plupart des tâches NLP. Si les tâches sont très différentes (par exemple, transférer des connaissances d'un modèle de reconnaissance d'images vers une tâche de prédiction boursière), le transfert peut être moins bénéfique, voire nuisible ("transfert négatif").
Peut-on fine-tuner un modèle utilisé dans un pipeline ?
Oui, absolument. Bien que les pipelines soient excellents pour l'inférence directe avec des modèles pré-entraînés (ou déjà fine-tunés), la bibliothèque Transformers sous-jacente fournit tous les outils nécessaires pour charger un modèle pré-entraîné et le fine-tuner sur votre propre ensemble de données spécifique. Une fois fine-tuné, ce modèle personnalisé peut ensuite être utilisé dans un pipeline pour une inférence simplifiée.
Recommandations de Lecture
Pour approfondir vos connaissances sur ces sujets, nous vous suggérons les requêtes suivantes :
- Comment fonctionne le mécanisme d'attention dans les modèles Transformers ?
- Quelles sont les meilleures pratiques pour le fine-tuning de modèles de langage pré-entraînés ?
- Applications de l'apprentissage par transfert en vision par ordinateur au-delà de la classification d'images.
- Comment évaluer la similarité des tâches pour un apprentissage par transfert réussi ?
Références
 aws.amazon.com
Last updated May 9, 2025