
XGBoost Décrypté : La Puissance Cachée Derrière l'Algorithme Champion du Machine Learning ?
Plongez au cœur du modèle mathématique, des atouts majeurs et des perspectives d'évolution de XGBoost, l'outil incontournable pour la modélisation prédictive.
Les Clés de Compréhension de XGBoost
- Performance Supérieure : XGBoost est réputé pour sa capacité à atteindre une précision élevée sur diverses tâches de classification et de régression, souvent en tête des compétitions de data science.
- Rapidité et Scalabilité Exceptionnelles : Grâce à des optimisations intelligentes comme le traitement parallèle et la gestion efficace de la mémoire, XGBoost peut traiter de grands volumes de données rapidement.
- Robustesse face au Surajustement : L'intégration de techniques de régularisation avancées permet de contrôler la complexité des modèles et d'améliorer leur capacité de généralisation sur de nouvelles données.
Qu'est-ce que XGBoost ? Une Vue d'Ensemble
XGBoost, acronyme de "eXtreme Gradient Boosting", est une bibliothèque logicielle open-source d'apprentissage automatique (machine learning) qui implémente un algorithme de boosting de gradient optimisé et hautement performant. Développé initialement par Tianqi Chen et Carlos Guestrin, XGBoost est devenu un outil de choix pour les data scientists en raison de sa vitesse et de sa précision, en particulier sur les données tabulaires ou structurées.
Fondamentalement, XGBoost appartient à la famille des méthodes d'ensemble, ce qui signifie qu'il combine les prédictions de plusieurs modèles plus simples (appelés apprenants faibles, généralement des arbres de décision) pour produire un modèle final plus robuste et précis. Le "boosting" est une technique séquentielle où chaque nouveau modèle est entraîné pour corriger les erreurs commises par l'ensemble des modèles précédents. XGBoost pousse cette idée à l'extrême grâce à des innovations algorithmiques et systémiques.
Le Cœur Mathématique de XGBoost et Son Fonctionnement
La puissance de XGBoost réside dans son modèle mathématique sophistiqué qui optimise une fonction objectif spécifique en utilisant une approche de boosting de gradient régularisé.
La Fonction Objectif au Cœur de l'Optimisation
L'objectif principal de XGBoost est de minimiser une fonction objectif qui combine une fonction de perte (mesurant l'écart entre les prédictions et les valeurs réelles) et un terme de régularisation (pénalisant la complexité du modèle pour éviter le surajustement). Pour un ensemble de \(n\) observations, la fonction objectif à l'itération \(t\) peut s'écrire :
\[ Obj^{(t)} = \sum_{i=1}^n l(y_i, \hat{y}_i^{(t-1)} + f_t(x_i)) + \Omega(f_t) \]Où :
- \(y_i\) est la vraie valeur pour l'observation \(i\).
- \(\hat{y}_i^{(t-1)}\) est la prédiction du modèle à l'itération précédente.
- \(f_t(x_i)\) est la prédiction du nouvel arbre de décision (apprenant faible) ajouté à l'itération \(t\).
- \(l(y_i, \hat{y}_i)\) est la fonction de perte différentiable (ex: erreur quadratique pour la régression, perte logistique pour la classification).
- \(\Omega(f_t)\) est le terme de régularisation pour l'arbre \(f_t\).
L'Approximation par Expansion de Taylor
Pour optimiser efficacement cette fonction objectif, XGBoost utilise une approximation de Taylor du second ordre de la fonction de perte autour de la prédiction actuelle. Cela permet de reformuler l'objectif de manière plus tractable :
\[ Obj^{(t)} \approx \sum_{i=1}^n [g_i f_t(x_i) + \frac{1}{2} h_i f_t(x_i)^2] + \Omega(f_t) + \text{constante} \]Où \(g_i\) et \(h_i\) sont respectivement la première et la seconde dérivée (gradient et hessien) de la fonction de perte par rapport à \(\hat{y}_i^{(t-1)}\) :
\[ g_i = \frac{\partial l(y_i, \hat{y}_i^{(t-1)})}{\partial \hat{y}_i^{(t-1)}} \] \[ h_i = \frac{\partial^2 l(y_i, \hat{y}_i^{(t-1)})}{(\partial \hat{y}_i^{(t-1)})^2} \]Cette approximation permet à XGBoost de prendre en compte plus d'informations sur la structure de la fonction de perte, menant à une meilleure convergence.
Régularisation : La Clé Contre le Surajustement
Le terme de régularisation \(\Omega(f_t)\) est crucial pour prévenir le surajustement. Il pénalise la complexité des arbres de décision. Typiquement, il inclut :
\[ \Omega(f_t) = \gamma T + \frac{1}{2} \lambda \sum_{j=1}^T w_j^2 \]- \(T\) : le nombre de feuilles dans l'arbre \(f_t\).
- \(w_j\) : le score (valeur de prédiction) de la \(j\)-ième feuille.
- \(\gamma\) : paramètre de régularisation qui contrôle la pénalité pour le nombre de feuilles (complexité structurelle).
- \(\lambda\) : paramètre de régularisation L2 sur les poids des feuilles, qui lisse les prédictions.
Cette régularisation aide à construire des modèles plus simples et plus généralisables.
Construction Séquentielle des Arbres
XGBoost construit les arbres de manière additive et séquentielle. À chaque étape \(t\), un nouvel arbre \(f_t\) est ajouté pour minimiser la fonction objectif \(Obj^{(t)}\). Cet arbre est construit de manière gloutonne (greedy) :
- En partant d'une seule feuille, l'algorithme évalue itérativement la division (split) de chaque feuille existante en deux nouvelles feuilles.
- Pour chaque division potentielle sur chaque caractéristique, XGBoost calcule le gain de la division, qui est la réduction de la fonction objectif obtenue grâce à cette division.
- La division qui maximise ce gain est choisie.
- Ce processus est répété jusqu'à ce qu'une profondeur maximale soit atteinte, que le gain soit inférieur à un seuil (contrôlé par \(\gamma\)), ou qu'il n'y ait plus d'échantillons à diviser.
Parallélisation et Optimisations
Bien que les arbres soient ajoutés séquentiellement (le boosting est un processus séquentiel), la construction de chaque arbre individuel peut être parallélisée. XGBoost excelle dans ce domaine en parallélisant la recherche des meilleures divisions au sein d'un arbre. Il utilise également des techniques comme la création de structures de données pré-triées (appelées "block") et une gestion consciente du cache pour accélérer le calcul des gains.
Gestion Intelligente des Données
Données Manquantes (Sparsity-Aware Split Finding)
XGBoost possède une routine intégrée pour gérer les valeurs manquantes. Lors de la recherche de la meilleure division pour une caractéristique, il apprend une direction par défaut pour les instances ayant des valeurs manquantes pour cette caractéristique. Il essaie de placer toutes les instances avec des valeurs manquantes dans la branche de gauche et calcule le gain, puis fait de même pour la branche de droite, et choisit la direction qui maximise le gain.
Élagage (Pruning) et Arrêt Précoce (Early Stopping)
XGBoost utilise un élagage post-construction (basé sur le paramètre \(\gamma\)) où les divisions avec un gain négatif ne sont pas effectuées (ou un arbre est élagué de bas en haut). De plus, l'entraînement peut être arrêté prématurément si les performances sur un jeu de validation ne s'améliorent plus pendant un certain nombre d'itérations, ce qui aide également à prévenir le surajustement et à économiser du temps de calcul.
Visualisation des Concepts Clés de XGBoost
Pour mieux appréhender la structure et les composantes de XGBoost, le schéma mental ci-dessous illustre les principaux aspects de l'algorithme, de son fondement mathématique à ses implications pratiques.
(Perte + Régularisation)"] id1_2["Expansion de Taylor
(2nd ordre)"] id1_3["Régularisation
(L1, L2, Gamma)"] id1_4["Construction d'Arbres
(Score de split, Gain)"] id2["Fonctionnement"] id2_1["Apprentissage Séquentiel
(Boosting)"] id2_2["Correction des Erreurs
Résiduelles"] id2_3["Parallélisation
(Construction d'arbre)"] id2_4["Gestion des Données
Manquantes (Sparsity-aware)"] id2_5["Élagage et Arrêt Précoce"] id3["Avantages"] id3_1["Haute Précision"] id3_2["Rapidité et Scalabilité"] id3_3["Flexibilité
(Objectifs, Métriques)"] id3_4["Contrôle du Surajustement"] id3_5["Gestion des Données Creuses"] id4["Inconvénients"] id4_1["Réglage des Hyperparamètres
(Complexe)"] id4_2["Intensif en Calcul
(Grandes données/modèles)"] id4_3["Interprétabilité Limitée
(Comparé à un arbre unique)"] id4_4["Moins optimal pour données
non structurées"] id5["Optimisations Futures (Modèle Math.)"] id5_1["Interprétabilité Accrue
(Intégrée)"] id5_2["Gestion de Données
Non Structurées/Temporelles"] id5_3["Algorithmes d'Optimisation
Plus Avancés"] id5_4["Régularisation Adaptative"] id5_5["Optimisations Matérielles"]
Ce diagramme met en évidence les interconnexions entre les différents éléments qui font de XGBoost un algorithme si puissant et polyvalent.
Les Atouts Majeurs de XGBoost
XGBoost est largement adopté pour plusieurs raisons clés qui le distinguent :
- Haute Précision : Grâce à son algorithme de boosting de gradient sophistiqué et à sa régularisation, XGBoost atteint souvent des performances de pointe sur de nombreux problèmes de classification et de régression. Il excelle particulièrement sur les données tabulaires structurées.
- Rapidité et Efficacité : L'une des caractéristiques les plus remarquables de XGBoost est sa vitesse d'entraînement. Il implémente le traitement parallèle (au niveau des caractéristiques et des nœuds d'arbre), l'élagage des arbres, la gestion optimisée du cache et des techniques pour les données éparses, ce qui le rend beaucoup plus rapide que les implémentations traditionnelles de gradient boosting.
- Scalabilité : XGBoost est conçu pour être efficace sur de grands ensembles de données qui ne tiennent pas en mémoire. Il supporte l'entraînement distribué sur plusieurs machines (par exemple, via Spark, Dask, Flink) et l'entraînement "out-of-core" (sur disque).
- Flexibilité : Il permet aux utilisateurs de définir des fonctions objectifs personnalisées et des métriques d'évaluation. Il peut gérer différents types de problèmes (régression, classification binaire et multiclasse, ranking).
- Contrôle Robuste du Surajustement : XGBoost intègre nativement des techniques de régularisation L1 (Lasso) et L2 (Ridge) sur les poids des feuilles, ainsi qu'un paramètre \(\gamma\) pour contrôler la complexité de l'arbre (similaire à un élagage basé sur le gain minimum). L'arrêt précoce (early stopping) est également une fonctionnalité standard.
- Gestion des Valeurs Manquantes : Comme mentionné, XGBoost possède une capacité intégrée à gérer les valeurs manquantes en apprenant la meilleure direction pour ces valeurs lors de la construction des arbres.
- Disponibilité et Communauté : XGBoost est disponible dans plusieurs langages populaires (Python, R, Java, Scala, C++) et bénéficie d'une large communauté d'utilisateurs et de développeurs, ce qui assure un bon support et des mises à jour régulières.
Inconvénients et Défis de XGBoost
Malgré ses nombreux avantages, XGBoost présente certains inconvénients et défis :
- Complexité du Réglage des Hyperparamètres : XGBoost possède un grand nombre d'hyperparamètres (taux d'apprentissage, profondeur des arbres, paramètres de régularisation, sous-échantillonnage, etc.). Trouver la combinaison optimale peut être un processus long et complexe, nécessitant souvent des techniques de recherche systématique (grid search, random search, optimisation bayésienne).
- Sensibilité aux Hyperparamètres : Les performances de XGBoost peuvent être très sensibles au choix de ces hyperparamètres. Un mauvais réglage peut conduire à un surajustement ou à un sous-ajustement.
- Intensif en Ressources de Calcul : Bien qu'optimisé, l'entraînement de modèles XGBoost, surtout sur de très grands ensembles de données ou avec un grand nombre d'arbres et une profondeur élevée, peut être gourmand en CPU et en mémoire.
- Interprétabilité Réduite : Comme la plupart des modèles d'ensemble, XGBoost est plus une "boîte noire" qu'un simple arbre de décision. Comprendre la logique exacte derrière ses prédictions peut être difficile, bien que des techniques comme SHAP (SHapley Additive exPlanations) ou l'importance des caractéristiques (feature importance) puissent aider à fournir des indications.
- Moins Performant sur les Données Non Structurées : XGBoost est principalement conçu pour les données tabulaires. Pour les données non structurées comme les images, le texte brut ou l'audio, les réseaux de neurones profonds (Deep Learning) sont souvent plus performants.
- Risque de Surajustement sur Petits Ensembles de Données Bruités : Si les données sont peu nombreuses ou très bruitées, XGBoost, même avec sa régularisation, peut toujours surapprendre si les hyperparamètres ne sont pas soigneusement ajustés.
Tableau Récapitulatif : Avantages vs. Inconvénients de XGBoost
Ce tableau synthétise les principaux points forts et les faiblesses de l'algorithme XGBoost pour une vue d'ensemble rapide.
| Aspect | Avantages | Inconvénients |
|---|---|---|
| Performance | Haute précision, souvent à la pointe | Peut surajuster sur petits datasets bruités si mal réglé |
| Vitesse & Scalabilité | Rapide grâce à la parallélisation et aux optimisations, gère les grands datasets | Peut être gourmand en ressources (CPU, mémoire) |
| Flexibilité | Supporte divers objectifs, métriques personnalisées, langages | Moins adapté nativement aux données non structurées |
| Régularisation | Contrôle robuste du surajustement (L1, L2, gamma, early stopping) | Nécessite un réglage fin des paramètres de régularisation |
| Utilisation | Gestion intégrée des valeurs manquantes, large communauté | Nombreux hyperparamètres à régler, complexité de tuning |
| Interprétabilité | Fournit l'importance des caractéristiques | Modèle "boîte noire" par rapport à des modèles plus simples |
Analyse Comparative des Attributs de XGBoost
Le diagramme radar ci-dessous offre une perspective comparative de XGBoost par rapport à d'autres algorithmes d'apprentissage automatique populaires, en évaluant plusieurs caractéristiques clés. Les scores sont donnés sur une échelle indicative de 1 (faible) à 10 (élevé), basés sur des performances générales et des consensus dans la communauté. Ils peuvent varier en fonction du dataset spécifique et de l'optimisation.
Ce graphique illustre comment XGBoost se positionne en termes de précision, vitesse, contrôle du surajustement, flexibilité, interprétabilité et facilité de réglage par rapport à d'autres algorithmes couramment utilisés.
Illustration de l'Architecture d'Ensemble de XGBoost
L'image ci-dessous schématise l'architecture d'ensemble typique de XGBoost, où plusieurs arbres de décision sont combinés pour former un modèle prédictif puissant.
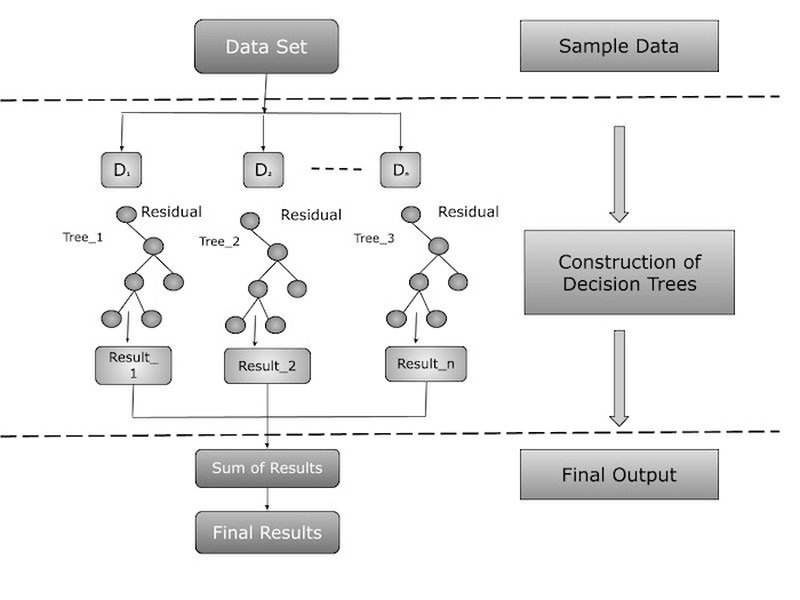
Visualisation de l'architecture d'ensemble de XGBoost, où les prédictions de multiples arbres de décision sont agrégées.
Chaque arbre du modèle apprend des erreurs résiduelles des arbres précédents, améliorant ainsi continuellement la performance globale du modèle. Cette approche additive est au cœur du mécanisme de boosting.
Vidéo Explicative : XGBoost en Bref
Pour une introduction rapide et visuelle à XGBoost, la vidéo ci-dessous (en anglais) résume les concepts fondamentaux de l'algorithme en moins de trois minutes. Elle met en lumière les caractéristiques clés qui ont fait le succès de XGBoost dans le domaine de l'apprentissage automatique et constitue un excellent point de départ pour comprendre ses principes avant d'explorer des détails plus techniques.
Cette vidéo offre un aperçu concis de ce qui rend XGBoost si efficace, notamment son utilisation du boosting de gradient, la régularisation, et ses optimisations pour la vitesse et la performance.
Pistes d'Optimisation Futures pour le Modèle Mathématique de XGBoost
Bien que XGBoost soit déjà un algorithme très performant, la recherche continue d'explorer des améliorations potentielles à son modèle mathématique. Voici quelques pistes d'optimisation futures envisagées :
Amélioration de l'Interprétabilité Intrinsèque
Actuellement, l'interprétabilité de XGBoost repose largement sur des méthodes post-hoc (comme SHAP). Des recherches futures pourraient viser à intégrer une plus grande interprétabilité directement dans le processus d'apprentissage. Cela pourrait impliquer des formulations mathématiques qui favorisent des structures d'arbres plus simples ou des fonctions de régularisation qui encouragent des contributions de caractéristiques plus explicables, sans sacrifier significativement la performance.
Extension aux Données Complexes et Non Structurées
XGBoost excelle sur les données tabulaires. Des développements mathématiques pourraient chercher à mieux intégrer nativement des types de données plus complexes, comme les données séquentielles (séries temporelles avec dépendances à long terme), les graphes, ou même des données non structurées (texte, images) sans dépendre uniquement de l'ingénierie de caractéristiques préalable. Cela pourrait impliquer de nouvelles structures d'apprenants faibles ou des fonctions de perte adaptées.
Développement d'Algorithmes d'Optimisation Plus Poussés
Bien que l'utilisation des dérivées secondes (hessiens) soit un avantage, l'exploration d'algorithmes d'optimisation encore plus sophistiqués (par exemple, des méthodes de quasi-Newton adaptatives pour la construction d'arbres ou des approches de second ordre plus dynamiques) pourrait améliorer la vitesse de convergence ou la qualité des solutions, en particulier sur des fonctions de perte très non convexes ou des problèmes à grande échelle.
Techniques de Régularisation Avancées et Adaptatives
De nouvelles formes de régularisation pourraient être développées, potentiellement basées sur des principes théoriques plus profonds (comme la théorie de l'information ou la complexité de Kolmogorov). Des techniques de régularisation adaptative, où les pénalités sont ajustées dynamiquement pendant l'entraînement en fonction des caractéristiques des données ou de la complexité du modèle en cours de construction, pourraient améliorer la généralisation et réduire la sensibilité aux hyperparamètres.
Optimisations pour Architectures Matérielles Spécifiques et Calcul Distribué
Bien que XGBoost utilise déjà le parallélisme, des recherches continues pourraient se concentrer sur des optimisations mathématiques spécifiques pour tirer pleinement parti des architectures matérielles émergentes (par exemple, les TPUs, les IPUs, ou les futurs accélérateurs de calcul). Cela pourrait inclure des algorithmes de division ou de construction d'arbres qui minimisent la communication de données dans les environnements distribués ou qui s'alignent mieux sur les capacités de calcul spécifiques de ces matériels.
Intégration de l'Apprentissage Actif et de l'Incertitude
Des formulations mathématiques pourraient être développées pour intégrer plus nativement des concepts d'apprentissage actif, permettant au modèle de sélectionner intelligemment les points de données les plus informatifs pour l'étiquetage et l'entraînement. De plus, améliorer la quantification de l'incertitude dans les prédictions de XGBoost, au-delà des approches d'ensemble simples, pourrait être un axe important pour les applications critiques.
FAQ - Questions Fréquemment Posées sur XGBoost
Qu'est-ce que le boosting de gradient ? +
Le boosting de gradient est une technique d'apprentissage automatique de type ensemble où de nouveaux modèles sont ajoutés séquentiellement pour corriger les erreurs des modèles précédents. Chaque nouveau modèle apprend les résidus (les différences entre les valeurs réelles et les prédictions) de l'ensemble des modèles précédents. L'idée est de combiner de nombreux "apprenants faibles" (modèles qui performent légèrement mieux qu'une estimation aléatoire) pour créer un "apprenant fort" très performant. XGBoost est une implémentation optimisée de cet algorithme.
Comment XGBoost gère-t-il les valeurs manquantes ? +
XGBoost possède une méthode intégrée pour gérer les valeurs manquantes, appelée "sparsity-aware split finding". Lors de la construction d'un arbre, pour chaque division potentielle, XGBoost place toutes les instances avec une valeur manquante pour la caractéristique de division dans la branche de gauche, puis dans la branche de droite, et calcule le gain pour chaque cas. Il choisit ensuite la direction (gauche ou droite) qui maximise le gain comme direction par défaut pour les valeurs manquantes. Cela signifie que l'algorithme apprend la meilleure façon de traiter les valeurs manquantes à partir des données elles-mêmes, sans nécessiter d'imputation préalable.
XGBoost est-il adapté à tous les types de données ? +
XGBoost est particulièrement performant sur les données structurées ou tabulaires, où les caractéristiques sont bien définies en colonnes. C'est pourquoi il est très populaire pour des tâches comme la prédiction de prix, la détection de fraude, ou la modélisation du risque de crédit. Cependant, pour les données non structurées comme les images, le texte brut ou les signaux audio, d'autres approches comme les réseaux de neurones profonds (Deep Learning) sont généralement plus adaptées, bien que XGBoost puisse être utilisé après une étape d'extraction de caractéristiques (feature engineering) transformant ces données en format tabulaire.
Pourquoi l'optimisation des hyperparamètres est-elle cruciale pour XGBoost ? +
XGBoost possède de nombreux hyperparamètres qui contrôlent son processus d'apprentissage (par exemple, le taux d'apprentissage, la profondeur maximale des arbres, le nombre d'arbres, les paramètres de régularisation L1 et L2, le gamma, etc.). La performance du modèle final dépend fortement du réglage de ces hyperparamètres. Un mauvais choix peut conduire à un surajustement (le modèle apprend trop bien les données d'entraînement mais généralise mal aux nouvelles données) ou à un sous-ajustement (le modèle est trop simple pour capturer la complexité des données). Une optimisation minutieuse, souvent via des techniques de recherche automatisée (comme la recherche par grille, la recherche aléatoire ou l'optimisation bayésienne), est donc essentielle pour exploiter pleinement le potentiel de XGBoost et obtenir les meilleures performances possibles.
Pistes de Lecture Recommandées
Pour approfondir votre compréhension de XGBoost et de ses applications, voici quelques requêtes de recherche pertinentes :
- Comment optimiser les hyperparamètres de XGBoost pour améliorer la performance ?
- Quelles sont les applications industrielles courantes de XGBoost ?
- Quelles sont les différences clés entre XGBoost, LightGBM et CatBoost ?
- Comment peut-on interpréter les prédictions d'un modèle XGBoost avec des outils comme SHAP ?
Références
Les informations présentées dans ce rapport s'appuient sur les sources suivantes :
Last updated May 8, 2025