
Магия Мультимодального Ввода: Как Показать Изображения, HTML и Текст Вашей LLM с LangChain и Ollama
Разблокируйте полный потенциал ваших языковых моделей, комбинируя различные типы данных в одном запросе с помощью Python.
Ключевые моменты
- Гибкая обработка данных: Узнайте, как передавать изображения (в формате Base64), содержимое HTML-файлов (после извлечения текста) и текстовых файлов непосредственно в LLM.
- Сила LangChain и Ollama: Используйте последние версии библиотек
langchainиlangchain-ollamaдля Python 3 для создания мощных мультимодальных приложений. - Единый комплексный промпт: Научитесь формировать единый промпт, который объединяет визуальную и текстовую информацию для получения глубокого и контекстуализированного ответа от модели.
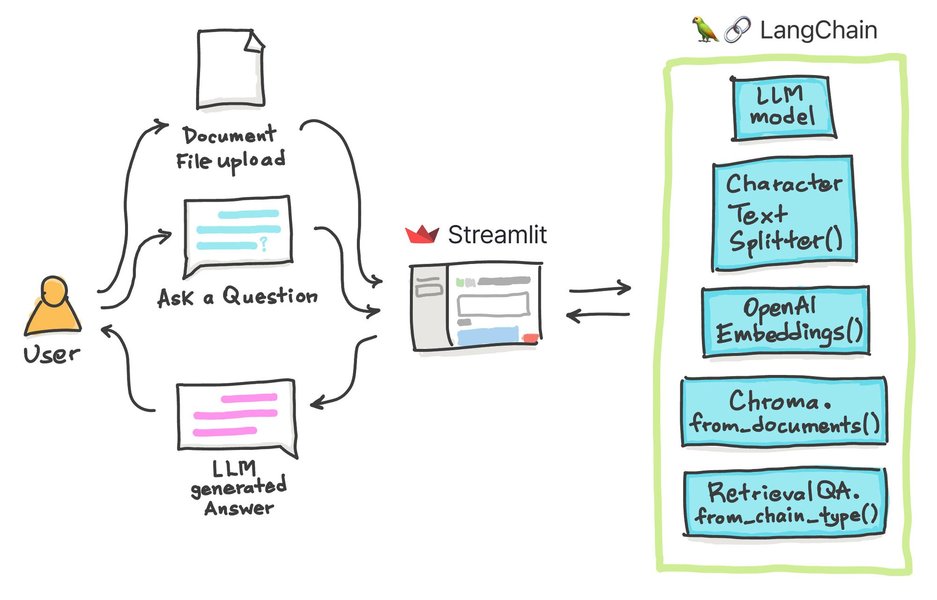
Концептуальная схема, иллюстрирующая поток данных и компонентов в LangChain.
Введение: Мультимодальные возможности с LangChain и Ollama
Современные большие языковые модели (LLM) выходят за рамки простого текста, обретая способность "видеть" и интерпретировать изображения, а также обрабатывать структурированную информацию из HTML-документов. Интеграция таких мультимодальных данных в ваши промпты открывает новые горизонты для создания интеллектуальных приложений. LangChain, в связке с Ollama, предоставляет мощный и гибкий инструментарий для реализации этих возможностей в Python. В этой статье мы рассмотрим, как, используя актуальные версии `langchain` (например, 0.3.x) и `langchain-ollama`, можно эффективно передавать изображения, HTML-файлы и текстовые файлы в LLM, объединяя их в одном комплексном запросе.
Подготовка окружения и ключевые компоненты
Необходимые библиотеки
Прежде чем начать, убедитесь, что у вас установлены все необходимые библиотеки. Вы можете установить их с помощью pip:
pip install langchain langchain-core langchain-community langchain-ollama beautifulsoup4 Pillow- langchain, langchain-core, langchain-community: Основные компоненты фреймворка LangChain.
- langchain-ollama: Интеграция для работы с моделями, запущенными через Ollama.
- beautifulsoup4: Библиотека для парсинга HTML и извлечения из него текста.
- Pillow: Библиотека для работы с изображениями (необходима для некоторых операций, хотя в данном примере прямо не используется для манипуляций, но часто является зависимостью).
Инициализация модели LLM
Для работы с мультимодальными данными нам понадобится LLM, поддерживающая обработку изображений. С помощью `langchain-ollama` мы можем легко подключиться к такой модели, запущенной локально через Ollama (например, LLaVA или более новые модели Llama с поддержкой зрения). Убедитесь, что в вашем Ollama установлена и запущена соответствующая модель (например, `ollama pull llava:latest`).
Функции для обработки данных
Для каждого типа данных нам потребуется своя функция подготовки.
Обработка изображений
Изображения обычно передаются в LLM в виде строки Base64. Это позволяет встроить данные изображения непосредственно в промпт. Мы создадим функцию для кодирования локального файла изображения в Base64.
Обработка HTML-файлов
HTML-файлы содержат много разметки, которая не нужна LLM для понимания основного текстового содержания. Поэтому перед передачей в модель мы извлечем из HTML-файла только текст с помощью библиотеки BeautifulSoup.
Обработка текстовых файлов
Текстовые файлы обрабатываются проще всего: их содержимое считывается как строка и может быть напрямую включено в промпт.
Комплексный пример кода на Python
Ниже представлен полный пример кода, демонстрирующий, как загрузить изображение, HTML-файл и текстовый файл, а затем передать их все вместе в LLM с помощью LangChain и Ollama. Замените пути к файлам (`"path/to/your/image.jpg"`, `"path/to/your/document.html"`, `"path/to/your/text_file.txt"`) и имя модели (`"llava:latest"`) на актуальные для вашей системы.
import base64
from pathlib import Path
from bs4 import BeautifulSoup
from langchain_ollama.chat_models import ChatOllama
from langchain_core.messages import HumanMessage

# 1. Инициализация модели Ollama (убедитесь, что модель поддерживает vision)
#    Примеры моделей: "llava:latest", "bakllava:latest", "llama3.2-vision" (проверьте доступные в вашем Ollama)
try:
    llm = ChatOllama(model="llava:latest", temperature=0.1)
    # Простой тестовый вызов для проверки доступности модели
    # llm.invoke("hi")
except Exception as e:
    print(f"Ошибка инициализации LLM. Убедитесь, что Ollama запущена и модель '{'llava:latest'}' доступна.")
    print(f"Подробности ошибки: {e}")
    exit()

# 2. Функция для кодирования изображения в Base64
def encode_image_to_base64(image_path: str) -> str:
    """Кодирует локальное изображение в строку Base64."""
    try:
        with open(image_path, "rb") as image_file:
            return base64.b64encode(image_file.read()).decode('utf-8')
    except FileNotFoundError:
        print(f"Ошибка: Файл изображения не найден по пути {image_path}")
        return "" # Возвращаем пустую строку или обрабатываем ошибку иначе

# 3. Функция для извлечения текста из HTML-файла
def extract_text_from_html(html_path: str) -> str:
    """Извлекает текстовое содержимое из HTML-файла."""
    try:
        with open(html_path, "r", encoding="utf-8") as html_file:
            html_content = html_file.read()
        soup = BeautifulSoup(html_content, "html.parser")
        return soup.get_text(separator="\\n", strip=True)
    except FileNotFoundError:
        print(f"Ошибка: HTML-файл не найден по пути {html_path}")
        return "" # Возвращаем пустую строку

# 4. Функция для чтения текстового файла
def read_text_file(text_path: str) -> str:
    """Считывает содержимое текстового файла."""
    try:
        return Path(text_path).read_text(encoding="utf-8")
    except FileNotFoundError:
        print(f"Ошибка: Текстовый файл не найден по пути {text_path}")
        return "" # Возвращаем пустую строку

# --- Пути к вашим файлам (замените на реальные пути) ---
# Создайте эти файлы для теста или используйте свои.
# Пример: example.jpg, example.html, example.txt
# Убедитесь, что example.html содержит какой-то текст и HTML-теги.
# Убедитесь, что example.txt содержит какой-то текст.
# Убедитесь, что example.jpg - это валидный файл изображения.

# Для примера создадим временные файлы, если они не существуют,
# чтобы код мог запуститься "из коробки" для демонстрации.
# В реальном использовании вы будете указывать пути к своим файлам.

image_file_path_str = "example.jpg"
html_file_path_str = "example.html"
text_file_path_str = "example.txt"

# Создаем заглушки, если файлы не существуют
if not Path(image_file_path_str).exists():
    print(f"Файл {image_file_path_str} не найден. Пожалуйста, создайте его или укажите корректный путь.")
    # Для запуска примера без реального изображения, можно закомментировать блок с изображением ниже
    # или использовать placeholder base64 строку.
    # В данном случае, если файла нет, encode_image_to_base64 вернет пустую строку.

if not Path(html_file_path_str).exists():
    with open(html_file_path_str, "w", encoding="utf-8") as f:
        f.write("<html><body><h1>Заголовок HTML</h1><p>Это тестовый HTML файл.</p></body></html>")
    print(f"Создан тестовый файл {html_file_path_str}")

if not Path(text_file_path_str).exists():
    with open(text_file_path_str, "w", encoding="utf-8") as f:
        f.write("Это содержимое тестового текстового файла. Он содержит простой текст.")
    print(f"Создан тестовый файл {text_file_path_str}")


# --- Загрузка и подготовка данных ---
base64_image_data = encode_image_to_base64(image_file_path_str)
html_extracted_text_data = extract_text_from_html(html_file_path_str)
plain_text_content_data = read_text_file(text_file_path_str)

# 5. Формирование мультимодального промпта
#    LangChain использует список "content blocks" для передачи различных типов данных.
content_blocks = []

# Добавляем текстовую инструкцию
content_blocks.append({
    "type": "text",
    "text": "Ты мультимодальный ассистент. Проанализируй предоставленные данные: изображение, содержимое HTML-файла и содержимое текстового файла. "
            "Опиши, что ты видишь на изображении. Извлеки ключевую информацию из HTML и текстового файла. "
            "Затем предоставь сводный анализ всех источников."
})

# Добавляем изображение (если оно было успешно закодировано)
if base64_image_data:
    content_blocks.append({
        "type": "image_url",
        "image_url": {"url": f"data:image/jpeg;base64,{base64_image_data}"} # Замените image/jpeg на нужный тип, если это не JPEG
    })
else:
    content_blocks.append({
        "type": "text",
        "text": "Изображение не было предоставлено или не удалось загрузить."
    })


# Добавляем извлеченный текст из HTML
if html_extracted_text_data:
    content_blocks.append({
        "type": "text",
        "text": f"--- Начало содержимого HTML-файла ---\n{html_extracted_text_data}\n--- Конец содержимого HTML-файла ---"
    })
else:
     content_blocks.append({
        "type": "text",
        "text": "HTML-файл не был предоставлен или не удалось обработать."
    })

# Добавляем содержимое текстового файла
if plain_text_content_data:
    content_blocks.append({
        "type": "text",
        "text": f"--- Начало содержимого текстового файла ---\n{plain_text_content_data}\n--- Конец содержимого текстового файла ---"
    })
else:
    content_blocks.append({
        "type": "text",
        "text": "Текстовый файл не был предоставлен или не удалось обработать."
    })

# Дополнительный вопрос или инструкция в конце
content_blocks.append({
    "type": "text",
    "text": "Каковы основные выводы из всех этих источников? Представь ответ структурированно."
})

# Создаем сообщение HumanMessage со списком контент-блоков
human_prompt = HumanMessage(content=content_blocks)

# 6. Вызов LLM с мультимодальным промптом
print("\\nОтправка запроса к LLM...")
try:
    response = llm.invoke([human_prompt])
    # Вывод ответа модели
    print("\\nОтвет модели:")
    print(response.content)
except Exception as e:
    print(f"Ошибка при вызове LLM: {e}")
    print("Убедитесь, что модель Ollama запущена, поддерживает мультимодальный ввод и корректно настроена.")
Разбор кода:
- Мы инициализируем `ChatOllama` с указанием модели, поддерживающей обработку изображений (например, `llava:latest`).
- Функции `encode_image_to_base64`, `extract_text_from_html` и `read_text_file` подготавливают данные из соответствующих файлов. Важно обрабатывать возможные ошибки, например, если файл не найден.
- Ключевым моментом является формирование `HumanMessage`. Его поле `content` представляет собой список словарей, где каждый словарь ("content block") описывает тип данных (`text` или `image_url`) и сами данные.
- Для изображений, закодированных в Base64, используется тип `image_url`, а URL имеет специальный формат `data:image/jpeg;base64,{base64_string}`. Тип изображения (например, `jpeg`, `png`) должен соответствовать вашему файлу.
- Текстовые данные из HTML и простого текста передаются как блоки типа `text`.
- В промпт также включены текстовые инструкции для LLM, направляющие ее анализ.
- Метод `llm.invoke()` отправляет сформированное сообщение модели, и мы получаем ответ.
Перед запуском убедитесь, что Ollama запущена, указанная модель загружена (`ollama pull llava:latest`) и доступна, а также что пути к файлам указаны верно и сами файлы существуют.
Визуализация процесса: от данных к ответу LLM
Чтобы лучше понять весь процесс, от исходных данных до ответа LLM, рассмотрим следующую ментальную карту. Она иллюстрирует основные этапы: сбор данных, их предварительную обработку, формирование структурированного промпта с помощью LangChain и, наконец, взаимодействие с моделью Ollama для получения результата.
с LangChain и Ollama"] InputData["Источники данных"] ImageFile["Изображение (.jpg, .png и др.)"] HTMLFile["HTML-файл (.html)"] TextFile["Текстовый файл (.txt)"] Preprocessing["Предварительная обработка"] ImageProc["Кодирование в Base64
(для локальных изображений)"] HTMLProc["Извлечение текста
(например, с BeautifulSoup)"] TextProc["Чтение содержимого файла"] LangChainPrompt["Формирование промпта в LangChain"] ContentBlocks["Структура 'Content Blocks'"] ImageBlock["Блок изображения
(type: 'image_url', url: 'data:image/...;base64,...')"] HTMLTextBlock["Текстовый блок
(извлеченный текст из HTML)"] PlainTextTextBlock["Текстовый блок
(содержимое текстового файла)"] InstructionBlock["Текстовый блок
(инструкции для LLM)"] HumanMessageCons["HumanMessage
(содержит список контент-блоков)"] OllamaInteraction["Взаимодействие с LLM через Ollama"] ChatOllamaInit["Инициализация ChatOllama
(с указанием vision-модели)"] InvokeLLM["Вызов llm.invoke([HumanMessage])"] LLMOutput["Ответ от LLM"] CombinedAnalysis["Анализ, объединяющий
все предоставленные данные"]
Сравнение характеристик обработки различных типов данных
Различные типы входных данных требуют разных подходов к обработке и предъявляют разные требования к моделям. Диаграмма ниже иллюстрирует некоторые аспекты работы с изображениями, HTML и текстовыми файлами в контексте их передачи в LLM. Оценка производится по шкале от 1 (низкий/простой) до 5 (высокий/сложный).
Эта диаграмма помогает визуализировать, что, например, изображения требуют более сложной предобработки и специализированных (vision) моделей, но могут нести уникальную визуальную информацию. Текстовые файлы, напротив, наиболее просты в интеграции.
Таблица: Обзор методов и компонентов
В таблице ниже кратко суммированы основные подходы к обработке различных типов данных, используемые компоненты LangChain и примеры моделей Ollama, подходящих для этих задач.
| Тип данных | Метод подготовки | Компонент LangChain | Пример Vision-модели Ollama |
|---|---|---|---|
| Изображение (локальное) | Кодирование в Base64 | HumanMessage с content block: {"type": "image_url", "image_url": {"url": "data:image/...;base64,..."}} |
llava:latest, bakllava:latest, llama3.2-vision |
| HTML-файл | Извлечение текста (например, с помощью BeautifulSoup) | HumanMessage с content block: {"type": "text", "text": "..."} |
Любая текстовая модель (включая vision-модели для текстовой части) |
| Текстовый файл | Чтение содержимого файла | HumanMessage с content block: {"type": "text", "text": "..."} |
Любая текстовая модель (включая vision-модели для текстовой части) |
| Комбинированный промпт | Сборка всех подготовленных данных (текст, base64 изображения) в один список content blocks | HumanMessage, содержащий список различных content blocks |
llava:latest, bakllava:latest, llama3.2-vision (требуется vision-модель для обработки изображений) |
Наглядный пример: Обработка изображений с LangChain и Ollama (Видео)
Для дальнейшего углубления в тему обработки изображений с помощью LangChain и Ollama (в частности, с моделями типа LLaVA), рекомендуем посмотреть следующее видео. В нем демонстрируются практические аспекты извлечения информации из изображений и их анализа с использованием этих инструментов, что отлично дополняет представленный здесь код.
В этом видео вы найдете примеры кода и объяснения, которые помогут вам лучше понять, как LLM "видит" и интерпретирует изображения, а также как интегрировать эти возможности в ваши проекты на Python.
Часто задаваемые вопросы (FAQ)
Какую модель Ollama лучше выбрать для мультимодальных задач?
Для задач, включающих анализ изображений, вам нужна модель с "vision" возможностями. Популярные варианты, доступные через Ollama, включают llava (например, llava:latest или llava:13b), bakllava, или более новые модели, такие как llama3.2-vision (если доступна). Всегда проверяйте актуальный список моделей на сайте Ollama и их совместимость с LangChain. Для чисто текстовых частей HTML и TXT файлов подойдет любая качественная LLM, но если изображение является частью запроса, вся LLM должна быть vision-совместимой.
Как обрабатывать ошибки, если файл не найден или изображение некорректно?
В предоставленном примере кода используются блоки try-except FileNotFoundError для обработки отсутствующих файлов. Вы можете расширить эту логику. Например, если изображение не удалось загрузить или оно повреждено, можно передать в LLM текстовое сообщение об этом (например, "Изображение недоступно") вместо блока с изображением или пропустить этот блок. Важно предусмотреть такие ситуации, чтобы ваше приложение работало стабильно.
Можно ли передавать изображения по URL, а не только локальные файлы?
Да, LangChain и многие vision-модели поддерживают передачу изображений по URL. В этом случае в `image_url` контент-блоке вы бы указали прямой URL изображения вместо `data:image/...;base64,...`. Например: `{"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}`. Убедитесь, что URL доступен для скачивания моделью.
Существуют ли ограничения на размер передаваемых данных?
Да, существуют ограничения. Во-первых, Base64 кодирование увеличивает размер изображения примерно на 33%. Во-вторых, сами LLM имеют ограничение на максимальный размер входного контекста (количество токенов). Большие изображения или очень объемные текстовые/HTML файлы могут превысить этот лимит. Рекомендуется оптимизировать изображения и извлекать только наиболее релевантный текст из HTML. Если данные слишком велики, рассмотрите стратегии их сокращения или разбиения на части (чанкование).
Рекомендуемые запросы для дальнейшего изучения
- Как использовать LangChain Agents для мультимодальных задач с Ollama?
- Продвинутые техники промпт-инжиниринга для анализа изображений и текста в LangChain.
- Оптимизация производительности при работе с большими мультимодальными данными в LangChain и Ollama.
- Интеграция LangChain с другими инструментами для создания комплексных мультимодальных AI-приложений на Python.
Источники и полезные ссылки
Last updated May 14, 2025